

Han pasado los días en que no había que preocuparse por la optimización del rendimiento de las bases de datos. El tiempo no se detiene. Cada nuevo empresario del sector tecnológico quiere crear el próximo Facebook, mientras se esfuerza por recopilar todos los datos a los que puede acceder. Estos datos son necesarios para que las empresas entrenen mejor los modelos que ayudan a ganar dinero. En estas condiciones, los programadores deben crear API que permitan trabajar de manera rápida y confiable con grandes volúmenes de información.
Si has estado diseñando partes servidoras de aplicaciones o bases de datos durante un tiempo, probablemente hayas escrito código para ejecutar consultas con paginación. Por ejemplo, algo así:
SELECT * FROM table_name LIMIT 10 OFFSET 40
¿Es así?
Pero si realizaste la paginación de esta manera, lamento informarte que lo hiciste de una manera que no es la más eficiente.
¿Quieres rebatirme? . , y ya utilizan técnicas de las cuales quiero hablar hoy.
Nombrar al menos a un desarrollador de backend que nunca haya utilizado OFFSET y LIMIT para ejecutar consultas con paginación. En un MVP (Producto Mínimo Viable) y en proyectos donde se utilizan pequeños volúmenes de datos, este enfoque es bastante aplicable. Se podría decir que 'simplemente funciona'.
Pero si necesitas crear sistemas confiables y eficientes desde cero, deberías preocuparte de antemano por la eficiencia de las consultas a las bases de datos utilizadas en tales sistemas.
Hoy hablaremos sobre los problemas asociados con las implementaciones de mecanismos de ejecución de consultas con paginación que son ampliamente utilizadas (desafortunadamente). Y sobre cómo lograr un alto rendimiento al ejecutar tales consultas.
¿Qué está mal con OFFSET y LIMIT?
Como se mencionó anteriormente, OFFSET y LIMIT se desempeñan excelentemente en proyectos donde no es necesario trabajar con grandes volúmenes de datos.
El problema surge cuando la base de datos crece a tal tamaño que ya no cabe en la memoria del servidor. Pero, aun así, al trabajar con esta base de datos, es necesario utilizar consultas con paginación.
Para que este problema se presente, es necesario que surja una situación en la que la base de datos recurra a una operación ineficiente de escaneo completo de tabla (Full Table Scan) al ejecutar cada consulta con paginación (mientras tanto, pueden ocurrir operaciones de inserción y eliminación de datos, y no necesitamos los datos obsoletos).
¿Qué es un "escaneo completo de tabla" (o "lectura secuencial de tabla", Sequential Scan)? Es una operación en la que la base de datos lee secuencialmente cada fila de la tabla, es decir, los datos contenidos en ella, y verifica su conformidad con la condición dada. Se sabe que este tipo de escaneo de tablas es el más lento. Esto se debe a que durante su ejecución se realizan muchas operaciones de entrada/salida que implican el subsistema de disco del servidor. La situación se agrava por las latencias asociadas con el manejo de datos almacenados en los discos, y el hecho de que la transferencia de datos del disco a la memoria es una operación intensiva en recursos.
Por ejemplo, tiene registros de 100000000 de usuarios y está ejecutando una consulta con la construcción OFFSET 50000000. Esto significa que la base de datos tendrá que cargar todos estos registros (¡y ni siquiera los necesitamos!), colocarlos en memoria y solo después tomar, digamos, 20 resultados, que se mencionan en LIMIT.
Digamos que podría verse así: "seleccionar filas de 50000 a 50020 de 100000". Es decir, el sistema necesitará cargar primero 50000 filas para ejecutar la consulta. ¿Ves cuántos trabajos innecesarios tendrá que realizar?
Si no me crees, mira el ejemplo que creé utilizando las capacidades de .
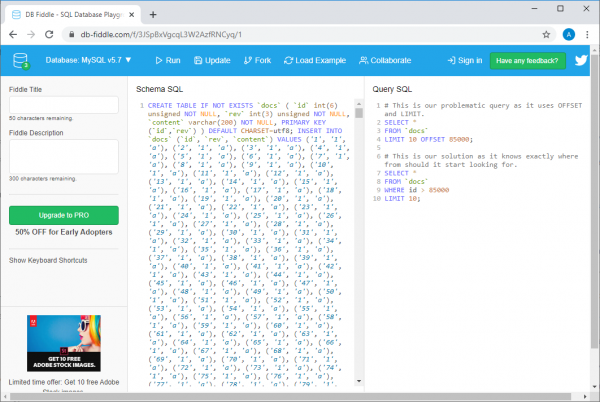
Ejemplo en db-fiddle.com
Allí, a la izquierda, en el campo Schema SQL, hay código que realiza la inserción en la base de datos de 100000 filas, y a la derecha, en el campo Query SQL, se muestran dos consultas. La primera, lenta, es así:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
Y la segunda, que representa una solución eficiente para la misma tarea, es:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Para ejecutar estas consultas, solo necesita hacer clic en el botón Ejecutar en la parte superior de la página. Al hacerlo, compararemos la información sobre los tiempos de ejecución de las consultas. Resulta que ejecutar una consulta ineficiente toma, al menos, 30 veces más tiempo que ejecutar la segunda (de una ejecución a otra, este tiempo varía; por ejemplo, el sistema puede informar que la primera consulta tomó 37 ms, mientras que la segunda — 1 ms).
Y si hay más datos, todo se verá aún peor (para comprobarlo, eche un vistazo a mi con 10 millones de filas).
Lo que acabamos de discutir debería darte una idea de cómo, en realidad, se procesan las consultas en las bases de datos.
Ten en cuenta que cuanto mayor sea el valor OFFSET más tiempo tomará ejecutar la consulta.
¿Qué se debe usar en lugar de la combinación OFFSET y LIMIT?
En lugar de la combinación OFFSET y LIMIT deberías usar una construcción basada en el siguiente esquema:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Esta es la ejecución de una consulta con paginación, basada en un cursor (Cursor based pagination).
En lugar de almacenar localmente los actuales OFFSET y LIMIT y enviarlos con cada consulta, deberías almacenar la última clave primaria recibida (normalmente es ID) y LIMIT, lo que resultará en consultas que se parecerán a la anterior.
¿Por qué? La razón es que al especificar explícitamente el identificador de la última fila leída, estás informando a tu sistema de gestión de bases de datos sobre dónde debe comenzar a buscar los datos necesarios. Además, la búsqueda, gracias al uso de la clave, se llevará a cabo de manera eficiente, el sistema no tendrá que distraerse con filas que están fuera del rango especificado.
Veamos la siguiente comparación de rendimiento entre varias consultas. Aquí hay una consulta ineficiente.
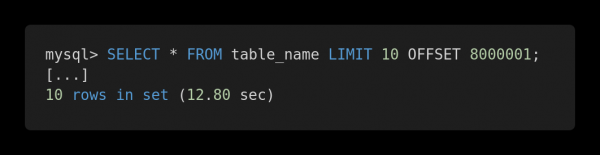
Consulta lenta
Y aquí está la versión optimizada de esta consulta.
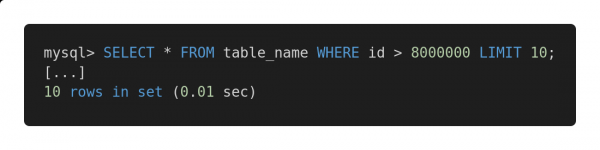
Consulta rápida
Ambas consultas devuelven exactamente la misma cantidad de datos. Pero la primera toma 12,80 segundos en ejecutarse, mientras que la segunda toma 0,01 segundos. ¿Sientes la diferencia?
Problemas potenciales
Para garantizar el funcionamiento efectivo del método propuesto para ejecutar consultas, es necesario que en la tabla haya una columna (o columnas) que contenga índices únicos y secuenciales, como un identificador entero. En algunos casos específicos, esto puede determinar el éxito de la aplicación de tales consultas para mejorar la velocidad de trabajo con la base de datos.
Por supuesto, al construir consultas, es importante tener en cuenta las características de la arquitectura de las tablas y elegir los mecanismos que mejor se desempeñen con las tablas existentes. Por ejemplo, si necesita trabajar en consultas con grandes volúmenes de datos relacionados, puede encontrar interesante artículo.
Si nos enfrentamos a la falta de una clave primaria, por ejemplo, si hay una tabla con una relación de 'muchos a muchos', entonces el enfoque tradicional que prevé el uso de OFFSET y LIMIT, seguramente nos será útil. Sin embargo, su aplicación puede llevar a la ejecución de consultas potencialmente lentas. En tales casos, recomendaría usar una clave primaria con auto-incremento, incluso si solo se necesita para organizar la ejecución de consultas paginadas.
Si le interesa este tema — , y — algunos materiales útiles.
Resultados
La conclusión principal que podemos sacar es que, independientemente del tamaño de las bases de datos, siempre se debe analizar la velocidad de ejecución de las consultas. En la actualidad, la escalabilidad de las soluciones es extremadamente importante, y si desde el principio se diseña correctamente un sistema, esto puede evitar que el desarrollador enfrente muchos problemas en el futuro.
¿Cómo analiza y optimiza las consultas a bases de datos?
Fuente: habr.com
