

Prólogo
A menudo, los usuarios, desarrolladores y administradores de bases de datos en MS SQL Server enfrentan problemas de rendimiento en la base de datos o en el sistema de gestión de bases de datos en general, por lo que el monitoreo de MS SQL Server es muy relevante.
Este artículo es un complemento al artículo y en él se analizarán algunos aspectos del monitoreo de MS SQL Server, en particular: cómo identificar rápidamente qué recursos faltan y recomendaciones sobre la configuración de los flags de seguimiento.
Para que los siguientes scripts funcionen, es necesario crear el esquema inf en la base de datos correspondiente de la siguiente manera:
Creación del esquema inf
use ;
go
create schema inf;
Método para detectar la falta de memoria RAM
El primer indicador de la falta de memoria RAM es cuando la instancia de MS SQL Server consume toda la RAM que se le ha asignado.
Para ello, crearemos la siguiente vista inf.vRAM:
Creación de la vista inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						--cuánta RAM libre hay en el servidor en MB
		 , a.[RAM_Avail_Percent]					--porcentaje de RAM libre en el servidor
		 , a.[Server_physical_memory_Mb]				--cuánta RAM total hay en el servidor en MB
		 , a.[SQL_server_committed_target_Mb]			--cuánta RAM total se ha asignado a MS SQL Server en MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		--cuánta RAM está consumiendo MS SQL Server actualmente en MB
		 , a.[SQL_RAM_Avail_Percent]				--porcentaje de RAM libre para MS SQL Server respecto a toda la RAM asignada para MS SQL Server
		 , a.[StateMemorySQL]						--si hay suficiente RAM para MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				--porcentaje de RAM asignada para MS SQL Server respecto a toda la RAM del servidor
		 --si hay suficiente RAM para el servidor
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Advertencia' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Peligro' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Advertencia' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Para determinar que la instancia de MS SQL Server está utilizando toda la memoria asignada, se puede utilizar la siguiente consulta:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Si el indicador SQL_server_physical_memory_in_use_Mb nunca es menor que SQL_server_committed_target_Mb, es necesario verificar la estadística de esperas.
Para determinar la falta de memoria RAM a través de la estadística de esperas, crearemos la vista inf.vWaits:
Creación de la vista inf.vWaits
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], --nombre del tipo de espera
        [wait_time_ms] / 1000.0 AS [WaitS],--Tiempo total de espera de este tipo en milisegundos. Este tiempo incluye signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Tiempo total de espera de este tipo en milisegundos sin signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--Diferencia entre el tiempo de señalización del hilo que espera y el tiempo de inicio de su ejecución
        [waiting_tasks_count] AS [WaitCount],--Número de esperas de este tipo. Este contador se incrementa cada vez que comienza una espera
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Tiempo total de espera de este tipo en milisegundos. Este tiempo incluye signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Tiempo total de espera de este tipo en milisegundos sin signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--Diferencia entre el tiempo de señalización del hilo que espera y el tiempo de inicio de su ejecución
	    [W1].[WaitCount] AS [WaitCount],--Número de esperas de este tipo. Este contador se incrementa cada vez que comienza una espera
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- umbral de porcentaje
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
En este caso, se puede determinar la falta de memoria RAM con la siguiente consulta:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Aquí se deben tener en cuenta las métricas Percentage y AvgWait_S. Si son considerables en su conjunto, existe una alta probabilidad de que el servidor MS SQL Server no tenga suficiente memoria RAM. Los valores significativos se determinan de forma individual para cada sistema. Sin embargo, se puede empezar con la siguiente métrica: Percentage >= 1 y AvgWait_S >= 0.005.
Para enviar las métricas al sistema de monitoreo (por ejemplo, Zabbix), se pueden crear las siguientes dos consultas:
- qué porcentaje ocupan los tipos de espera por RAM (suma de todos esos tipos de espera):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - cuánto tiempo en milisegundos ocupan los tipos de espera por RAM (valor máximo de todos los tiempos de espera promedio de esos tipos de espera):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
            'PAGEIOLATCH_XX',
            'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
A partir de la dinámica de los valores obtenidos en estas dos métricas, se puede concluir si hay suficiente RAM para la instancia de MS SQL Server.
Método de detección de carga excesiva en la CPU
Para identificar la falta de tiempo de procesador, se puede utilizar la vista del sistema sys.dm_os_schedulers. Aquí, si el indicador runnable_tasks_count es constantemente mayor a 1, existe una alta probabilidad de que el número de núcleos no sea suficiente para la instancia de MS SQL Server.
Para enviar el indicador al sistema de monitoreo (por ejemplo, Zabbix), se puede crear la siguiente consulta:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id < 255;
A partir de la dinámica de los valores obtenidos en este indicador, se puede concluir si hay suficiente tiempo de procesador (número de núcleos de CPU) para la instancia de MS SQL Server.
Sin embargo, es importante recordar que las consultas pueden solicitar varios hilos a la vez. A veces, el optimizador no puede evaluar correctamente la complejidad de la consulta misma. En este caso, pueden asignarse demasiados hilos a la consulta, que en ese momento no pueden ser procesados simultáneamente. Esto también provoca un tipo de espera relacionado con la falta de tiempo de CPU y el crecimiento de la cola en los programadores que utilizan núcleos de CPU específicos, lo que significa que el indicador runnable_tasks_count en tales condiciones aumentará.
En tal caso, antes de aumentar el número de núcleos de CPU, es necesario configurar correctamente las propiedades de paralelismo de la instancia de MS SQL Server, y desde la versión 2016, configurar adecuadamente las propiedades de paralelismo de las bases de datos necesarias:
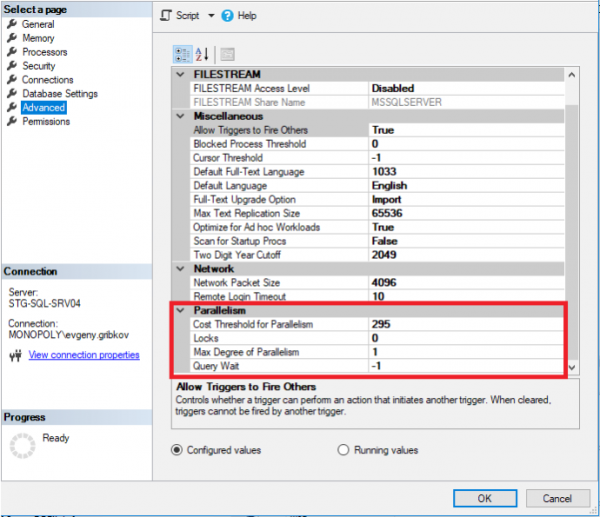
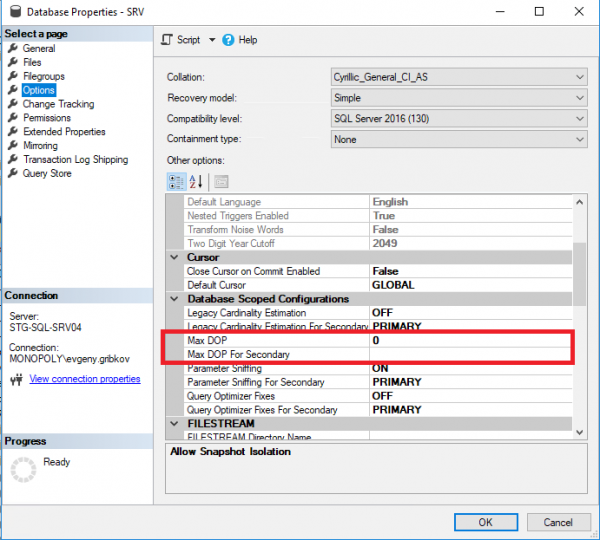
Aquí se deben tener en cuenta los siguientes parámetros:
- Max Degree of Parallelism: establece el número máximo de hilos que pueden ser asignados a cada consulta (por defecto es 0: solo el sistema operativo y la edición de MS SQL Server imponen restricciones).
- Cost Threshold for Parallelism: costo estimado para el paralelismo (por defecto es 5).
- Max DOP: establece el número máximo de hilos que pueden ser asignados a cada consulta a nivel de base de datos (pero no más que el valor de la propiedad «Max Degree of Parallelism») (por defecto es 0: solo el sistema operativo y la edición de MS SQL Server imponen restricciones, así como la propiedad «Max Degree of Parallelism» de toda la instancia de MS SQL Server).
Aquí no es posible dar una receta igual de buena para todos los casos, es decir, es necesario analizar las consultas pesadas.
Según mi experiencia, recomiendo el siguiente algoritmo de acciones para sistemas OLTP para ajustar las propiedades de paralelismo:
- Primero, deshabilitar el paralelismo estableciendo Max Degree of Parallelism a 1 a nivel de toda la instancia.
- Analizar las consultas más pesadas y determinar el número óptimo de hilos para ellas.
- Establecer Max Degree of Parallelism al número óptimo de hilos obtenido del punto 2, y también establecer el valor Max DOP para cada base de datos, obtenido del punto 2.
- Analizar las consultas más pesadas y detectar el efecto negativo de la multithreading. Si existe, aumentar Cost Threshold for Parallelism.
Para sistemas como 1C, Microsoft CRM y Microsoft NAV, en la mayoría de los casos, es adecuado prohibir la multithreading.
Además, si está en la edición Standard, en la mayoría de los casos se puede aplicar la restricción de multi-threading debido a que esta edición tiene un límite en la cantidad de núcleos de CPU.
El algoritmo descrito anteriormente no es adecuado para sistemas OLAP.
Según mi propia experiencia, recomiendo el siguiente algoritmo de acciones para sistemas OLAP para configurar las propiedades de paralelismo:
- Analizar las consultas más pesadas y determinar el número óptimo de hilos para ellas.
- establecer Max Degree of Parallelism en un número óptimo de hilos, obtenido del punto 1, y también para bases de datos específicas establecer el valor Max DOP, obtenido del punto 1 para cada base de datos.
- analizar las consultas más pesadas e identificar el efecto negativo de restringir el paralelismo. Si hay uno, entonces disminuir el valor de Cost Threshold for Parallelism o repetir los pasos 1-2 de este algoritmo.
Es decir, para sistemas OLTP vamos de la ejecución de un solo hilo a múltiples hilos, y para sistemas OLAP, al contrario, empezamos de múltiples hilos a un solo hilo. De esta manera, podemos optimizar la configuración de paralelismo tanto para una base de datos específica como para toda la instancia de MS SQL Server.
También es importante entender que las configuraciones de propiedades de paralelismo deben ajustarse con el tiempo, basándose en los resultados del monitoreo del rendimiento de MS SQL Server.
Recomendaciones para la configuración de flags de trazado.
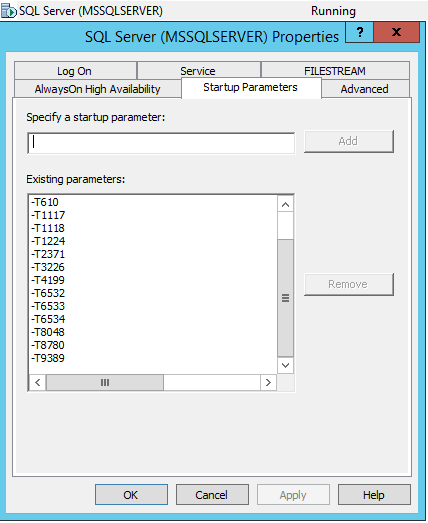
Desde mi propia experiencia y la de mis colegas, para un funcionamiento óptimo, recomiendo establecer los siguientes flags de trazado al iniciar el servicio MS SQL Server para versiones 2008-2016:
- 610 — Reduce el registro de inserciones en tablas indexadas. Puede ayudar con inserciones en tablas con un gran número de registros y múltiples transacciones, durante esperas prolongadas de WRITELOG debido a cambios en los índices.
- 1117 — Si un archivo en un grupo de archivos cumple con los requisitos del umbral de incremento automático, todos los archivos del grupo se incrementan.
- 1118 — Obliga a que todos los objetos se ubiquen en diferentes extensiones (previniendo extensiones mixtas), lo que minimiza la necesidad de escanear la página SGAM, que se utiliza para rastrear extensiones mixtas.
- 1224 — Desactiva la agrupación de bloqueos basada en la cantidad de bloqueos. Sin embargo, un uso excesivo de memoria puede activar la agrupación de bloqueos.
- 2371 — Cambia el umbral de actualización automática de estadísticas fija al umbral de actualización automática de estadísticas dinámica. Es importante para la actualización de los planes de consultas relacionadas con tablas grandes, donde la identificación incorrecta del número de registros lleva a planes de ejecución erróneos.
- 3226 — Suprime los mensajes sobre la ejecución exitosa de copias de seguridad en el registro de errores.
- 4199 — Habilita los cambios en el optimizador de consultas lanzados en los paquetes acumulativos y los paquetes de actualización de SQL Server.
- 6532-6534 — Mejora el rendimiento de las operaciones de consulta con tipos de datos espaciales.
- 8048 — Convierte los objetos de memoria particionados por NUMA en particionados por CPU.
- 8780 — Activa la concesión adicional de tiempo para la elaboración del plan de consulta. Algunas consultas sin este indicador pueden ser rechazadas, ya que no tienen un plan de consulta (error muy raro).
- 8780 — 9389 — Habilita un búfer de memoria temporal adicional dinámicamente proporcionado para los operadores en modo por lotes, lo que permite al operador en modo por lotes solicitar memoria adicional y evitar el traslado de datos a tempdb, si hay memoria adicional disponible.
También es útil, hasta la versión 2016, activar el indicador de seguimiento 2301, que habilita la optimización del soporte extendido para la toma de decisiones y así ayuda en la selección de planes de consulta más adecuados. Sin embargo, a partir de la versión 2016, a menudo tiene un efecto negativo en el tiempo total de ejecución de consultas.
Además, para sistemas con muchos índices (por ejemplo, bases de datos 1C), recomiendo habilitar el indicador de seguimiento 2330, que desactiva la recolección sobre el uso de índices, lo que en general tiene un efecto positivo en el sistema.
Para obtener más información sobre los indicadores de seguimiento, se puede consultar.
En el enlace anterior, también es importante tener en cuenta las versiones y compilaciones de MS SQL Server, ya que para versiones más nuevas algunos indicadores de seguimiento están habilitados por defecto o no tienen ningún efecto.
Se puede habilitar y deshabilitar el indicador de seguimiento mediante los comandos DBCC TRACEON y DBCC TRACEOFF, respectivamente. Consulte para más detalles.
Se puede obtener el estado de los indicadores de seguimiento con el comando DBCC TRACESTATUS:
Para que las banderas de traza se habiliten en el inicio automático del servicio MS SQL Server, es necesario acceder al Administrador de configuración de SQL Server y agregar las banderas de traza en las propiedades del servicio a través de -T:
Resultados
En este artículo se han abordado algunos aspectos del monitoreo de MS SQL Server, que permiten identificar de manera rápida la falta de RAM y el tiempo libre de la CPU, así como una serie de otros problemas menos evidentes. Se han revisado las banderas de traza más comúnmente utilizadas.
Fuentes:
»
»
»
»
»
»
»
Fuente: habr.com
