

Desarrollamos DevOps lo mejor que pudimos. Éramos 8 personas, y Vasya era el mejor en Windows. De repente, Vasya se fue, y me encontré con la tarea de lanzar un nuevo proyecto que entregara desarrollo de Windows. Cuando volqué sobre la mesa todo el stack de desarrollo en Windows, comprendí que la situación era dolorosa...
Así comienza la historia Alexandra Sinchinova en . Cuando el principal especialista en Windows de la empresa se fue, Alexander se preguntó qué hacer a continuación. ¡Por supuesto, cambiar a Linux! Alexander explicará cómo logró crear un precedente y trasladar parte del desarrollo de Windows a Linux usando como ejemplo un proyecto implementado para 100,000 usuarios finales.
¿Cómo entregar un proyecto en RPM de manera fácil y sin complicaciones, utilizando TFS, Puppet, Linux .NET Core? ¿Cómo mantener el versionado de la base de datos del proyecto si los desarrolladores oyen por primera vez palabras como Postgres y Flyway, y la fecha límite es pasado mañana? ¿Cómo integrarse con Docker? ¿Cómo motivar a los desarrolladores .NET a abandonar Windows y los batidos en favor de Puppet y Linux? ¿Cómo resolver conflictos ideológicos si no hay fuerzas, ni deseos, ni recursos para mantener Windows en producción? Sobre esto, así como sobre Web Deploy, pruebas, CI, prácticas de uso de TFS en proyectos existentes, y, por supuesto, sobre muletas rotas y soluciones efectivas, se discutirá en la transcripción de la presentación de Alexander.
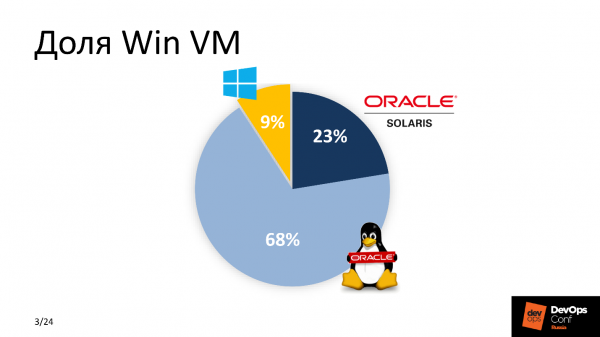
Así que, Vasya se fue, la tarea está sobre mí, los desarrolladores esperan con ansias. Cuando finalmente me di cuenta de que no podía recuperar a Vasya, me puse a trabajar. Primero evalué el porcentaje de VM de Windows en nuestro parque. La cuenta no era favorable para Windows.
Como estamos desarrollando activamente DevOps, entendí que era necesario cambiar el enfoque para implementar la nueva aplicación. La solución fue simple: trasladar todo a Linux cuando fuera posible. Google me ayudó: en ese momento ya se había portado .Net a Linux, y entendí que esa era la solución.
¿Por qué .NET Core en combinación con Linux?
Hubo varias razones. Entre 'pagar dinero' y 'no pagar', la mayoría elegirá la segunda opción, al igual que yo. La licencia para MSDB cuesta alrededor de 1,000 $, y el mantenimiento de un parque de máquinas virtuales Windows se cuenta por cientos de dólares. Para una gran empresa, estos son costos significativos. Por eso, el ahorro — es la primera razón. No es la más importante, pero sí una de las más relevantes.
Las máquinas virtuales de Windows consumen más recursos que sus contrapartes de Linux, son pesadas. Considerando la escala de una gran empresa, elegimos Linux.
El sistema se integra fácilmente en CI existente. Nos consideramos DevOps progresistas, utilizamos Bamboo, Jenkins y GitLab CI, por lo que gran parte de nuestro trabajo se realiza en Linux.
La última razón es el soporte conveniente. Necesitábamos reducir la barrera de entrada para los "soportantes" — chicos que entienden la parte técnica, garantizan la continuidad y atienden los servicios de segunda línea. Ya estaban familiarizados con el stack de Linux, por lo que les resulta mucho más fácil entender el nuevo producto, mantenerlo y soportarlo, en lugar de gastar recursos adicionales para familiarizarse con funcionalidades similares en software para la plataforma Windows.
Requisitos
Lo primero y más importante es la conveniencia de la nueva solución para los desarrolladores. No todos estaban listos para el cambio, especialmente después de mencionar la palabra Linux. Los desarrolladores quieren su Visual Studio favorito, TFS con pruebas automáticas en compilaciones y smoothies. Cómo se realiza la entrega a producción no les preocupa. Por eso decidimos no cambiar el proceso habitual y dejar todo igual para el desarrollo en Windows.
El nuevo proyecto debe integrarse en CI existente. Las herramientas ya estaban en su lugar y todo el trabajo debía realizarse teniendo en cuenta los parámetros del sistema de gestión de configuraciones, los estándares de entrega aprobados y los sistemas de monitoreo.
La simplicidad en el soporte y operación, como condición para una mínima barrera de entrada para todos los nuevos participantes de diferentes departamentos y del equipo de soporte.
El plazo era ayer.
El grupo de desarrollo de Win
¿Con qué estaba trabajando el equipo de Windows entonces?
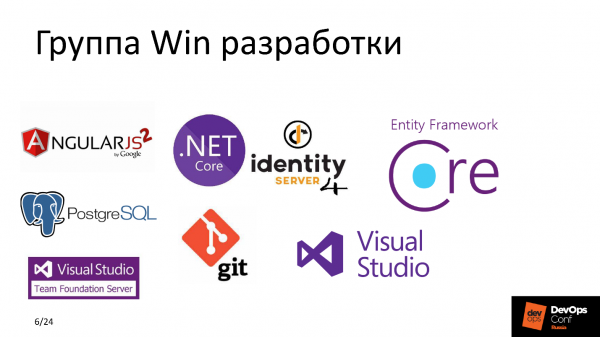
Ahora puedo decir con confianza que IdentityServer4 es una excelente alternativa gratuita a ADFS con capacidades similares, o que Entity Framework Core es un paraíso para los desarrolladores, donde no hay necesidad de preocuparse por escribir scripts SQL, sino que se pueden describir consultas a la base de datos en términos de OOP. Pero en ese momento, en la discusión del plan de acción, veía este stack como una escritura cuneiforme sumeria, reconociendo solo PostgreSQL y Git.
En ese momento utilizábamos activamente Puppet como sistema de gestión de configuraciones. En la mayoría de nuestros proyectos aplicábamos GitLab CI, Elastic, balanceábamos servicios de alta carga usando HAProxy, monitoreábamos todo con Zabbix, la combinación de Grafana y Prometheus, Jaeger, y todo esto funcionaba en hardware HP c ESXi en VMware. Es bien conocido — la clásica.
Vamos a ver y tratar de entender qué sucedió antes de que comenzáramos todas estas intervenciones.
¿Qué pasó?
TFS es un sistema bastante potente que no solo transporta el código del desarrollador a la máquina de producción final, sino que también tiene un conjunto para una integración muy flexible con varios servicios para garantizar CI a nivel multiplataforma.
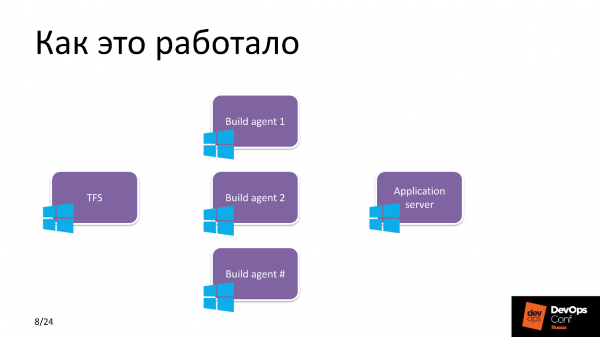
Antes, eran solo ventanillas. TFS utilizaba varios agentes de compilación, en los cuales se compilaban numerosos proyectos. En cada agente hay de 3 a 4 trabajadores para paralelizar tareas y optimizar el proceso. Luego, de acuerdo con los planes de lanzamiento, TFS entregaba la compilación recién horneada en un servidor de aplicaciones de Windows.
A lo que queríamos llegar
Usamos TFS para la entrega y desarrollo, y lanzamos la aplicación en un servidor de aplicaciones Linux, y entre ellos hay una especie de magia. Esta Magic Box es la esencia del trabajo futuro. Antes de descomponerlo en partes, haré un paso al lado y diré un par de palabras sobre la aplicación.
Proyecto
La aplicación proporciona funcionalidad para manejar tarjetas prepagadas.
Cliente
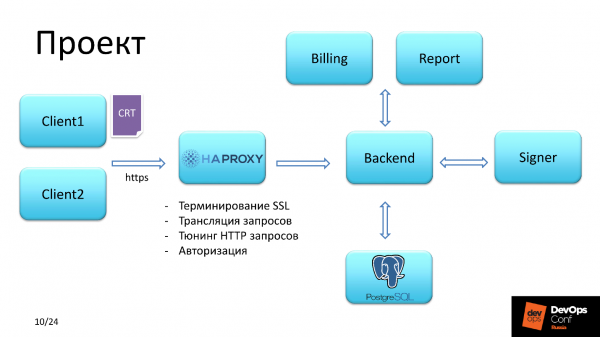
Existían dos tipos de usuarios. Primero accedía autenticándose con un certificado SSL SHA-2. El segundo tenía acceso con login y contraseña.
HAProxy
Luego, la solicitud del cliente llegaba a HAProxy, que resolvía las siguientes tareas:
- autenticación primaria;
- terminación de SSL;
- ajuste de solicitudes HTTP;
- transmisión de solicitudes.
La verificación del certificado del cliente se realizaba en cadena. Nosotros somos authority y podemos permitirnos esto, ya que nosotros mismos emitimos certificados a los clientes del servicio.
Presta atención al tercer punto, regresaremos a él más tarde.
Backend
Planeamos hacer el backend en Linux. El backend interactúa con la base de datos, carga la lista necesaria de privilegios y luego, dependiendo de los privilegios del usuario autenticado, proporciona acceso para la firma de documentos financieros y su envío para su ejecución, o la generación de algún informe.
Ahorro con HAProxy
Además de los dos contextos que seguía cada uno de los clientes, había otro contexto de identidad. IdentityServer4 que precisamente permite la autenticación, es un equivalente gratuito y potente de ADFS — Servicios de Federaciónde Active Directory.
La solicitud en identity se procesaba en varios pasos. El primer paso - cliente llegaba al backend, que intercambiaba datos con este servidor y verificaba la existencia del token para el cliente. Si no lo encontraba, la solicitud se devolvía al contexto desde el cual había venido, pero ya con una redirección, y la redirección iba a identity.
El segundo paso — la solicitud llegaba a la página de autorización en IdentityServer, donde el cliente se registraba, y en la base de datos de IdentityServer aparecía ese tan esperado token.
El tercer paso — el cliente se redirigía de vuelta al contexto desde el cual había venido.
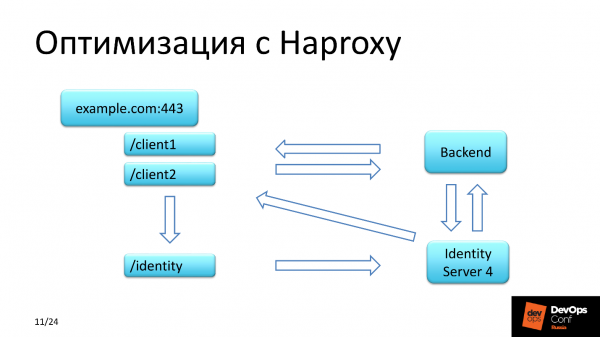
IdentityServer4 tiene una particularidad: la respuesta a la solicitud inversa se devuelve por HTTP. Por más que intentamos configurar el servidor, por más que nos iluminamos con la documentación, cada vez recibíamos la solicitud original del cliente con una URL que había llegado por HTTPS, y IdentityServer devolvía el mismo contexto, pero con HTTP. ¡Estábamos en shock! Y trasladamos todo esto a través del contexto identity en HAProxy, y en los headers tuvimos que modificar el protocolo HTTP a HTTPS.
¿Cuál es la mejora y dónde ahorramos?
Ahorramos dinero usando una solución gratuita para la autorización de un grupo de usuarios, recursos, ya que no llevamos IdentityServer4 como un nodo separado en un segmento separado, sino que lo utilizamos junto con el backend en el mismo servidor donde está funcionando el backend de la aplicación.
Cómo debería funcionar
Así que, como prometí — Magic Box. Ya entendemos que nos movemos garantizadamente hacia Linux. Vamos a formular tareas concretas que requerían solución.
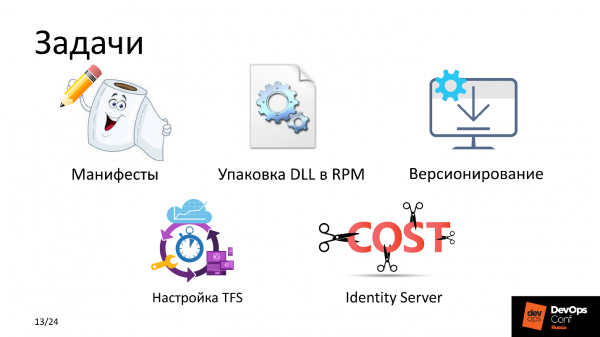
Manifiestos de Puppet. Para entregar y gestionar la configuración del servicio y la aplicación, era necesario escribir recetas adecuadas. Un rollo con un lápiz muestra elocuente cómo se hizo esto de manera rápida y de calidad.
Método de entrega. El estándar es RPM. Todos entienden que en Linux no se puede sin él, pero el proyecto después de la construcción era un conjunto de archivos DLL ejecutables. Eran alrededor de 150, el proyecto es bastante pesado. La única solución armoniosa fue empaquetar esta binaria en RPM y desde allí desplegar la aplicación.
Versionado. Teníamos que lanzar muy frecuentemente y necesitábamos decidir cómo formar el nombre del paquete. Esta es una cuestión a nivel de integración con TFS. Teníamos un agente de compilación en Linux. Cuando TFS envía una tarea al procesador - worker - en el agente de compilación, también le pasa un montón de variables que llegan al entorno del proceso del procesador. En estas variables de entorno se transmite el nombre de la compilación, el nombre de la versión y otras variables. Más detalles sobre esto en la sección 'compilación de paquetes RPM'.
Configuración de TFS se centraba en la configuración del Pipeline. Antes recopilábamos todos los proyectos de Windows en agentes de Windows, y ahora aparece un agente de Linux - el agente de compilación, que debe ser incluido en el grupo de compilación, enriquecido con algún artefacto, indicado qué tipo de proyectos se compilarán en este agente de compilación y modificar el Pipeline de alguna manera.
IdentityServer. ADFS no es nuestro camino, apoyamos el Open Source.
Vamos a revisar los componentes.
Magic Box
Consiste en cuatro partes.
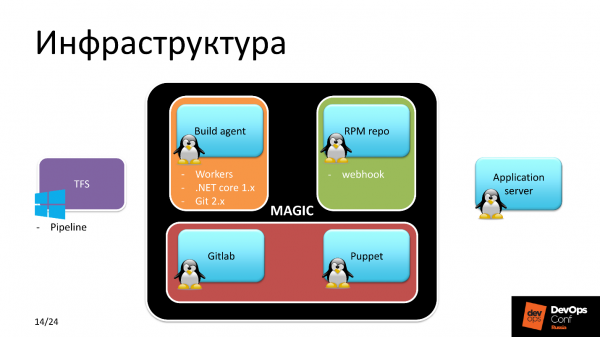
Agente de compilación en Linux. Linux, porque estamos compilando para él - es lógico. Esta parte se llevó a cabo en tres pasos.
- Configurar los workers y no uno solo, ya que se suponía que habría trabajo distribuido en el proyecto.
- Instalar .NET Core 1.x. ¿Por qué 1.x, cuando ya está disponible 2.0 en el repositorio estándar? Porque cuando comenzamos el desarrollo, la versión estable era 1.09, y se decidió hacer el proyecto para esa versión.
- Git 2.x.
Repositorio RPM. Los paquetes RPM necesitaban ser almacenados en algún lugar. Se esperaba que utilizáramos el mismo repositorio RPM corporativo que estaba disponible para todos los hosts de Linux. Así lo hicimos. En el servidor del repositorio se configuró webhook que descargaba el paquete RPM requerido desde el lugar indicado. La versión del paquete fue informada al webhook por el agente de compilación.
GitLab. ¡Atención! GitLab aquí es utilizado no por los desarrolladores, sino por el departamento de operaciones para el control de versiones de la aplicación, versiones de paquetes, control del estado de todas las máquinas Linux y en él se almacena la receta - todos los manifiestos de Puppet.
Puppet resuelve todos los puntos conflictivos y proporciona exactamente la configuración que queremos, desde GitLab.
Comenzamos a profundizar. ¿Cómo se entrega DLL en RPM?
Entrega de DDL en RPM
Supongamos que tenemos una estrella de rock del desarrollo en .NET. Utiliza Visual Studio y crea una rama de lanzamiento. Después de eso, la sube a Git, y Git aquí es una entidad de TFS, es decir, es el repositorio de la aplicación con el que trabaja el desarrollador.
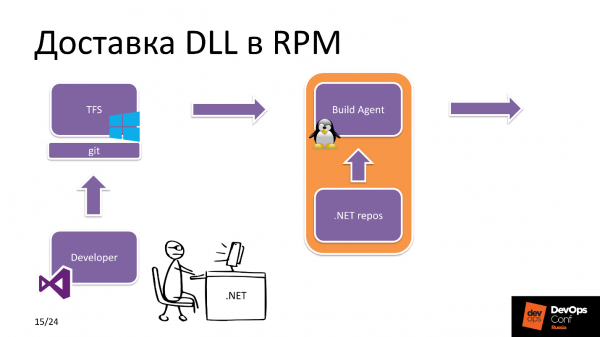
Después de lo cual TFS ve que ha llegado un nuevo commit. ¿Qué aplicación? En la configuración de TFS hay una etiqueta que indica qué recursos tiene cada agente de compilación. En este caso, ve que estamos compilando un proyecto .NET Core y elige un agente de compilación de Linux del grupo.
El agente de compilación recibe los fuentes, descarga lo necesario dependencies del repositorio .NET, npm, etc. y después de compilar la aplicación y empaquetarla, envía el paquete RPM al repositorio RPM.
Por otro lado, ocurre lo siguiente. El ingeniero del departamento de operaciones se encarga directamente de desplegar el proyecto: cambia las versiones de los paquetes en Hiera en el repositorio donde se almacena la receta de la aplicación, después de lo cual Puppet activa Yum, recoge el nuevo paquete del repositorio y la nueva versión de la aplicación está lista para ser utilizada.
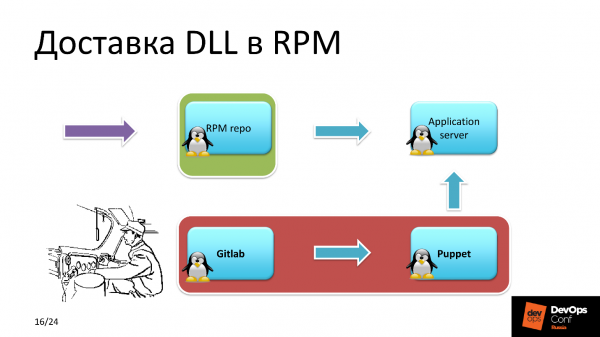
En teoría todo es simple, pero ¿qué ocurre dentro del propio agente de compilación?
Empaquetado de DLL RPM
Se han obtenido los fuentes del proyecto y la tarea de compilación de TFS. El agente de compilación inicia la compilación del proyecto a partir de los fuentes. El proyecto compilado está disponible en forma de múltiples archivos DLL, que se empaquetan en un archivo zip para reducir la carga en el sistema de archivos.
El archivo ZIP se lanza en el directorio de construcción del paquete RPM. Luego, un script Bash inicializa las variables de entorno, encuentra la versión de Build, la versión del proyecto, la ruta al directorio de construcción y lanza RPM-build. Al finalizar la compilación, el paquete se publica en el repositorio local, que se encuentra en el agente de compilación.
Luego, desde el agente de compilación al servidor en el repositorio RPM se envía una solicitud JSON con la especificación del nombre de la versión y la compilación. El webhook, del que hablé antes, descarga ese paquete del repositorio local en el agente de compilación y hace que una nueva compilación esté disponible para instalación.
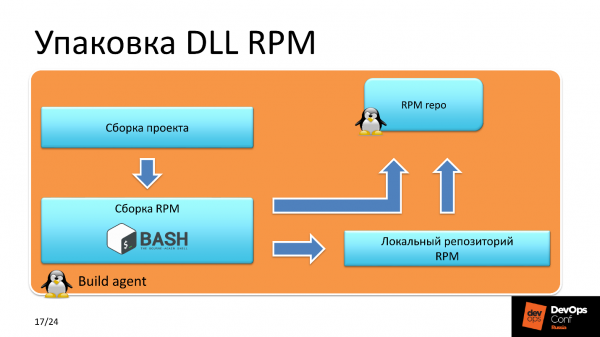
¿Por qué este esquema de entrega del paquete al repositorio RPM? ¿Por qué no se puede enviar el paquete compilado directamente al repositorio? Se debe a que es una condición para garantizar la seguridad. Este escenario limita la posibilidad de cargas no autorizadas de paquetes RPM por parte de personas ajenas en el servidor, que está accesible para todas las máquinas Linux.
Versionado de la base de datos
En el consejo con el desarrollo se aclaró que a los chicos les gusta más MS SQL, pero en la mayoría de los proyectos no Windows ya estábamos usando PostgreSQL. Dado que ya decidimos alejarnos de todo lo de pago, comenzamos a usar PostgreSQL aquí también.
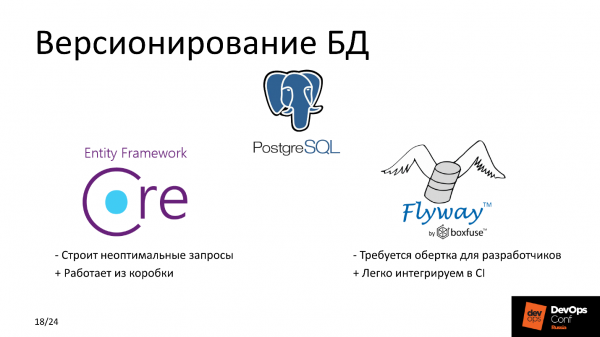
En esta parte quiero hablar sobre cómo realizamos la versión de la base de datos y cómo elegimos entre Flyway y Entity Framework Core. Veamos sus ventajas y desventajas.
Desventajas
Flyway solo va en una dirección, nosotros no podemos retroceder — esta es una desventaja significativa. La comparación con Entity Framework Core puede hacerse según otros parámetros, desde el punto de vista de la comodidad del desarrollador. Recuerden que esto es lo que pusimos en primer plano, y el principal criterio fue no cambiar nada para el desarrollo en Windows.
Para Flyway necesitábamos algún tipo de envoltura , para que los chicos no tuvieran que escribirconsultas SQL . A ellos les resulta mucho más fácil operar en términos de OOP. Escribimos instrucciones sobre cómo trabajar con los objetos de la base de datos, se formó la consulta SQL y se ejecutó. La nueva versión de la base de datos está lista, ha funcionado — todo bien, todo funciona.Entity Framework Core tiene un inconveniente — bajo altas cargas
genera consultas SQL no óptimas , y la caída en la base de datos puede ser significativa. Sin embargo, dado que nuestro servicio no está sometido a alta carga, no contamos la carga por cientos de RPS, asumimos estos riesgos y delegamos el problema a nuestro futuro.funciona fuera de la caja y es conveniente para el desarrollo
Ventajas
Entity Framework Core , mientras que Flywayse integra fácilmente en el CI existente . Pero hacemos todo para que sea conveniente para los desarrolladores :)El procedimiento de implementación
Puppet ve que llega un cambio de versión de los paquetes, entre los cuales está el que se encarga de la migración. Primero instala el paquete que contiene los scripts de migración y la funcionalidad relacionada con la base de datos. Después de esto, se reinicia la aplicación que trabaja con la base de datos. Luego se realiza la instalación de los componentes restantes. El orden de instalación de los paquetes y el inicio de las aplicaciones está descrito en el manifiesto de Puppet.
Las aplicaciones utilizan datos sensibles, como tokens, contraseñas para la base de datos, todo esto se extrae en la configuración desde el Puppet master, donde se almacenan en forma cifrada.
Problemas en TFS
Después de que nos decidimos y entendimos que efectivamente todo funciona, decidí observar cómo iban las compilaciones en TFS en general para el departamento de desarrollo en Windows para otros proyectos — si rápidamente o no nos estamos compilando/lanzando, y encontré problemas significativos con la velocidad.
Uno de los principales proyectos se compila en 12-15 minutos — esto es largo, no se puede vivir así. Un rápido análisis mostró una terrible caída en el I/O, y eso en matrices.
Al analizar componente por componente, identifiqué tres focos. El primero —
«Kaspersky antivirus» «Antivirus Kaspersky», que escanea el código fuente en todos los agentes de construcción de Windows. El segundo — Windows Indexador. No fue desactivado, y en los agentes de construcción se indexaba todo en tiempo real durante el proceso de despliegue.
El tercero — Npm install. Resultó que en la mayoría de los Pipelines utilizábamos exactamente este script. ¿Cuál es su desventaja? El procedimiento Npm install se activa al formar el árbol de dependencias en package-lock.json, donde se registran las versiones de los paquetes que se utilizarán para compilar el proyecto. La desventaja es que Npm install cada vez descarga las versiones actuales de los paquetes desde internet, lo cual consume bastante tiempo en el caso de un proyecto grande.
Los desarrolladores a veces experimentan en su máquina local para verificar el funcionamiento de una parte específica o de todo el proyecto. A veces sucedía que localmente todo funcionaba genial, pero al compilar y desplegar, nada funcionaba. Comenzamos a investigar cuál es el problema — ah, diferentes versiones de paquetes con dependencias.
Solución
- Códigos fuente en excepciones AV.
- Desactivación de la indexación.
- Cambio a npm ci.
Las ventajas de npm ci son que creamos el árbol de dependencias una vez, y obtenemos la posibilidad de proporcionar al desarrollador una lista actualizada de paquetes, con la que puede experimentar localmente tanto como quiera. Esto ahorra tiempo a los desarrolladores que escriben código.
Configuración
Ahora un poco sobre la configuración del repositorio. Históricamente hemos utilizado Nexus para gestionar repositorios, incluyendo el REPO Interno. En este repositorio interno se suministran todos los componentes que usamos para fines internos, por ejemplo, monitoreos personalizados.
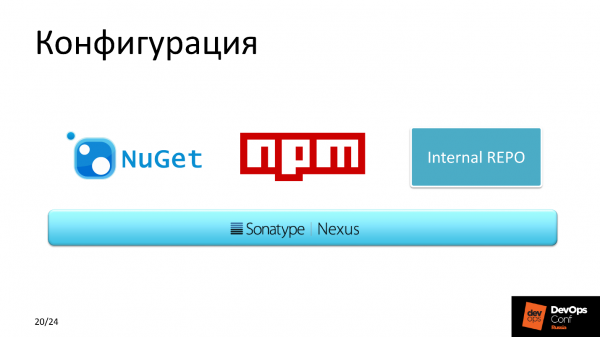
También utilizamos NuGet, ya que tiene un mejor sistema de caché en comparación con otros gestores de paquetes.
Resultado
Después de optimizar los agentes de construcción, el tiempo medio de compilación se redujo de 12 minutos a 7.
Si contamos todas las máquinas que podríamos haber utilizado para Windows, pero que convertimos a Linux en este proyecto, hemos ahorrado alrededor de $10,000. Y eso solo en licencias, y si consideramos el mantenimiento, más.
Planes
En el próximo trimestre hemos planeado trabajar en la optimización de la entrega de código.
Transición a la imagen Docker precompilada. TFS es una herramienta genial con muchos complementos que permiten integrarse en el Pipeline, incluyendo la compilación por trigger, por ejemplo, de una imagen Docker. Queremos crear este trigger para esa misma. package-lock.json. Si de alguna manera cambia la composición de los componentes que se utilizan para construir el proyecto, se genera una nueva imagen de Docker. Posteriormente, se utiliza para desplegar un contenedor con la aplicación ensamblada. En este momento no está disponible, pero planeamos migrar a una arquitectura de microservicios en Kubernetes, que se está desarrollando activamente en nuestra empresa y que hace tiempo que gestiona soluciones en producción.
Currículum
Exorto a todos a deshacerse de Windows, pero no porque no sepa usarla. La razón es que la mayoría de las soluciones de código abierto son el stack de Linux.Ahorrarás en recursos.En mi opinión, el futuro pertenece a las soluciones de código abierto en Linux con una sólida comunidad.
Perfil del ponente Alexander Sinchinov .
es una conferencia sobre la integración de procesos de desarrollo, pruebas y operación para profesionales por profesionales. Es por eso que el proyecto del que habló Alexander está implementado y funcionando, y en el día de su presentación se realizaron dos lanzamientos exitosos. el 27 y 28 de mayo habrá aún más casos similares de practicantes. Aún puedes subirte al último tren y O, sin prisa, un boleto. ¡Nos vemos en Skolkovo!
Fuente: habr.com
