

Primero explicaré el título del artículo. Originalmente se planeaba ofrecer un buen y confiable consejo sobre cómo acelerar el uso de la reflexión con un ejemplo simple pero realista; sin embargo, durante las pruebas de benchmark, descubrí que la reflexión no es tan lenta como pensaba, y que LINQ es más lento de lo que soñé en mis pesadillas. Al final, también cometí un error en las mediciones... Los detalles de esta historia de vida están en el despliegue y en los comentarios. Dado que el ejemplo es bastante cotidiano y se realizó básicamente como se hace normalmente en empresas, parece que he logrado una demostración bastante interesante de la vida: la influencia en la velocidad del tema principal del artículo no fue perceptible debido a la lógica externa: Moq, Autofac, EF Core y otros
Comencé mi trabajo impresionado por este artículo:
Como se puede ver, el autor sugiere usar delegados compilados en lugar de acceder directamente a los métodos de los tipos de reflexión como una excelente manera de acelerar significativamente el rendimiento de la aplicación. También hay emisión de IL, pero me gustaría evitarla, ya que es la forma más laboriosa de llevar a cabo la tarea, lo cual está lleno de errores.
Dado que siempre he mantenido una opinión similar sobre la velocidad de la reflexión, no tenía la intención de cuestionar las conclusiones del autor.
A menudo me encuentro con el uso ingenuo de la reflexión en empresas. Se toma un tipo. Se obtiene información sobre una propiedad. Se llama al método SetValue, y todos se alegran. El valor llega al campo objetivo, todos están contentos. Las personas son bastante inteligentes: seniors y team leads escriben sus propias extensiones sobre object, basándose en una implementación ingenua de 'mappers universales' de un tipo a otro. La esencia suele ser: tomamos todos los campos, tomamos todas las propiedades, iteramos sobre ellos: al coincidir con los nombres de los miembros del tipo, ejecutamos SetValue. A veces atrapamos excepciones en errores donde no encontramos alguna propiedad en uno de los tipos, pero incluso aquí hay una salida que mejora el rendimiento. Try/catch.
He visto cómo las personas reinventan los parsers y mappers sin tener toda la información sobre cómo funcionan las bicicletas que se inventaron antes. He observado cómo las personas ocultan sus implementaciones ingenuas detrás de estrategias, interfaces e inyecciones, como si eso pudiera disculpar el descontrol posterior. Me alejé de esas implementaciones. De hecho, no medí la verdadera filtración de rendimiento, y siempre que pude, simplemente cambiaba la implementación por una más "óptima", si tenía tiempo. Por eso, las primeras mediciones que se mencionan a continuación me sorprendieron seriamente.
Creo que muchos de ustedes, al leer a Richter u otros ideólogos, se han encontrado con la afirmación bastante justa de que la reflexión en el código es un fenómeno que impacta muy negativamente el rendimiento de la aplicación.
La llamada a la reflexión obliga al CLR a recorrer ensamblados en busca del necesario, cargar sus metadatos, parsearlos, etc. Además, la reflexión durante el recorrido de las secuencias conduce a la asignación de una gran cantidad de memoria. Al gastar memoria, el CLR activa el GC y comienzan las congelaciones. Esto debe ser notablemente lento, créanme. Los enormes volúmenes de memoria de los servidores de producción modernos o máquinas en la nube no salvan de las altas latencias en el procesamiento. De hecho, cuanto más memoria, mayor es la probabilidad de que USTED NOTE cómo funciona el GC. La reflexión es, en teoría, una innecesaria bandera roja para él.
Sin embargo, todos usamos tanto contenedores de IoC como mapeadores de datos, cuyo principio de funcionamiento también se basa en la reflexión, pero normalmente no surgen preguntas sobre su rendimiento. No, no porque la inyección de dependencias y la abstracción de modelos de un contexto externo limitado sean cosas tan necesarias que tengamos que sacrificar el rendimiento en cualquier caso. Es más simple: realmente no impactan mucho el rendimiento.
La cuestión es que los frameworks más comunes que se basan en la tecnología de reflexión utilizan diversos trucos para funcionar de manera más óptima con ella. Normalmente, esto es caching. Generalmente, se trata de Expressions y delegados compilados a partir de árboles de expresión. El mismo AutoMapper mantiene un diccionario concurrente, que empareja tipos con funciones que pueden convertir uno al otro sin invocar la reflexión.
¿Cómo se logra esto? En esencia, no es diferente de la lógica que utiliza la propia plataforma para generar código JIT. En la primera llamada al método, este se compila (y sí, este proceso no es rápido), en las llamadas posteriores, el control se transfiere al método ya compilado, y aquí no habrá caídas significativas en el rendimiento.
En nuestro caso, también podemos aprovechar la compilación JIT y luego utilizar el comportamiento compilado con el mismo rendimiento que sus análogos AOT. Para ayudarnos en esto, usaremos expresiones.
Se puede resumir el principio del que hablamos de la siguiente manera:
Es recomendable almacenar en caché el resultado final del trabajo de la reflexión en forma de delegado que contenga la función compilada. También tiene sentido almacenar en caché todos los objetos necesarios con información sobre los tipos en campos que se mantengan fuera de los objetos de su tipo: el trabajador.
Hay lógica en esto. El sentido común nos dice que si algo se puede compilar y almacenar en caché, entonces debemos hacerlo.
Sin adelantarme demasiado, debo decir que la caché en el trabajo con la reflexión tiene sus ventajas, incluso sin utilizar el método de compilación de expresiones propuesto. En este caso, simplemente repetiré los puntos del autor del artículo al que me refiero arriba.
Ahora hablemos del código. Veamos un ejemplo que se basa en un reciente problema que tuve que enfrentar en una producción seria de una organización crediticia importante. Todas las entidades son ficticias para que nadie pueda deducir.
Hay cierta entidad. Digamos que es un Contacto. Hay correos electrónicos con un cuerpo estandarizado, de los cuales un parser y un hidratador crean estos contactos. Llegó un correo, lo leímos, lo desglosamos en pares clave-valor, creamos un contacto y lo guardamos en la base de datos.
Es elemental. Supongamos que el contacto tiene propiedades de Nombre Completo, Edad y número de teléfono de contacto. Estos datos se envían en el correo. Además, el negocio quiere que los soportes puedan agregar rápidamente nuevas claves para mapear propiedades de la entidad a pares en el cuerpo del correo. En caso de que alguien cometa un error tipográfico en la plantilla o si, antes del lanzamiento, necesitamos lanzar con urgencia el mapeo de un nuevo compañero, adaptándonos a un nuevo formato. Entonces, podremos agregar la nueva correlación de mapeo como un fix de datos barato. Es decir, un ejemplo de la vida real.
Implementamos, creamos pruebas. Funciona.
No proporcionaré el código: hay muchos archivos fuente, y están disponibles en GitHub en el enlace al final del artículo. Puede descargarlos, modificarlos hasta que sean irreconocibles y medir cómo afectaría esto en su caso. Solo proporcionaré el código de dos métodos plantillas, que diferencian el hidratador que debía ser rápido del que debía ser lento.
La lógica es la siguiente: el método plantilla recibe pares formados por la lógica base del analizador. El nivel de LINQ es el analizador y la lógica base del hidratador, que realiza la consulta al contexto de la base de datos y empareja las claves con los pares del analizador (hay código sin LINQ para estas funciones para compararlas). Luego, los pares se envían al método principal de hidratación y los valores de las propiedades se establecen en las propiedades correspondientes de la entidad.
«Rápido» (Prefijo Fast en los benchmarks):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Como podemos ver, se utiliza una colección estática con los setter de las propiedades, lambdas compiladas que llaman al setter de la entidad. Se crean con el siguiente código:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
En general, es claro. Recorremos las propiedades, creamos delegados que llaman a los setters, y los almacenamos. Luego los llamamos cuando es necesario.
«Lento» (Prefijo Slow en los benchmarks):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Aquí recorremos las propiedades y llamamos directamente a SetValue.
Para la claridad y como referencia, implementé un método ingenuo que escribe los valores de sus pares de correlación directamente en los campos de la entidad. Prefijo: Manual.
Ahora tomamos BenchmarkDotNet y examinamos el rendimiento. Y de repente... (spoiler: este no es el resultado correcto, más detalles a continuación)
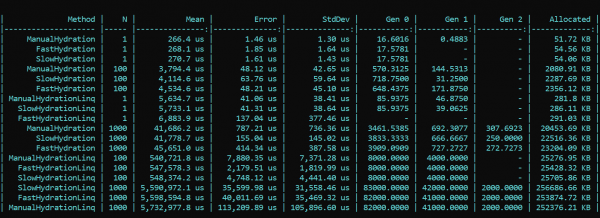
¿Qué vemos aquí? Los métodos que llevan con orgullo el prefijo Fast, en casi todas las iteraciones, son más lentos que los métodos con el prefijo Slow. Esto es cierto tanto para la asignación como para la velocidad de ejecución. Por otro lado, una implementación bonita y elegante de mapeo utilizando en todas partes los métodos LINQ diseñados para eso, por el contrario, consume mucho rendimiento. La diferencia es abismal. La tendencia no cambia con un número diferente de iteraciones. La única diferencia está en la magnitud. Con LINQ, es 4 a 200 veces más lento, y la cantidad de basura es aproximadamente en la misma escala.
ACTUALIZADO
No podía creer lo que veían mis ojos, pero lo que es más importante, ni él ni mi código confiaron en nuestra colega — . Al revisar mi solución, descubrió brillantemente y señaló un error que yo había pasado por alto debido a una serie de cambios en la implementación, desde el principio hasta el final. Después de corregir el error encontrado en la configuración de Moq, todos los resultados se alinearon. Según los resultados de la nueva prueba, la tendencia principal no cambia: LINQ afecta el rendimiento de forma más significativa que la reflexión. Sin embargo, es agradable que trabajar con la compilación de expresiones no sea en vano, y el resultado es visible tanto en la asignación como en el tiempo de ejecución. La primera ejecución, cuando se inicializan los campos estáticos, es lógicamente más lenta en el método 'rápido', pero luego la situación cambia.
Aquí está el resultado de la nueva prueba:
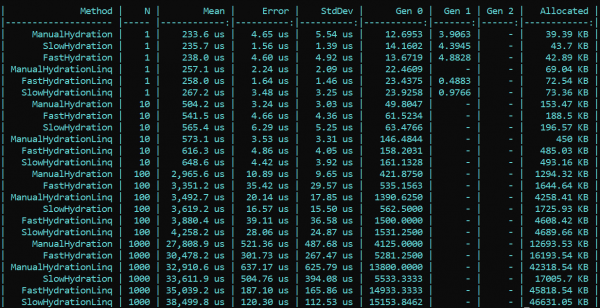
Conclusión: al utilizar reflexión en el ámbito empresarial, no se requieren especialmente trucos complicados—LINQ devorará el rendimiento de manera más fuerte. Sin embargo, en métodos de alta carga que requieren optimización, se puede mantener la reflexión en forma de inicializadores y compiladores de delegados que luego asegurarán una lógica 'rápida'. Así, puedes mantener tanto la flexibilidad de la reflexión como la velocidad de funcionamiento de la aplicación.
El código con el benchmark está disponible aquí. Todos los interesados pueden verificar mis palabras:
PS: El código en las pruebas utiliza IoC, y en los benchmarks – una construcción explícita. La cuestión es que en la implementación final eliminé todos los factores que podrían afectar el rendimiento y enturbiar los resultados.
PPS: Gracias al usuario por descubrir mi error en la configuración de Moq, que afectó las primeras mediciones. Si alguno de los lectores tiene suficiente karma, por favor, denle un 'me gusta'. La persona se detuvo, se tomó el tiempo de leer, revisó y señaló el error. Creo que eso merece respeto y aprecio.
PPPS: Gracias a ese minucioso lector que se fijó en la estética y el formato. Estoy a favor de la uniformidad y la comodidad. La diplomacia en la presentación deja mucho que desear, pero he tomado en cuenta la crítica. Por favor, dirígete al grano.
Fuente: habr.com
