

Hasta hace poco, en Odnoklassniki había alrededor de 50 TB de datos procesados en tiempo real almacenados en SQL Server. Para tal volumen, proporcionar un acceso rápido, confiable y además resistente a fallos a un centro de datos usando una base de datos SQL es prácticamente imposible. Por lo general, en tales casos se utiliza uno de los almacenes NoSQL, pero no todo se puede trasladar a NoSQL: algunas entidades requieren garantías de transacciones ACID.
Esto nos llevó a utilizar un almacén NewSQL, es decir, una base de datos que proporciona la resistencia a fallos, escalabilidad y velocidad de los sistemas NoSQL, pero manteniendo las garantías ACID habituales de los sistemas clásicos. Existen pocos sistemas industriales de esta nueva clase, por lo que decidimos implementar uno nosotros mismos y ponerlo en producción.
Cómo funciona y qué logramos, lo puedes leer a continuación.
Hoy en día, la audiencia mensual de «Odnoklassniki» supera los 70 millones de visitantes únicos. Nosotros principales redes sociales del mundo, y en el vigésimo lugar entre los sitios donde los usuarios pasan más tiempo. La infraestructura de «OK» procesa cargas muy altas: más de un millón de solicitudes HTTP/seg en los frentes. Las partes del parque de servidores, que suman más de 8000 unidades, están ubicadas cerca unas de otras, en cuatro centros de datos en Moscú, lo que permite garantizar una latencia de red de menos de 1 ms entre ellos.
Utilizamos Cassandra desde 2010, comenzando con la versión 0.6. Hoy en día hay en operación varias decenas de clústeres. El clúster más rápido procesa más de 4 millones de operaciones por segundo, y el más grande almacena 260 TB.
Sin embargo, todos estos son clústeres NoSQL convencionales que se utilizan para el almacenamiento Nosotros queríamos reemplazar el almacenamiento principal consistente, Microsoft SQL Server, que se había utilizado desde la fundación de «Odnoklassniki». El almacenamiento consistía en más de 300 máquinas de SQL Server Standard Edition, que contenían 50 TB de datos: entidades de negocio. Estos datos se modifican en el marco de transacciones ACID y requieren .
Para distribuir los datos entre los nodos de SQL Server utilizamos tanto particionamiento vertical como horizontal. (sharding). Históricamente, hemos utilizado un esquema simple de sharding de datos: a cada entidad se le asigna un token, que es una función del ID de la entidad. Las entidades con el mismo token se colocan en un mismo servidor SQL. La relación tipo maestro-detalle se implementaba para que los tokens del registro principal y del registro derivado coincidieran siempre y estuvieran en el mismo servidor. En una red social, casi todos los registros se generan en nombre del usuario, lo que significa que todos los datos del usuario dentro de un mismo subsistema funcional se almacenan en un único servidor. Es decir, en la transacción comercial, casi siempre estaban involucradas tablas de un mismo servidor SQL, lo que permitía garantizar la coherencia de los datos mediante transacciones ACID locales, sin necesidad de usar . Gracias al sharding y para acelerar el funcionamiento de SQL:
No usamos restricciones de claves foráneas, ya que al hacer sharding, el ID de una entidad puede estar en otro servidor.
- No utilizamos procedimientos almacenados ni disparadores debido a la carga adicional en la CPU de la DBMS.
- No usamos JOINs debido a todo lo anterior y a la gran cantidad de lecturas aleatorias desde el disco.
- Fuera de las transacciones, para reducir los bloqueos mutuos, usamos el nivel de aislamiento Read Uncommitted.
- Solo ejecutamos transacciones cortas (en promedio, más cortas de 100 ms).
- No utilizamos UPDATE y DELETE multi-fila debido a la gran cantidad de bloqueos mutuos; actualizamos solo un registro a la vez.
- Siempre ejecutamos consultas solo por índices; una consulta con un plan de recorrido completo de la tabla para nosotros significa sobrecarga de la base de datos y su fallo.
- Estos pasos permitieron exprimir casi el máximo rendimiento de los servidores SQL. Sin embargo, cada vez había más problemas. Vamos a revisarlos.
Problemas con SQL
Dado que utilizamos un sharding hecho a medida, la adición de nuevos shards era realizada manualmente por los administradores. Durante todo este tiempo, las réplicas de datos escalables no atendían las consultas.
- A medida que crece el número de registros en la tabla, disminuye la velocidad de inserción y modificación; al agregar índices a una tabla existente, la velocidad cae drásticamente, la creación y recreación de índices se realiza con tiempo de inactividad.
- La presencia de un pequeño número de Windows para SQL Server en producción dificulta la gestión de la infraestructura.
- Pero el principal problema es —
Pero el principal problema es —
Tolerancia a fallos
Un servidor SQL clásico tiene una mala resistencia a fallos. Supongamos que solo tienes un servidor de base de datos y falla una vez cada tres años. Durante ese tiempo, el sitio no funciona durante 20 minutos, lo cual es aceptable. Si tienes 64 servidores, el sitio no funciona una vez cada tres semanas. Y si tienes 200 servidores, el sitio no funciona cada semana. Ese es el problema.
¿Qué se puede hacer para mejorar la resistencia a fallos del servidor SQL? Wikipedia nos sugiere construir : donde, en caso de falla de cualquiera de los componentes, hay un respaldo.
Esto requiere un parque de costoso equipamiento: una gran duplicación, fibra óptica, almacenamiento compartido, y el activado del respaldo funciona de manera poco fiable: alrededor del 10% de las activaciones terminan en el fallo de un nodo de respaldo siguiendo al nodo principal.
Pero la principal desventaja de un clúster de alta disponibilidad así es la nula disponibilidad en caso de fallo del centro de datos donde está ubicado. «Odnoklassniki» tiene cuatro centros de datos, y necesitamos asegurar su funcionamiento ante una falla completa en uno de ellos.
Para esto, podríamos aplicar integrada en SQL Server. Esta solución es considerablemente más cara debido al costo del software y padece de problemas bien conocidos con la replicación: demoras impredecibles en las transacciones durante la replicación síncrona y demoras en la aplicación de replicaciones (y, como consecuencia, modificaciones perdidas) en la replicación asíncrona. La hace que esta opción sea completamente inaplicable para nosotros.
Todos estos problemas requerían una solución radical y comenzamos a analizarlos en detalle. Aquí necesitamos familiarizarnos con lo que principalmente hace SQL Server: las transacciones.
Transacción simple
Consideremos la transacción más simple, desde el punto de vista de un programador SQL aplicado: añadir una foto a un álbum. Los álbumes y las fotos se almacenan en tablas diferentes. Un álbum tiene un contador de fotos públicas. Entonces, esta transacción se divide en los siguientes pasos:
- Bloqueamos el álbum por clave.
- Creamos una entrada en la tabla de fotos.
- Si la foto tiene un estado público, incrementamos en el álbum el contador de fotos públicas, actualizamos la entrada y hacemos commit de la transacción.
O en forma de pseudocódigo:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vemos que el escenario de transacción empresarial más común es leer datos de la base de datos en la memoria del servidor de aplicaciones, realizar algún cambio y guardar los nuevos valores de vuelta en la base de datos. Normalmente, en tal transacción actualizamos varias entidades, varias tablas.
Al ejecutar una transacción, puede ocurrir la modificación concurrente de los mismos datos desde otro sistema. Por ejemplo, el Antispam puede decidir que un usuario es sospechoso y, por lo tanto, todas las fotos de ese usuario ya no deben ser públicas, deben enviarse a moderación, lo que significa que hay que cambiar photo.status a otro valor y ajustar los contadores correspondientes. Es obvio que si esta operación se realiza sin garantías de atomicidad en la aplicación y de aislamiento de modificaciones competidoras, como en , el resultado no será el deseado: o el contador de fotos mostrará un valor incorrecto, o no todas las fotos serán enviadas a moderación.
Se ha escrito mucho código como este, que manipula diversas entidades comerciales dentro de una única transacción, a lo largo de la existencia de Odnoklassniki. A partir de la experiencia de migraciones a NoSQL con , sabemos que las mayores dificultades (y gastos de tiempo) surgen de la necesidad de desarrollar código destinado a mantener la consistencia de los datos. Por lo tanto, el principal requisito para el nuevo almacenamiento fue asegurar a la lógica de aplicación transacciones ACID reales.
Otros requisitos no menos importantes fueron:
- En caso de falla del centro de datos, tanto la lectura como la escritura deben ser posibles en el nuevo almacenamiento.
- Mantener la actual velocidad de desarrollo. Es decir, al trabajar con el nuevo almacenamiento, la cantidad de código debe ser aproximadamente la misma, no debe haber necesidad de escribir algo adicional en el almacenamiento, desarrollar algoritmos de resolución de conflictos, mantener índices secundarios, etc.
- La velocidad de funcionamiento del nuevo almacenamiento debe ser suficientemente alta, tanto para la lectura de datos como para el procesamiento de transacciones, lo que significa efectivamente que no se pueden aplicar soluciones estrictamente académicas, universales pero lentas, como por ejemplo, .
- Escalado automático en tiempo real.
- Uso de servidores estándar y económicos, sin necesidad de comprar hardware exótico.
- Posibilidad de desarrollar el almacenamiento con el esfuerzo de los desarrolladores de la empresa. En otras palabras, se priorizaban soluciones internas o de código abierto, preferiblemente en Java.
Soluciones, soluciones
Analizando las posibles soluciones, llegamos a dos opciones posibles de arquitectura:
La primera opción es tomar cualquier servidor SQL y realizar la redundancia necesaria, el mecanismo de escalado, un clúster tolerante a fallos, resolución de conflictos y transacciones ACID distribuidas, confiables y rápidas. Evaluamos esta opción como bastante no trivial y laboriosa.
La segunda opción es adoptar un almacén NoSQL listo para usar con escalabilidad implementada, un clúster tolerante a fallos, resolución de conflictos y realizar transacciones y SQL por nuestra cuenta. A primera vista, incluso la tarea de implementar SQL, sin mencionar las transacciones ACID, parece un desafío de años. Pero luego entendimos que el conjunto de funcionalidades SQL que utilizamos en la práctica está tan lejos de ANSI SQL como está lejos de ANSI SQL. Al examinar más de cerca CQL, nos dimos cuenta de que se acerca bastante a lo que necesitamos.
Cassandra y CQL
Entonces, ¿qué hace interesante a Cassandra, qué capacidades tiene?
En primer lugar, aquí puedes crear tablas que soporten diversos tipos de datos, puedes hacer SELECT o UPDATE por clave primaria.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Para garantizar la consistencia de los datos de las réplicas, Cassandra utiliza . En el caso más simple, esto significa que al colocar tres réplicas de la misma fila en diferentes nodos del clúster, la escritura se considera exitosa si la mayoría de los nodos (es decir, dos de tres) han confirmado el éxito de esta operación de escritura. Los datos de la fila se consideran consistentes si, al leer, se han interrogado y confirmado la mayoría de los nodos. Así, con tres réplicas se garantiza una consistencia total e instantánea de los datos en caso de fallo de un nodo. Este enfoque nos ha permitido implementar un esquema aún más fiable: siempre enviar solicitudes a las tres réplicas, esperando la respuesta de las dos más rápidas. La respuesta retrasada de la tercera réplica se descarta en este caso. El nodo que se retrasa en responder puede tener problemas serios: lentitud, recolección de basura en la JVM, reclamación de memoria directa en el núcleo de Linux, fallos de hardware, desconexión de la red. Sin embargo, esto no afecta la operación del cliente ni los datos.
El enfoque en el que consultamos a tres nodos y recibimos respuesta de dos se llama : solicitar réplicas adicionales se envía antes de que se "caiga".
Otra de las ventajas de Cassandra es Batchlog, un mecanismo que garantiza la aplicación completa o la no aplicación total de un lote de cambios que usted realice. Esto nos permite resolver A en ACID: atomicidad de manera predeterminada.
Lo más cercano a las transacciones en Cassandra son las llamadas. Pero están muy lejos de las "verdaderas" transacciones ACID: de hecho, es posible hacer un solo en los datos de un solo registro, utilizando el consenso del pesado protocolo Paxos. Por lo tanto, la velocidad de estas transacciones no es alta.
Lo que nos falta en Cassandra
Así que teníamos que implementar en Cassandra verdaderas transacciones ACID. Con las que podríamos implementar fácilmente otras dos capacidades útiles de los DBMS clásicos: índices rápidos consistentes, que nos permitirían realizar consultas de datos no solo por la clave primaria, y un generador ordinario de ID autoincrementales monotónicos.
C*One
Así nació una nueva base de datos C*One, compuesta por tres tipos de nodos de servidor:
- Almacenadores — servidores Cassandra (casi) estándar, responsables de almacenar datos en discos locales. A medida que crece la carga y el volumen de datos, su número se puede escalar fácilmente a decenas y centenas.
- Los coordinadores de transacciones garantizan la ejecución de las transacciones.
- Los clientes son servidores de aplicaciones que realizan operaciones comerciales e inician transacciones. Puede haber miles de tales clientes.
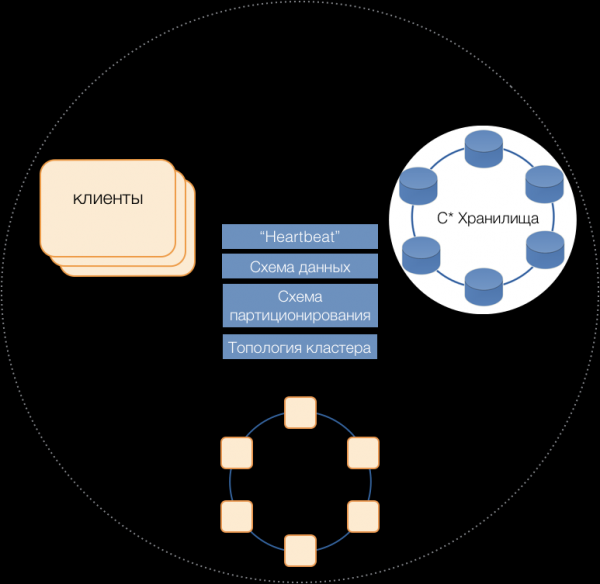
Los servidores de todos los tipos están en un clúster común, utilizan el protocolo interno de mensajes Cassandra para comunicarse entre sí y para intercambiar información del clúster. A través de Heartbeat, los servidores detectan fallos mutuos, mantienen un esquema de datos único: tablas, su estructura y replicación; esquema de particionamiento, topología del clúster, etc.
Clientes
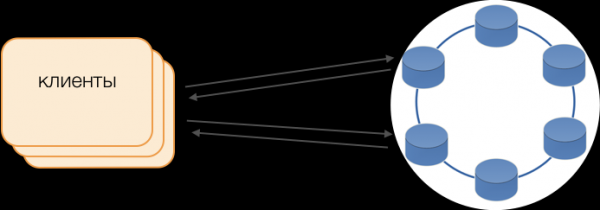
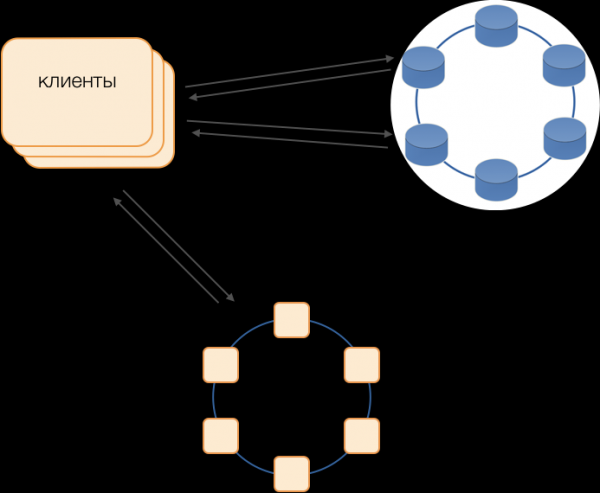
En lugar de controladores estándar, se utiliza el modo Fat Client. Este nodo no almacena datos, pero puede actuar como coordinador de ejecución de solicitudes, es decir, el cliente mismo cumple la función de coordinador de sus solicitudes: interroga las réplicas del almacenamiento y resuelve los conflictos. Esto es no solo más fiable y rápido que el controlador estándar, que requiere comunicación con un coordinador remoto, sino que también permite gestionar la transmisión de solicitudes. Fuera de la transacción abierta en el cliente, las solicitudes se dirigen a los almacenes. Si el cliente ha abierto una transacción, entonces todas las solicitudes dentro de la transacción se envían al coordinador de transacciones.
Coordinador de transacciones C*One
El coordinador es lo que hemos implementado para C*One desde cero. Se encarga de gestionar transacciones, bloqueos y el orden de aplicación de las transacciones.
Para cada transacción atendida, el coordinador genera una marca de tiempo: cada sucesiva es mayor que la de la transacción anterior. Dado que en Cassandra el sistema de resolución de conflictos se basa en marcas de tiempo (de dos registros en conflicto, se considera válido el que tiene la marca de tiempo más reciente), el conflicto siempre se resolverá a favor de la transacción posterior. Así es como hemos implementado — una forma económica de resolver conflictos en un sistema distribuido.
Bloqueos
Para garantizar la aislamiento, decidimos utilizar el método más simple: bloqueos pesimistas por la clave primaria del registro. En otras palabras, en la transacción, el registro debe ser bloqueado primero, y solo después leerse, modificarse y guardarse. Solo después de un commit exitoso, el registro puede ser desbloqueado para que las transacciones en competencia puedan utilizarlo.
La implementación de tal bloqueo es sencilla en un entorno no distribuido. En un sistema distribuido hay dos enfoques principales: implementar un bloqueo distribuido en el clúster o distribuir las transacciones de tal manera que las transacciones que involucren un mismo registro sean siempre atendidas por el mismo coordinador.
Dado que en nuestro caso los datos ya están distribuidos en grupos de transacciones locales en SQL, se decidió asignar a los coordinadores de grupos de transacciones locales: un coordinador maneja todas las transacciones con un token del 0 al 9, el segundo con un token del 10 al 19, y así sucesivamente. Como resultado, cada una de las instancias del coordinador se convierte en el maestro del grupo de transacciones.
Entonces, los bloqueos pueden ser implementados como un simple HashMap en la memoria del coordinador.
Fallas de los coordinadores
Dado que un coordinador atiende exclusivamente a un grupo de transacciones, es muy importante determinar rápidamente la ocurrencia de su falla para que el reintento de ejecución de la transacción se realice dentro del tiempo de espera. Para esto, aplicamos un protocolo de heartbeat con quórum totalmente conectado:
En cada centro de datos se aloja un mínimo de dos nodos coordinadores. Periódicamente, cada coordinador envía un mensaje de heartbeat a los otros coordinadores y les informa sobre su funcionamiento, así como sobre qué mensajes de heartbeat de qué coordinadores en el clúster ha recibido por última vez.
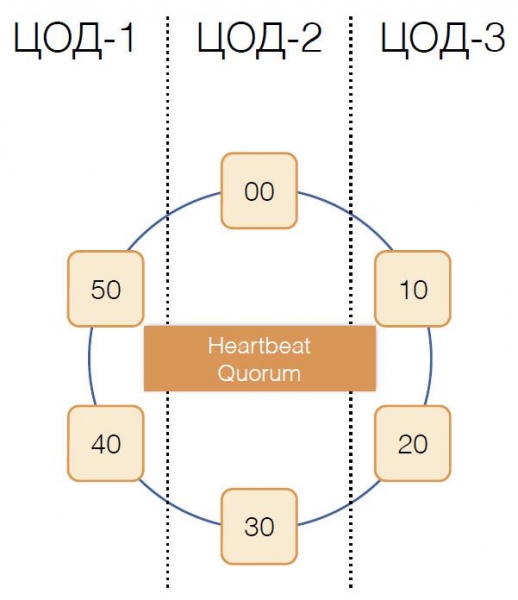
Al recibir información similar de los demás en sus mensajes de heartbeat, cada coordinador decide para sí mismo qué nodos del clúster están funcionando y cuáles no, guiándose por el principio de quórum: si el nodo X ha recibido información de la mayoría de los nodos en el clúster sobre la normal recepción de mensajes del nodo Y, entonces Y está funcionando. Y viceversa, tan pronto como la mayoría informe sobre la falta de mensajes del nodo Y, significa que Y ha fallado. Curiosamente, si el quórum informa al nodo X que no recibe más mensajes de él, entonces el mismo nodo X se considerará fallido.
Los mensajes de heartbeat se envían con gran frecuencia, alrededor de 20 veces por segundo, con un período de 50 ms. Es difícil garantizar una respuesta de la aplicación en Java dentro de 50 ms debido a la duración comparable de las pausas causadas por el recolector de basura. Logramos alcanzar este tiempo de respuesta utilizando el recolector de basura G1, que permite especificar un objetivo para la duración de las pausas de GC. Sin embargo, a veces, aunque raramente, las pausas del recolector exceden los 50 ms, lo que puede llevar a una falsa detección de fallos. Para evitar esto, el coordinador no informa sobre la falla de un nodo remoto tras la pérdida del primer mensaje de heartbeat, sino solo si se pierden varios de forma consecutiva. Así logramos detectar la falla de un nodo coordinador en 200 ms.
Pero no basta con entender rápidamente qué nodo ha dejado de funcionar. Hay que hacer algo al respecto.
Redundancia
El esquema clásico prevé, en caso de fallo del maestro, iniciar las elecciones de uno nuevo mediante uno de los algoritmos. Sin embargo, estos algoritmos tienen problemas bien conocidos de convergencia a lo largo del tiempo y duración del propio proceso de elecciones. Hemos logrado evitar tales retrasos adicionales mediante un esquema de sustitución de coordinadores en una red completamente conectada:
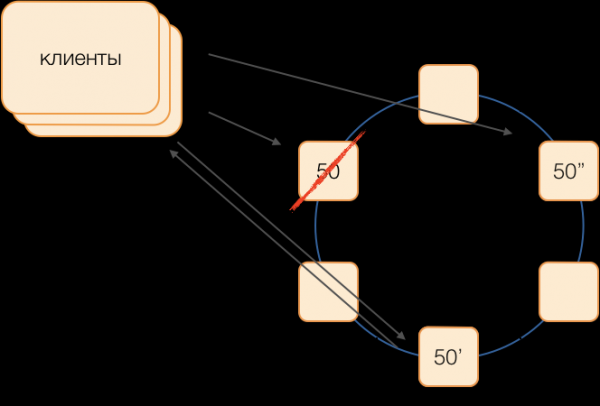
Supongamos que queremos ejecutar una transacción en el grupo 50. Definiremos de antemano el esquema de sustitución, es decir, qué nodos ejecutarán las transacciones del grupo 50 en caso de fallo del coordinador principal. Nuestro objetivo es mantener la operatividad del sistema ante la falla de un centro de datos. Definiremos que el primer respaldo será un nodo de otro centro de datos y el segundo respaldo será un nodo del tercero. Este esquema se elige una vez y no cambia hasta que la topología del clúster cambie, es decir, hasta que entren nuevos nodos (lo cual sucede muy raramente). El orden de selección de un nuevo maestro activo en caso de fallo del antiguo será siempre el siguiente: el primer respaldo se convertirá en el maestro activo, y si este también deja de funcionar, el segundo respaldo.
Este esquema es más confiable que un algoritmo universal, ya que para activar un nuevo maestro solo es necesario confirmar el hecho de falla del antiguo.
¿Pero cómo podrán los clientes entender qué maestro está trabajando en este momento? En 50 ms es imposible enviar información a miles de clientes. Puede haber una situación en la que el cliente envíe una solicitud para abrir una transacción sin saber que este maestro ya no está operativo, y la solicitud quedará pendiente por tiempo de espera. Para evitar esto, los clientes envían especulativamente la solicitud para abrir una transacción al maestro del grupo y a sus dos reservas, pero solo responderá a esta solicitud aquel que sea el maestro activo en ese momento. Toda la posterior comunicación en el marco de la transacción se realizará únicamente con el maestro activo.
Los maestros de reserva colocan las solicitudes recibidas para transacciones que no les pertenecen en una cola de transacciones no nacidas, donde se almacenan durante algún tiempo. Si el maestro activo muere, entonces un nuevo maestro procesará las solicitudes para abrir transacciones desde su cola y responderá al cliente. Si el cliente ya ha logrado abrir una transacción con el antiguo maestro, la segunda respuesta se ignora (y, evidentemente, tal transacción no se completará y será repetida por el cliente).
Cómo funciona la transacción
Supongamos que el cliente envió una solicitud al coordinador para abrir una transacción para tal entidad con tal clave primaria. El coordinador bloquea esta entidad y la coloca en la tabla de bloqueos en memoria. Si es necesario, el coordinador lee esta entidad del almacenamiento y guarda los datos obtenidos en el estado de la transacción en la memoria del coordinador.
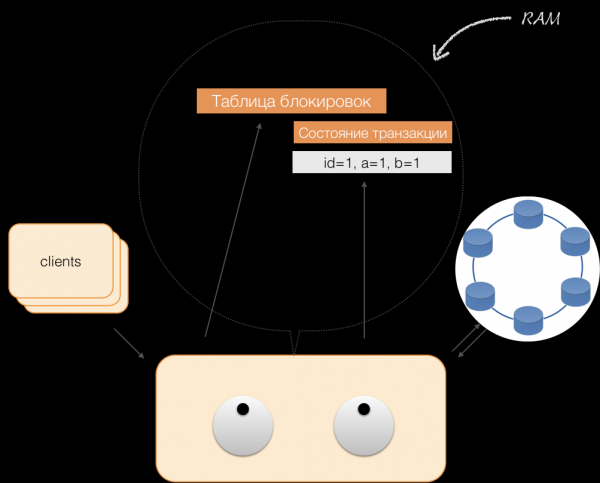
Cuando el cliente quiere modificar datos en la transacción, envía al coordinador una solicitud para modificar la entidad, y este coloca los nuevos datos en la tabla de estado de transacciones en memoria. En este punto, la grabación se completa: no se realiza ningún registro en el almacenamiento.
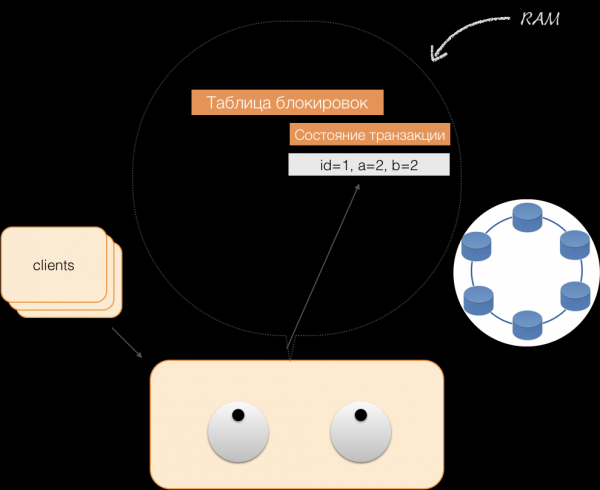
Cuando el cliente solicita en el marco de una transacción activa sus propios datos modificados, el coordinador actúa de la siguiente manera:
- si el ID ya está en la transacción, los datos se obtienen de la memoria;
- si el ID no está en la memoria, los datos faltantes se leen de los nodos de almacenamiento, se combinan con los que ya están en memoria, y el resultado se entrega al cliente.
De este modo, el cliente puede leer sus propios cambios, mientras que otros clientes no ven esos cambios, porque se almacenan únicamente en la memoria del coordinador, y aún no están en los nodos de Cassandra.
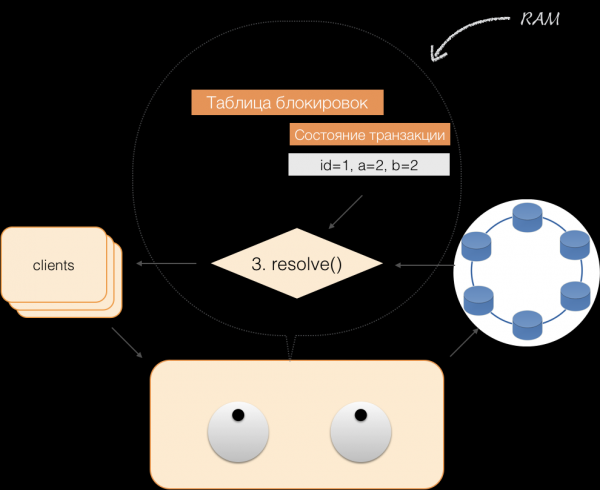
Cuando un cliente envía un commit, el estado que tenía el servicio en memoria se guarda por el coordinador en un logged batch, que luego se envía a los almacenes de Cassandra. Los almacenes hacen todo lo necesario para que este paquete se aplique de manera atómica (completamente) y devuelven una respuesta al coordinador, quien libera los bloqueos y confirma la exitosa transacción al cliente.
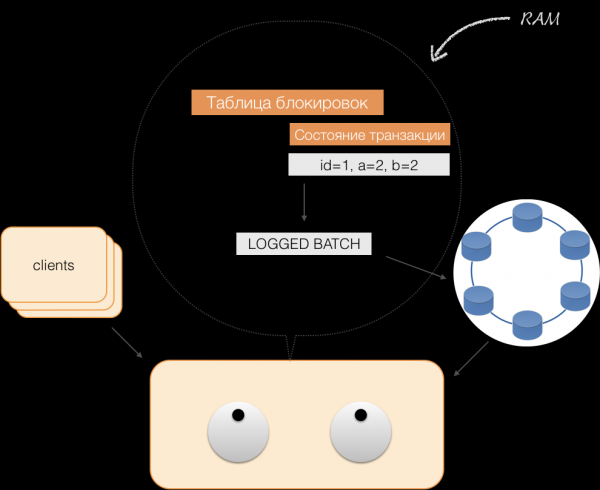
Y para deshacer, al coordinador solo le basta con liberar la memoria ocupada por el estado de la transacción.
Como resultado de las mejoras descritas, hemos implementado los principios ACID:
- Atomicidad. Esta es la garantía de que ninguna transacción se registrará parcialmente en el sistema; se ejecutarán todas sus suboperaciones o no se ejecutará ninguna. Este principio se cumple en nuestro caso gracias al logged batch en Cassandra.
- Consistencia. Cada transacción exitosa, por definición, registra solo resultados válidos. Si después de abrir una transacción y ejecutar parte de las operaciones se descubre que el resultado no es válido, se realiza un rollback.
- Aislamiento. Al realizar una transacción, las transacciones paralelas no deben influir en su resultado. Las transacciones que compiten están aisladas mediante bloqueos pesimistas en el coordinador. Para lecturas fuera de la transacción, se cumple el principio de aislamiento a nivel de Read Committed.
- Sostenibilidad. Independientemente de los problemas en los niveles inferiores — corte de energía, fallo de hardware — los cambios realizados por una transacción que se haya completado con éxito deben permanecer guardados después de reanudar el funcionamiento.
Lectura por índices
Tomemos una tabla simple:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Tiene un ID (clave primaria), un propietario y una fecha de modificación. Necesitamos hacer una consulta muy simple: seleccionar datos por propietario en la fecha de modificación "en las últimas 24 horas".
SELECT *
WHERE owner=?
AND modified>?
Para que tal consulta se ejecute rápidamente, en una base de datos SQL clásica se debe construir un índice sobre las columnas (owner, modified). Esto podemos hacerlo con bastante facilidad, ya que ahora tenemos garantías ACID.
Índices en C*One
Hay una tabla original con fotografías, donde el ID del registro es la clave primaria.
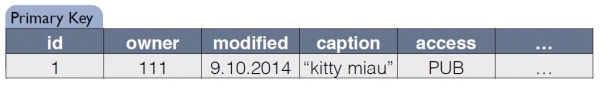
Para el índice, C*One crea una nueva tabla que es una copia de la original. La clave coincide con la expresión del índice, incluyendo también la clave primaria del registro de la tabla original:
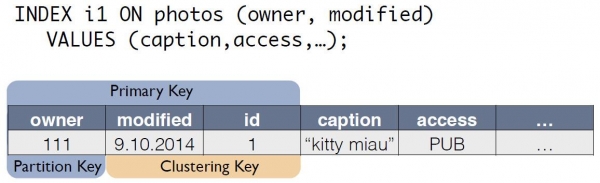
Ahora se puede reescribir la consulta por "propietario en las últimas 24 horas" como un select de otra tabla:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
La coherencia de los datos de la tabla original photos y la tabla de índice i1 es mantenida automáticamente por el coordinador. Basándose solo en el esquema de datos, al recibir cambios, el coordinador genera y almacena cambios no solo de la tabla principal, sino también de las copias. No se realizan acciones adicionales en la tabla de índice, no se leen logs, no se utilizan bloqueos. Es decir, agregar índices consume casi ningún recurso y prácticamente no afecta la velocidad de aplicación de modificaciones.
Con ACID hemos logrado implementar índices "como en SQL". Tienen coherencia, pueden escalar, funcionan rápidamente, pueden ser compuestos e integrados en el lenguaje de consultas CQL. No es necesario hacer cambios en el código de aplicación para soportar índices. Es tan simple como en SQL. Y lo más importante, los índices no afectan la velocidad de ejecución de modificaciones en la tabla de transacciones original.
¿Qué resultados se obtuvieron?
Desarrollamos C*One hace tres años y lo lanzamos para uso industrial.
¿Qué hemos logrado al final? Evaluemos esto con el ejemplo del subsistema de procesamiento y almacenamiento de fotos, uno de los tipos de datos más importantes en la red social. No se trata de las imágenes en sí, sino de la variada metainformación. Actualmente en "Odnoklassniki" hay alrededor de 20 mil millones de tales registros, el sistema procesa 80 mil consultas de lectura por segundo, hasta 8 mil transacciones ACID por segundo relacionadas con la modificación de datos.
Cuando utilizamos SQL con un factor de replicación = 1 (pero en RAID 10), la metainformación de las fotos se almacenaba en un clúster de alta disponibilidad de 32 máquinas con Microsoft SQL Server (más 11 de respaldo). También se reservaron 10 servidores para almacenar copias de seguridad. En total, 50 máquinas costosas. Mientras tanto, el sistema funcionaba bajo carga nominal, sin margen.
Después de migrar al nuevo sistema, obtuvimos un factor de replicación = 3 — con una copia en cada centro de datos. El sistema consiste en 63 nodos de almacenamiento de Cassandra y 6 máquinas coordinadoras, un total de 69 servidores. Pero estas máquinas son significativamente más baratas, su costo total es de aproximadamente el 30 % del costo del sistema en SQL. A su vez, la carga se mantiene en un 30 %.
Con la implementación de C*One, también se redujeron los tiempos de latencia: en SQL, la operación de escritura tomaba alrededor de 4,5 ms. En C*One, es de aproximadamente 1,6 ms. La duración de la transacción es en promedio menor a 40 ms, el commit se realiza en 2 ms, y la duración de lectura y escritura es en promedio 2 ms. El percentil 99 es de solo 3-3,1 ms, y el número de timeouts se redujo en 100 veces, todo gracias a la amplia aplicación de especulaciones.
Hasta el momento, se ha retirado la mayor parte de los nodos de SQL Server de la explotación, y los nuevos productos solo se desarrollan utilizando C*One. Hemos adaptado C*One para su funcionamiento en nuestra nube. , lo que ha permitido acelerar el despliegue de nuevos clústeres, simplificar la configuración y automatizar la operación. Sin el código fuente, esto habría sido significativamente más complicado y poco práctico.
Ahora estamos trabajando en la migración de nuestros otros almacenes a la nube, pero esa ya es una historia completamente diferente.
Fuente: habr.com
