

Este artículo es la traducción de mi artículo en Medium — , que resultó ser bastante popular, probablemente debido a su simplicidad. Por eso decidí escribirlo en español y complementarlo un poco para que una persona común, que no es especialista en datos, pueda entender qué es un almacén de datos (DW), qué es un lago de datos (Data Lake) y cómo coexisten juntos.
¿Por qué quise escribir sobre el lago de datos? He trabajado con datos y analítica durante más de 10 años, y actualmente trabajo con big data en Amazon Alexa AI en Cambridge, cerca de Boston, aunque vivo en Victoria, en la isla de Vancouver, y a menudo estoy en Boston, Seattle y Vancouver, y a veces incluso doy conferencias en Moscú. También escribo de vez en cuando, pero principalmente en inglés, y ya he escrito , además de que tengo la necesidad de compartir tendencias de analítica desde América del Norte, y a veces escribo en .
Siempre he trabajado con almacenes de datos, y desde 2015 he estado trabajando estrechamente con Amazon Web Services y, de hecho, me he enfocado en la analítica en la nube (AWS, Azure, GCP). He observado la evolución de las soluciones de analítica desde 2007 y he trabajado en un proveedor de almacenes de datos, Teradata, implementándola en Sberbank, fue entonces cuando apareció Big Data con Hadoop. Todos comenzaron a decir que la era de los almacenes había terminado y que ahora todo era Hadoop, y luego se empezó a hablar de Data Lake, de nuevo diciendo que ahora definitivamente el almacén de datos había llegado a su fin. Pero afortunadamente (quizás para algunos desgraciadamente, quienes ganaron mucho dinero configurando Hadoop), el almacén de datos no ha desaparecido.
En este artículo vamos a explorar qué es un lago de datos. Está dirigido a personas que tienen poca o ninguna experiencia con almacenes de datos.
En la imagen, el lago Bled, es uno de mis lagos favoritos, aunque solo he estado allí una vez, pero lo recuerdo toda mi vida. Pero hablaremos de otro tipo de lago: el lago de datos. Es posible que muchos de ustedes ya hayan escuchado este término varias veces, pero una definición más no le vendrá mal a nadie.
Primero que nada, aquí están las definiciones más populares de Lago de Datos:
"almacenamiento de archivos de todos los tipos de datos en bruto, que están disponibles para análisis por cualquier persona en la organización" — Martin Fowler.
«Si piensas que un lago de datos es como una botella de agua: purificada, embotellada y envasada para un consumo fácil, entonces un lago de datos es un enorme reservorio de agua en su estado natural. Los usuarios pueden recoger agua para sí mismos, zambullirse y explorar» — James Dixon.
Ahora sabemos con certeza que un lago de datos se trata de analítica; nos permite almacenar grandes volúmenes de datos en su forma original y tenemos acceso conveniente a la información.
A menudo me gusta simplificar las cosas. Si puedo explicar un término complejo de manera sencilla, significa que he entendido cómo funciona y para qué sirve. Por ejemplo, mientras revisaba fotos en mi iPhone, me di cuenta de que esto era un verdadero lago de datos. Incluso hice una diapositiva para conferencias:
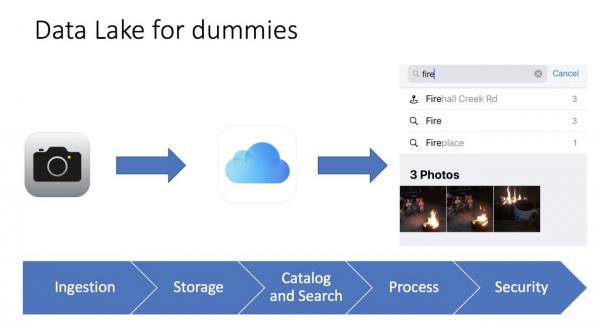
Es muy simple. Tomamos una foto con el teléfono, la imagen se guarda en el dispositivo y puede ser almacenada en iCloud (almacenamiento en la nube). Además, el teléfono recopila metadatos de la foto: qué se muestra, la geolocalización y la hora. Como resultado, podemos utilizar la interfaz del iPhone para encontrar nuestra foto y, además, ver los indicadores. Por ejemplo, al buscar fotos con la palabra fuego (fire), encuentro 3 imágenes de una fogata. Para mí, esto es como una herramienta de Business Intelligence que funciona de manera rápida y precisa.
Y, por supuesto, no debemos olvidar la seguridad (autorización y autenticación), de lo contrario, nuestros datos pueden estar fácilmente expuestos. Hay muchas noticias sobre grandes corporaciones y startups cuyos datos han quedado al descubierto debido a la negligencia de los desarrolladores y la falta de cumplimiento de reglas simples.
Incluso una imagen tan sencilla nos ayuda a visualizar qué es un lago de datos, sus diferencias con un almacén de datos tradicional y sus elementos clave:
- Carga de datos (Ingesta) — un componente clave del lago de datos. Los datos pueden ingresar al almacenamiento de datos de dos maneras: batch (carga por intervalos) y streaming (flujo de datos).
- Almacenamiento de archivos (Almacenamiento) — el componente principal del Lago de Datos. Necesitamos que el almacenamiento sea fácilmente escalable, extremadamente confiable y de bajo costo. Por ejemplo, en AWS es S3.
- Catálogo y Búsqueda (Catálogo y Búsqueda) — para evitar el Mar de Datos (que es cuando acumulamos todos los datos en un solo lugar, haciendo imposible trabajar con ellos), necesitamos crear una capa de metadatos para clasificar los datos, de modo que los usuarios puedan encontrar fácilmente la información necesaria para su análisis. Además, se pueden utilizar soluciones adicionales para la búsqueda, como ElasticSearch. La búsqueda ayuda al usuario a encontrar los datos que necesita a través de interfaces fáciles de usar.
- Procesamiento (Proceso) — este paso se encarga del procesamiento y transformación de los datos. Podemos transformar los datos, cambiar sus estructuras, limpiarlos y mucho más.
- Seguridad (Seguridad) — es importante dedicar tiempo al diseño de la seguridad de la solución. Por ejemplo, cifrado de datos durante el almacenamiento, procesamiento y carga. Es esencial utilizar métodos de autenticación y autorización. En conclusión, se necesita una herramienta de auditoría.
Desde un punto de vista práctico, podemos caracterizar un lago de datos con tres atributos:
- Reúne y almacena cualquier cosa — el lago de datos contiene todos los datos, tanto datos crudos no procesados de cualquier período como datos procesados/limpios.
- Análisis profundo — el lago de datos permite a los usuarios explorar y analizar datos.
- Acceso flexible — el lago de datos proporciona acceso flexible para diferentes datos y varios escenarios.
Ahora podemos hablar sobre la diferencia entre un almacén de datos y un lago de datos. A menudo, la gente pregunta:
- ¿Y qué pasa con el almacén de datos?
- ¿Sustituimos el almacén de datos por un lago de datos o lo ampliamos?
- ¿Podemos de verdad prescindir de un lago de datos?
En resumen, no hay una respuesta clara. Todo depende de la situación específica, las habilidades del equipo y el presupuesto. Por ejemplo, la migración de un almacén de datos en Oracle a AWS y la creación de un lago de datos por parte de una subsidiaria de Amazon — Woot — .
Por otro lado, el proveedor Snowflake afirma que ya no necesitas preocuparte por un lago de datos, ya que su plataforma de datos (hasta 2020 era un almacén de datos) te permite combinar tanto un lago de datos como un almacén de datos. He trabajado un poco con Snowflake, y es realmente un producto único que puede hacer eso. El precio es otro tema.
En conclusión, mi opinión personal es que todavía necesitamos un almacén de datos como fuente principal de datos para nuestros informes, y todo lo que no quepa, lo almacenamos en un lago de datos. La función de la analítica es proporcionar acceso conveniente a la información para la toma de decisiones empresariales. De cualquier manera, los usuarios de negocios trabajan de manera más eficiente con un almacén de datos que con un lago de datos, por ejemplo, en Amazon hay Redshift (almacén de datos analíticos) y Redshift Spectrum/Athena (interfaz SQL para el lago de datos en S3 basada en Hive/Presto). Lo mismo se aplica a otros almacenes de datos analíticos modernos.
Veamos la arquitectura típica de un almacén de datos:
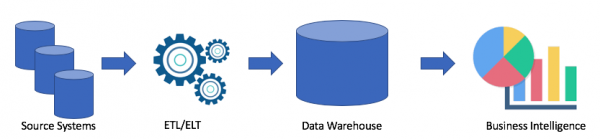
Esta es una solución clásica. Tenemos sistemas de origen, con ETL/ELT copiamos los datos en el almacén de datos analíticos y nos conectamos a una solución de Business Intelligence (mi favorita es Tableau, ¿y la tuya?).
Esta solución tiene las siguientes desventajas:
- Las operaciones de ETL/ELT requieren tiempo y recursos.
- Por lo general, la memoria para almacenar datos en un almacén de datos analíticos no es barata (por ejemplo, Redshift, BigQuery, Teradata), ya que necesitamos comprar un clúster completo.
- Los usuarios de negocios tienen acceso a datos limpios y, a menudo, agregados y no tienen la posibilidad de obtener datos en crudo.
Por supuesto, todo depende de tu caso. Si no tienes problemas con tu almacén de datos, entonces definitivamente no necesitas un lago de datos. Pero cuando surgen problemas de falta de espacio, potencia o el costo es un factor clave, entonces puede ser adecuado considerar un lago de datos. Por eso, el lago de datos es muy popular. Aquí hay un ejemplo de la arquitectura de un lago de datos:
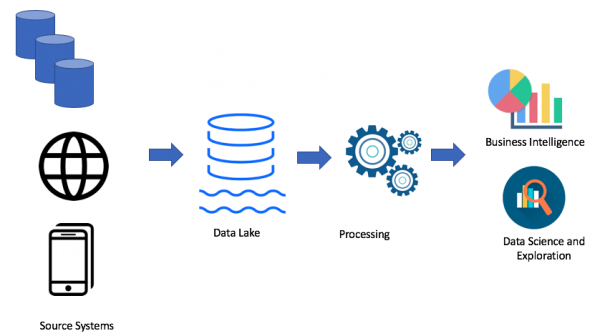
Usando el enfoque del lago de datos, cargamos datos en crudo en nuestro lago de datos (por lotes o en streaming), luego procesamos los datos según sea necesario. El lago de datos permite a los usuarios de negocios crear sus propias transformaciones de datos (ETL/ELT) o analizar datos en soluciones de Business Intelligence (si hay el controlador necesario).
El objetivo de cualquier solución analítica es servir a los usuarios de negocios. Por lo tanto, siempre debemos trabajar a partir de las necesidades del negocio. (En Amazon, este es uno de los principios: trabajar hacia atrás).
Al trabajar tanto con el almacén de datos como con el lago de datos, podemos comparar ambas soluciones:
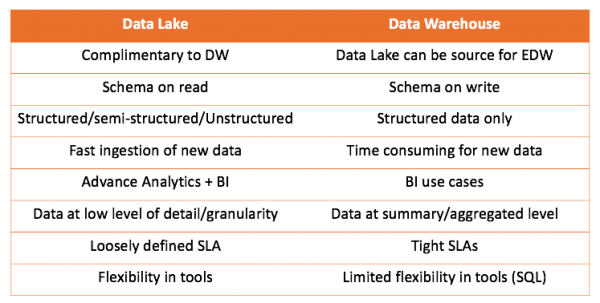
La conclusión principal es que el almacenamiento de datos no compite con el lago de datos, sino que más bien lo complementa. Pero depende de usted decidir qué es lo que se adapta a su caso. Siempre es interesante probar por sí mismo y llegar a las conclusiones correctas.
También me gustaría contar uno de los casos en los que comencé a utilizar el enfoque del lago de datos. Todo es bastante sencillo: intenté usar la herramienta ELT (teníamos Matillion ETL) y Amazon Redshift. Mi solución funcionó, pero no cumplía con los requisitos.
Necesitaba tomar los registros web, transformarlos y agregarlos para proporcionar datos para dos casos:
- El equipo de marketing quería analizar la actividad de los bots para SEO.
- El equipo de TI quería ver métricas sobre el rendimiento de los sitios.
Registros muy simples, muy simples. Aquí hay un ejemplo:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Un archivo pesaba entre 1 y 4 megabytes.
Pero había una dificultad. Teníamos 7 dominios en todo el mundo, y en un solo día se creaban 7000 archivos. Esto no es un gran volumen, apenas 50 gigabytes. Pero el tamaño de nuestro clúster de Redshift también era pequeño (4 nodos). Cargar un archivo de la manera tradicional tardaba alrededor de un minuto. Es decir, no se podía resolver la tarea de forma directa. Y fue en ese momento que decidí utilizar el enfoque del lago de datos. La solución era aproximadamente así:
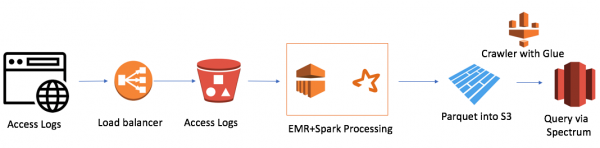
Es bastante simple (quiero señalar que la ventaja de trabajar en la nube es la simplicidad). Utilicé:
- AWS Elastic Map Reduce (Hadoop) como potencia de cálculo.
- AWS S3 como almacenamiento de archivos con la capacidad de cifrar datos y restringir el acceso.
- Spark como potencia de cálculo en memoria y PySpark para la lógica y transformación de datos.
- Parquet como resultado del trabajo de Spark.
- AWS Glue Crawler como recopilador de metadatos sobre nuevos datos y particiones.
- Redshift Spectrum como interfaz SQL al lago de datos para los usuarios existentes de Redshift.
El clúster EMR+Spark más pequeño procesó todo el paquete de archivos en 30 minutos. Hay otros casos para AWS, especialmente muchos relacionados con Alexa, donde hay una gran cantidad de datos.
Recientemente descubrí una de las desventajas de un lago de datos: el GDPR. El problema es que, cuando un cliente solicita que se eliminen sus datos y estos están en uno de los archivos, no podemos utilizar el Data Manipulation Language y la operación DELETE como en una base de datos.
Espero que el artículo haya aclarado la diferencia entre un almacén de datos y un lago de datos. Si te ha interesado, puedo traducir otros artículos míos o de profesionales que leo. También puedo hablar sobre las soluciones con las que trabajo y su arquitectura.
Fuente: habr.com
