

Un usuario más quiere escribir un nuevo bloque de datos en el disco duro, pero no tiene suficiente espacio libre para hacerlo. No quiere eliminar nada porque "todo es muy importante y necesario". ¿Y qué hacemos con él?
Este problema no le ocurre solo a él. En nuestros discos duros hay terabytes de información, y esta cantidad no deja de crecer. Pero, ¿qué tan única es? Al final, todos los archivos son solo conjuntos de bits de longitud determinada y, probablemente, el nuevo no se diferencie mucho de aquel que ya se almacena.
Es evidente que buscar bloques de información ya almacenados en el disco duro es una tarea, si no fallida, al menos ineficaz. Por otro lado, si la diferencia es pequeña, se podría ajustar un poco...
TL;DR — segunda tentativa de explicar un método extraño de optimización de datos utilizando archivos JPEG, ahora en una forma más comprensible.
Sobre los bits y la diferencia
Si tomamos dos bloques de datos completamente aleatorios, en promedio, la mitad de los bits contenidos coinciden. De hecho, entre las posibles combinaciones para cada par (’00, 01, 10, 11′), exactamente la mitad tiene valores coincidentes, esto es sencillo.
Pero, por supuesto, si simplemente tomamos dos archivos y ajustamos uno al otro, perderemos uno de ellos. Si conservamos los cambios, simplemente reinventaremos , que ya existía antes que nosotros, aunque generalmente no se utilice con los mismos propósitos. Se puede intentar insertar una secuencia más pequeña en una más grande, pero incluso así arriesgamos perder segmentos críticos de datos si se utiliza de manera imprudente.
¿Qué diferencia se puede eliminar entonces? Es decir, el nuevo archivo que el usuario está escribiendo es simplemente una secuencia de bits, con la cual por sí sola no podemos hacer nada. Entonces, simplemente debemos encontrar en el disco duro esos bits que se puedan modificar sin necesidad de guardar la diferencia, para que podamos afrontar su pérdida sin consecuencias graves. Y cambiar no solo tiene sentido para el archivo mismo en el sistema de archivos, sino también para alguna información menos sensible dentro de él. ¿Pero qué y cómo?
Métodos de ajuste
Los archivos comprimidos con pérdida vienen al rescate. Todos estos jpeg, mp3 y otros, aunque sean compresiones con pérdida, contienen un montón de bits que se pueden modificar de forma segura. Se pueden utilizar técnicas avanzadas que modifiquen sus componentes de forma sutil en diferentes partes de la codificación. Espera. Técnicas avanzadas… modificación sutil… unos bits en otros… casi se podría decir que es !
Y de hecho, incrustar una información dentro de otra recuerda mucho a sus métodos. También impresiona la invisibilidad de los cambios realizados para los sentidos humanos. Aquí es donde los caminos se separan: nuestra tarea se reduce a que el usuario agregue información adicional en su disco duro, lo cual solo le perjudicará. Olvidará aún más.
Por lo tanto, aunque podemos utilizarlos, es necesario realizar ciertas modificaciones. Y más adelante, explicaré y mostraré esto con el ejemplo de uno de los métodos existentes y un formato de archivo popular.
Sobre los chacales
Si vas a comprimir, que sea lo más comprimible del mundo. Hablamos, por supuesto, de archivos JPEG. No solo existe un montón de herramientas y métodos existentes para incrustar datos en él, sino que es el formato gráfico más popular en este planeta.
Sin embargo, para no ser un criador de perros, es necesario limitar nuestro campo de acción en los archivos de este formato. A nadie le gustan los cuadros monocromáticos que aparecen debido a una compresión excesiva, por lo que debemos limitarnos a trabajar con un archivo ya comprimido, evitando la recodificación. En concreto, con coeficientes enteros que permanecen después de las operaciones responsables de la pérdida de datos: DCT y cuantificación, lo cual se representa perfectamente en el diagrama de codificación (gracias a la wiki de la biblioteca nacional Bauman):
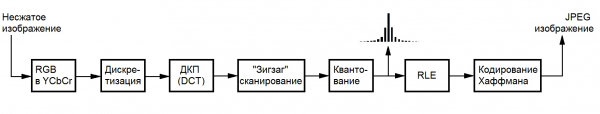
Existen muchos métodos posibles para optimizar archivos jpeg. Hay optimización sin pérdida (jpegtran), hay optimización "" que en realidad aún introducen cambios, pero eso no nos importa. Después de todo, si el usuario está dispuesto a incrustar una información dentro de otra para aumentar el espacio libre en disco, entonces ya ha optimizado sus imágenes o simplemente no desea hacerlo por miedo a perder calidad.
F5
Bajo estas condiciones, se adapta toda una familia de algoritmos, con los que se puede familiarizar. . El más avanzado de ellos es el algoritmo escrito por Andreas Westfeld, que trabaja con coeficientes de componentes de brillo, ya que el ojo humano es menos sensible a sus cambios. Además, utiliza una metodología de incrustación basada en la codificación de matrices, lo que permite realizar menos cambios al insertar la misma cantidad de información, cuanto mayor sea el tamaño del contenedor utilizado.
Los cambios en sí se reducen a la disminución del valor absoluto de los coeficientes en una unidad bajo ciertas condiciones (es decir, no siempre), lo que permite utilizar F5 para optimizar el almacenamiento de datos en el disco duro. La razón es que, después de tal cambio, el coeficiente probablemente ocupará menos bits tras realizar la codificación de Huffman debido a la distribución estadística de los valores en JPEG, y los nuevos ceros resultantes brindarán una ventaja al codificarlos mediante RLE.
Las modificaciones necesarias se limitan a eliminar la parte correspondiente a la privacidad (la permutación de contraseñas), lo que ahorra recursos y tiempo de ejecución, y añadir un mecanismo para trabajar con múltiples archivos en lugar de uno solo a la vez. El proceso de cambio probablemente no será de gran interés para el lector, así que pasemos a describir la implementación.
Alta tecnología
Para demostrar el funcionamiento de este enfoque, implementé un método en C puro y realicé una serie de optimizaciones tanto en velocidad de ejecución como en memoria (no pueden imaginar cuánto pesan estas imágenes sin compresión, incluso hasta DCT). Se ha logrado la compatibilidad multiplataforma usando una combinación de bibliotecas. , y , por lo que les agradezco. Todo esto se compila con 'make', así que los usuarios de Windows deberían instalar algún Cygwin o lidiar por su cuenta con Visual Studio y las bibliotecas.
La implementación está disponible en forma de una utilidad de consola y biblioteca. Aquellos interesados en usar esta última pueden consultar el README en el repositorio de GitHub, cuyo enlace proporcionaré al final de la publicación.
¿Cómo usarlo?
Con cuidado. Las imágenes utilizadas para la compresión se seleccionan mediante una búsqueda con expresiones regulares en el directorio raíz especificado. Una vez finalizado, los archivos se pueden mover, renombrar y copiar a voluntad dentro de ella, cambiar sistemas de archivos y operativos, etc. Sin embargo, se debe tener mucho cuidado y no modificar el contenido real. La pérdida de valor de incluso un solo bit puede llevar a la imposibilidad de recuperar la información.
Al finalizar el trabajo, la utilidad deja un archivo de archivo especial que contiene toda la información necesaria para la descompresión, incluyendo datos sobre las imágenes utilizadas. El archivo en sí pesa alrededor de un par de kilobytes y no tiene un impacto significativo en el espacio de disco ocupado.
Se puede analizar la capacidad posible usando la bandera ‘-a’: ‘./f5ar -a [carpeta de búsqueda] [expresión regular compatible con Perl]’. La compresión se realiza con el comando ‘./f5ar -p [carpeta de búsqueda] [expresión regular compatible con Perl] [archivo comprimido] [nombre del archivo de archivo]’, y la descompresión con ‘./f5ar -u [archivo de archivo] [nombre del archivo restaurado]’.
Demostración del funcionamiento
Para mostrar la eficacia del método, cargué una colección de 225 fotos de perros completamente gratuitas del servicio y encontré un gran PDF de 45 metros del segundo volumen en mis documentos de Knuth.
La secuencia es bastante simple:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Leyendo el archivo de compresión... ok
Inicializando el archivo... ok
Analizando la capacidad de la biblioteca... hecho en 17.0s
Capacidad garantizada detectada de 48439359 bytes
Capacidad posible detectada de hasta 102618787 bytes
Compresion... hecho en 39.4s
Guardando el archivo... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Inicializando el archivo... ok
Leyendo el archivo de archivo... ok
Llenando el archivo con archivos... hecho en 1.4s
Descomprimiendo... hecho en 21.0s
Escribiendo datos extraídos... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Capturas de pantalla para los aficionados
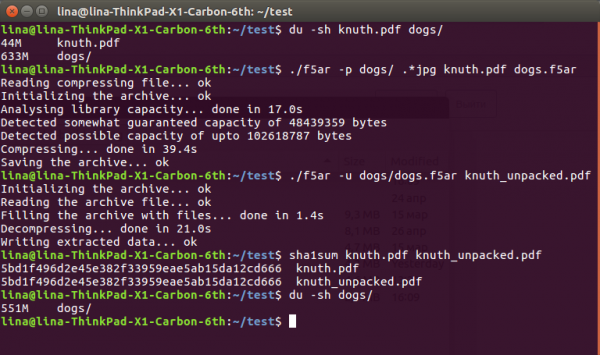
El archivo descomprimido aún se puede y debe leer:
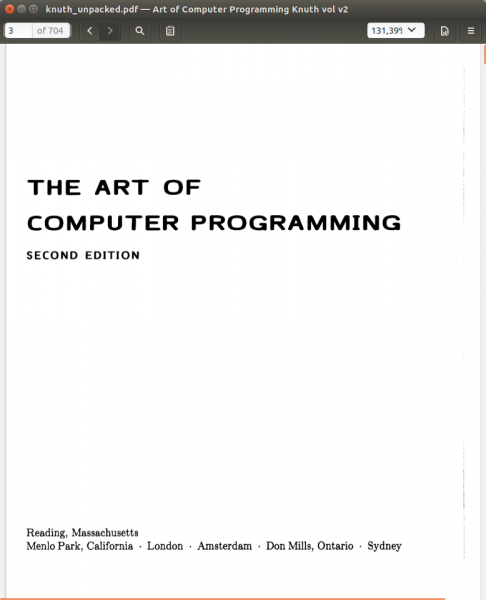
Como se puede ver, de los 633 + 36 == 669 megabytes de datos en el disco duro, hemos llegado a unos agradables 551. Esta diferencia radical se explica por la reducción de los valores del coeficiente que afecta su posterior compresión sin pérdida: la reducción de solo uno puede fácilmente "cortar" un par de bytes del archivo final. Sin embargo, sigue siendo una pérdida de datos, aunque muy pequeña, con la que habrá que lidiar.
Afortunadamente, no son visibles para el ojo en absoluto. Bajo el spoiler (ya que habrastorage no maneja archivos grandes) el lector puede evaluar la diferencia tanto a simple vista como su intensidad, obtenida restando los valores del componente modificado del original: , , (cuanto más apagado es el color, menor es la diferencia en el bloque).
En conclusión
Mirando todas estas complicaciones, comprar un disco duro o subir todo a la nube puede parecer una solución mucho más sencilla al problema. Pero aunque ahora vivimos en una época maravillosa, no hay garantía de que mañana aún podamos conectarnos a Internet y subir todos nuestros datos sobrantes. O ir a la tienda y comprar otro disco duro de mil terabytes. Sin embargo, siempre se puede utilizar lo que ya está en casa.
->
Fuente: habr.com
