

El proceso de actualización para su clúster de Kubernetes
En algún momento, al utilizar un clúster de Kubernetes, surge la necesidad de actualizar los nodos en funcionamiento. Esto puede incluir actualizaciones de paquetes, actualizaciones del núcleo o el despliegue de nuevas imágenes de máquinas virtuales. En la terminología de Kubernetes, esto se llama .
Esta publicación es parte de un ciclo de 4 publicaciones:
- Esta publicación.
- Finalización correcta de los pods en un clúster de Kubernetes
- Finalización retrasada de un pod al eliminarlo
- Cómo evitar el tiempo de inactividad en el clúster de Kubernetes utilizando PodDisruptionBudgets
(Nota del traductor: se espera que las traducciones de los demás artículos del ciclo lleguen pronto)
En este artículo, describiremos todas las herramientas que Kubernetes ofrece para lograr un tiempo de inactividad cero para los nodos en funcionamiento en su clúster.
Definición del problema
Al principio, utilizaremos un enfoque ingenuo, identificando problemas y evaluando los riesgos potenciales de este enfoque, acumulando conocimiento para resolver cada uno de los problemas que encontremos a lo largo de todo el ciclo. Como resultado, obtendremos una configuración que utiliza hooks del ciclo de vida, readiness probes y presupuestos de disrupción de pods para lograr nuestro tiempo de inactividad cero.
Para comenzar nuestro camino, tomemos un ejemplo concreto. Supongamos que tenemos un clúster de Kubernetes con dos nodos, en el que está ejecutándose una aplicación con dos pods, los cuales están detrás de Servicio:
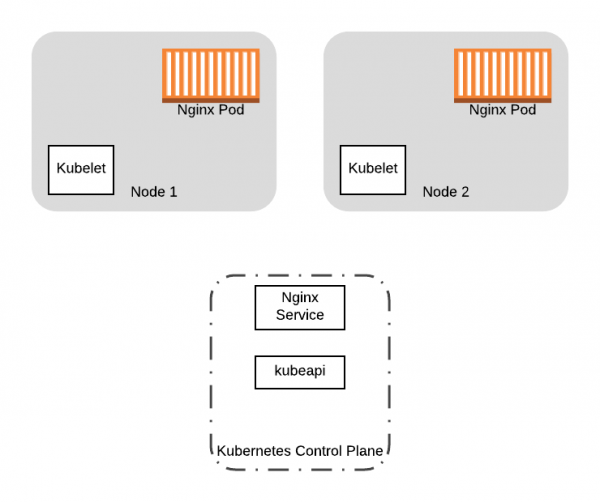
Empecemos con dos pods de Nginx y un servicio ejecutándose en nuestros dos nodos del clúster de Kubernetes.
Queremos actualizar la versión del núcleo de nuestros dos nodos de trabajo en el clúster. ¿Cómo lo haremos? Una solución simple sería cargar nuevos nodos con la configuración actualizada y luego apagar los nodos antiguos, al mismo tiempo que se inician los nuevos. Aunque esto funcionará, habrá varios problemas con este enfoque:
- Cuando apagues los nodos antiguos, los pods en ejecución en ellos también se apagarán. ¿Qué sucede si los pods necesitan ser limpiados para una desconexión adecuada? El sistema de virtualización que estés utilizando puede no esperar a que se complete el proceso de limpieza.
- ¿Qué ocurriría si apagas todos los nodos al mismo tiempo? Tendrás un tiempo de inactividad considerable mientras los pods se trasladan a los nuevos nodos.
Necesitamos una forma adecuada de migrar pods desde nodos antiguos y, al mismo tiempo, debemos asegurarnos de que ninguno de nuestros procesos de trabajo esté activo mientras realizamos cambios en el nodo. O cuando hacemos un reemplazo completo del clúster, como en el ejemplo (es decir, sustituimos las imágenes de las VM), queremos trasladar aplicaciones en funcionamiento de los nodos antiguos a los nuevos. En ambos casos, queremos evitar la programación de nuevos pods en los nodos antiguos, y luego expulsar todos los pods en funcionamiento de estos. Para lograr estos objetivos, podemos usar el comando kubectl drain.
Redistribuir todos los pods desde el nodo
La operación drain permite redistribuir todos los pods desde el nodo. Durante la ejecución del drain, el nodo se marca como unschedulable (flag NoSchedule). Esto evita la aparición de nuevos pods en él. Luego, el drain comienza a expulsar los pods del nodo, deteniendo los contenedores que actualmente están en funcionamiento en el nodo enviando una señal TERM a los contenedores en el pod.
Aunque kubectl drain Aunque la operación de expulsión de pods se maneja bien, hay otros dos factores que pueden causar que la operación drain falle:
- Su aplicación debe ser capaz de cerrarse correctamente al recibir
TERMla señal. Cuando se expulsan los pods, Kubernetes envía una señalTERMa los contenedores y espera a que se detengan durante un tiempo determinado; después de lo cual, si no se han detenido, los finaliza forzosamente. En cualquier caso, si su contenedor no recibe la señal correctamente, aún puede apagar los pods incorrectamente si están en funcionamiento en ese momento (por ejemplo, si se está ejecutando una transacción en la base de datos). - Pierde todos los pods que contienen su aplicación. Puede que no esté disponible en el momento del inicio de nuevos contenedores en los nuevos nodos o, si sus pods se han desplegado sin controladores, puede que no se reinicien en absoluto.
Evitando el tiempo de inactividad
Para minimizar el tiempo de inactividad por interrupciones voluntarias, como la operación drain para un nodo, Kubernetes proporciona las siguientes opciones para gestionar fallos:
En las demás partes del ciclo, utilizaremos estas funciones de Kubernetes para mitigar el impacto de la transferencia de pods. Para facilitar el seguimiento de la idea principal, utilizaremos nuestro ejemplo anterior con la siguiente configuración de recursos:
---
apiversion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiversion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Esta configuración es un ejemplo mínimo Deployment, que gestiona pods de nginx en el clúster. Además, la configuración describe un recurso Servicio, que se puede usar para acceder a los pods de nginx en el clúster.
A lo largo del ciclo, iterativamente ampliaremos esta configuración para que al final incluya todas las capacidades que Kubernetes ofrece para reducir el tiempo de inactividad.
Para obtener una versión completamente integrada y probada de actualizaciones del clúster de Kubernetes para un tiempo de inactividad cero en AWS y otros recursos, visite .
También lee otros artículos en nuestro blog:
Fuente: habr.com
