

Introducción
¡Hola!
En este artículo, compartiré mi experiencia en la construcción de una arquitectura de microservicios para un proyecto que utiliza redes neuronales.
Hablaremos sobre los requisitos para la arquitectura, veremos varios diagramas estructurales, examinaremos cada uno de los componentes de la arquitectura lista, y también evaluaremos las métricas técnicas de la solución.
¡Disfruta la lectura!
Un par de palabras sobre la tarea y su solución
La idea principal es evaluar la atractividad de una persona en una escala de diez puntos basada en una foto.
En este artículo, nos alejaremos de la descripción tanto de las redes neuronales utilizadas como del proceso de preparación de datos y entrenamiento. Sin embargo, en una de las siguientes publicaciones, definitivamente volveremos a analizar el pipeline de evaluación a un nivel más profundo.
Ahora haremos un recorrido de alto nivel por el pipeline de evaluación, haciendo hincapié en la interacción de los microservicios en el contexto de la arquitectura general del proyecto.
Al trabajar en el pipeline de evaluación de la atractividad, la tarea se descompuso en los siguientes componentes:
- Detección de rostros en la foto
- Evaluación de cada uno de los rostros
- Renderización del resultado
El primero se resuelve con la ayuda de un modelo preentrenado de . Para el segundo, se entrenó una red neuronal convolucional en PyTorch, utilizando como backbone – en un equilibrio entre "calidad / velocidad de inferencia en CPU"
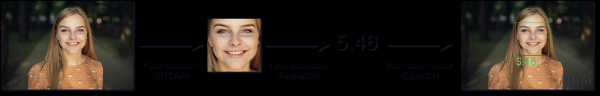
Diagrama funcional del pipeline de evaluación
Análisis de los requisitos de la arquitectura del proyecto
En el ciclo de vida del proyecto, las etapas de trabajo en la arquitectura y la automatización del despliegue del modelo son a menudo las más costosas en tiempo y recursos.
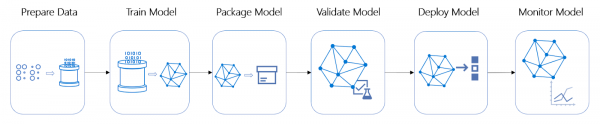
Ciclo de vida del proyecto de ML
Este proyecto no es una excepción: se tomó la decisión de envolver el pipeline de evaluación en un servicio en línea, para lo cual fue necesario profundizar en la arquitectura. Se definieron los siguientes requisitos básicos:
- Almacenamiento único de logs: todos los servicios deben escribir los logs en un solo lugar y deben ser fáciles de analizar.
- Posibilidad de escalado horizontal del servicio de evaluación — como el Bottleneck más probable.
- A cada imagen se debe asignar la misma cantidad de recursos del procesador — para evitar desviaciones en la distribución del tiempo de inferencia.
- Despliegue rápido (re) de servicios específicos y del stack en general.
- Posibilidad de utilizar objetos comunes en diferentes servicios, si es necesario.
Arquitectura
Después de analizar los requisitos, quedó claro que la arquitectura de microservicios se adapta prácticamente a la perfección.
Para evitar dolores de cabeza innecesarios, se eligió el API de Telegram como frontend.
Para empezar, revisaremos el diagrama estructural de la arquitectura final, luego pasaremos a la descripción de cada uno de los componentes, y además formalizaremos el proceso de manejo exitoso de imágenes.
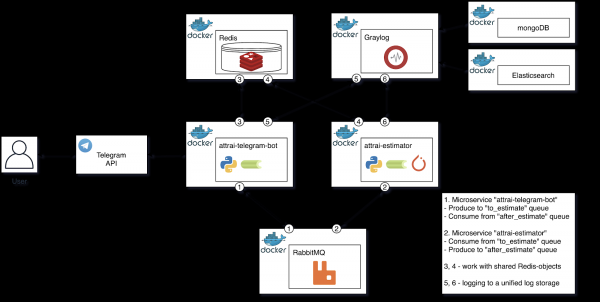
Diagrama estructural de la arquitectura final
Hablemos en detalle sobre cada uno de los componentes del diagrama, señalando su Responsabilidad Única en el proceso de evaluación de la imagen.
Microservicio «attrai-telegram-bot»
Este microservicio encapsula todas las interacciones con el API de Telegram. Se pueden destacar 2 escenarios principales: trabajar con la imagen del usuario y trabajar con el resultado de la evaluación del pipeline. Analizaremos ambos escenarios en términos generales.
Al recibir un mensaje del usuario con una imagen:
- Se realiza un filtrado, que consiste en las siguientes comprobaciones:
- La existencia de un tamaño óptimo de imagen
- La cantidad de imágenes del usuario que ya están en la cola
- Al pasar la filtración inicial, la imagen se guarda en un volumen de Docker
- Se produce una tarea en la cola “to_estimate”, en la que, entre otras cosas, figura la ruta de la imagen que se encuentra en nuestro volumen
- Si las etapas anteriores se superan con éxito, el usuario recibirá un mensaje con el tiempo aproximado de procesamiento de la imagen, que se calcula en función de la cantidad de tareas en la cola. En caso de error, el usuario será notificado explícitamente enviando un mensaje con información sobre qué pudo haber salido mal.
Además, este microservicio, como worker de Celery, escucha la cola “after_estimate”, destinada a tareas que han pasado por el pipeline de evaluación.
Al recibir una nueva tarea de “after_estimate”:
- Si la imagen ha sido procesada con éxito, enviamos el resultado al usuario, si no, notificamos sobre el error.
- Eliminamos la imagen que es el resultado del pipeline de evaluación.
Microservicio de evaluación «attrai-estimator»
Este microservicio es un worker de Celery y encapsula todo lo relacionado con el pipeline de evaluación de imágenes. Aquí hay un solo algoritmo de funcionamiento — lo desglosaremos.
Al recibir una nueva tarea de “to_estimate”:
- Ejecutamos la imagen a través del pipeline de evaluación:
- Cargamos la imagen en memoria
- Ajustamos la imagen al tamaño deseado
- Detectamos todos los rostros (MTCNN)
- Evaluamos todos los rostros (embalamos los rostros encontrados en el paso anterior en un lote y hacemos inferencia con ResNet34)
- Renderizamos la imagen final
- Dibujamos los bounding boxes
- Dibujamos las evaluaciones
- Eliminamos la imagen del usuario (original)
- Guardamos la salida del pipeline de evaluación
- Colocamos la tarea en la cola 'after_estimate', que es escuchada por el microservicio 'attrai-telegram-bot' mencionado anteriormente
Graylog (+ mongoDB + Elasticsearch)
— es una solución para la gestión centralizada de logs. En este proyecto, se utilizó para su propósito directo.
Se eligió específicamente él, y no el habitual stack, por la conveniencia de trabajar con él desde Python. Todo lo que se necesita para registrar en Graylog es añadir GELFTCPHandler del paquete a los demás manejadores de root logger de nuestro microservicio en Python.
Yo, como alguien que antes solo había trabajado con el stack ELK, en general, tuve una experiencia positiva al trabajar con Graylog. Lo único desalentador es la superioridad de las características de Kibana sobre la interfaz web de Graylog.
RabbitMQ
— es un corredor de mensajes basado en el protocolo AMQP.
En este proyecto, se utilizó como para Celery y funcionó en modo durable.
Redis
— es una base de datos NoSQL que trabaja con estructuras de datos tipo 'clave-valor'.
A veces surge la necesidad de usar objetos comunes en diferentes microservicios de Python que implementan alguna estructura de datos.
Por ejemplo, en Redis se almacena un hashmap del tipo 'telegram_user_id => cantidad de tareas activas en la cola', lo que permite limitar el número de solicitudes de un usuario a un valor específico y, de esta manera, prevenir ataques de DoS.
Formalizamos el proceso de procesamiento exitoso de imágenes
- El usuario envía una imagen al bot de Telegram
- 'attrai-telegram-bot' recibe el mensaje de la API de Telegram y lo analiza
- La tarea con la imagen se añade a la cola asíncrona 'to_estimate'
- El usuario recibe un mensaje con el tiempo estimado para la evaluación
- 'attrai-estimator' toma la tarea de la cola 'to_estimate', la pasa por el pipeline de evaluación y produce la tarea en la cola 'after_estimate'
- 'attrai-telegram-bot', que escucha la cola 'after_estimate', envía el resultado al usuario
DevOps
Finalmente, tras revisar la arquitectura, podemos pasar a una parte igualmente interesante: DevOps
Docker Swarm
— sistema de agrupamiento, cuya funcionalidad está implementada dentro de Docker Engine y está disponible de inmediato.
Con la ayuda de un "enjambre", todas las nodos de nuestro clúster se pueden dividir en dos tipos: worker y manager. En las máquinas del primer tipo se despliegan grupos de contenedores (stacks), mientras que las máquinas del segundo tipo se encargan del escalado, balanceo y . Los managers por defecto también son workers.
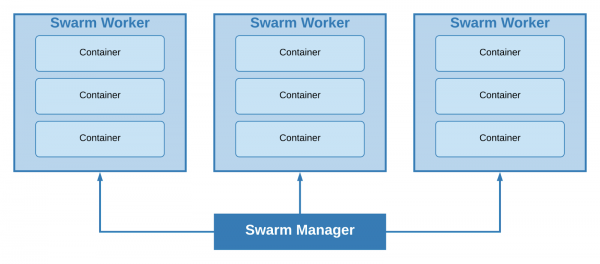
Clúster con un leader manager y tres workers
El tamaño mínimo posible del clúster es de 1 nodo, donde una única máquina actuará simultáneamente como leader manager y worker. Según el tamaño del proyecto y los requisitos mínimos de resiliencia, se tomó la decisión de utilizar este enfoque.
Para anticipar, diré que desde la primera entrega en producción, que tuvo lugar a mediados de junio, no ha habido problemas relacionados con esta organización del clúster (pero eso no significa que tal organización sea aceptable en proyectos medianos a grandes que tienen requisitos de resiliencia).
Docker Stack
En modo "enjambre", el despliegue de stacks (conjuntos de servicios Docker) es responsabilidad de
Soporta configuraciones de docker-compose, permitiendo utilizar parámetros de despliegue adicionales.
Por ejemplo, con estos parámetros se limitaron los recursos asignados a cada una de las instancias del microservicio de evaluación (asignamos N núcleos a N instancias, y en el propio microservicio limitamos la cantidad de núcleos utilizados por PyTorch a uno)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Es importante destacar que Redis, RabbitMQ y Graylog son servicios con estado y no se pueden escalar tan fácilmente como "attrai-estimator".
Anticipando la pregunta: ¿por qué no Kubernetes?
Parece que usar Kubernetes en proyectos pequeños y medianos es un exceso, toda la funcionalidad necesaria se puede obtener de Docker Swarm, que es bastante amigable para un orquestador de contenedores y tiene un bajo umbral de entrada.
Infraestructura
Todo esto se desplegó en un VDS con las siguientes características:
- CPU: 4 núcleos Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Después de pruebas de carga local, parecía que con un flujo serio de usuarios, esta máquina sería justo suficiente.
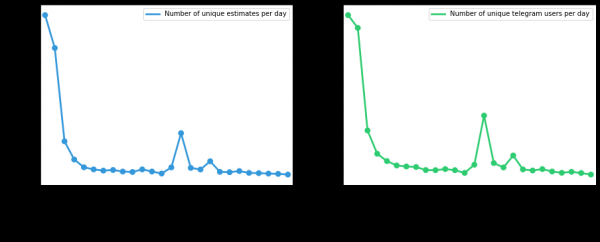
Pero, justo después del despliegue, publiqué el enlace a uno de los foros de imágenes más populares en la CEI (sí, ese mismo), lo que despertó el interés de la gente y en pocas horas el servicio procesó con éxito decenas de miles de imágenes. En los momentos pico, los recursos de CPU y RAM ni siquiera se utilizaron a la mitad.
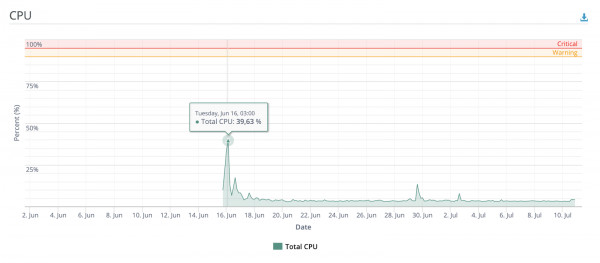
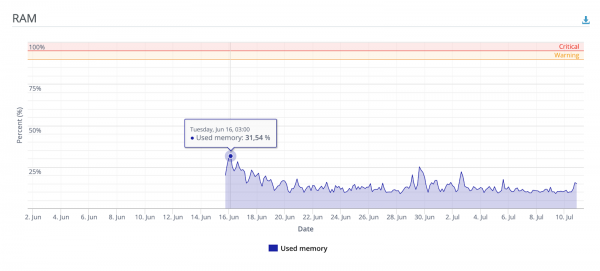
Un poco más de gráficos
Cantidad de usuarios únicos y solicitudes de evaluación, desde el momento del despliegue, dependiendo del día
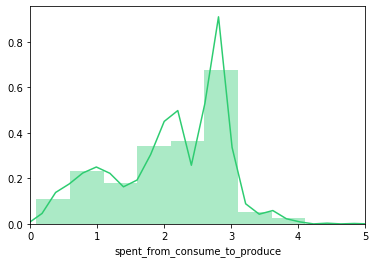
Distribución del tiempo de inferencia del pipeline de evaluación
Conclusiones
En resumen, puedo decir que la arquitectura y el enfoque para la orquestación de contenedores se han justificado completamente: incluso en los momentos pico no hubo caídas ni demoras en el tiempo de procesamiento.
Creo que los proyectos pequeños y medianos que utilizan inferencia en tiempo real de redes neuronales en CPU pueden adoptar con éxito las prácticas descritas en este artículo.
Añadiré que originalmente el artículo era más extenso, pero para no publicar un texto largo decidí omitir algunos puntos en este artículo; regresaremos a ellos en próximas publicaciones.
Puedes probar el bot en Telegram - @AttraiBot, funcionará, al menos, hasta finales de otoño de 2020. Recuerda que no se almacenan datos de los usuarios: ni las imágenes originales ni los resultados del pipeline de evaluación, todo se borra después del procesamiento.
Fuente: habr.com
