

El desarrollo de un almacén es un proceso largo y serio.
Mucho en la vida del proyecto depende de cuán bien se haya pensado el modelo de objeto y la estructura de la base desde el inicio.
El enfoque comúnmente aceptado ha sido y sigue siendo diversas combinaciones de la estructura en 'estrella' con la tercera forma normal. Por lo general, bajo el principio: datos originales — 3NF, vitrinas — estrella. Este enfoque, probado por el tiempo y respaldado por una gran cantidad de investigaciones, es lo primero (y a veces lo único) que le viene a la mente a un experto en DWH al pensar en cómo debe verse un almacén analítico.
Por otro lado, los negocios en general y los requisitos del cliente en particular tienden a cambiar rápidamente, mientras que los datos pueden crecer 'en profundidad' y 'en amplitud'. Y aquí es donde se manifiesta la principal desventaja de la estrella: su limitación. flexibilidad.
Y si de repente en su tranquila y acogedora vida como desarrollador de DWH aparece:
- la tarea de 'hacer algo rápido y luego ya veremos';
- un proyecto en rápido desarrollo, con la incorporación de nuevas fuentes y un cambio en el modelo de negocio al menos una vez por semana;
- un cliente que no tiene idea de cómo debería ser el sistema y qué funciones debería desempeñar, pero está dispuesto a experimentar y a precisar de manera continua el resultado deseado acercándose de forma progresiva a él;
- el gerente de proyectos aparece con la alegre noticia: '¡Y ahora tenemos Agile!'.
O si simplemente le interesa conocer otras formas de construir almacenes, ¡bienvenido debajo del cat!
¿Qué significa 'flexibilidad'?
Para comenzar, definamos qué propiedades debe tener un sistema para poder ser considerado 'flexible'.
Cabe mencionar que las propiedades descritas deben referirse específicamente a el sistema, y no al proceso de su desarrollo. Por lo tanto, si deseaba leer sobre Agile como metodología de desarrollo, es mejor consultar otros artículos. Por ejemplo, aquí en Habr hay una gran cantidad de materiales interesantes (tales como y , como ).
Esto no significa que el proceso de desarrollo y la estructura del HLD no estén relacionados en absoluto. En general, desarrollar un almacén de arquitectura flexible siguiendo Agile debería ser considerablemente más fácil. Sin embargo, en la práctica, a menudo se encuentran opciones para el desarrollo de un DWH clásico según Kimball y DataVault — siguiendo el enfoque en cascada, más que coincidencias felices de flexibilidad en sus dos manifestaciones en un mismo proyecto.
Entonces, ¿qué capacidades debería tener un almacén flexible? Aquí se pueden destacar tres puntos:
- Entrega temprana y rápida modificación — esto significa que, en ideal, el primer resultado comercial (por ejemplo, los primeros informes funcionales) debe lograrse lo antes posible, es decir, incluso antes de que el sistema completo esté diseñado e implementado. Cada modificación subsiguiente también debería tomar el menor tiempo posible.
- Modificación iterativa — esto significa que cada modificación subsiguiente, en ideal, no debería afectar la funcionalidad ya operativa. Este aspecto a menudo se convierte en la mayor pesadilla en proyectos grandes: tarde o temprano, los objetos individuales comienzan a acumular tantas relaciones que es más fácil repetir la lógica en una copia al lado, que agregar un campo en una tabla existente. Y si te sorprende que el análisis del impacto de la modificación en los objetos existentes pueda llevar más tiempo que la modificación misma, probablemente aún no has trabajado con grandes HLD en banca o telecomunicaciones.
- Adaptación constante a los requisitos comerciales cambiantes — la estructura objeto general debe diseñarse no solo teniendo en cuenta una posible expansión, sino considerando que la dirección de esta nueva expansión no podría haberte siquiera imaginado en la etapa de diseño.
Y sí, cumplir con todos estos requisitos en un mismo sistema es posible (por supuesto, en ciertos casos y con algunas aclaraciones).
A continuación, analizaré dos de las metodologías de diseño flexible más populares para HLD — Modelo de ancla y Data Vault. Se dejan de lado técnicas tan excelentes como EAV, 6NF (en su forma pura) y todo lo relacionado con soluciones NoSQL, no porque sean peores, ni tampoco porque en este caso el artículo amenazara con adquirir el volumen de una tesis promedio. Simplemente, todo esto se relaciona con soluciones de una categoría algo diferente, ya sea con técnicas que se pueden aplicar en casos específicos, independientemente de la arquitectura general de su proyecto (como EAV), o con paradigmas de almacenamiento de información completamente distintos (como bases de datos gráficas y otras variantes de NoSQL).
Los problemas del enfoque “clásico” y sus soluciones en metodologías flexibles
Con el enfoque “clásico” me refiero a la buena y antigua estrella (independientemente de la implementación específica de las capas subyacentes, que me perdonen los adeptos de Kimball, Inmon y el CDM).
1. La cardinalidad estricta de las relaciones
Dicha modelo se basa en una clara separación de datos en dimensiones (Dimension) y hechos (Fact). Y esto, maldita sea, es lógico, ya que el análisis de datos en la gran mayoría de los casos se reduce precisamente al análisis de ciertos indicadores numéricos (hechos) en determinados cortes (dimensiones).
Al mismo tiempo, las relaciones entre objetos se establecen en forma de relaciones entre tablas a través de claves externas. Esto parece bastante natural, pero inmediatamente conduce a la primera limitación de flexibilidad: la definición rígida de la cardinalidad de las relaciones.
. Esto significa que en la etapa de diseño de tablas, debe determinar exactamente para cada par de objetos relacionados si pueden relacionarse como muchos a muchos, o solo uno a muchos, y “en qué dirección”. Esto depende directamente de en cuál de las tablas estará la clave primaria y en cuál la externa. Cambiar esta relación ante nuevos requisitos probablemente llevará a la reestructuración de la base.
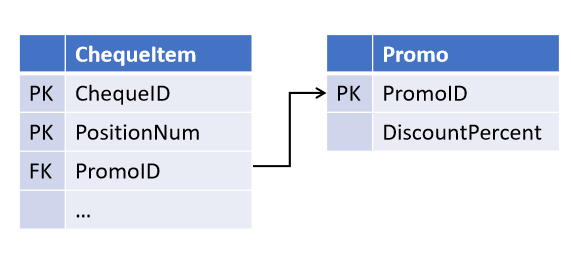
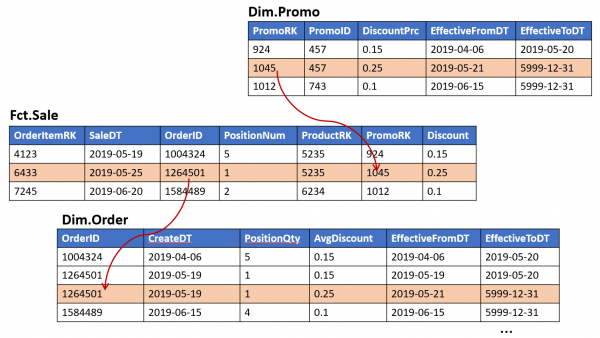
Por ejemplo, al diseñar el objeto “recibo de caja”, usted, basándose en las garantías juradas del departamento de ventas, estableció la posibilidad de que una promoción afectara a varias posiciones de recibo (pero no al revés):
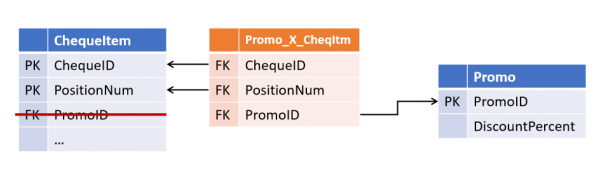
Y después de un tiempo, los colegas introdujeron una nueva estrategia de marketing, en la que en una misma posición pueden actuar varias promociones simultáneamente. Ahora debe modificar las tablas, destacando la relación en un objeto separado.
(Todos los objetos derivados donde se realiza el chequeo de la promoción también necesitan ajustes).
Relaciones en Data Vault y Modelo Ancla
Evitar tal situación resultó ser bastante sencillo: no hay que creer en el departamento de ventas, para ello es suficiente almacenar todas las relaciones inicialmente en tablas separadas y procesarlas como muchos a muchos.
Este enfoque fue propuesto por Dan Linstedt como parte de la paradigma Data Vault y totalmente respaldado por Lars Rönnbäck en Modelo Ancla.
Como resultado, obtenemos la primera característica distintiva de las metodologías flexibles:
Las relaciones entre los objetos no se almacenan en los atributos de las entidades parentales, sino que representan un tipo separado de objetos.
En Data Vault tales tablas de relación se llaman Link, mientras que en Modelo Ancla — Tie. A primera vista, son muy similares, aunque sus diferencias no se agotan en el nombre (de lo que hablaremos a continuación). En ambas arquitecturas, las tablas de relación pueden vincular cualquier cantidad de entidades (no necesariamente 2).
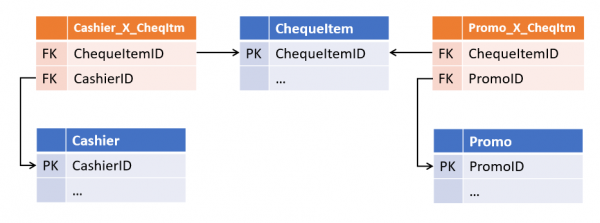
Esta aparente redundancia brinda una flexibilidad considerable en las modificaciones. Esta estructura se vuelve tolerante no solo a los cambios en las cardinalidades de las relaciones existentes, sino también a la adición de nuevas: si ahora el elemento de chequeo también tiene un enlace al cajero que lo procesó, la aparición de dicha relación se convierte simplemente en una superestructura sobre las tablas existentes sin afectar a ningún objeto o proceso existente.
2. Duplicación de datos
El segundo problema que resuelven las arquitecturas flexibles es menos obvio y es característico principalmente de mediciones tipo SCD2 (dimensiones lentamente cambiantes de segundo tipo), aunque no solo de ellas.
En un almacén clásico, una dimensión normalmente representa una tabla que contiene una clave surrogada (como PK) así como un conjunto de claves de negocio y atributos en columnas separadas.
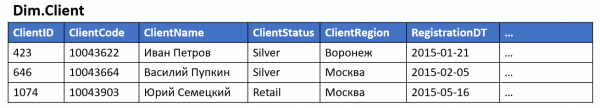
Si la dimensión soporta versionado, al conjunto estándar de campos se añaden límites de tiempo de validez de la versión, y en una fila de la fuente aparecen varias versiones en el almacén (una por cada cambio en los atributos de versión).
Si una dimensión contiene al menos un atributo de versión que cambia con frecuencia, la cantidad de versiones de dicha dimensión será considerable (incluso si los demás atributos no son de versión o nunca cambian), y si hay varios de esos atributos, la cantidad de versiones puede crecer en progresión geométrica de acuerdo a su cantidad. Esta dimensión puede ocupar un volumen significativo de espacio en disco, aunque la mayor parte de los datos almacenados en ella son simplemente duplicados de los valores de atributos invariables de otras filas.
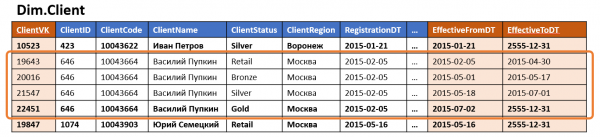
A menudo se aplica también la desnormalización — parte de los atributos se almacenan intencionalmente como un valor y no como una referencia a un diccionario o a otra dimensión. Este enfoque acelera el acceso a los datos, reduciendo la cantidad de uniones al acceder a la dimensión.
En general, esto lleva a que la misma información se almacene simultáneamente en varios lugares. Por ejemplo, la información sobre la región de residencia y la pertenencia a la categoría del cliente puede almacenarse simultáneamente en las dimensiones “Cliente” y en los hechos “Compra”, “Entrega” y “Llamadas al centro de atención al cliente”, así como en la tabla de vínculo “Cliente — Gestor de Cliente”.
Lo descrito anteriormente también se aplica a las dimensiones ordinarias (no versionadas), pero en las versionadas puede tener una escala diferente: la aparición de una nueva versión de un objeto (especialmente retroactivamente), no solo actualiza todas las tablas relacionadas, sino que provoca la aparición en cascada de nuevas versiones de los objetos relacionados, cuando la Tabla 1 se utiliza para construir la Tabla 2, y la Tabla 2 — para construir la Tabla 3, etc. Incluso si ningún atributo de la Tabla 1 participa en la construcción de la Tabla 3 (y otros atributos de la Tabla 2, obtenidos de otras fuentes, sí lo hacen), la actualización versionada de esta construcción como mínimo llevará a costos adicionales y, en el peor de los casos, a versiones innecesarias en la Tabla 3, que aquí no tiene relevancia y así sucesivamente en la cadena.
3. Complejidad no lineal de la modificación
A su vez, cada nueva vitrina construida sobre la base de otra aumenta la cantidad de lugares donde los datos pueden “desviarse” al realizar cambios en ETL. Esto, a su vez, lleva a un aumento de la complejidad (y duración) de cada modificación subsiguiente.
Si lo anterior se aplica a sistemas con procesos ETL que rara vez se modifican, es posible vivir en tal paradigma: basta con asegurarse de que las nuevas modificaciones se apliquen correctamente a todos los objetos relacionados. Sin embargo, si las modificaciones ocurren con frecuencia, la probabilidad de 'perder' accidentalmente algunas relaciones aumenta significativamente.
Si además se tiene en cuenta que el ETL 'versionado' es significativamente más complejo que el 'no versionado', evitar errores al realizar modificaciones frecuentes a todo este sistema se vuelve bastante complicado.
Almacenamiento de objetos y atributos en Data Vault y Modelo Ancla
El enfoque propuesto por los autores de arquitecturas flexibles se puede formular de la siguiente manera:
Es necesario separar lo que cambia de lo que permanece inalterado. Es decir, almacenar las claves por separado de los atributos.
Sin embargo, no se debe confundir no versionado atributo con inalterable: el primero no almacena el historial de su cambio, pero puede variar (por ejemplo, al corregir un error de entrada o al recibir nuevos datos), el segundo nunca cambia.
Las opiniones sobre lo que se puede considerar inalterable en Data Vault y el Modelo Ancla varían.
Desde el punto de vista de la arquitectura Data Vault, se puede considerar inalterable todo el conjunto de claves — naturales (NIF de la organización, código de producto en el sistema fuente, etc.) y surrogadas. Al mismo tiempo, los demás atributos se pueden dividir en grupos según la fuente y/o frecuencia de cambios y para cada grupo, llevar una tabla separada con un conjunto independiente de versiones.
En el paradigma Modelo Ancla , se considera inalterable solo la clave surrogada de la entidad. Todo lo demás (incluyendo las claves naturales) es simplemente un caso particular de sus atributos. Sin embargo, todos los atributos son, por defecto, independientes entre sí, por lo que para cada atributo debe crearse una tabla separada.
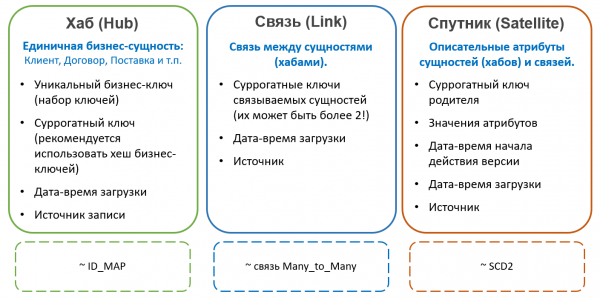
En Data Vault las tablas que contienen las claves de las entidades se denominan Hub (Hub). Los Hubs siempre contienen un conjunto fijo de campos:
- Claves naturales de la entidad
- Clave surrogada
- Referencia a la fuente
- Fecha de adición del registro
Los registros en los Hubs nunca cambian y no tienen versiones.. Los hubs exteriores son muy parecidos a las tablas de tipo ID-map, utilizadas en algunos sistemas para generar sustitutos, sin embargo, se recomienda utilizar un hash de un conjunto de claves de negocio como sustituto en Data Vault. Este enfoque simplifica la carga de relaciones y atributos desde las fuentes (no es necesario hacer un join en el hub para obtener el sustituto; basta con calcular el hash de la clave natural), pero puede causar otros problemas (relacionados, por ejemplo, con colisiones, mayúsculas y caracteres no imprimibles en las claves de texto, etc.), por lo que no es comúnmente aceptado.
Todos los demás atributos de las entidades se almacenan en tablas especiales llamadas Satélites (Satellit). Un hub puede tener varios satélites que almacenan diferentes conjuntos de atributos.
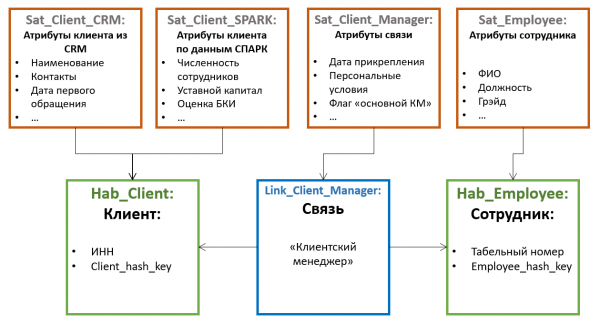
La distribución de atributos entre los satélites se realiza de acuerdo con el principio de cambio conjunto — en un satélite pueden almacenarse atributos no versionados (por ejemplo, la fecha de nacimiento y el número de la Seguridad Social para personas físicas), en otro, atributos versionados que cambian raramente (por ejemplo, el apellido y el número del pasaporte), y en un tercero, atributos que cambian con frecuencia (como la dirección de entrega, categoría, fecha del último pedido, etc.). La versionidad se lleva a cabo a nivel de satélites individuales, y no de la entidad en su conjunto, por lo que es conveniente distribuir los atributos de tal manera que la intersección de las versiones dentro de un satélite sea mínima (lo que reduce el número total de versiones almacenadas).
Además, para optimizar el proceso de carga de datos, a menudo se extraen a satélites separados los atributos que se obtienen de diversas fuentes.
Los satélites están vinculados al Hub mediante clave externa (lo que corresponde a la cardinalidad de uno a muchos). Esto significa que múltiples valores de atributos (por ejemplo, varios números de teléfono de contacto para un mismo cliente) son compatibles de forma predeterminada con esta arquitectura.
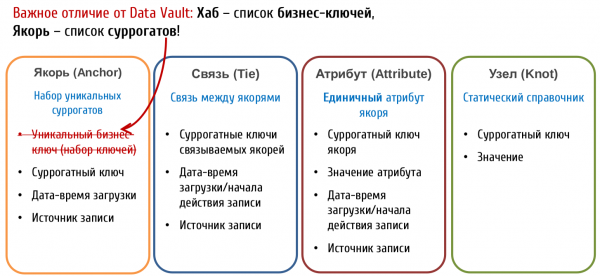
En Modelo Ancla (Anchor Model) las tablas que almacenan claves se llaman Anclas (Anchor). Y almacenan:
- Solo claves sustitutas
- Referencia a la fuente
- Fecha de adición del registro
Las claves naturales, desde la perspectiva del Modelo Ancla, se consideran atributos comunes. Esta opción puede parecer más compleja de entender, pero ofrece muchas más oportunidades para la identificación del objeto.
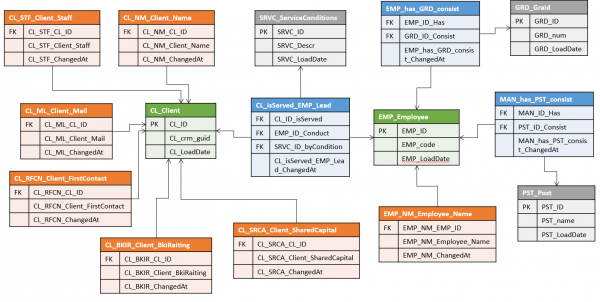
Por ejemplo, si los datos de una misma entidad pueden llegar de diferentes sistemas, en cada uno de los cuales se utiliza su propia clave natural. En Data Vault, esto puede llevar a construcciones bastante complejas de varios hubs (uno por fuente + una versión maestra combinada), mientras que en el modelo Ancla cada clave natural de cada fuente se almacena en su propio atributo y puede ser utilizada durante la carga de manera independiente de los demás.
Pero aquí hay un punto engañoso: si en una entidad se combinan atributos de diferentes sistemas, probablemente existan ciertas reglas de 'fusión', según las cuales el sistema debe entender que los registros de diferentes fuentes corresponden a una instancia única de la entidad.
En Data Vault Estas reglas probablemente definirán la formación de 'un hub sustituto' de la entidad maestra y no influirán en los Hubs que almacenan las claves naturales de las fuentes y sus atributos originales. Si en algún momento las reglas de fusión cambian (o llega una actualización de los atributos sobre los que se realiza), será suficiente volver a formar los hubs sustitutos.
En El modelo Ancla tendrá tal entidad almacenada en un único ancla. Esto significa que todos los atributos, independientemente de la fuente de donde provienen, estarán vinculados a un mismo sustituto. Separar registros erróneamente fusionados y en general rastrear la validez de la fusión en tal sistema puede resultar mucho más difícil, especialmente si las reglas son lo suficientemente complejas y cambian con frecuencia, y el mismo atributo puede provenir de diferentes fuentes (aunque es exactamente posible, ya que cada versión del atributo conserva un enlace a su fuente).
En cualquier caso, si en su sistema se prevé la implementación de funcionalidades de deduplicación, fusión de registros y otros elementos de MDM, es especialmente importante familiarizarse con los aspectos del almacenamiento de claves naturales en metodologías flexibles. Es probable que una construcción más compleja de Data Vault resulte ser más segura en términos de errores de fusión.
El modelo Ancla también contempla un tipo adicional de objeto llamado Nudo (Knot) y en esencia es un tipo especial de ancla degenerada., que puede contener solo un atributo. Se supone que los nodos se utilizan para almacenar diccionarios planos (por ejemplo, género, estado civil, categoría de servicio al cliente, etc.). A diferencia de un ancla, un nodo no tiene tablas de atributos relacionadas, y su único atributo (nombre) siempre se almacena en la misma tabla con la clave. Los nodos se vinculan a las anclas mediante tablas de relación (Tie) de la misma manera que los anclas entre sí.
No hay un consenso definitivo sobre el uso de nodos. Por ejemplo, , que promueve activamente el uso del modelo de anclaje en Rusia, considera (no sin fundamento) que para ningún diccionario se puede afirmar con certeza que siempre será estático y unidimensional, por lo que para todos los objetos es mejor usar un ancla completa desde el principio.
Otra importante diferencia entre Data Vault y el modelo de anclaje es la existencia de atributos en las relaciones:
En Data Vault Las relaciones son objetos completos, al igual que los hubs, y pueden tener sus propios atributos. Hay El modelo Ancla Las relaciones se utilizan únicamente para conectar anclas y no pueden tener atributos propios. Esta diferencia da lugar a enfoques de modelado significativamente diferentes de hechos, sobre lo que se hablará a continuación.
Almacenamiento de hechos
Hasta ahora, hemos hablado principalmente sobre la modelización de dimensiones. Con los hechos la situación es un poco menos clara.
En Data Vault un objeto típico para almacenar hechos es Relación (Link), cuyos satélites contienen indicadores reales.
Este enfoque parece intuitivamente claro. Ofrece acceso sencillo a los indicadores analizados y en general es similar a una tabla de hechos tradicional (solo que los indicadores no se almacenan en la propia tabla, sino en la 'vecina'). Pero hay trampas: una de las modificaciones típicas del modelo —la expansión de la clave del hecho— presenta la necesidad de agregar una nueva clave externa en el Link. A su vez, esto 'rompe' la modularidad y potencialmente requiere modificaciones en otros objetos.
En El modelo Ancla La relación no puede tener atributos propios, por lo que este enfoque no funcionará: absolutamente todos los atributos e indicadores deben estar vinculados a un ancla concreta. La conclusión es simple: cada hecho también necesita su propio anclaPara una parte de lo que acostumbramos a ver como hechos, esto puede parecer natural, por ejemplo, el hecho de una compra se traduce perfectamente en un objeto “pedido” o “recibo”, la visita al sitio web se convierte en una sesión, etc. Pero hay hechos para los cuales encontrar un “objeto portador” natural no es tan sencillo, como por ejemplo, los inventarios de productos al inicio de cada día.
En consecuencia, no hay problemas de modularidad al expandir la clave del hecho en el modelo Anchor (solo es necesario agregar una nueva Relación al Anchor correspondiente), pero el diseño del modelo para mostrar hechos es menos claro, pueden surgir Anchors “artificiales” que no representan evidentemente el modelo de negocio.
Cómo se logra la flexibilidad
La construcción resultante en ambos casos contiene muchas más tablas, que una dimensión tradicional. Pero puede ocupar sustancialmente menos espacio en disco con el mismo conjunto de atributos de versión que una dimensión tradicional. No hay magia aquí, por supuesto — todo se trata de la normalización. Al distribuir atributos en los Satellites (en Data Vault) o en tablas separadas (Modelo Anchor), reducimos (o eliminamos completamente) la duplicación de valores de algún atributo al cambiar otros.
Para Data Vault el beneficio dependerá de la distribución de los atributos en los Satellites, y para El modelo Ancla es prácticamente directamente proporcional al número promedio de versiones del objeto de medición.
Sin embargo, la ganancia en espacio ocupado es un beneficio importante, pero no el principal ventaja del almacenamiento separado de atributos. Junto con el almacenamiento separado de relaciones, este enfoque convierte el almacenamiento en una construcción modular. Esto significa que la adición tanto de atributos individuales como de nuevas áreas temáticas a este modelo parece una superestructura sobre el conjunto existente de objetos sin modificarlos. Y esto es precisamente lo que hace que las metodologías descritas sean flexibles.
También recuerda la transición de la producción individual a la masiva — si en el enfoque tradicional cada tabla del modelo es única y requiere atención individual, en las metodologías flexibles, ya es un conjunto de “componentes” estándar. Por un lado, hay más tablas, los procesos de carga y extracción de datos deben parecer más complicados. Por otro lado, se vuelven estándar. Y eso significa que pueden ser automatizados y gestionados por metadatos. La pregunta “¿cómo vamos a estructurar?”, cuya respuesta podría haber ocupado una parte significativa del trabajo en el diseño de mejoras, ahora simplemente no se plantea (al igual que la pregunta sobre el impacto del cambio de modelo en los procesos operativos).
Esto no significa que los analistas en dicho sistema sean completamente prescindibles; aún se necesita a alguien que trabaje en un conjunto de objetos con atributos y sepa de dónde y cómo cargar todo esto. Sin embargo, el volumen de trabajo, así como la probabilidad y el costo de errores, se reducen significativamente. Tanto en la fase de análisis como en el desarrollo de ETL, que en gran medida puede resumirse en la edición de metadatos.
El lado oscuro
Todo lo anterior hace que ambos enfoques sean realmente flexibles, tecnológicos y aptos para desarrollos iterativos. Por supuesto, hay también un “tarro de miel”, del que, creo que ya te estás imaginando.
La descomposición de datos, que subyace a la modularidad de arquitecturas flexibles, lleva a un aumento en la cantidad de tablas y, por lo tanto, gastos generales en uniones durante la selección. Para obtener todos los atributos de la medida, en un almacén clásico basta con una sola selección, mientras que la arquitectura flexible requerirá una serie de uniones. Además, si para los informes se pueden escribir de antemano todas estas uniones, los analistas, acostumbrados a escribir SQL manualmente, sufrirán el doble.
Hay varios hechos que facilitan tal situación:
Al trabajar con grandes dimensiones, casi nunca se utilizan simultáneamente todos sus atributos. Esto significa que puede haber menos uniones de las que parecen a primera vista en el modelo. En Data Vault también se puede tener en cuenta la frecuencia esperada de uso conjunto al distribuir atributos entre satélites. Al mismo tiempo, los hubs o anclas son necesarios principalmente para generar y mapear sustitutos en la fase de carga y rara vez se utilizan en consultas (especialmente en el caso de las anclas).
Todas las uniones son por clave. Además, un método de almacenamiento de datos más "compacto" reduce los costos de escaneo de tablas donde sea necesario (por ejemplo, al filtrar por el valor de un atributo). Esto puede hacer que la selección de una base de datos normalizada con muchas uniones sea incluso más rápida que el escaneo de una única dimensión pesada con múltiples versiones por fila.
Por ejemplo, en este artículo hay una prueba comparativa detallada del rendimiento del Modelo Anchor con selección de una sola tabla.
Mucho depende del motor. Muchas plataformas modernas tienen mecanismos internos de optimización de uniones. Por ejemplo, MS SQL y Oracle pueden "omitir" uniones con tablas si sus datos no se utilizan en ningún otro lugar, excepto en otras uniones y no afectan la selección final (eliminación de tabla/unión), mientras que el MPP Vertica, según , ha demostrado ser un gran motor para el Modelo Anchor con cierta optimización manual del plan de consulta. Por otro lado, almacenar el Modelo Anchor, por ejemplo, en Click House, que tiene un soporte limitado para uniones, no parece ser una buena idea.
Además, para ambas arquitecturas existen técnicas especiales, que facilitan el acceso a los datos (tanto desde el punto de vista del rendimiento de las consultas como para los usuarios finales). Por ejemplo, las tablas Point-In-Time en Data Vault o funciones tabulares especiales en el Modelo Anchor.
Total
La esencia de estas arquitecturas flexibles radica en la modularidad de sus "construcciones".
Precisamente esta propiedad permite:
- Después de una preparación inicial relacionada con el despliegue de metadatos y la escritura de algoritmos básicos de ETL, proporcionar rápidamente al cliente un primer resultado en forma de un par de informes que contienen datos de solo unos pocos objetos fuente. No es necesario planificar completamente (incluso a un alto nivel) todo el modelo de objetos para esto.
- El modelo de datos puede comenzar a operar (y aportar beneficios) con solo 2-3 objetos, y luego crecer progresivamente (en relación con el Modelo Anchor, Nikolai una bonita comparación con una micorriza).
- La mayoría de las modificaciones, incluyendo la ampliación del dominio temático y la adición de nuevas fuentes no afectan la funcionalidad existente y no corren el riesgo de romper algo que ya esté funcionando..
- Gracias a la descomposición en elementos estándar, los procesos ETL en tales sistemas tienen una apariencia uniforme, su escritura puede ser sistematizada y, al final, automatización.
El precio de tal flexibilidad es rendimiento. Esto no significa que alcanzar un rendimiento aceptable en tales modelos sea imposible. Más bien, a menudo puede requerir más esfuerzo y atención a los detalles para lograr las métricas deseadas.
Aplicaciones
Tipos de entidad Data Vault
Más sobre Data Vault:
Tipos de entidades Modelo Ancla
Más sobre el modelo Anchor:
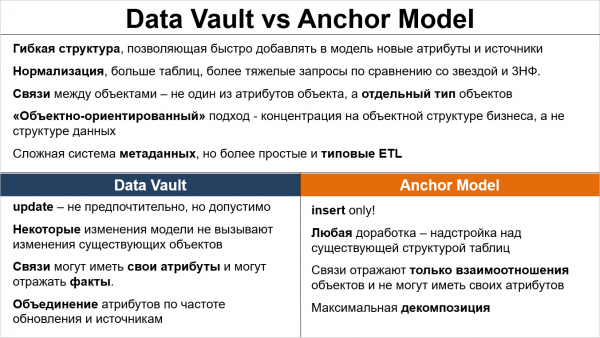
Tabla resumen con características comunes y diferencias de los enfoques discutidos:
Fuente: habr.com
