

El navegador Chromium, una plataforma de código abierto en activo desarrollo que es la madre de Google Chrome y del nuevo Microsoft Edge, ha atraído una atención negativa considerable debido a una función diseñada con buenas intenciones: verifica si el proveedor está 'robando' resultados de búsqueda inexistentes de dominios.
, generando solicitudes falsas de 'dominios' aleatorios cuya existencia es estadísticamente improbable, es responsable de aproximadamente la mitad del tráfico total recibido por los servidores DNS raíz en todo el mundo. El ingeniero de Verisign Matt Thomas escribió un extenso en el blog de APNIC describiendo el problema y evaluando su magnitud.
Cómo se realiza normalmente la resolución DNS
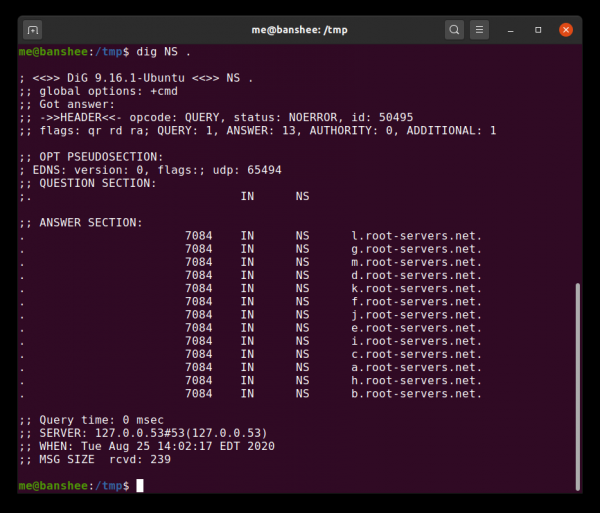
Estos servidores son la máxima autoridad a la que se debe recurrir para resolver .com, .net, etc., para informarle que frglxrtmpuf no es un dominio de nivel superior (TLD).
DNS, o Sistema de Nombres de Dominio, es un sistema que permite a las computadoras convertir nombres de dominio memorables como arstechnica.com en IP mucho menos convenientes, como 3.128.236.93. Sin DNS, Internet no podría existir de una manera comprensible para los humanos, lo que significa que una carga innecesaria en la infraestructura de nivel superior es un problema real.
Para cargar una sola página web moderna puede ser necesario un número inconcebible de búsquedas DNS. Por ejemplo, al analizar la página principal de ESPN, contamos 93 nombres de dominio individuales, desde a.espncdn.com hasta z.motads.com. ¡Todos ellos son necesarios para cargar la página por completo!
Para que el sistema de búsqueda pueda soportar esta carga, ya que necesita atender a todo el mundo, DNS está diseñada como una jerarquía multinivel. En la cima de esta pirámide están los servidores raíz: cada dominio de nivel superior, como .com, tiene su propio grupo de servidores que son la máxima autoridad para cada dominio por debajo de ellos. Un escalón por encima de estos servidores están los propios servidores raíz, desde a.root-servers.net hasta m.root-servers.net.
¿Con qué frecuencia ocurre esto?
Gracias a la jerarquía de caché de múltiples niveles de la infraestructura DNS, solo un pequeño porcentaje de las consultas DNS mundiales alcanza los servidores raíz. La mayoría de las personas obtiene información del resolvedor DNS directamente de su proveedor. Cuando un dispositivo del usuario necesita saber cómo llegar a un sitio web específico, la consulta se envía primero a un servidor DNS gestionado por ese proveedor local. Si el servidor DNS local no tiene una respuesta, redirige la consulta a sus propios "servidores de reenvío" (en caso de que estén configurados).
Si ni el servidor DNS del proveedor local ni los "servidores de reenvío" especificados en su configuración tienen una respuesta en caché, la consulta se eleva directamente al servidor de autoridad del dominio arriba que estás intentando resolver. En el caso de dominio.com esto significará que la consulta se envía a los servidores de autoridad del mismo dominio com, que están ubicados en la dirección gtld-servers.net.
Sistema gtld-servers, a la que se realizó la consulta, responde con una lista de servidores de nombres de autoridad para el dominio dominio.com, así como al menos un registro vinculante que contiene la dirección IP de uno de esos servidores de nombres. Luego, las respuestas se transmiten en cadena: cada servidor de reenvío envía estas respuestas hacia abajo al servidor que las solicitó, hasta que finalmente la respuesta llega al servidor del proveedor local y a la computadora del usuario. Todos ellos almacenan en caché esta respuesta para no tener que molestar a los sistemas de niveles superiores.
En la mayoría de los casos, los registros de servidores de nombres para dominio.com ya estarán en caché en uno de esos servidores de reenvío, por lo que los servidores raíz no son molestados. Sin embargo, mientras hablamos del formato habitual de URL — el que se convierte en un sitio web convencional. Las consultas de Chrome corresponden al nivel arriba de esto, en un nivel de los propios clústeres root-servers.net.
Chromium y la verificación de suplantación NXDomain
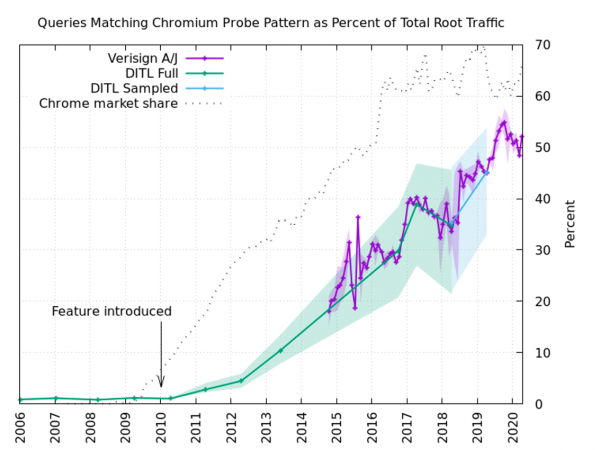
Las verificaciones de Chromium "¿este servidor DNS no me está engañando?" representan casi la mitad de todo el tráfico que llega al clúster de servidores DNS raíz de Verisign.
El navegador Chromium, el proyecto madre de Google Chrome, el nuevo Microsoft Edge y una cantidad innumerable de navegadores menos conocidos, desea proporcionar a los usuarios una forma sencilla de búsqueda en un solo campo, a veces llamado «Omnibox». En otras palabras, el usuario ingresa tanto URL reales como consultas a motores de búsqueda en el mismo campo de texto en la parte superior de la ventana del navegador. Avanzando un paso más hacia la simplificación, tampoco obliga al usuario a ingresar una parte de la URL con http:// o https://.
Por conveniente que sea, este enfoque requiere que el navegador entienda qué debe considerar como URL y qué como consulta de búsqueda. En la mayoría de los casos, esto es bastante obvio; por ejemplo, una cadena con espacios no puede ser una URL. Pero las cosas pueden ser más complicadas si se consideran las intranets: redes privadas que también pueden utilizar dominios de nivel superior privados para resolver sitios web reales.
Si un usuario en la intranet de su empresa ingresa «marketing», y hay un sitio web interno con ese mismo nombre, Chromium muestra un cuadro de información preguntando al usuario si desea buscar «marketing» o ir a https://marketing. Eso está bien, pero muchos proveedores de Internet y proveedores de redes Wi-Fi públicas «secuestran» cada URL ingresada con errores tipográficos, redirigiendo al usuario a alguna página llena de anuncios.
Generación aleatoria
Los desarrolladores de Chromium no querían que los usuarios en redes comunes vieran un cuadro de información preguntando qué querían decir cada vez que buscaban una sola palabra, así que implementaron una prueba: al iniciar el navegador o cambiar de red, Chromium realiza búsquedas DNS de tres «dominios» de nivel superior generados aleatoriamente, que tienen entre siete y quince caracteres. Si cualesquiera de estas dos consultas devuelve la misma dirección IP, Chromium asume que la red local está «secuestrando» errores NXDOMAIN, que debería recibir, por lo que el navegador considera todas las consultas de una sola palabra como intentos de búsqueda hasta nuevo aviso.
Desafortunadamente, en redes que no secuestran los resultados de consultas DNS, estas tres operaciones generalmente se elevan a la parte superior, hasta los mismos servidores raíz de nombres: el servidor local no sabe cómo resolver qwajuixk, por lo que redirige esta solicitud a su servidor de reenvío, que hace lo mismo hasta que, finalmente, a.root-servers.net o uno de sus «hermanos» no se ve obligado a decir «Lo siento, pero ese no es un dominio».
Dado que existen aproximadamente 1,67*10^21 posibles nombres de dominio falsos con longitudes de entre siete y quince caracteres, la mayoría de las veces cada una de estas pruebas, realizadas en una red «honesta», llega al servidor raíz. Esto representa aproximadamente la mitad de la carga total en los DNS raíz, según las estadísticas de esa parte de los clústeres root-servers.net, que pertenecen a la empresa Verisign.
La historia se repite
Este no es el primer caso en que un proyecto creado con las mejores intenciones o casi ha colapsado un recurso público con tráfico innecesario; nos recordó de inmediato la larga y triste historia de D-Link y el servidor NTP (Protocolo de Tiempo de Red) de Poul-Henning Kamp a mediados de los 2000.
En 2005, el desarrollador de FreeBSD Poul-Henning, que también poseía el único servidor NTP de nivel Stratum 1 en Dinamarca, recibió una factura inesperada y alta por el tráfico generado. En resumen, la razón fue que los desarrolladores de D-Link codificaron las direcciones de los servidores NTP de Stratum 1, incluido el servidor de Kamp, en el firmware de su línea de conmutadores, enrutadores y puntos de acceso. Esto incrementó instantáneamente el tráfico del servidor de Kamp en nueve veces, lo que llevó a que el Danish Internet Exchange (punto de intercambio de tráfico de Internet en Dinamarca) cambiara su tarifa de «Gratuita» a «9,000 dólares al año».
El problema no era que hubiera demasiados enrutadores D-Link, sino que estaban «rompiendo la jerarquía». Al igual que DNS, NTP debe funcionar de manera jerárquica; los servidores de nivel Stratum 0 transmiten información a los servidores Stratum 1, que a su vez envían información a los servidores Stratum 2, y así sucesivamente, hacia abajo por la jerarquía. Un enrutador doméstico típico, un conmutador o un punto de acceso, como aquellos donde D-Link incorporó las direcciones de los servidores NTP, deberían haber enviado solicitudes al servidor Stratum 2 o Stratum 3.
El proyecto Chromium, probablemente con las mejores intenciones, repitió el problema del NTP en el problema del DNS, inundando los servidores raíz de Internet con solicitudes que nunca debieron procesar.
Hay esperanza de una pronta solución
En el proyecto Chromium hay una apertura , que requiere desactivar por defecto el Intranet Redirect Detector para solucionar este problema. Debemos dar crédito al proyecto Chromium: el error fue descubierto antes de que, Matt Thomas de Verisign llamara la atención masiva sobre él con su en el blog de APNIC. El error fue reportado en junio, pero permaneció olvidado hasta la publicación de Thomas; después de eso, comenzó a estar bajo un cuidadoso escrutinio.
Hay esperanza de que el problema se resuelva pronto, y los servidores DNS raíz no tendrán que responder diariamente a unos 60 mil millones de solicitudes falsas.
Publicidad
Servidores épicos — es o Linux con potentes procesadores de la familia AMD EPYC y discos NVMe Intel muy rápidos. ¡No se pierda la oportunidad de pedirlo!
Fuente: habr.com
