

En la presentación, Andrey Borodin explicará cómo tuvieron en cuenta la experiencia de escalar PgBouncer al diseñar el pooler de conexiones , cómo lo implementaron en producción. Además, discutiremos qué funciones nos gustaría ver en nuevas versiones del pooler: es importante para nosotros no solo satisfacer nuestras necesidades, sino también desarrollar la comunidad de usuarios .
Video:
¡Hola a todos! Me llamo Andrey.
En Yandex, me dedico al desarrollo de bases de datos de código abierto. Hoy tenemos un tema sobre el pooler de conexiones.
Si sabes cómo llamar a un pooler de conexiones en español, házmelo saber. Tengo muchas ganas de encontrar un buen término técnico que se establezca en la literatura técnica.
El tema es bastante complejo, porque en muchas bases de datos el pooler de conexiones está integrado y ni siquiera es necesario conocerlo. Hay algunas configuraciones que, por supuesto, existen en todas partes, pero en Postgres no resulta así. Y paralelamente (en HighLoad++ 2019) hay una presentación de Nikolai Samokhvalov sobre la configuración de consultas en Postgres. Y entiendo que aquí han venido personas que ya han configurado consultas a la perfección, y son personas que enfrentan problemas sistémicos más raros relacionados con la red y la utilización de recursos. Y a veces esto puede ser bastante complicado en cuanto a que los problemas no son evidentes.
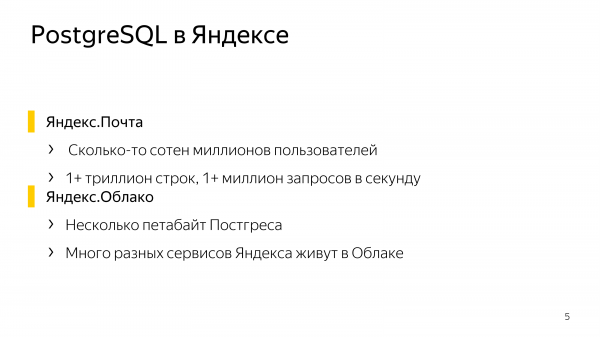
En Yandex hay Postgres. En Yandex.Cloud viven muchos servicios de Yandex. Y tenemos varios petabytes de datos que generan no menos de un millón de consultas por segundo en Postgres.
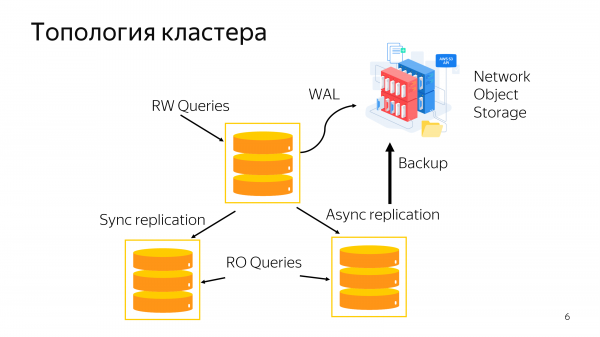
Y proporcionamos un clúster bastante típico a todos los servicios: esta es la principal nodo primaria, junto con dos replicas (síncrona y asíncrona), copias de seguridad y escalado de consultas de lectura en la réplica.
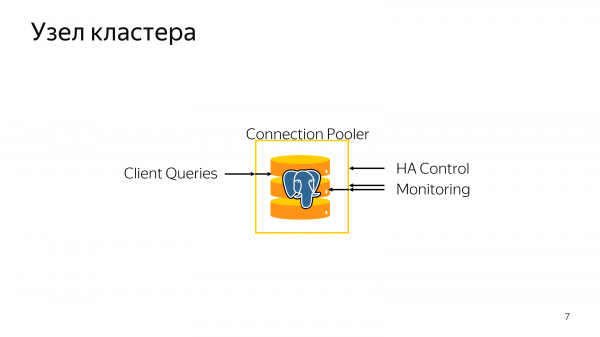
Cada nodo del clúster es un Postgres, en el que además de Postgres y sistemas de monitoreo, se ha instalado un pooler de conexiones. El pooler de conexiones se utiliza para fencing y por su propósito principal.
¿Cuál es el propósito principal del pooler de conexiones?
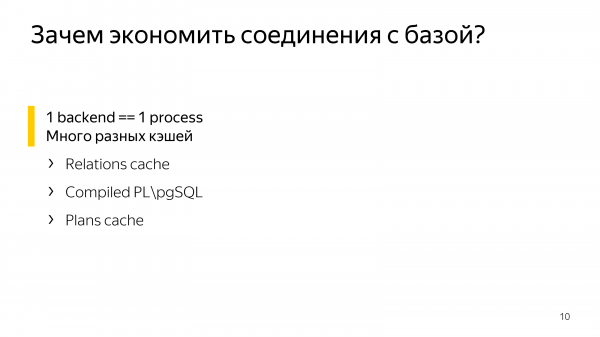
En Postgres se adopta un modelo de procesos al trabajar con la base de datos. Esto significa que una conexión es un proceso, un backend de Postgres. Y en este backend hay muchos tipos de cachés que son bastante costosos de hacer diferentes para distintas conexiones.
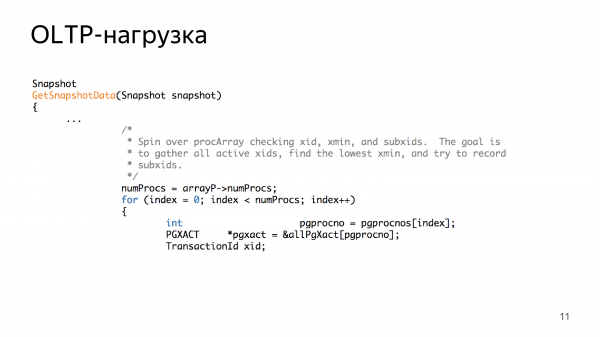
Además, en el código de Postgres hay una matriz llamada procArray. Contiene los datos básicos sobre las conexiones de red. Y casi todos los algoritmos de procesamiento de procArray tienen una complejidad lineal, recorren toda la matriz de conexiones de red. Este es un ciclo bastante rápido, pero con un gran número de conexiones de red entrantes, todo se vuelve un poco más costoso. Y cuando todo se vuelve un poco más caro, al final se puede pagar un precio muy alto por un gran número de conexiones de red.
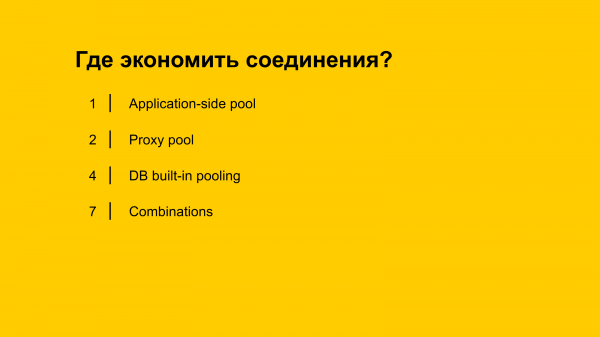
Existen 3 enfoques posibles:
- En el lado de la aplicación.
- En el lado de la base de datos.
- Y en medio, es decir, varias combinaciones.
Desafortunadamente, el pooler integrado está actualmente en desarrollo. Los amigos de PostgreSQL Professional se encargan principalmente de esto. Cuando aparezca, es difícil de predecir. Y de hecho, tenemos dos soluciones disponibles para el arquitecto. Es el pool de lado de la aplicación y el pool proxy.
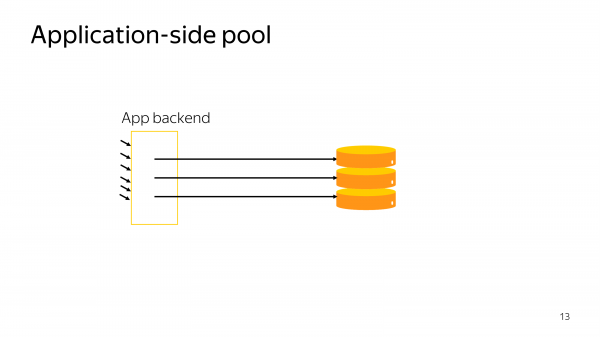
El pool de lado de la aplicación es la forma más simple. Y casi todos los controladores de cliente te proporcionan una forma de presentar millones de tus conexiones en el código como unas pocas decenas de conexiones en la base de datos.
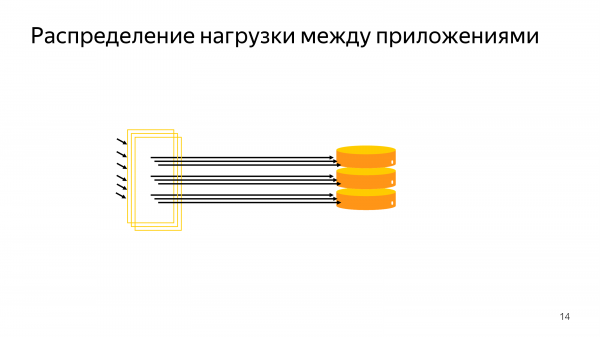
Surge el problema de que en algún momento quieres escalar el backend, quieres desplegarlo en múltiples máquinas virtuales.
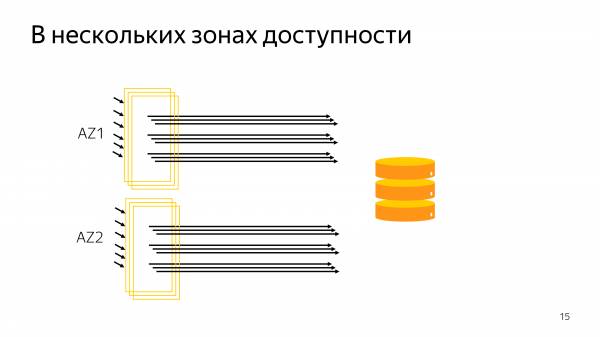
Luego también te das cuenta de que tienes varias zonas de disponibilidad, varios centros de datos. Y el enfoque de pooling del lado del cliente lleva a grandes números. Grandes son alrededor de 10,000 conexiones. Ese es el límite en el que puede funcionar adecuadamente.
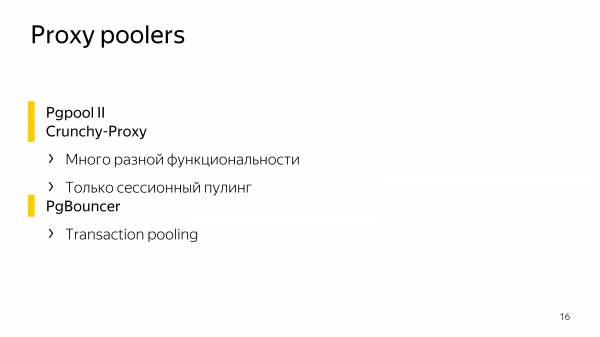
En cuanto a los poolers proxy, hay dos poolers que pueden hacer muchas cosas. No solo son poolers. Son poolers + funcionalidad adicional genial. Esto es y .
Pero, desafortunadamente, esta funcionalidad adicional no es necesaria para todos. Y lleva a que los poolers solo admitan el pooling por sesión, es decir, un cliente entrante, un cliente saliente en la base de datos.
Para nuestras tareas, esto no se adapta muy bien, por eso usamos PgBouncer, que implementa el pooling por transacciones, es decir, las conexiones del servidor se emparejan con las conexiones del cliente solo durante el tiempo de la transacción.
Y bajo nuestra carga, esto es cierto. Pero hay varios problemas..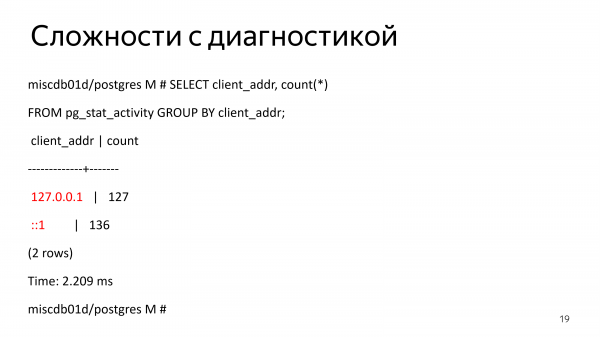
Los problemas comienzan cuando quieres diagnosticar una sesión, porque todas las conexiones entrantes son locales. Todas vinieron del loopback y trazar una sesión se vuelve complicado.
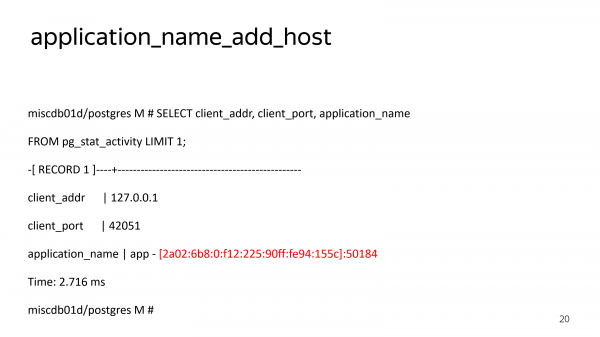
Por supuesto, puedes utilizar application_name_add_host. Esta es una manera de que Bouncer añada una dirección IP a application_name. Pero application_name se establece mediante una conexión adicional.
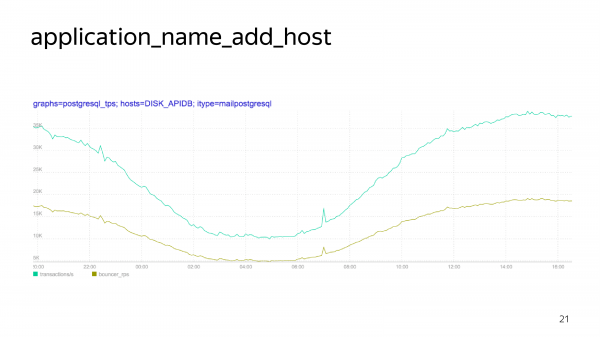
En este gráfico, donde la línea amarilla representa las solicitudes reales, y donde la línea azul las solicitudes que llegan a la base de datos. Y esta diferencia es precisamente la configuración de application_name, que se necesita solo para el seguimiento, pero no es en absoluto gratuita.
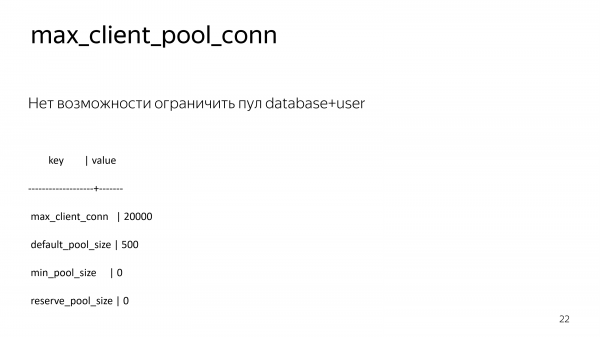
Además, en Bouncer no se puede limitar un pool, es decir, el número de conexiones a la base de datos de un usuario específico, para una base de datos específica.
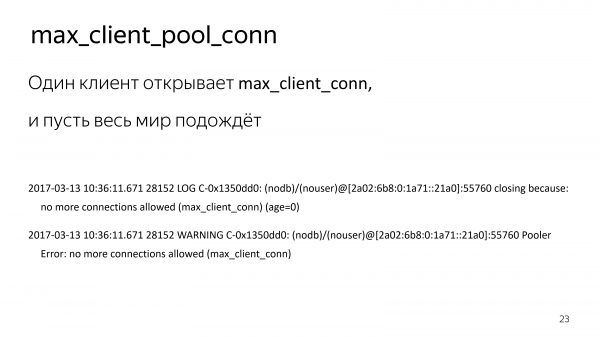
¿A dónde lleva esto? Tienes un servicio sobrecargado, escrito en C++, y cerca de él un pequeño servicio en node que no hace nada grave con la base de datos, pero su controlador se vuelve loco. Abre 20,000 conexiones, y todo lo demás tendrá que esperar. Tu código está bien.
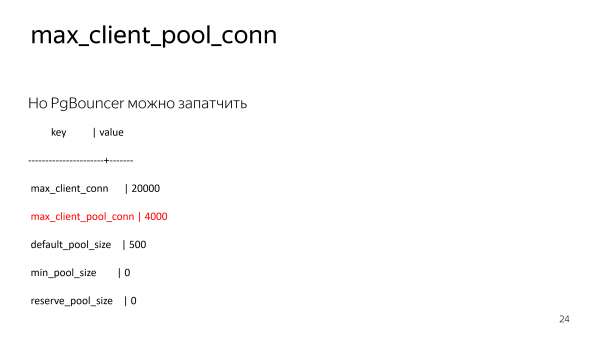
Desde luego, escribimos un pequeño parche para Bouncer que añadió esta configuración, es decir, la limitación de clientes en el pool.
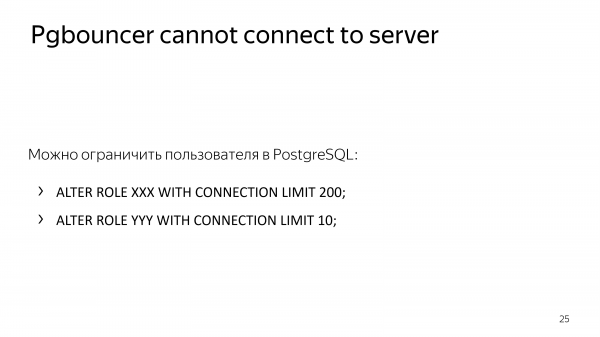
Se podría hacer del lado de Postgres, es decir, limitar el número de conexiones para los roles en la base de datos.
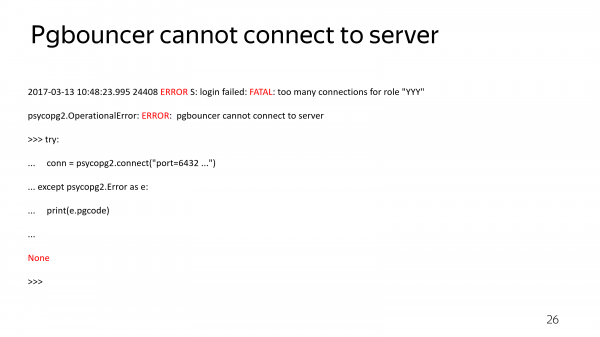
Pero entonces pierdes la capacidad de entender por qué no tienes conexiones con el servidor. PgBouncer no transmite el error de conexión, siempre devuelve la misma información. Y no puedes comprender: tal vez tu contraseña ha cambiado, tal vez la base de datos simplemente se ha caído, tal vez algo no está bien. Pero no hay diagnóstico. Si no se puede establecer la sesión, no sabrás por qué no se puede hacer.
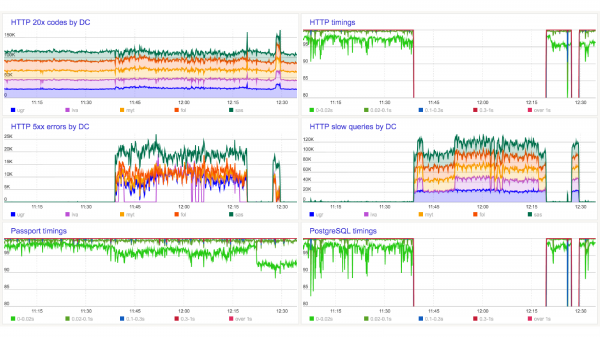
En algún momento observas las gráficas de la aplicación y ves que la aplicación no está funcionando.
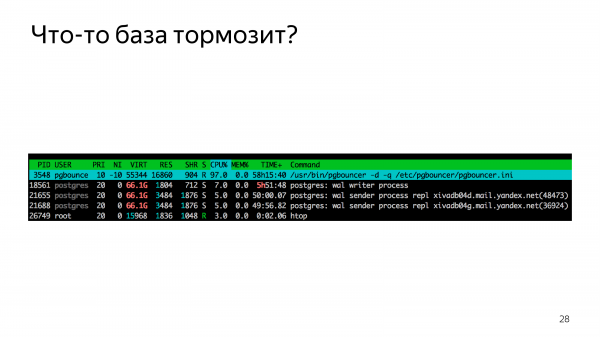
Miras el top y ves que Bouncer es de un solo hilo. Este es un punto de inflexión en la vida del servicio. Te das cuenta de que te preparabas para la escalabilidad de la base de datos en un año y medio, pero ahora necesitas escalar el pooler.
Llegamos a la conclusión de que necesitamos más PgBouncer.
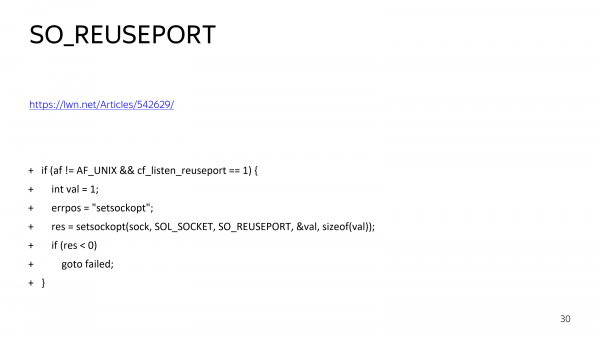
Hicimos algunos pequeños parches a Bouncer.
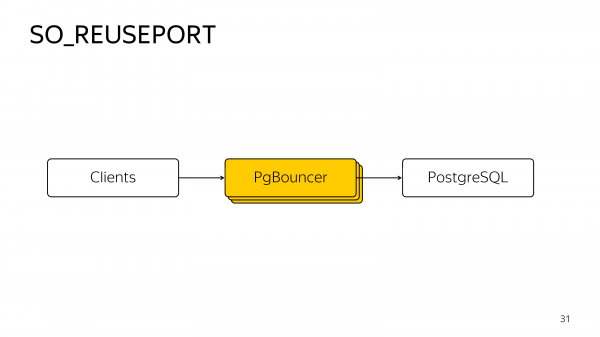
Y configuramos que se puedan levantar varios Bouncers reutilizando el puerto TCP. Y ya el sistema operativo redistribuye automáticamente las conexiones TCP entrantes entre ellos de manera round-robin.
Esto es transparente para los clientes, es decir, todo parece que tienes un solo Bouncer, pero tienes una fragmentación de conexiones inactivas entre los Bouncers en funcionamiento.
Y en un momento determinado, puede notar que estos 3 Bouncers están utilizando cada uno su núcleo al 100%. Necesita bastante Bouncers. ¿Por qué?
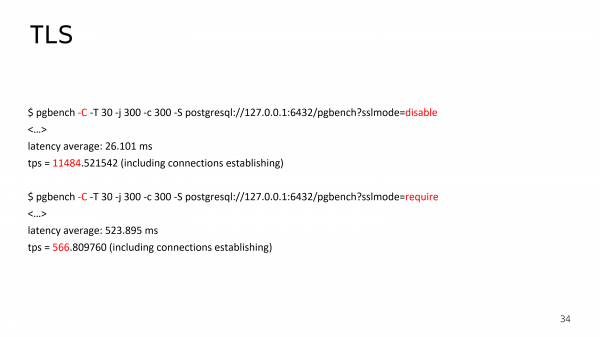
Porque tiene TLS. Tiene una conexión cifrada. Y si hace benchmarks de Postgres con TLS y sin TLS, descubrirá que el número de conexiones establecidas disminuye casi en dos órdenes de magnitud con la inclusión del cifrado, porque el apretón de manos de TLS consume recursos de la CPU.
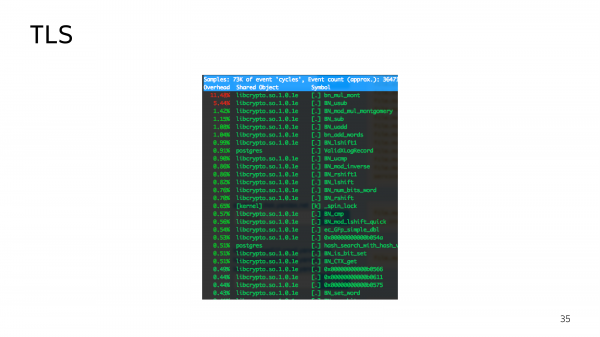
Y en la parte superior, puede ver varias funciones criptográficas que se llevan a cabo durante la oleada de conexiones entrantes. Dado que nuestro primary puede cambiar entre zonas de disponibilidad, la oleada de conexiones entrantes es una situación bastante típica. Es decir, por alguna razón, el antiguo primary no estaba disponible, y toda la carga fue enviada a otro centro de datos. Todos llegarán al mismo tiempo para saludar con TLS.
Y una gran cantidad de apretón de manos de TLS puede no saludar ya a Bouncer, sino que puede ahogarlo. Debido al tiempo de espera, la oleada de conexiones entrantes puede volverse inagotable. Si tiene reintentos en la base sin un backoff exponencial, no llegarán una y otra vez como una ola coherente.
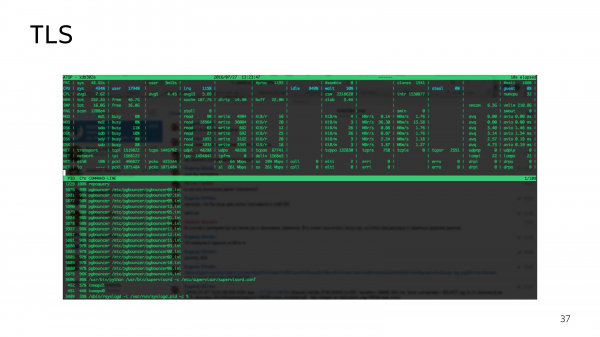
Aquí hay un ejemplo de 16 PgBouncers que utilizan 16 núcleos al 100%.
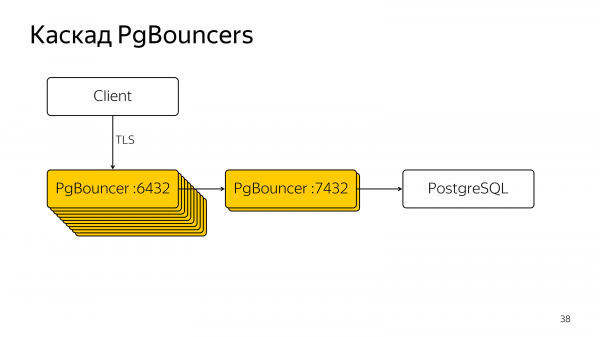
Hemos llegado al PgBouncer en cascada. Esta es la mejor configuración que se puede alcanzar con nuestra carga con Bouncer. Los Bouncers externos sirven para el apretón de manos TCP, mientras que los Bouncers internos sirven para el pooling real, para no fragmentar demasiado las conexiones externas.
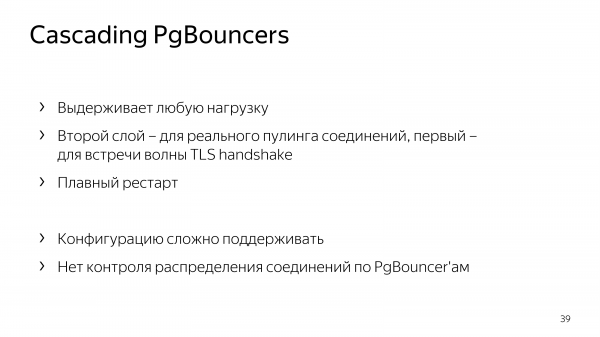
En tal configuración, es posible un reinicio suave. Puede reiniciar todos estos 18 Bouncers uno por uno. Pero mantener tal configuración es bastante difícil. Los administradores del sistema, los DevOps y las personas que realmente son responsables de este servidor no estarán muy contentos con tal esquema.
Aparentemente, podríamos promover todas nuestras mejoras en open source, pero Bouncer no tiene un buen soporte. Por ejemplo, la capacidad de ejecutar múltiples PgBouncers en un solo puerto se comprometió hace un mes. Y la solicitud de incorporación con esta función fue hace varios años.
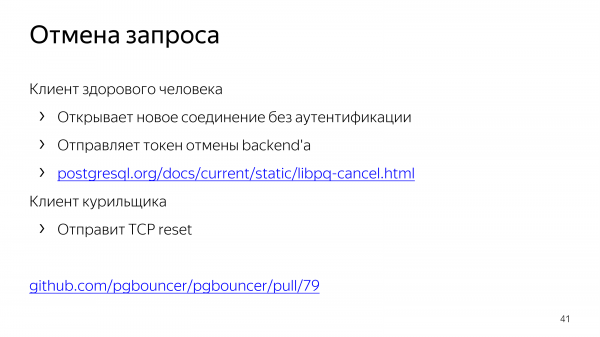
O otro ejemplo. En Postgres, puedes cancelar una consulta en ejecución enviando un secreto a otra conexión sin autenticación adicional. Pero algunos clientes simplemente envían un TCP-reset, es decir, rompen la conexión de red. ¿Qué hará Bouncer en ese caso? No hará nada. Continuará ejecutando la consulta. Si tienes una enorme cantidad de conexiones que han saturado la base de datos con pequeñas consultas, simplemente desconectar de Bouncer no será suficiente, también tendrás que terminar aquellas consultas que están corriendo en la base de datos.
Esto se ha parcheado y este problema aún no se ha fusionado en el upstream de Bouncer.
Así llegamos a la conclusión de que necesitamos nuestro propio pool de conexiones, que se desarrollará, será parcheado, en el que podamos corregir problemas de manera rápida y que, por supuesto, debe ser multihilo.
Hemos establecido la multihilo como una tarea principal. Necesitamos manejar bien la ola de conexiones TLS entrantes.
Para esto, tuvimos que desarrollar una biblioteca separada llamada Machinarium, que está destinada a describir los estados de las máquinas en la conexión de red como código secuencial. Si miras el código fuente de libpq, verás llamadas bastante complejas que pueden devolverte un resultado y decir: 'Llámame más tarde. Ahora tengo IO, pero cuando termine el IO, tendré carga para el procesador'. Y este es un esquema de múltiples niveles. La interacción en red generalmente se describe mediante máquinas de estado. Con muchas reglas como 'Si antes recibí un encabezado de paquete de tamaño N, ahora espero N bytes', 'Si envié un paquete SYNC, ahora espero un paquete con los metadatos del resultado'. Esto resulta en un código bastante difícil de seguir, como si un laberinto se convirtiera en un despliegue lineal. Hicimos que en lugar de una máquina de estados, el programador describa el camino principal de la interacción en código imperativo común. Simplemente, en este código imperativo, necesitas insertar lugares donde la secuencia de ejecución deba interrumpirse para esperar datos de la red, pasando el contexto de ejecución a otra corutina (green thread). Este enfoque es similar a escribir el camino más esperado en el laberinto de forma secuencial y luego agregarle ramificaciones.
Al final, tenemos un flujo que realiza un TCP accept y mediante round-robin distribuye una conexión TPC a múltiples workers.
Cada conexión del cliente siempre funciona en un solo procesador. Esto permite que sea amigable con el caché.
Además, hemos mejorado la recolección de pequeños paquetes en uno grande para reducir la carga del TCP-stack del sistema.
También hemos optimizado el pooling transaccional de manera que Odyssey, con la configuración adecuada, puede enviar CANCEL y ROLLBACK en caso de interrupción de la conexión de red, es decir, si nadie está esperando la solicitud, Odyssey le indicará a la base de datos que no se esfuerce en ejecutar esa solicitud que podría consumir recursos valiosos.
Y, en la medida de lo posible, mantenemos las conexiones con el mismo cliente. Esto evita reinstalar application_name_add_host. Si es posible, no hay reinstalación adicional de parámetros necesarios para diagnóstico.
Trabajamos en interés de Yandex.Cloud. Si utiliza PostgreSQL gestionado y tiene un connection pooler configurado, puede crear replicación lógica hacia afuera, es decir, irse de nosotros si lo desea, mediante replicación lógica. El Bouncer no entregará el flujo de replicación lógica hacia afuera.
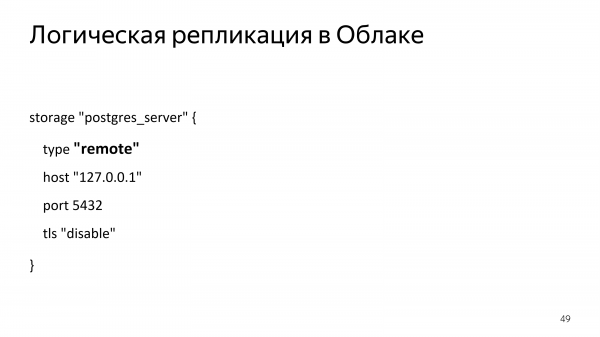
Este es un ejemplo de configuración de replicación lógica.
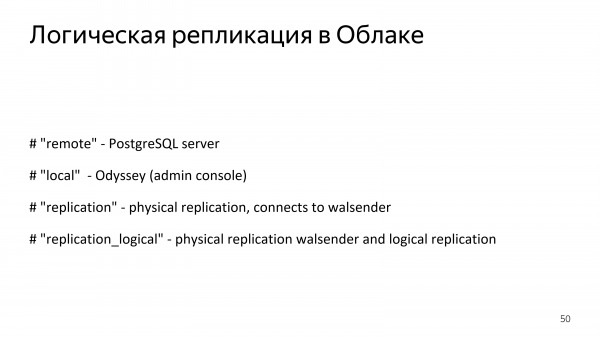
Además, tenemos soporte para replicación física hacia afuera. En la Nube, por supuesto, esto no es posible porque entonces su clúster daría demasiada información sobre sí mismo. Sin embargo, en sus instalaciones, si necesita replicación física a través del connection pooler en Odyssey, es posible.
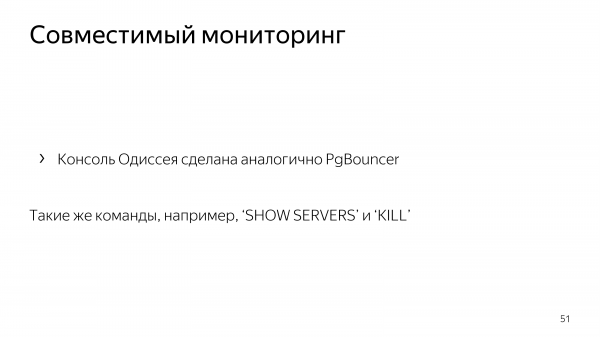
En Odyssey, hay un monitoreo completamente compatible con PgBouncer. Tenemos una consola similar que ejecuta casi los mismos comandos. Si falta algo, envíenos un pull request o al menos un issue en GitHub, y estaremos encantados de agregar los comandos necesarios. Pero ya tenemos la funcionalidad principal de la consola de PgBouncer.
Y, por supuesto, tenemos el reenvío de errores. Devolveremos el error que informó la base de datos. Recibirá información sobre por qué no puede acceder a la base, en lugar de simplemente que no puede acceder.
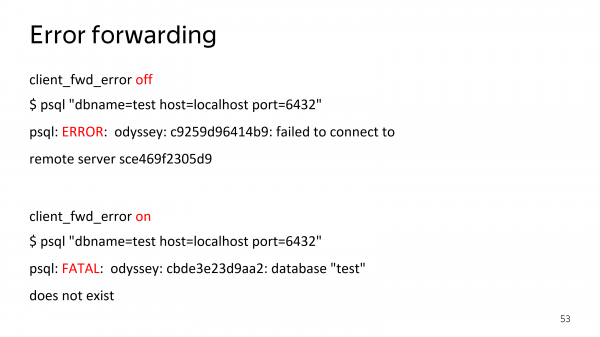
Esta capacidad se puede desactivar en caso de que necesite una compatibilidad del 100% con PgBouncer. Podemos comportarnos igual que el Bouncer, por si acaso.
Desarrollo
Algunas palabras sobre el código fuente de Odyssey.
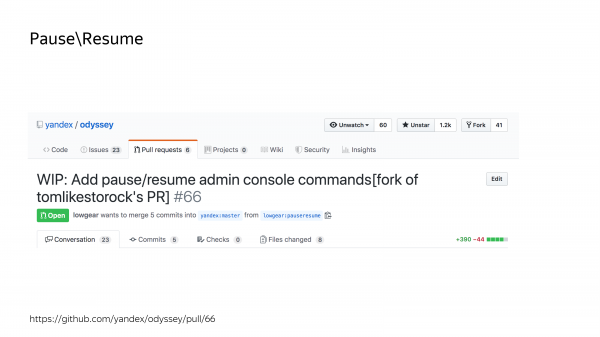
Por ejemplo, hay comandos como «Pause / Resume». Normalmente se utilizan para actualizar la base de datos. Si necesitas actualizar Postgres, puedes ponerlo en pausa en el pool de conexiones, hacer un pg_upgrade y luego reanudarlo. Desde el lado del cliente, parecerá que la base de datos simplemente se detuvo. Esta funcionalidad fue traída por personas de la comunidad. Aún no ha sido fusionada, pero pronto estará disponible. (Ya está fusionada)
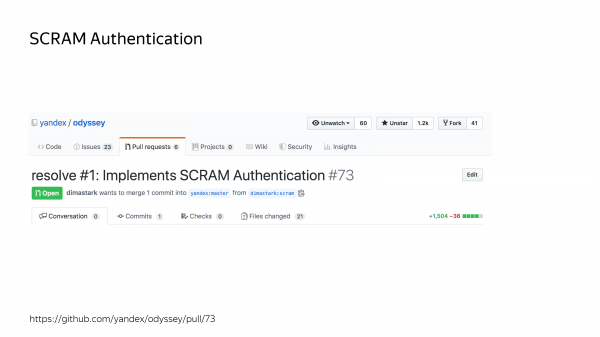
— ya está fusionada
Además, una de las nuevas características de PgBouncer es el soporte para la autenticación SCRAM, también traída por una persona que no trabaja en Yandex.Cloud. Ambas funcionalidades son complejas e importantes.
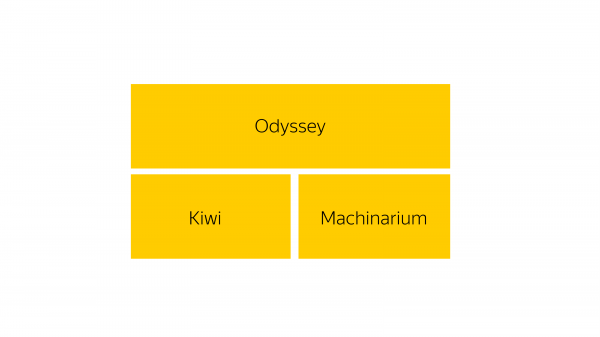
Por eso, quiero contarles de qué está hecho Odyssey, quizás también quieran escribir un poco de código.
Tienes la base Odyssey, que se basa en dos bibliotecas principales. La biblioteca Kiwi es una implementación del protocolo de mensajes de Postgres. Es decir, el proto 3 nativo de Postgres son los mensajes estándar que los frontends y backends pueden intercambiar. Esto está implementado en la biblioteca Kiwi.
La biblioteca Machinarium es la implementación de flujos. Un pequeño fragmento de este Machinarium está escrito en ensamblador. Pero no se asusten, son solo 15 líneas.
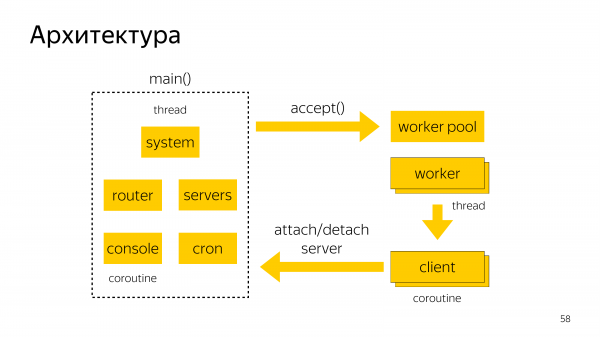
Arquitectura de Odyssey. Hay una máquina principal donde se ejecutan corutinas. En esta máquina se realiza la aceptación de conexiones TCP entrantes y su distribución a los workers.
Dentro de un worker puede trabajar un manejador de varios clientes. Además, en el hilo principal se ejecutan la consola y el procesamiento de tareas crone para eliminar conexiones que ya no son necesarias en el pool.
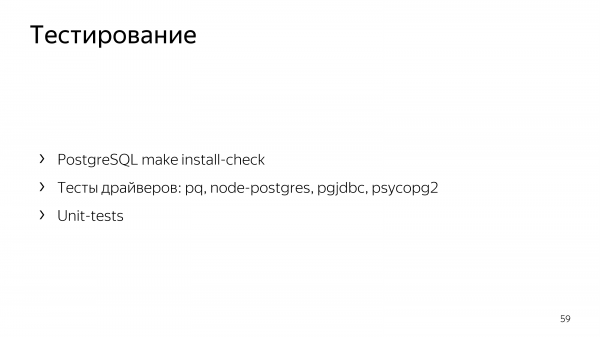
Para probar Odyssey, se utiliza el conjunto estándar de pruebas de Postgres. Simplemente ejecutamos install-check a través de Bouncer y a través de Odyssey, obteniendo un div cero. Hay varias pruebas relacionadas con el formateo de fechas que no pasan de manera idéntica en Bouncer y en Odyssey.
Además, hay muchos drivers que tienen sus propias pruebas. Utilizamos estas pruebas para probar Odyssey.
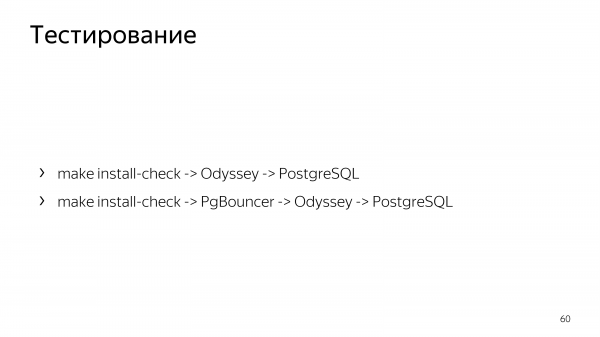
Además, debido a nuestra configuración en cascada, tenemos que probar diferentes combinaciones: Postgres + Odyssey, PgBouncer + Odyssey, Odyssey + Odyssey, para asegurarnos de que, si Odyssey se encuentra en alguna parte de la cascada, también sigue funcionando como esperamos.
Trampas
Utilizamos Odyssey en producción. No sería justo decir que todo funciona sin problemas. No, o sea, sí, pero no siempre. Por ejemplo, en producción todo funcionó bien, luego nuestros amigos de PostgreSQL Professional llegaron y dijeron que teníamos una fuga de memoria. Ellos tenían razón, la corregimos. Pero eso fue simplemente.
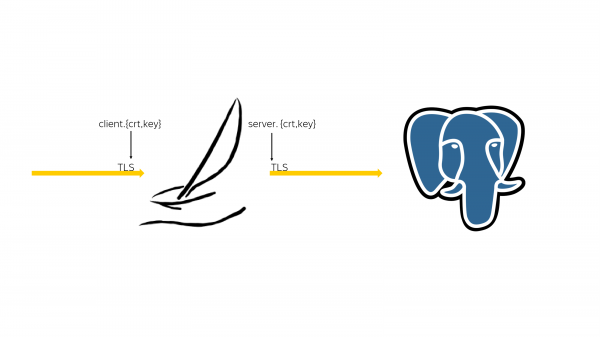
Luego descubrimos que en el pool de conexiones hay conexiones TLS entrantes y salientes. Y se requieren certificados de cliente y certificados de servidor en las conexiones.
Los certificados de servidor Bouncer y Odyssey los leen desde su pcache, pero los certificados de cliente no necesitan leerse desde pcache porque nuestro Odyssey escalable acaba topando con el rendimiento del sistema en la lectura de ese certificado. Esto nos sorprendió, pues no ocurrió de inmediato. Al principio escalaba de manera lineal, y después de 20,000 conexiones simultáneas entrantes, se presentó este problema.
El Método de Autenticación Pluggable es la capacidad de autenticarse utilizando herramientas integradas de Linux. En PgBouncer se implementa de tal manera que hay un hilo separado para esperar la respuesta de PAM y hay el hilo principal de PgBouncer, que atiende la conexión actual y puede pedir que se mantengan en el hilo de PAM.
No implementamos esto por una sencilla razón. Tenemos muchos hilos. ¿Para qué lo necesitamos?
Esto podría causar problemas porque si tiene autenticación PAM y no PAM, una gran ola de autenticaciones PAM puede retrasar significativamente las no PAM. Esta es una de esas cosas que no corregimos. Pero si desea corregirlo, puede ocuparse de ello.
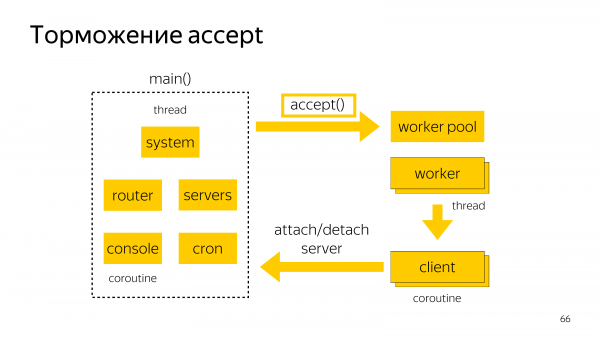
Otro problema fue que tenemos un hilo que acepta todas las conexiones entrantes. Y luego las pasa al pool de trabajadores, donde se realizará el apretón de manos TLS.
Así que si tiene una ola coherente de 20,000 conexiones de red, todas serán aceptadas. Y del lado del cliente, libpq comenzará a registrar los tiempos de espera. Por defecto, parece que son 3 segundos.
Si no pueden acceder a la base de datos al mismo tiempo, entonces no pueden acceder a la base de datos, porque todo esto podría estar cubierto por un retry no exponencial.
Llegamos a la conclusión de que copiamos aquí el esquema de PgBouncer con la que tenemos un control en la cantidad de conexiones TCP, las cuales aceptamos.
Si vemos que aceptamos conexiones, pero estas finalmente no logran hacer el handshake, las colocamos en una cola para que no consuman recursos de la CPU. Esto provoca que el handshake simultáneo puede no realizarse para todas las conexiones que llegaron. Pero al menos alguien entrará a la base, incluso si la carga es bastante alta.
Hoja de ruta
¿Qué gustaría ver en el futuro en Odyssey? ¿Qué estamos dispuestos a desarrollar nosotros mismos y qué esperamos de la comunidad?
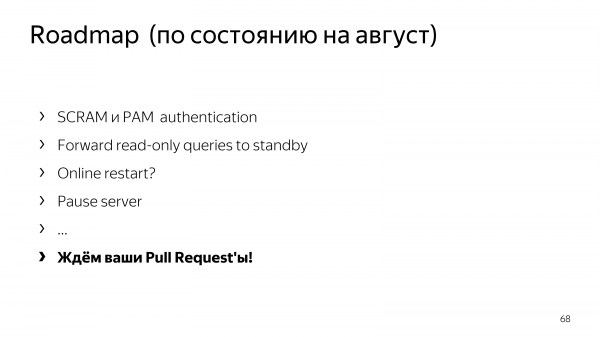
A agosto de 2019.
Así lucía la hoja de ruta de Odyssey en agosto:
- Queríamos autenticación SCRAM y PAM.
- Queríamos redirigir consultas de lectura a standby.
- Nos gustaría un reinicio en línea.
- Y la posibilidad de hacer pausas en el servidor.
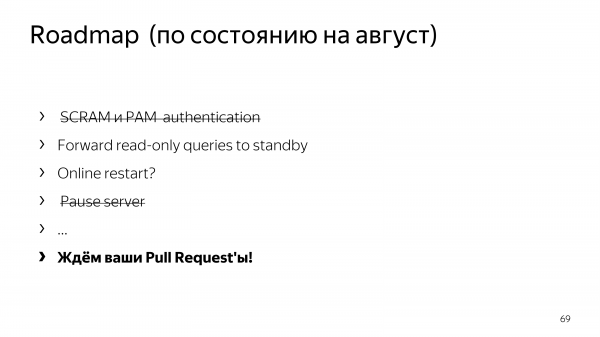
La mitad de esta hoja de ruta se ha cumplido, y no por nosotros. Y eso es bueno. Así que hablemos de lo que queda y añadamos más.
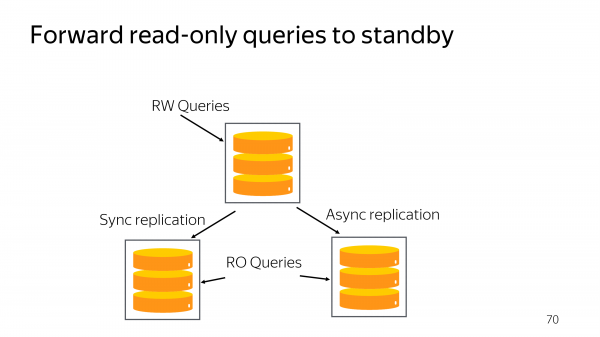
? У нас есть реплики, которые без выполнения запросов будут просто греть воздух. Они нам необходимы для обеспечения failover и switchover. В случае проблем в одном из дата-центре хотелось бы их занять какой-то полезной работой. Потому что те же самые центральные процессоры, ту же самую память мы не можем сконфигурировать по-другому, потому что иначе не будет работать репликация.
En principio, en Postgres, desde la versión 10, hay posibilidad al conectar de indicar también session_attrs. En la conexión puedes enumerar todos los hosts de las bases de datos y decir por qué accedes a la base de datos: para escribir o solo para leer. Y el controlador elegirá el primer host de la lista que más le guste, que cumpla con los requisitos de session_attrs.
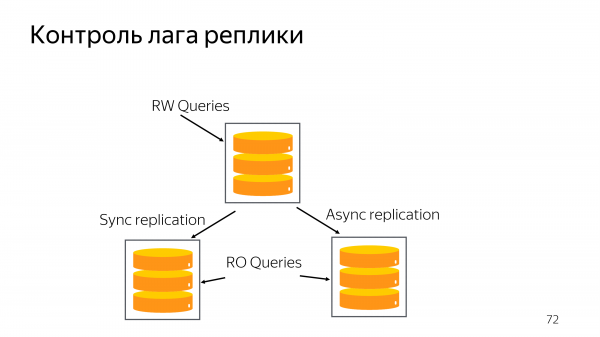
Pero el problema de este enfoque es que no controla el retraso de replicación. Puede haber alguna réplica que esté atrasada en un tiempo inaceptable para tu servicio. Para hacer que las consultas de lectura funcionen plenamente en la réplica, necesitamos mantener en Odyssey la capacidad de no operar cuando no se puede leer.
Odyssey debería consultar periódicamente la base y preguntar la distancia de replicación desde el primario. Y si ha alcanzado el valor límite, no permitir nuevas consultas a la base, informar al cliente que debe reiniciar las conexiones y posiblemente elegir otro host para ejecutar las consultas. Esto permitirá que la base recupere más rápido el retraso de replicación y vuelva a responder a las consultas.
Es difícil nombrar plazos de implementación, ya que es open source. Pero espero que no sean 2,5 años como en el caso de mis colegas de PgBouncer. Esta función me gustaría ver en Odyssey.
Ahora puede crear declaraciones preparadas de dos maneras. Primero, puede ejecutar el comando SQL, es decir, 'prepared'. Para comprender este comando SQL, necesitamos aprender a entender SQL desde el lado de Bouncer. Sería un exceso, porque necesitamos un analizador completo. No podemos analizar cada comando SQL.
Pero hay declaraciones preparadas a nivel de protocolo de mensajes en proto3. Y ese es el momento en que la información sobre la creación de la declaración preparada llega en forma estructurada. Y podríamos mantener la comprensión de que en cierta conexión del servidor, el cliente solicitó crear declaraciones preparadas. E incluso si la transacción se cerró, aún necesitamos mantener la coherencia entre el servidor y el cliente.
Pero aquí surge una discrepancia en el diálogo, porque alguien dice que es necesario entender qué declaraciones preparadas creó el cliente y dividir la conexión del servidor entre todos los clientes que crearon esta conexión del servidor, es decir, aquellos que crearon tal declaración preparada.
Andrés Freund dijo que si llega un cliente que ya creó tal declaración preparada en otra conexión del servidor, entonces créelo por él. Pero parece un poco incorrecto ejecutar consultas en la base de datos en lugar del cliente, aunque desde la perspectiva del desarrollador que escribe el protocolo de interacción con la base de datos, sería conveniente que simplemente le proporcionaran una conexión de red en la que existe tal consulta preparada.
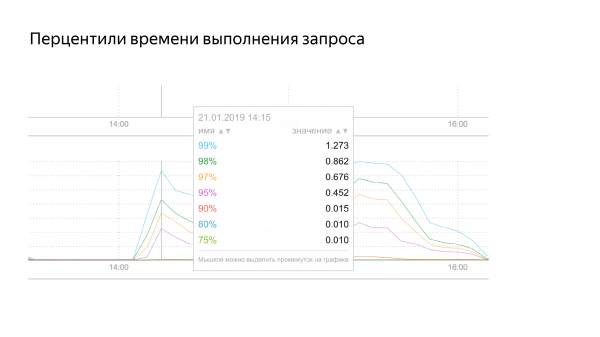
Y otra característica que necesitamos implementar. Actualmente tenemos un monitoreo compatible con PgBouncer. Podemos devolver el tiempo promedio de ejecución de la consulta. Pero el tiempo promedio es como la temperatura media en un hospital: algunos están fríos, otros tibios; en promedio todos están sanos. Eso no es verdad.
Necesitamos implementar el soporte para percentiles que indiquen que hay consultas lentas que consumen recursos y harían que el monitoreo sea más aceptable.
Lo más importante es que quiero la versión 1.0 (ya ha salido la versión 1.1). La cuestión es que ahora Odyssey está en la versión 1.0rc, es decir, candidato a lanzamiento. Y todos los problemas que mencioné se han solucionado precisamente con esa versión, excepto la fuga de memoria.
¿Qué significará para nosotros la versión 1.0? Estamos lanzando Odyssey en nuestras bases. Ya está funcionando en nuestras bases, pero cuando alcance la marca de 1,000,000 de solicitudes por segundo, podremos decir que esta es la versión de lanzamiento y que se puede considerar la versión 1.0.
En la comunidad, algunas personas han pedido que la versión 1.0 incluya una pausa y SCRAM. Pero eso significará que tendremos que lanzar la siguiente versión en producción, porque ni SCRAM ni la pausa se han fusionado aún. Sin embargo, es probable que este problema se resuelva con bastante rapidez.
Estoy esperando sus pull requests. También me gustaría saber qué problemas tienen con Bouncer. Discutámoslo. Quizás podamos implementar algunas funciones que ustedes necesiten.
Con esto concluyo mi parte, me gustaría escucharlos. ¡Gracias!
Preguntas
Si configuro application_name, ¿se transmitirá correctamente, incluso en el pooling de transacciones en Odyssey?
¿En Odyssey o en Bouncer?
En Odyssey. En Bouncer se transmite.
Realizaremos el set.
Y si mi conexión real salta entre otras conexiones, ¿se transmitirá?
Haremos un set de todos los parámetros que están en la lista. No puedo decir si application_name está en esta lista. Creo haberlo visto ahí. Estableceremos todos los mismos parámetros. Con una sola solicitud, el set hará todo lo que se configuró por el cliente al iniciar.
¡Gracias, Andrey, por la presentación! ¡Buena presentación! Me alegra que Odyssey esté evolucionando cada vez más rápido. Espero que continúen así. Ya nos hemos comunicado con ustedes sobre la posibilidad de una conexión multi data-source, para que Odyssey pueda conectarse simultáneamente a diferentes bases de datos, es decir, master-slave, y luego conectarse automáticamente a un nuevo master después de un failover.
Sí, creo recordar esa discusión. Actualmente hay varios storages. Pero no hay conmutación entre ellos. Debemos sondear el servidor de nuestro lado para saber si sigue activo y entender que ha ocurrido un failover, quien llamará a pg_recovery. Tengo un método estándar para saber que no estamos conectados al master. Y debemos averiguarlo a partir de algún error o de otra manera. Es decir, la idea es interesante, se está discutiendo. Escriban más comentarios. Si tienen manos a la obra que sepan C, sería genial.
La cuestión de la escalabilidad a través de réplicas también nos interesa, porque queremos hacer que la adopción de clústeres replicados sea lo más simple posible para los desarrolladores de aplicaciones. Sin embargo, aquí nos gustaría tener más comentarios, es decir, cómo exactamente hacerlo, cómo hacerlo bien.
La pregunta también es sobre las réplicas. Así que tienen un maestro y varias réplicas. Y está claro que se accede a la réplica con menor frecuencia que al maestro en cuanto a las conexiones, porque pueden tener diferencias. Ustedes mencionaron que las diferencias en los datos pueden ser tales que no satisfacen su negocio y no accederán a ellas hasta que se repliquen completamente. Además, si no se accede durante mucho tiempo, y luego se comienza a acceder, los datos que se necesitan no estarán disponibles de inmediato. Es decir, si constantemente accedemos al maestro, el caché allí está caliente, mientras que en la réplica el caché se queda un poco atrás.
Sí, es cierto. En el pcache no habrá bloques de datos que deseen, en el cache real no habrá información sobre las tablas que desean, en los planes no habrá consultas analizadas, en general, no habrá nada.
Y cuando tienen un clúster y añaden una nueva réplica, mientras se inicia, todo va mal, es decir, va acumulando su caché.
Entendí la idea. Un enfoque correcto sería iniciar un pequeño porcentaje de solicitudes primero en la réplica, que calentarían el caché. A grosso modo, tenemos la condición de que no debemos estar más de 10 segundos atrás respecto al maestro. Y esta condición no debe activarse de una sola vez, sino de forma gradual para algunos clientes.
Sí, aumentar el peso.
Es una buena idea. Pero primero necesitamos implementar esta desconexión. Primero debemos desconectarnos, y luego pensaremos en cómo reconectarnos. Es una gran característica para reiniciar de manera gradual.
En nginx hay una opción así slowly start en el clúster para el servidor. Y va incrementando la carga gradualmente.
Sí, es una excelente idea, lo probaremos cuando lleguemos a eso.
Fuente: habr.com
