

¡Aloha, gente! Me llamo Oleg Anastasiev, trabajo en Odnoklassniki en el equipo de la Plataforma. Además de mí, en Odnoklassniki hay un montón de hardware. Tenemos cuatro centros de datos, con alrededor de 500 racks y más de 8,000 servidores. En un momento determinado, entendimos que la implementación de un nuevo sistema de gestión nos permitiría cargar el hardware de manera más eficiente, facilitar la gestión de accesos, automatizar (re)distribuir los recursos computacionales, acelerar el lanzamiento de nuevos servicios y mejorar las respuestas ante fallos masivos.
¿Qué hemos logrado con esto?
Además de mí y un montón de hardware, hay personas que trabajan con este hardware: ingenieros que están directamente en los centros de datos; especialistas en redes que configuran la infraestructura de red; administradores, o SRE, que aseguran la resiliencia de la infraestructura; y equipos de desarrolladores, cada uno responsable de ciertas funciones del portal. El software que crean funciona más o menos así:
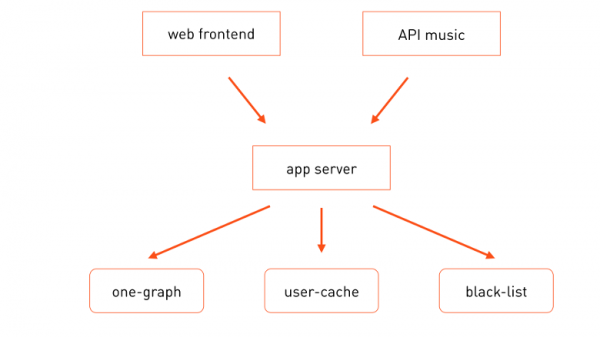
Las solicitudes de los usuarios llegan tanto a los frontales del portal principal , como a otros, por ejemplo a los frontales de la API de música. Para procesar la lógica del negocio, hacen llamadas a un servidor de aplicaciones, que al procesar la solicitud invoca los necesarios microservicios especializados: one-graph (grafo de relaciones sociales), user-cache (caché de perfiles de usuario), etc.
Cada uno de estos servicios está desplegado en múltiples máquinas, y cada uno de ellos tiene desarrolladores responsables de su funcionamiento, operación y evolución tecnológica. Todos estos servicios se ejecutan en servidores físicos, y hasta hace poco, ejecutábamos exactamente una tarea en un servidor, es decir, estaba especializado para una tarea específica.
¿Por qué era así? Este enfoque tenía varias ventajas:
- Facilita la gestión masiva. Supongamos que una tarea requiere ciertas bibliotecas, ciertas configuraciones. Entonces, el servidor se asigna a un grupo específico, se describe una política de cfengine para este grupo (o ya está descrita), y esta configuración se despliega de manera centralizada y automática en todos los servidores de este grupo.
- Simplifica el diagnóstico. Supongamos que está observando una carga elevada en la CPU y se da cuenta de que solo una tarea que se ejecuta en este procesador puede haber generado esa carga. La búsqueda del culpable termina muy rápido.
- Simplifica monitoreo. Si hay algo mal con el servidor, el monitor lo informa y sabe exactamente quién es el culpable.
A un servicio que consta de múltiples réplicas se le asignan varios servidores, uno para cada uno. Así, es muy fácil asignar recursos de cómputo al servicio: puede consumir tantos recursos como servidores tiene. “Fácil” aquí no significa que sea sencillo de usar, sino que la distribución de recursos se realiza manualmente.
Este enfoque también nos permitió hacer configuraciones de hardware especializadas para la tarea que se ejecuta en este servidor. Si la tarea implica almacenar grandes volúmenes de datos, usamos un servidor 4U con chasis para 38 discos. Si la tarea es puramente computacional, podemos comprar un servidor 1U más barato. Esto es eficiente desde el punto de vista de los recursos de cómputo. Además, este enfoque nos permite utilizar cuatro veces menos máquinas con una carga comparable a la de una red social que nos es amigable.
Tal eficiencia en el uso de recursos de cómputo debería garantizar también eficiencia económica, si partimos de la premisa de que lo más caro son los servidores. Durante mucho tiempo, el hardware fue lo más costoso, y hemos invertido muchos esfuerzos en reducir el costo del hardware, ideando algoritmos que aseguran la tolerancia a fallos para disminuir los requisitos de fiabilidad del equipo. Y hoy hemos llegado a un punto en el que el precio del servidor ya no es determinante. Si no consideramos las excentricidades más recientes, la configuración específica de los servidores en el rack no tiene importancia. Ahora tenemos otro problema: el costo del espacio que ocupa un servidor en el centro de datos, es decir, el espacio en el rack.
Al darnos cuenta de esto, decidimos calcular cuán eficientemente estamos utilizando los racks.
Tomamos el precio del servidor más potente que es económicamente viable, calculamos cuántos de esos servidores podemos colocar en los racks, cuántas tareas podríamos ejecutar en ellos basándonos en el antiguo modelo "un servidor = una tarea" y cuán eficientemente podrían aprovechar el equipo. Realizamos los cálculos y nos conmocionamos. Resulta que la eficiencia en el uso de los racks es de aproximadamente el 11%. La conclusión es clara: necesitamos mejorar la eficiencia en el uso de los centros de datos. A primera vista, la solución parece obvia: deberíamos ejecutar múltiples tareas en un solo servidor. Pero aquí comienzan las complicaciones.
La configuración masiva se complica drásticamente: ahora no es posible asignar al servidor un único grupo. De hecho, en un mismo servidor pueden ejecutarse varias tareas de diferentes equipos. Además, la configuración puede ser conflictiva para diferentes aplicaciones. La diagnosis también se complica: si ves un aumento en el consumo de procesadores o discos en el servidor, no sabes cuál de las tareas está causando problemas.
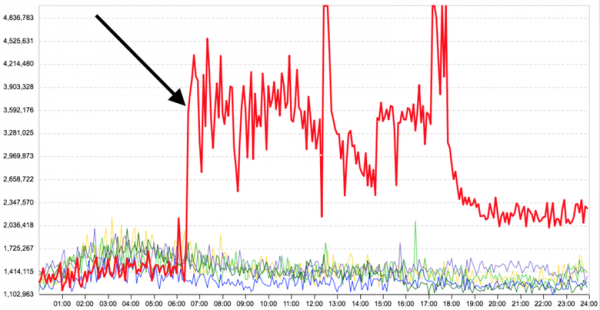
Pero lo más importante es que no hay aislamiento entre las tareas que se ejecutan en una misma máquina. Por ejemplo, el gráfico del tiempo de respuesta medio de una tarea de servidor antes y después de que se ejecutara en el mismo servidor otra aplicación de cálculo no relacionada, muestra que el tiempo de respuesta de la tarea principal aumentó significativamente.
Es evidente que necesitamos ejecutar las tareas ya sea en contenedores o en máquinas virtuales. Dado que prácticamente todas nuestras tareas se ejecutan bajo un solo sistema operativo (Linux) o están adaptadas para él, no necesitamos soportar múltiples sistemas operativos diferentes. Por lo tanto, la virtualización no es necesaria, ya que, debido a los costos adicionales, será menos eficiente que la contenedorización.
Como implementación de contenedores para ejecutar tareas directamente en servidores, Docker es un buen candidato: las imágenes de sistemas de archivos resuelven bien los problemas de configuraciones conflictivas. El hecho de que las imágenes se puedan componer de varias capas nos permite reducir significativamente la cantidad de datos necesarios para su despliegue en la infraestructura, al desplazar las partes comunes a capas base separadas. Así, las capas base (y más pesadas) se almacenarán en caché rápidamente en toda la infraestructura, y para enviar múltiples tipos de aplicaciones y versiones sólo será necesario transferir capas de menor volumen.
Además, el registro listo y la etiquetación de imágenes en Docker nos dan primitivos listos para la versionado y entrega de código a producción.
Docker, al igual que cualquier otra tecnología similar, nos proporciona cierto nivel de aislamiento de contenedores de forma nativa. Por ejemplo, el aislamiento de memoria: a cada contenedor se le asigna un límite de uso de memoria de la máquina, que no puede exceder. También es posible aislar contenedores en cuanto al uso de CPU. Sin embargo, para nosotros, el aislamiento estándar no era suficiente. Pero de esto hablaremos más adelante.
El lanzamiento directo de contenedores en servidores es sólo parte de los problemas. La otra parte está relacionada con la colocación de contenedores en los servidores. Es necesario entender qué contenedor se puede colocar en qué servidor. Esta no es una tarea tan simple, ya que los contenedores deben ser colocados en los servidores de manera lo más densa posible, sin reducir su velocidad de funcionamiento. Esta colocación puede ser complicada también desde el punto de vista de la tolerancia a fallos. A menudo queremos colocar réplicas del mismo servicio en diferentes racks o incluso en diferentes salas del centro de datos, para que al fallar un rack o sala no perdamos todas las réplicas del servicio.
Distribuir los contenedores manualmente no es una opción cuando tienes 8 mil servidores y de 8 a 16 mil contenedores.
Además, queríamos dar a los desarrolladores más autonomía en la distribución de recursos, para que pudieran ubicar sus servicios en producción sin ayuda de un administrador. Al mismo tiempo, queríamos mantener el control para que un servicio secundario no consumiera todos los recursos de nuestros centros de datos.
Es evidente que se necesita una capa de gestión que se encargue de esto de forma automática.
Aquí llegamos a una imagen simple y clara, que todos los arquitectos adoran: tres cuadrados.
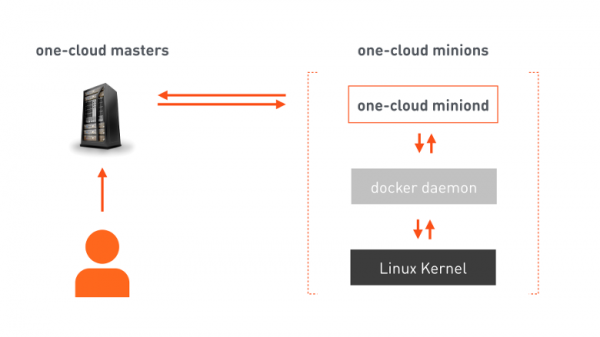
one-cloud masters — un clúster de alta disponibilidad encargado de la orquestación de la nube. El desarrollador envía al máster un manifiesto, que contiene toda la información necesaria para desplegar el servicio. El máster, sobre la base de esto, da órdenes a los minions seleccionados (máquinas destinadas a ejecutar contenedores). En los minions está nuestro agente, que recibe la orden, emite sus propias órdenes a Docker, y Docker configura el kernel de Linux para iniciar el contenedor correspondiente. Además de ejecutar órdenes, el agente informa continuamente al máster sobre los cambios en el estado tanto de la máquina-minion como de los contenedores que se ejecutan en ella.
Distribución de recursos
Ahora abordemos el problema de una distribución más compleja de recursos para múltiples minions.
El recurso computacional en one-cloud es:
- La potencia de CPU consumida por una tarea específica.
- El volumen de memoria disponible para la tarea.
- Tráfico de red. Cada uno de los minions tiene una interfaz de red específica con un ancho de banda limitado, por lo que no se pueden distribuir las tareas sin tener en cuenta el volumen de datos que transmiten por la red.
- Discos. Aparte de, evidentemente, el espacio para los datos de la tarea, también asignamos el tipo de disco: HDD o SSD. Los discos pueden atender una cantidad limitada de solicitudes por segundo — IOPS. Por lo tanto, para tareas que generan más IOPS de las que puede manejar un solo disco, también asignamos 'spindles' — es decir, dispositivos de disco que deben reservarse exclusivamente para la tarea.
Entonces, para algún servicio, digamos para user-cache, podemos anotar los recursos consumidos de la siguiente manera: 400 núcleos de CPU, 2.5 TB de memoria, 50 Gbps de tráfico en ambas direcciones, 6 TB de espacio en HDD, distribuido en 100 spindles. O en una forma más familiar para nosotros así:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Los recursos del servicio user-cache consumen solo una parte de todos los recursos disponibles en la infraestructura de producción. Por lo tanto, queremos asegurarnos de que, inesperadamente, debido a un error del operador o no, user-cache no consuma más recursos de los que se le han asignado. Es decir, debemos limitar los recursos. Pero ¿a qué podríamos vincular la cuota?
Regresemos a nuestro esquema simplificado de interacción de componentes y dibujemos con más detalles: así:
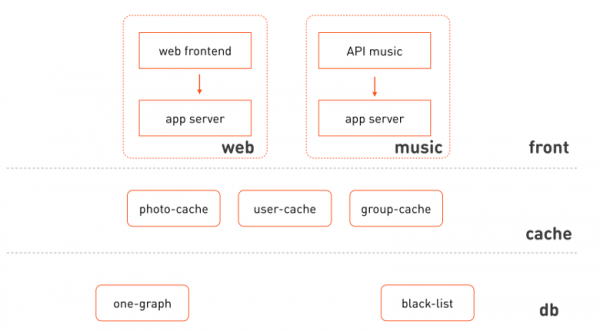
Lo que llama la atención:
- El frontend web y la música utilizan clústeres aislados del mismo servidor de aplicaciones.
- Podemos identificar las capas lógicas a las que pertenecen estos clústeres: frontends, cachés, capa de almacenamiento y gestión de datos.
- El frontend no es homogéneo, son diferentes subsistemas funcionales.
- Los cachés también se pueden distribuir entre el subsistema cuyos datos están almacenando.
Dibujemos de nuevo la imagen:
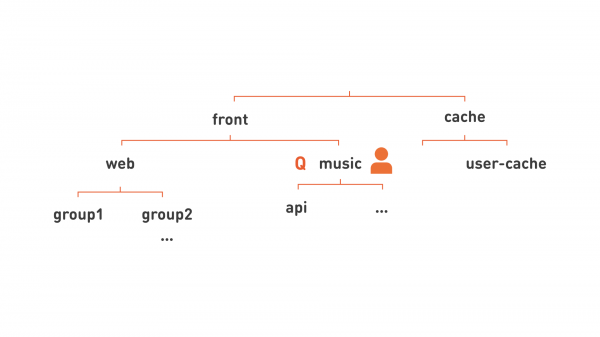
¡Vaya! ¡Vemos una jerarquía! Esto significa que se pueden distribuir los recursos en bloques más grandes: asignar un desarrollador responsable a un nodo de esta jerarquía, correspondiente a un subsistema funcional (como 'music' en la imagen), y vincular una cuota a este mismo nivel de jerarquía. Esta jerarquía también nos permite organizar más flexiblemente los servicios para facilitar la gestión. Por ejemplo, todos los web, ya que es un grupo muy grande de servidores, los subdividimos en varios grupos más pequeños, mostrados en la imagen como group1, group2.
Al eliminar líneas innecesarias, podemos escribir cada nodo de nuestra imagen de manera más plana: group1.web.front, api.music.front, user-cache.cache.
Así llegamos al concepto de 'cola jerárquica'. Esta tiene un nombre, como 'group1.web.front'. A ella se le asigna una cuota de recursos y derechos de usuario. A una persona de DevOps le daremos derechos para enviar servicios a la cola, y esa persona puede iniciar algo en la cola, mientras que a una persona de OpsDev se le otorgarán derechos de administración, y ahora puede gestionar la cola, asignar personas a la misma, dar derechos a esas personas, etc. Los servicios que se inicien en esta cola se ejecutarán dentro de la cuota de la cola. Si la cuota computacional de la cola no es suficiente para ejecutar todos los servicios simultáneamente, se ejecutarán de manera secuencial, formando así la cola propiamente dicha.
Veamos los servicios en más detalle. Un servicio tiene un nombre completo, que siempre incluye el nombre de la cola. Entonces, el servicio del frontend web tendrá el nombre ok-web.group1.web.front. Y el servicio del servidor de aplicaciones al que se dirige se llamará ok-app.group1.web.front. Cada servicio tiene un manifiesto que especifica toda la información necesaria para su implementación en máquinas concretas: cuánto recurso consume esta tarea, qué configuración requiere, cuántas réplicas deben existir y las propiedades para el manejo de fallos de este servicio. Después de implementar el servicio en las máquinas, surgen sus instancias, que también se nombran de manera única — como el número de la instancia y el nombre del servicio: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Esto es muy conveniente: al observar solo el nombre del contenedor en ejecución, podemos deducir mucho de inmediato.
Ahora nos familiarizaremos más con lo que estas instancias, en realidad, realizan: las tareas.
Clases de aislamiento de tareas
Todas las tareas en OK (y probablemente en todas partes) se pueden dividir en grupos:
- Tareas con baja latencia — prod. Para estas tareas y servicios, es muy importante la latencia, es decir, qué tan rápido se procesará cada una de las solicitudes por el sistema. Ejemplos de tareas: frontend web, cachés, servidores de aplicaciones, almacenes OLTP, etc.
- Tareas de cálculo — batch. Aquí, la velocidad de procesamiento de cada solicitud específica no es importante. Lo que importa es cuántos cálculos en total realizará esta tarea en un determinado (gran) período de tiempo (throughput). Esto incluirá cualquier tarea en MapReduce, Hadoop, aprendizaje automático, estadísticas.
- Tareas en segundo plano — idle. Para estas tareas, ni la latencia ni el throughput son muy importantes. Incluyen diversas pruebas, migraciones, recálculos, conversiones de datos de un formato a otro. Por un lado, son similares a las tareas de cálculo; por el otro, no nos preocupa mucho la rapidez con que se completan.
Veamos cómo estas tareas consumen recursos, por ejemplo, el CPU.
Tareas con baja latencia. El patrón de consumo de CPU de esta tarea será similar a este:
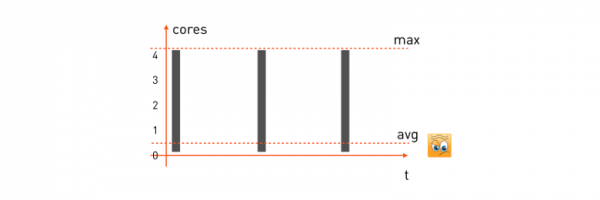
Recibe una solicitud del usuario, la tarea comienza a utilizar todos los núcleos disponibles del CPU, procesa, devuelve la respuesta, espera la siguiente solicitud y permanece en espera. Llega la siguiente solicitud — de nuevo usa todo lo que tiene, realiza el cálculo, espera la siguiente.
Para garantizar una latencia mínima para esta tarea, debemos tomar el máximo de recursos consumidos por ella y reservar la cantidad necesaria de núcleos en el minion (la máquina que llevará a cabo la tarea). Entonces, la fórmula de reserva para nuestra tarea será la siguiente:
alloc: cpu = 4 (max)Y si tenemos una máquina-minion con 16 núcleos, podemos colocar exactamente cuatro de estas tareas en ella. Cabe destacar que el consumo promedio del procesador para estas tareas suele ser muy bajo, lo cual es evidente, ya que gran parte del tiempo la tarea se encuentra a la espera de una solicitud y no hace nada.
Tareas de cálculo. Su patrón será algo diferente:
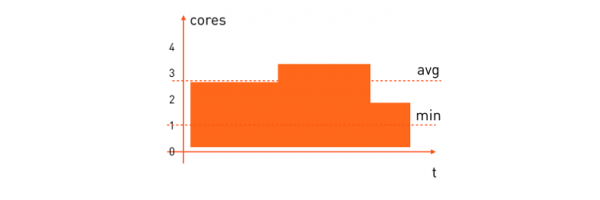
El consumo promedio de recursos del procesador para estas tareas es bastante alto. A menudo queremos que la tarea de cálculo se realice en un tiempo determinado, por lo que necesitamos reservar el mínimo número de procesadores que necesite para que todo el cálculo termine en un tiempo aceptable. Su fórmula de reserva se verá así:
alloc: cpu = [1,*)«Coloca, por favor, en el minion donde haya al menos un núcleo libre, y luego todo lo que haya — se lo llevará todo».
Aquí, la eficiencia del uso ya es significativamente mejor que en tareas con un corto retraso. Pero la ganancia será mucho mayor si combinamos ambos tipos de tareas en una sola máquina-minion y distribuimos sus recursos sobre la marcha. Cuando una tarea con un corto retraso requiere el procesador, lo obtiene inmediatamente, y cuando los recursos ya no son necesarios, se transfieren a la tarea de cálculo, es decir, así:
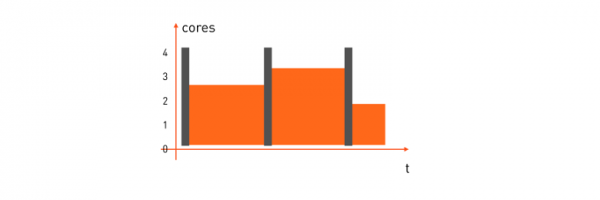
Pero, ¿cómo se hace esto?
Para empezar, analicemos prod y su alloc: cpu = 4. Necesitamos reservar cuatro núcleos. En Docker run, esto se puede hacer de dos maneras:
- Con la opción
--cpuset=1-4, es decir, asignar a la tarea cuatro núcleos específicos en la máquina. - Usar
--cpuquota=400_000 --cpuperiod=100_000, asignar una cuota de tiempo de CPU, es decir, indicar que cada 100 ms de tiempo real la tarea consume no más de 400 ms de tiempo de CPU. Se obtienen los mismos cuatro núcleos.
Pero, ¿cuál de estos métodos es el adecuado?
La cpuset parece bastante atractiva. La tarea tiene cuatro núcleos dedicados, lo que significa que las cachés del procesador funcionarán de manera óptima. Sin embargo, esto tiene un lado negativo: tendríamos que asumir la tarea de distribuir los cálculos entre núcleos no utilizados de la máquina en lugar de hacerlo el sistema operativo, lo cual es una tarea bastante no trivial, especialmente si intentamos ejecutar trabajos en batch en dicha máquina. Las pruebas mostraron que aquí es mejor la opción de cuota: así, el sistema operativo tiene más libertad para elegir el núcleo en el que ejecutar la tarea en el momento actual y el tiempo de CPU se distribuye de manera más eficiente.
Vamos a ver cómo crear reservas en Docker con la mínima cantidad de núcleos. La cuota para trabajos en batch ya no es aplicable, porque no es necesario limitar el máximo, solo se debe garantizar un mínimo. Y aquí encaja bien la opción docker run --cpushares.
Acuerdamos que si un trabajo en batch requiere garantía de al menos un núcleo, entonces indicamos --cpushares=1024, y si el mínimo son dos núcleos, entonces indicamos --cpushares=2048. Las shares de CPU no intervienen en la distribución del tiempo de CPU siempre que haya suficiente. Así, si el proceso principal no utiliza en este momento sus cuatro núcleos — nada limita a los trabajos en batch, y pueden usar tiempo de CPU adicional. Pero en una situación de escasez de procesador, si el proceso principal ha consumido todos sus cuatro núcleos y ha alcanzado la cuota — el tiempo de CPU restante se dividirá proporcionalmente a las cpushares, es decir, en una situación de tres núcleos libres, uno recibirá la tarea con 1024 cpushares, y los otros dos recibirán la tarea con 2048 cpushares.
Pero el uso de cuota y shares no es suficiente. Necesitamos asegurarnos de que las tareas de baja latencia tengan prioridad sobre las tareas en batch en la distribución del tiempo de CPU. Sin tal priorización, una tarea en batch consumirá todo el tiempo de CPU en el momento en que lo necesite el proceso principal. En Docker run no hay opciones para priorizar contenedores, pero las políticas del planificador de CPU en Linux vienen al rescate. Puedes leer más sobre ellas , y en este artículo las abordaremos brevemente:
- SCHED_OTHER
Por defecto, todos los procesos de usuario normales en una máquina Linux reciben esto. - SCHED_BATCH
Destinada a procesos que consumen muchos recursos. Al asignar una tarea al procesador, se introduce una llamada penalización por activación: es menos probable que una tarea obtenga recursos del procesador si en ese momento está siendo utilizada por una tarea con SCHED_OTHER. - SCHED_IDLE
Proceso en segundo plano con una prioridad muy baja, incluso más baja que nice -19. Utilizamos nuestra biblioteca de código abierto. , para aplicar la política necesaria al iniciar el contenedor mediante la llamada
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Pero incluso si no programas en Java, puedes hacer lo mismo con el comando chrt:
chrt -i 0 $pidResumimos todos nuestros niveles de aislamiento en una tabla para mayor claridad:
Clase de aislamiento
Ejemplo de alloc
Opciones de Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Si realizas chrt desde dentro del contenedor, puede ser necesario el capability sys_nice, ya que por defecto Docker retira este capability al iniciar el contenedor.
Pero las tareas consumen no solo el procesador, sino también el tráfico, lo que afecta la latencia de la tarea de red incluso más que la distribución incorrecta de recursos del procesador. Por lo tanto, naturalmente queremos obtener una imagen exactamente igual para el tráfico. Es decir, cuando una tarea prod envía paquetes a la red, limitamos la velocidad máxima (fórmula alloc: lan=[*,500mbps) ), con la que prod puede hacerlo. Y para batch garantizamos solo un ancho de banda mínimo, pero no limitamos el máximo (fórmula alloc: lan=[10Mbps,*) ) En este caso, el tráfico prod debe tener prioridad sobre las tareas batch.
Aquí Docker no tiene primitivas que podamos usar. Pero nos ayuda . Pudimos lograr el resultado deseado con la disciplina . Con ella separamos dos clases de tráfico: prod de alta prioridad y batch/idle de baja prioridad. Como resultado, la configuración para el tráfico saliente queda así:
aquí 1:0 — «qdisc raíz» de la disciplina hsfc; 1:1 — clase secundaria hsfc con un límite de ancho de banda total de 8 Gbit/s, bajo el cual se incluyen las clases secundarias de todos los contenedores; 1:2 — clase secundaria hsfc común para todas las tareas batch e idle con un límite «dinámico», del que hablaremos más adelante. Las demás clases secundarias hsfc son clases dedicadas para contenedores prod en funcionamiento con límites que corresponden a sus manifiestos, es decir, 450 y 400 Mbit/s. A cada clase hsfc se le asigna una cola qdisc fq o fq_codel, dependiendo de la versión del núcleo de Linux, para evitar la pérdida de paquetes durante picos de tráfico.
Normalmente, las disciplinas tc se utilizan solo para priorizar el tráfico saliente. Pero queremos priorizar también el tráfico entrante, ya que alguna tarea batch puede fácilmente consumir todo el ancho de banda entrante cuando recibe, por ejemplo, un gran paquete de datos para map&reduce. Para ello utilizamos el módulo , que crea una interfaz virtual ifbX para cada interfaz de red y redirige el tráfico entrante desde la interfaz al tráfico saliente en ifbX. A partir de ahí, todas las mismas disciplinas se aplican a ifbX para controlar el tráfico saliente, para el cual la configuración hsfc será muy similar:
Durante los experimentos, descubrimos que hsfc da mejores resultados cuando la clase 1:2 de tráfico batch/idle no prioritario se limita en las máquinas minion a no más que a un cierto ancho de banda libre. De lo contrario, el tráfico no prioritario afecta demasiado la latencia de las tareas prod. El actual valor del ancho de banda libre es determinado cada segundo por miniond, midiendo el consumo promedio de tráfico de todas las tareas prod en ese minion  y restándolo del ancho de banda de la interfaz de red
 con un pequeño margen, es decir,

Los anchos de banda se determinan de manera independiente para el tráfico entrante y saliente. Y de acuerdo con los nuevos valores, miniond reconfigura el límite de la clase no prioritaria 1:2.
De este modo, hemos implementado las tres clases de aislamiento: prod, batch e idle. Estas clases influyen significativamente en las características de ejecución de las tareas. Por lo tanto, decidimos colocar esta característica en la parte superior de la jerarquía, para que al mirar el nombre de la cola jerárquica, quede claro de inmediato con qué estamos tratando:
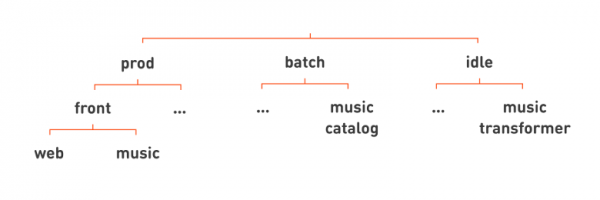
Todos nuestros conocidos web y música los frentes se colocan entonces en la jerarquía bajo prod. Por ejemplo, busquemos colocar el servicio bajo batch catálogo de música, que periódicamente compila un catálogo de pistas de un conjunto de archivos mp3 subidos en «Odnoklassniki». Un ejemplo de servicio inactivo podría ser transformador de música, que normaliza el nivel de volumen de la música.
De nuevo, al eliminar líneas innecesarias, podemos escribir los nombres de nuestros servicios de manera más plana, añadiendo la clase de aislamiento de la tarea al final del nombre completo del servicio: web.front.prod, catalog.music.batch, transformer.music.idle.
Y ahora, al mirar el nombre del servicio, entendemos no solo qué función desempeña, sino también su clase de aislamiento, lo que implica su criticidad, etc.
Todo es maravilloso, pero hay una amarga verdad. No es posible aislar completamente las tareas que funcionan en una misma máquina.
Lo que hemos logrado: si el batch consume intensamente solo recursos de la CPU, el planificador de CPU de Linux integrado cumple muy bien con su tarea, y la influencia en la tarea prod es prácticamente nula. Pero si esta tarea batch comienza a trabajar activamente con la memoria, entonces la influencia mutua ya se manifiesta. Esto ocurre porque las cachés de procesador de la tarea prod se «vacían» — como resultado, aumentan los fallos en la caché, y el procesador procesa la tarea prod más lentamente. Tal tarea batch puede aumentar en un 10 % la latencia de nuestro típico contenedor prod.
Aislar el tráfico es aún más difícil debido a que las tarjetas de red modernas tienen una cola interna de paquetes. Si un paquete de la tarea batch entra primero, significa que será el primero en ser enviado por el cable, y no hay nada que se pueda hacer al respecto.
Además, hasta ahora solo hemos logrado resolver el problema de priorización del tráfico TCP: el enfoque con hsfc no funciona para UDP. E incluso en el caso del tráfico TCP, si la tarea batch genera mucho tráfico, esto también provoca un aumento de aproximadamente el 10 % en la latencia de la tarea prod.
Tolerancia a fallos
Uno de los objetivos al desarrollar one-cloud fue mejorar la resistencia a fallos de Odnoklassniki. Por lo tanto, a continuación me gustaría analizar más a fondo los posibles escenarios de fallos y emergencias. Comencemos con un escenario simple: la falla de un contenedor.
Un contenedor por sí mismo puede fallar de varias maneras. Esto puede ser un experimento, un error o un problema en el manifiesto, que hace que la tarea de producción comience a consumir más recursos de los que se especifican en el manifiesto. Tuvimos un caso en el que un desarrollador implementó un algoritmo complicado, lo modificó varias veces, se complicó a sí mismo y se confundió tanto que, al final, la tarea quedó atrapada en un bucle bastante no trivial. Y dado que la tarea de producción tiene más prioridad que todas las demás en los mismos minions, comenzó a consumir todos los recursos de CPU disponibles. En esta situación, la aislamiento fue salvador, o más bien, la cuota de tiempo de CPU. Si a una tarea se le asigna una cuota, no consumirá más. Por lo tanto, las tareas por lotes y otras tareas de producción que trabajaban en la misma máquina no notaron nada.
El segundo problema posible es la caída del contenedor. Y aquí nos ayudan las políticas de reinicio, que todos conocen, y Docker lo maneja muy bien. Prácticamente todas las tareas de producción tienen una política de reinicio siempre. A veces utilizamos on_failure para tareas por lotes o para depurar contenedores de producción.
¿Y qué se puede hacer si un minion entero no está disponible?
Obviamente, lanzar el contenedor en otra máquina. Lo más interesante aquí es qué pasa con la dirección IP (las direcciones) asignadas al contenedor.
Podemos asignar a los contenedores las mismas direcciones IP que tienen las máquinas-minions donde se ejecutan estos contenedores. Entonces, al lanzar un contenedor en otra máquina, su dirección IP cambia, y todos los clientes deben entender que el contenedor se ha trasladado, ahora tienen que ir a otra dirección, lo que requiere un servicio adicional de Descubrimiento de Servicios.
El Descubrimiento de Servicios es conveniente. Hay muchas soluciones en el mercado con diferentes grados de tolerancia a fallos para organizar un registro de servicios. A menudo, en tales soluciones se implementa la lógica del balanceador de carga, el almacenamiento de configuración adicional en forma de almacenamiento KV, etc.
Sin embargo, nos gustaría prescindir de la necesidad de implementar un registro separado, ya que esto significaría introducir un sistema crítico que es utilizado por todos los servicios en producción. Esto representa un punto de fallo potencial, y se debe elegir o desarrollar una solución muy resistente a fallos, lo cual, evidentemente, es muy complicado, largo y costoso.
Y otro gran inconveniente: para que nuestra antigua infraestructura funcionara con la nueva, tendríamos que reescribir absolutamente todas las tareas para utilizar algún sistema de Service Discovery. Hay MUCHO trabajo, y en algunos casos es casi imposible, especialmente cuando se trata de dispositivos de bajo nivel que operan a nivel del núcleo del sistema operativo o directamente con el hardware. La implementación de esta funcionalidad utilizando patrones establecidos de soluciones, como por ejemplo significaría a veces una carga adicional, en ocasiones — una complicación de la explotación y escenarios adicionales de fallos. No queríamos complicar las cosas, por lo que decidimos que el uso de Service Discovery fuera opcional.
En one-cloud, la IP sigue al contenedor, es decir, cada instancia de la tarea tiene su propia dirección IP. Esta dirección es "estática": se asigna a cada instancia en el momento del primer envío del servicio a la nube. Si durante la vida del servicio tuvo diversas instancias, al final se le asignarán tantas direcciones IP como máximo haya habido instancias.
Posteriormente, estas direcciones no cambian: se asignan una vez y continúan existiendo durante toda la vida del servicio en producción. Las direcciones IP siguen a los contenedores por la red. Si un contenedor se mueve a otro minión, la dirección también se trasladará con él.
De este modo, la correspondencia entre el nombre del servicio y su lista de direcciones IP cambia con muy poca frecuencia. Si miramos nuevamente los nombres de las instancias del servicio que mencionamos al inicio del artículo (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), notamos que se asemejan a FQDN, que se utilizan en DNS. Así es, para mostrar los nombres de las instancias de servicios en sus direcciones IP utilizamos el protocolo DNS. De hecho, este DNS devuelve todas las direcciones IP reservadas de todos los contenedores, tanto en funcionamiento como detenidos (supongamos que se utilizan tres réplicas y tenemos cinco direcciones reservadas: las cinco serán devueltas). Los clientes, al recibir esta información, intentarán establecer conexión con las cinco réplicas, y así determinarán cuáles están operativas. Esta forma de determinar la disponibilidad es considerablemente más confiable, ya que no involucra ni DNS ni Service Discovery, lo que significa que no hay problemas difíciles de resolver relacionados con la actualización de información y la resistencia a fallos de estos sistemas. Más aún, en servicios críticos de los cuales depende el funcionamiento de todo el portal, podemos no usar DNS en absoluto, y simplemente introducir las direcciones IP en la configuración.
La implementación de esta transferencia de IP entre contenedores puede no ser trivial — y nos detendremos en cómo funciona con el siguiente ejemplo:
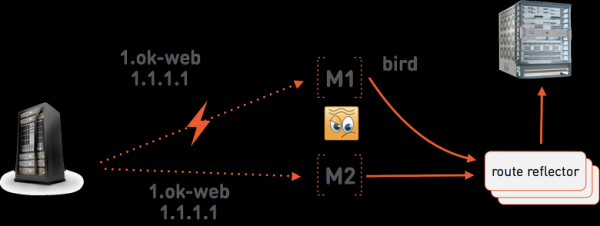
Supongamos que el maestro de one-cloud da la orden al minion M1 de iniciar 1.ok-web.group1.web.front.prod con la dirección 1.1.1.1. En el minion funciona , que anuncia esta dirección a servidores especiales . Estos últimos tienen una sesión BGP con el equipo de red, al que se transmite la ruta de la dirección 1.1.1.1 hacia M1. M1, a su vez, enruta los paquetes dentro del contenedor ya utilizando herramientas de Linux. Hay tres servidores route reflector, ya que esta es una parte muy crítica de la infraestructura de one-cloud — sin ellos, la red de one-cloud no funcionará. Los ubicamos en diferentes racks, preferiblemente ubicados en diferentes salas del centro de datos, para reducir la probabilidad de una falla simultánea de los tres.
Ahora supongamos que la conexión entre el maestro de one-cloud y el minion M1 se ha perdido. El maestro de one-cloud ahora actuará bajo la suposición de que M1 ha fallado completamente. Es decir, dará la orden al minion M2 de iniciar web.group1.web.front.prod con la misma dirección 1.1.1.1. Ahora tenemos dos rutas en conflicto en la red para 1.1.1.1: en M1 y en M2. Para resolver tales conflictos, utilizamos el Multi Exit Discriminator, que se especifica en el anuncio de BGP. Este es un número que indica el peso de la ruta anunciada. Se seleccionará la ruta con el valor más bajo de MED entre las en conflicto. El maestro one-cloud soporta MED como parte integral de las direcciones IP de los contenedores. La primera vez, la dirección se emite con un MED bastante alto = 1,000,000. En una situación de falla de este tipo del contenedor, el maestro reduce el MED, y M2 recibirá la orden de anunciar la dirección 1.1.1.1 con MED = 999,999. El instance que trabaja en M1 quedará sin conexión y su futuro no nos interesa hasta que se restaure la conexión con el maestro, momento en el cual se detendrá como un viejo duplicado.
Fallas
Todos los sistemas de gestión de centros de datos manejan adecuadamente las pequeñas fallas. La caída de un contenedor es algo normal casi en cualquier lugar.
Veamos cómo manejamos una falla, por ejemplo, un corte de energía en una o más salas del centro de datos.
¿Qué significa una falla para el sistema de gestión del centro de datos? En primer lugar, es un fallo masivo y simultáneo de muchas máquinas, y el sistema de gestión necesita migrar muchos contenedores al mismo tiempo. Pero si la falla es muy extensa, puede suceder que no todas las tareas puedan ser redistribuidas a otros minions, porque la capacidad de recursos del centro de datos cae por debajo del 100% de carga.
A menudo, las fallas vienen acompañadas de la caída de la capa de gestión. Esto puede ocurrir debido a la falla de su hardware, pero más comúnmente ocurre porque las fallas no se prueban, y la capa de gestión colapsa bajo la carga aumentada.
¿Qué se puede hacer con todo esto?
Las migraciones masivas significan que en la infraestructura surgen una gran cantidad de acciones, migraciones y despliegues. Cada una de las migraciones puede llevar un tiempo para la entrega y descompresión de las imágenes de los contenedores a los minions, el inicio y la inicialización de contenedores, etc. Por lo tanto, es preferible que las tareas más importantes se inicien antes que las menos importantes.
Volvamos a revisar la jerarquía de servicios que conocemos y intentemos decidir qué tareas queremos iniciar primero.
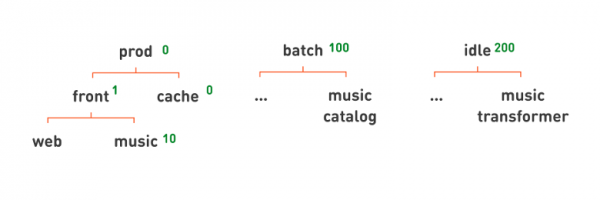
Por supuesto, estos son los procesos que participan directamente en el manejo de las solicitudes de los usuarios, es decir, prod. Lo indicamos utilizando la prioridad de colocación — un número que puede ser asignado a la cola. Si una cola tiene una prioridad más alta, sus servicios se colocan en primer lugar.
En prod, asignamos prioridades más altas, 0; en batch — un poco más bajas, 100; en idle — aún más bajas, 200. Las prioridades se aplican jerárquicamente. Todas las tareas más bajas en la jerarquía tendrán la prioridad correspondiente. Si queremos que dentro de prod las cachés se ejecuten antes que los frontales, entonces asignamos prioridades a cache = 0 y a front de subtareas = 1. Si, por ejemplo, queremos que entre los frontales se ejecute primero el portal principal y luego el frontal musical, al último podemos asignar una prioridad más baja — 10.
El siguiente problema es la falta de recursos. Así que hemos perdido un gran número de equipos, salas enteras del centro de datos, y hemos lanzado tantos servicios que ahora no hay suficientes recursos para todos. Necesitamos decidir cuáles tareas sacrificar para que funcionen los servicios críticos principales.
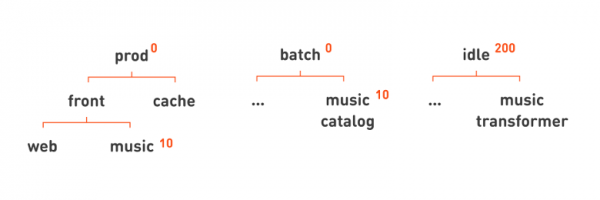
A diferencia de la prioridad de colocación, no podemos sacrificar todas las tareas batch sin pensar, algunas de ellas son importantes para el funcionamiento del portal. Por lo tanto, hemos destacado por separado la prioridad de desalojo de las tareas. Al colocar una tarea con una prioridad más alta puede desalojar, es decir, detener la tarea con una prioridad más baja, si no hay más minions libres. En este caso, es probable que la tarea con baja prioridad permanezca sin asignar, es decir, no habrá un minion adecuado con suficientes recursos libres.
En nuestra jerarquía, es muy fácil establecer una prioridad de desalojo donde las tareas prod y batch desalojen o detengan las tareas idle, pero no entre ellas, asignando a idle una prioridad de 200. Así como en el caso de la prioridad de colocación, podemos utilizar nuestra jerarquía para describir reglas más complejas. Por ejemplo, indicaremos que sacrificamos la función musical si nos faltan recursos para el portal web principal, estableciendo para los nodos correspondientes una prioridad más baja: 10.
Fallas del DC en su totalidad
¿Por qué puede fallar todo el centro de datos? Fuerza de la naturaleza. Hubo una buena publicación sobre cómo Se puede considerar que la causa de los problemas son los indigentes que alguna vez incendiaron la fibra óptica en un pozo, lo que hizo que el centro de datos perdiera completamente la conexión con otras ubicaciones. La causa del fallo también puede ser el factor humano: un operador puede dar una orden que cause la caída de todo el centro de datos. Esto puede ocurrir debido a un gran error. En resumen, los centros de datos caen; no es raro. Esto nos ocurre una vez cada pocos meses.
Y esto es lo que hacemos para que nadie #NoVivasNoPoste en Twitter.
La primera estrategia es la aislamiento. Cada instancia de one-cloud está aislada y solo puede gestionar máquinas de un único centro de datos. Es decir, la pérdida de la nube debido a errores o a una orden incorrecta de un operador solo afecta a un centro de datos. Estamos preparados para ello: existe una política de reserva, en la cual las réplicas de aplicaciones y datos se distribuyen en todos los centros de datos. Utilizamos bases de datos tolerantes a fallos y realizamos pruebas de fallos periódicamente.
Dado que hoy tenemos cuatro centros de datos, esto significa que hay cuatro instancias separadas y completamente aisladas de one-cloud.
Este enfoque no solo protege contra fallos físicos, sino que también puede proteger contra errores del operador.
¿Qué más se puede hacer respecto al factor humano? Cuando un operador da a la nube un comando extraño o potencialmente peligroso, puede requerírsele inesperadamente que resuelva una pequeña tarea para comprobar cuán bien ha reflexionado. Por ejemplo, si se trata de una detención masiva de muchas réplicas o simplemente un comando extraño — reducción del número de réplicas o cambio en el nombre de la imagen, y no solo del número de versión en un nuevo manifiesto.
Resultados
Características distintivas de one-cloud:
- Un esquema jerárquico y visual para nombrar servicios y contenedores, que permite conocer rápidamente de qué se trata la tarea, a qué se relaciona y cómo funciona, y quién es el responsable de ella.
- Aplicamos nuestra técnica de combinación de tareas prod- y batch-en minions para aumentar la eficiencia del uso compartido de máquinas. En lugar de cpuset, utilizamos cuotas de CPU, shares, políticas del planificador de CPU y Linux QoS.
- No conseguimos aislar completamente los contenedores que operan en una sola máquina, pero su influencia mutua se mantiene dentro del 20%.
- La organización de servicios en una jerarquía ayuda en la eliminación automática de emergencias mediante prioridades de colocación y desalojo..
FAQ
Por qué no optamos por una solución ya preparada.
- Las diferentes clases de aislamiento de tareas requieren lógicas distintas al distribuirse en los nodos. Mientras que las tareas de producción pueden asignarse simplemente mediante la reserva de recursos, las tareas en lote e inactivas necesitan distribuirse siguiendo la utilización real de los recursos en los nodos.
- La necesidad de tener en cuenta recursos utilizados por las tareas tales como:
- ancho de banda de red;
- tipos y "spindles" de discos.
- La necesidad de especificar prioridades de servicio al manejar emergencias, derechos y cuotas de equipo sobre recursos, lo que se resuelve mediante colas jerárquicas en one-cloud.
- La necesidad de contar con nombres humanos para los contenedores, para reducir el tiempo de respuesta ante emergencias e incidentes.
- La imposibilidad de implementar simultáneamente Service Discovery en todos lados; la necesidad de coexistir durante mucho tiempo con tareas alojadas en servidores físicos, lo que se resuelve mediante direcciones IP "estáticas" que siguen a los contenedores, y, como consecuencia, la necesidad de una integración única con una gran infraestructura de red.
Todas estas funciones requerirían modificaciones significativas de las soluciones existentes para ajustarlas, y, tras evaluar la cantidad de trabajo, nos dimos cuenta de que podríamos desarrollar nuestra propia solución con aproximadamente el mismo esfuerzo. Pero nuestra solución será mucho más fácil de operar y desarrollar, ya que carece de abstracciones innecesarias que sostienen funcionalidades no deseadas.
A aquellos que leen las últimas líneas, ¡gracias por su paciencia y atención!
Fuente: habr.com
