

La virtualización de OpenShift (proyecto upstream – Kubernetes: KubeVirt, ver. y ), anteriormente conocida como Virtualización nativa de Contenedores, fue presentada como una funcionalidad de la plataforma OpenShift, destinada a desplegar y gestionar máquinas virtuales (VM) como entidades básicas de Kubernetes. Este tipo de tarea es técnicamente compleja, debido a las diferencias fundamentales en las tecnologías. Para lograr este objetivo, se utilizaron tecnologías familiares basadas en Red Hat Enterprise Linux y KVM, que llevan con nosotros varios años y han demostrado su eficacia.
En este artículo examinaremos los aspectos técnicos de la virtualización de OpenShift, que hacen posible la coexistencia de VM y contenedores dentro de una única plataforma que los gestiona como un todo.
Tareas computacionales
Los contenedores utilizan mecanismos del núcleo de Linux, como namespaces y cgroups, para aislar procesos y gestionar recursos. Normalmente, los procesos se entienden como aplicaciones de Python, Java o archivos ejecutables, pero en realidad pueden ser cualquier tipo de procesos, así como bash, Emacs o vim.
¿Y qué es una máquina virtual? Desde el punto de vista del hipervisor, también es un proceso. Pero no un proceso de aplicación, sino un proceso KVM encargado de ejecutar una VM específica.
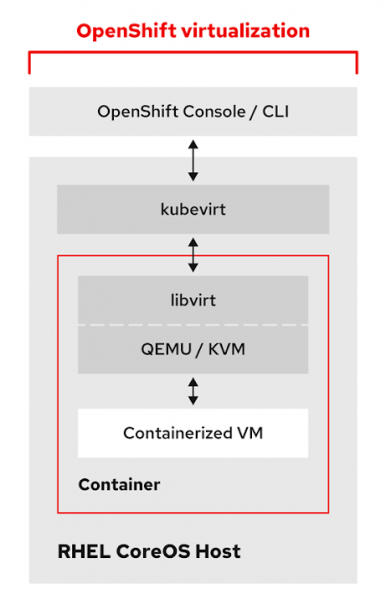
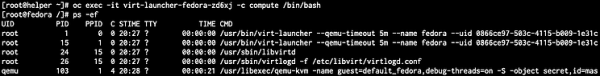
La imagen de contenedor contiene todas las herramientas, bibliotecas y archivos necesarios para la máquina virtual KVM. Si inspeccionamos el pod de una VM en funcionamiento, veremos allí ayudantes y procesos de qemu-kvm. Además, tenemos acceso a herramientas KVM para gestionar máquinas virtuales, como qemu-img, qemu-nbd y virsh.
Dado que una máquina virtual es un pod, hereda automáticamente toda la funcionalidad de un pod en Kubernetes. A los VMs-pod se les aplican las mismas políticas y criterios de programación, como taints, tolerations, affinity y anti-affinity. También obtienes beneficios como alta disponibilidad, entre otros. Sin embargo, hay una diferencia importante: los pods normales no migran de un host a otro en el sentido que conocemos. Si un nodo se apaga, el pod en él se interrumpe y se reasigna a otro nodo en el clúster. En el caso de una máquina virtual, esperamos ver una migración en vivo.
Para abordar esta brecha, se creó una definición de recurso personalizado (CDR) que describe el mecanismo de migración en vivo, encargado de la inicialización, monitoreo y gestión de migraciones en vivo de VMs entre nodos de trabajo.
apiVersion: kubevirt.io/v1alpha3
kind: VirtualMachineInstanceMigration
metadata:
  name: migration-job
spec:
  vmiName: fedora
Al desactivar un nodo, se crean automáticamente tareas de migración para aquellas máquinas virtuales que tienen Live Migration como estrategia de evacuación. De esta manera, se puede controlar el comportamiento de las máquinas virtuales al moverse entre los nodos del clúster. Se puede configurar Live Migration y gestionar las VM como con cualquier otro pod.
Red
Cualquier sistema Kubernetes proporciona comunicación entre nodos y pods a través de redes SDN programáticas. OpenShift no es la excepción y, desde la versión 3, utiliza por defecto OpenShiftSDN para esto. Además, en OpenShift 4 se introdujo una nueva función llamada Multus, que permite hacer disponibles múltiples redes y conectar pods a ellas simultáneamente.
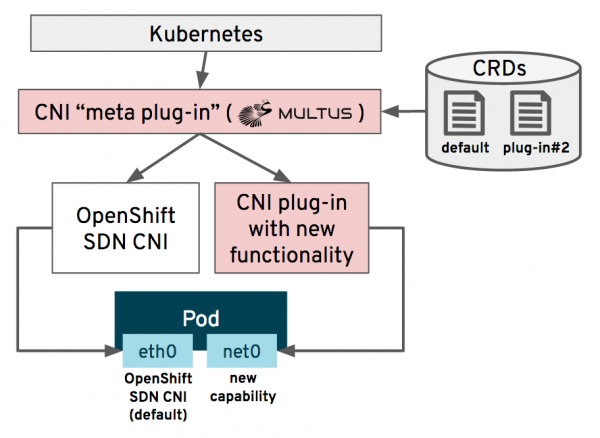
Con Multus, el administrador puede definir redes CNI adicionales que luego serán implementadas y configuradas en el clúster mediante un operador especializado llamado Cluster Network Operator. Después de esto, los pods se conectan a una o varias de estas redes, generalmente a la OpenShiftSDN estándar y a otra interfaz adicional. Se pueden utilizar dispositivos SR-IOV, puentes Linux estándar, dispositivos MACVLAN e IPVLAN, si es necesario para su VM. A continuación se muestra cómo configurar Multus CNI para una red bridge en la interfaz eth1:
apiVersion: operator.openshift.io/v1
kind: Network
metadata:
  name: cluster
spec:
  additionalNetworks:
  - name: multus1
rawCNIConfig: '{ "cniVersion": "0.3.1", "type": "bridge", "master": "eth1", "ipam":
   { "type": "static", "addresses": [ { "address": "191.168.1.1/24" } ] } }'
   type: Raw
En el contexto de la virtualización de OpenShift, esto significa que una VM se puede conectar directamente a una red externa, evitando SDN. Esto es importante para las máquinas virtuales que se han trasladado a OpenShift desde Red Hat Virtualization o VMware vSphere, ya que con acceso al segundo nivel del OSI no habrá cambio de configuración de red. También significa que una VM puede tener una dirección de red que evite SDN. Así, podemos utilizar eficazmente adaptadores de red especializados o conectarnos directamente a un almacenamiento de red...
Puede obtener más información sobre cómo crear y conectar máquinas virtuales de OpenShift virtualization a la red. . Además, , desplegado como parte de OpenShift virtualization, ofrece otra forma bien conocida de crear y gestionar configuraciones de red en nodos físicos utilizados bajo hipervisores.
Almacenamiento
La conexión y gestión de discos de máquinas virtuales en el marco de la virtualización de OpenShift se lleva a cabo utilizando conceptos de Kubernetes como StorageClasses, PersistentVolumeClaims (PVC) y PersistentVolume (PV), así como protocolos de almacenamiento estándar en el entorno de Kubernetes. De esta manera, los administradores de Kubernetes y los equipos responsables de las aplicaciones cuentan con un mecanismo de gestión unificado y familiar tanto para contenedores como para máquinas virtuales. Para muchos administradores de entornos de virtualización, este concepto puede parecer familiar, ya que utiliza el mismo principio de separación de archivos de configuración de VM y discos que se aplica en OpenStack y en muchas otras plataformas en la nube.
Sin embargo, no se puede crear un nuevo disco para cada VM cada vez, ya que al migrar desde un hipervisor a OpenShift, es necesario conservar los datos. Incluso cuando desplegamos una nueva VM, siempre es más rápido hacerlo desde una plantilla que crearla desde cero. Por lo tanto, necesitamos la funcionalidad de importar discos existentes.
Para simplificar esta tarea, OpenShift virtualization implementa el proyecto Containerized Data Importer (CDI), que reduce la importación de imágenes de disco desde varias fuentes a la creación de un registro en PVC.
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: "fedora-disk0"
  labels:
    app: containerized-data-importer
  annotations:
    cdi.kubevirt.io/storage.import.endpoint: "http://10.0.0.1/images/Fedora-Cloud-Base-31-1.9.x86_64.qcow2"
spec:
  storageClassName: ocs-gold
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi
Precisamente este registro activa CDI, iniciando la secuencia de acciones que se muestra en la figura a continuación:
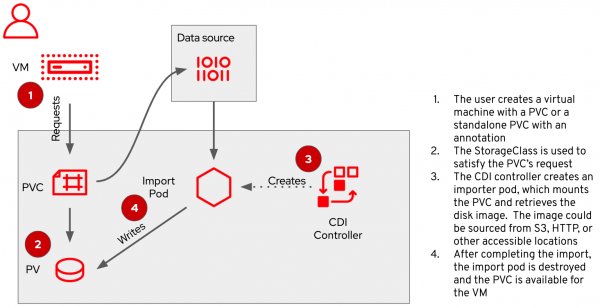
Una vez que CDI haya terminado, el PVC contendrá un disco de máquina virtual listo para usar y adaptado al formato estándar de OpenShift…
Al trabajar con OpenShift virtualization, también será útil OpenShift Container Storage (OCS), la solución de Red Hat basada en el sistema de archivos Ceph, que implementa la funcionalidad de almacenamiento persistente para contenedores. Además de los métodos de acceso estándar a PVC – RWO (bloques) y RWX (archivos) – OCS proporciona RWX para dispositivos de bloque raw, lo cual es muy útil para organizar el acceso de bloques compartido para aplicaciones con altas demandas de rendimiento. Además, OCS respalda el nuevo estándar de solicitud de grupo de objetos Object Bucket Claim, que permite a las aplicaciones utilizar directamente el almacenamiento de objetos.
Máquinas virtuales en contenedores
Si te interesa comprobar cómo funciona, ten en cuenta que la virtualización de OpenShift ya está disponible en versión Tech Preview como parte de OpenShift 3.11 y posteriores. Los propietarios de una suscripción activa a OpenShift pueden utilizar OpenShift virtualization de forma completamente gratuita y sin ningún tipo de complicaciones adicionales. En el momento de la publicación de este post, las versiones actuales son OpenShift 4.4 y OpenShift virtualization 2.3; si estás utilizando versiones anteriores, vale la pena actualizar para obtener las últimas funciones. La versión completamente soportada de OpenShift virtualization debería salir en la segunda mitad de 2020.
Para más información, consulta para obtener instrucciones de instalación, que incluyen , donde se presentan detalles sobre cómo configurar redes externas.
Fuente: habr.com
