

Introducción a los sistemas operativos
¡Hola, Habr! Quiero presentar a su atención una serie de artículos traducidos sobre una literatura que me parece interesante: OSTEP. Este material examina a fondo el funcionamiento de los sistemas operativos similares a Unix, es decir, el manejo de procesos, varios planificadores, memoria y otros componentes similares que conforman un sistema operativo moderno. Puede ver el origen de todos los materiales aquí . Por favor, tengan en cuenta que la traducción se realizó de manera no profesional (bastante libre), pero espero haber mantenido el sentido general.
Los trabajos de laboratorio sobre este tema se pueden encontrar aquí:
Otras partes:
Y también pueden visitar mi canal en =)
Introducción al programador
El núcleo del problema: ¿Cómo desarrollar una política de programación?
¿Cómo deben desarrollarse los marcos básicos de políticas de programación? ¿Cuáles deben ser las supuestos clave? ¿Qué métricas son importantes? ¿Qué técnicas básicas se utilizaron en los primeros sistemas computacionales?
Supuestos sobre la carga de trabajo
Antes de discutir las posibles políticas, primero hagamos algunas simplificaciones sobre los procesos que se ejecutan en el sistema, que en conjunto se denominan carga de trabajo. Definir la carga de trabajo como una parte crítica para construir políticas y cuanto más sepas sobre la carga, mejor será la política que puedas escribir.
Haremos los siguientes supuestos sobre los procesos ejecutados en el sistema, a veces también llamados jobs (tareas). Prácticamente todos estos supuestos son poco realistas, pero son necesarios para desarrollar el pensamiento.
- Cada tarea se ejecuta durante el mismo tiempo,
- Todas las tareas se programan al mismo tiempo,
- La tarea programada trabaja hasta su finalización,
- Todas las tareas utilizan únicamente la CPU,
- El tiempo de ejecución de cada tarea es conocido.
Métricas del Programador
Además de algunos supuestos sobre la carga, también se necesita alguna herramienta para comparar diferentes políticas de programación: métricas del programador. Una métrica es simplemente una medida de algo. Existen varias métricas que se pueden utilizar para comparar programadores.
Por ejemplo, utilizaremos una métrica llamada tiempo de respuesta (turnaround time). El tiempo de respuesta de una tarea se define como la diferencia entre el tiempo de finalización de la tarea y el tiempo de llegada de la tarea al sistema.
Tturnaround=Tcompletion−Tarrival
Dado que hemos supuesto que todas las tareas llegan al mismo tiempo, entonces Ta=0 y así Tt=Tc. Este valor naturalmente cambiará cuando modifiquemos los supuestos anteriores.
Otra métrica es justicia (fairness). La productividad y la justicia a menudo son características opuestas en la programación. Por ejemplo, un programador puede optimizar la productividad, pero a expensas de la espera para iniciar otras tareas, disminuyendo así la justicia.
PRIMERO EN ENTRAR, PRIMERO EN SALIR (FIFO)
El algoritmo más básico que podemos implementar se llama FIFO o el primero en llegar (dentro), el primero en ser servido (fuera). Este algoritmo tiene varias ventajas: es muy simple de implementar y se adapta a todas nuestras suposiciones, realizando el trabajo bastante bien.
Consideremos un ejemplo simple. Supongamos que 3 tareas se han asignado al mismo tiempo. Pero asumamos que la tarea A llegó un poco antes que las demás, por lo que estará en la lista de ejecución antes que las otras, al igual que la B en relación con la C. Supongamos que cada una de ellas tomará 10 segundos. ¿Cuál sería, en este caso, el tiempo medio de ejecución de estas tareas?
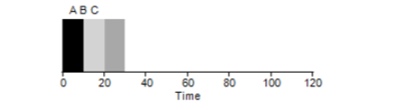
Al calcular los valores — 10+20+30 y dividir por 3, obtendremos un tiempo medio de ejecución del programa igual a 20 segundos.
Ahora intentaremos cambiar nuestras suposiciones. En particular, la suposición 1 y así no asumiremos más que cada tarea se ejecuta el mismo tiempo. ¿Cómo se comportará FIFO esta vez?
Como resulta, los diferentes tiempos de ejecución de las tareas afectan negativamente la productividad del algoritmo FIFO. Supongamos que la tarea A se ejecuta durante 100 segundos, mientras que B y C siguen siendo de 10 cada una.
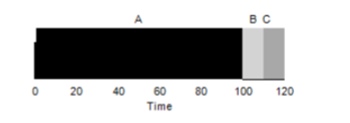
Como se puede ver en la imagen, el tiempo medio para el sistema será (100+110+120)/3=110. Este efecto se llama efecto de convoy, cuando algunos consumidores de recursos de corta duración están en cola detrás de un consumidor pesado. Es similar a una fila en el supermercado, cuando delante de usted hay un comprador con un carrito lleno. La mejor solución al problema es intentar cambiar de caja o relajarse y respirar profundamente.
Shortest Job First
¿Se puede resolver de alguna manera esta situación con procesos pesados? Por supuesto. Otro tipo de planificación se llamaShortest Job First (SJF). Su algoritmo también es bastante primitivo: como se entiende por el nombre, las tareas más cortas se ejecutarán primero una tras otra.
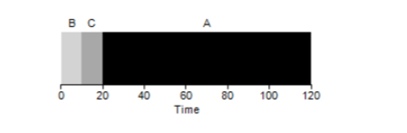
En este ejemplo, el resultado de la ejecución de los mismos procesos mejorará el tiempo medio de rotación de los programas y será igual a 50 en lugar de 110, lo que es prácticamente el doble de mejor.
Por lo tanto, bajo la suposición de que todas las tareas llegan al mismo tiempo, el algoritmo SJF parece ser el más óptimo. Sin embargo, nuestras suposiciones aún no parecen realistas. Esta vez, cambiamos la suposición 2 y presentamos que las tareas pueden llegar en cualquier momento, no todas al mismo tiempo. ¿Qué problemas podría ocasionar esto?
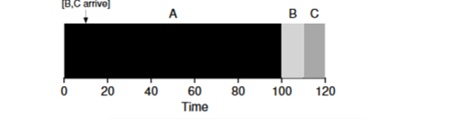
Imaginemos que la tarea A (100s) llega primero y comienza a ejecutarse. En el momento t=10, llegan las tareas B y C, cada una de las cuales tomará 10 segundos. Así, el tiempo promedio de ejecución es (100+(110-10)+(120-10))/3 = 103. ¿Qué podría hacer el planificador para mejorar la situación?
Shortest Time-to-Completion First (STCF)
Para mejorar la situación, omitamos la suposición 3 de que el programa se inicia y funciona hasta completarse. Además, vamos a necesitar soporte de hardware y, como pueden suponer, vamos a utilizar un temporizador para interrumpir la tarea en ejecución y realizar cambios de contexto. De este modo, el planificador puede actuar en el momento en que llegan las tareas B y C: interrumpir la ejecución de la tarea A y procesar las tareas B y C, y después de finalizarlas, continuar con el proceso A. Este tipo de planificador se llama STCFo Preemptive Job First.
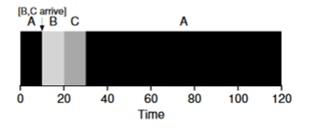
El resultado del funcionamiento de este planificador será el siguiente: ((120-0)+(20-10)+(30-10))/3=50. Así, este planificador se vuelve aún más óptimo para nuestras tareas.
Métrica Tiempo de respuesta (Response Time)
Así, si conocemos el tiempo de ejecución de las tareas y sabemos que estas utilizan solo CPU, STCF será la mejor solución. Y en tiempos antiguos, estos algoritmos funcionaban bastante bien. Sin embargo, ahora el usuario pasa la mayor parte del tiempo frente al terminal y espera una interacción productiva e interactiva. Así nació una nueva métrica — tiempo de respuesta (response time).
El tiempo de respuesta se calcula de la siguiente manera:
Tresponse=Tfirstrun−Tarrival
Por lo tanto, para el ejemplo anterior, el tiempo de respuesta será: A=0, B=0, C=10 (abg=3,33).
Y resulta que el algoritmo STCF no es tan bueno en la situación en la que 3 tareas llegan al mismo tiempo; tendrá que esperar hasta que las tareas pequeñas se completen completamente. Así, el algoritmo es bueno para la métrica de tiempo de retorno, pero malo para la métrica de interactividad. Imagina que, sentado frente a la terminal tratando de escribir caracteres en un editor, tuviste que esperar más de 10 segundos porque alguna otra tarea está ocupando el procesador. No es nada agradable.
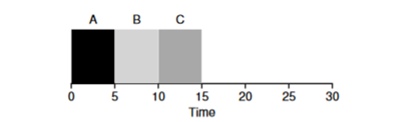
Así que nos enfrentamos a otro problema: ¿cómo podemos construir un planificador que sea sensible al tiempo de respuesta?
Round Robin
Para resolver este problema, se desarrolló un algoritmo Round Robin (RR). La idea básica es bastante simple: en lugar de ejecutar las tareas hasta que se completen, ejecutamos una tarea durante un cierto período de tiempo (llamado cuántum de tiempo) y luego cambiamos a otra tarea de la cola. El algoritmo repite su trabajo hasta que todas las tareas están completas. En este proceso, el tiempo de ejecución del programa debe ser un múltiplo del tiempo tras el cual el temporizador interrupta el proceso. Por ejemplo, si el temporizador interrumpe el proceso cada x=10 ms, el tamaño de la ventana de ejecución del proceso debe ser múltiplo de 10 y puede ser 10, 20 o x*10.
Consideremos un ejemplo: las tareas A, B y C llegan al sistema al mismo tiempo y cada una quiere trabajar 5 segundos. El algoritmo SJF ejecutará cada tarea hasta el final antes de iniciar otra. En cambio, el algoritmo RR con ventana de ejecución=1s pasará por las tareas de la siguiente manera (fig. 4.3):
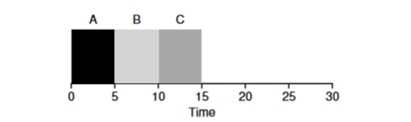
(SJF Nuevamente (Malo para el Tiempo de Respuesta)
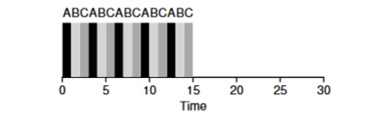
(Round Robin (Bueno para el Tiempo de Respuesta)
El tiempo promedio de respuesta para el algoritmo RR (0+1+2)/3=1, mientras que para SJF (0+5+10)/3=5.
Es lógico suponer que la ventana de tiempo es un parámetro muy importante para RR; cuanto menor sea, mayor será el tiempo de respuesta. Sin embargo, no se puede hacer que sea demasiado pequeña, ya que el tiempo de cambio de contexto también jugará un papel en el rendimiento general. Así, la elección del tiempo de ventana se establece por el arquitecto del sistema operativo y depende de las tareas que se planea ejecutar en él. Cambiar de contexto no es la única operación auxiliar que consume tiempo; el programa en ejecución opera con muchos otros elementos, como diferentes cachés, y en cada cambio es necesario guardar y restaurar este entorno, lo que también puede requerir mucho tiempo.
RR es un excelente planificador si solo se considera la métrica del tiempo de respuesta. Pero, ¿cómo se comportará la métrica del tiempo de rotación de tareas con este algoritmo? Consideremos el ejemplo anterior, donde el tiempo de ejecución de A, B y C es de 5 segundos y llegan al mismo tiempo. La tarea A terminará a las 13, B a las 14 y C a las 15 segundos, por lo que el tiempo promedio de rotación será de 14 segundos. Por lo tanto, RR es el peor algoritmo para la métrica de rotación.
En términos más generales, cualquier algoritmo del tipo RR es justo; divide el tiempo de ejecución de la CPU equitativamente entre todos los procesos. Así, estas métricas entran en conflicto constantemente entre sí.
Por lo tanto, tenemos varios algoritmos contrapuestos y aún quedan algunas suposiciones: que el tiempo de la tarea es conocido y que la tarea solo utiliza la CPU.
Mezcla con I/O
Primero eliminemos la suposición 4, que el proceso solo utiliza la CPU; esto no es cierto ya que los procesos pueden acceder a otro hardware.
En el momento en que un proceso solicita una operación de entrada/salida, el proceso pasa al estado bloqueado, esperando la finalización de la I/O. Si la I/O se envía al disco duro, tal operación puede tardar unos milisegundos o más, y en ese momento el procesador estará inactivo. Durante este tiempo, el planificador puede usar el procesador para otro proceso. La siguiente decisión que debe tomar el planificador es cuándo el proceso completará su I/O. Cuando esto suceda, habrá una interrupción y el sistema operativo cambiará el proceso que solicitó la I/O al estado listo.
Consideremos un ejemplo de varias tareas. Cada una de ellas necesita 50 ms de tiempo de CPU. Sin embargo, la primera accederá a I/O cada 10 ms (también se ejecutará cada 10 ms). Y el proceso B simplemente utiliza 50 ms de CPU sin I/O.
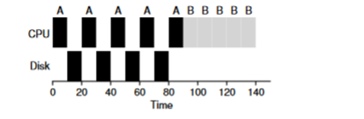
En este ejemplo utilizaremos el programador STCF. ¿Cómo se comportará el programador si lanzamos un proceso como A? Actuará de la siguiente manera: primero completará el proceso A por completo, y luego el proceso B.
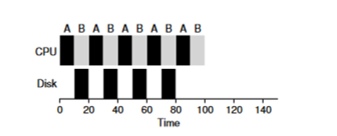
El enfoque tradicional para resolver este problema es interpretar cada subtarea de 10 ms del proceso A como una tarea separada. Así, al comenzar con el algoritmo STJF, la elección entre una tarea de 50 ms y una de 10 ms es obvia. Luego, cuando la subtarea A termine, se iniciará el proceso B y I/O. Después de completar I/O, se decidirá reiniciar el proceso A de 10 ms en lugar del proceso B. De esta manera, es posible implementar la superposición, donde la CPU es utilizada por otro proceso mientras el primero espera I/O. Como resultado, el sistema se utiliza mejor: en el momento en que los procesos interactivos esperan I/O, otros procesos pueden ejecutarse en la CPU.
Ya no hay oráculos.
Ahora tratemos de deshacernos de la suposición de que el tiempo de ejecución de la tarea es conocido. Este es, en general, el peor y más irrealista supuesto de toda la lista. De hecho, en los sistemas operativos promedio, el propio SO geralmente sabe muy poco sobre el tiempo de ejecución de las tareas, ¿cómo entonces construir un programador sin saber cuánto tiempo ejecutará una tarea? Quizás podríamos utilizar algunos principios de RR para resolver este problema.
Summary
Hemos revisado las ideas básicas de la planificación de tareas y hemos considerado 2 familias de programadores. El primero lanza la tarea más corta primero, aumentando así el tiempo de rotación, mientras que el segundo se divide equitativamente entre todas las tareas, mejorando el tiempo de respuesta. Ambos algoritmos son deficientes donde los algoritmos de la otra familia son efectivos. También hemos visto cómo el uso paralelo de CPU e I/O puede mejorar el rendimiento, pero no hemos resuelto el problema de la visión del SO. En la próxima clase, discutiremos un programador que mira al pasado cercano y intenta predecir el futuro. Se llama cola de retroalimentación de múltiples niveles.
Fuente: habr.com
