

Introducción a los sistemas operativos
¡Hola, Habr! Quiero presentar a su atención una serie de artículos traducidos sobre una literatura que me parece interesante: OSTEP. Este material examina a fondo el funcionamiento de los sistemas operativos similares a Unix, es decir, el manejo de procesos, varios planificadores, memoria y otros componentes similares que conforman un sistema operativo moderno. Puede ver el origen de todos los materiales aquí . Por favor, tengan en cuenta que la traducción se realizó de manera no profesional (bastante libre), pero espero haber mantenido el sentido general.
Los trabajos de laboratorio sobre este tema se pueden encontrar aquí:
Otras partes:
Y también pueden visitar mi canal en =)
Planificación: Cola de Retroalimentación Multi-Nivel
En esta lección, hablaremos sobre los problemas de desarrollar uno de los enfoques más conocidos de
planificación, que se llama Cola de Retroalimentación Multi-Nivel (MLFQ). El planificador MLFQ fue descrito por primera vez en 1962 por Fernando J. Corbató en un sistema llamado
Compatible Time-Sharing System (CTSS). Estos trabajos (incluyendo trabajos posteriores sobre
Multics) fueron posteriormente nominados al premio Turing. El planificador fue
posteriormente mejorado y adquirió una forma que se puede encontrar en
algunos sistemas modernos.
El algoritmo MLFQ intenta resolver 2 problemas fundamentales interrelacionados.
Primero, intenta optimizar el tiempo de giro, que como hemos discutido en la lección anterior, se optimiza mediante el método de ejecutar al principio de la cola las tareas más
cortas. Sin embargo, el SO no sabe cuánto tiempo funcionará un proceso determinado, y ese es un
conocimiento necesario para el funcionamiento de los algoritmos SJF, STCF. En segundo lugar, MLFQ intenta
hacer que el sistema sea receptivo para los usuarios (por ejemplo, para aquellos que están sentados y
mirando la pantalla esperando que se complete una tarea) y así minimizar el tiempo
de respuesta. Desafortunadamente, algoritmos como RR reducen el tiempo de respuesta, pero afectan bastante
mal a la métrica del tiempo de giro. De ahí nuestra pregunta: ¿Cómo diseñar un
planificador que cumpla con nuestros requisitos y a la vez no sepa nada sobre
la naturaleza del proceso, en general? ¿Cómo puede un planificador aprender las características de las tareas,
que ejecuta para así tomar mejores decisiones de planificación?
La esencia del problema: ¿Cómo planificar la ejecución de tareas sin conocimiento perfecto?
¿Cómo desarrollar un planificador que minimice simultáneamente el tiempo de respuesta
para tareas interactivas y también minimice el tiempo de giro sin un conocimiento previo
del tiempo de ejecución de la tarea?
Nota: aprendiendo de eventos pasados
La cola MLFQ es un excelente ejemplo de un sistema que aprende de
eventos pasados para predecir el futuro. Enfoques similares son comunes en sistemas operativos (y muchos otros campos de la informática, incluyendo ramas
de predicciones en hardware y algoritmos de caché). Estas aproximaciones
son efectivas cuando las tareas tienen fases de comportamiento y por lo tanto son predecibles.
срабатывают, когда у задач есть поведенческие фазы и таким образом они предсказуемы.
Sin embargo, con esta técnica se debe tener cuidado, porque las predicciones pueden
resultar incorrectas y llevar al sistema a tomar decisiones peores que
si no tuviera ningún conocimiento en absoluto.
MLFQ: Reglas Básicas
Analicemos las reglas básicas del algoritmo MLFQ. Y aunque existen varias implementaciones de este algoritmo,
los enfoques básicos son similares.
En la implementación que estaremos considerando, el MLFQ tendrá varias
colas separadas, cada una con diferente prioridad. En cualquier momento,
la tarea lista para su ejecución se encuentra en una cola. El MLFQ utiliza prioridades
para decidir qué tarea ejecutar, es decir, la tarea con mayor
prioridad (la tarea de la cola con mayor prioridad) se ejecutará primero.
Sin duda, en una cola particular pueden haber más de una tarea, así
que tendrán la misma prioridad. En este caso se utilizará el mecanismo
RR para programar la ejecución entre esas tareas.
Así llegamos a dos reglas básicas para el MLFQ:
Regla 1: Si prioridad(A) > Prioridad(B), se ejecutará la tarea A (B no se ejecutará)
- Regla 2: Si prioridad(A) = Prioridad(B), A y B se ejecutan usando RR.
- A partir de lo anterior, los elementos clave para la programación MLFQ
son las prioridades. En lugar de asignar una prioridad fija a cada
tarea, el MLFQ ajusta su prioridad según el comportamiento observado.
Por ejemplo, si una tarea constantemente cede el control del CPU esperando la entrada del teclado,
el MLFQ mantendrá la prioridad del proceso en un nivel alto, porque así es como
debería funcionar un proceso interactivo. Sin embargo, si por el contrario, la tarea utiliza
intensamente el CPU durante un largo período, el MLFQ reducirá su
prioridad. De esta manera, el MLFQ aprenderá el comportamiento de los procesos mientras trabajan
y adaptará su comportamiento.
Dibujemos un ejemplo de cómo podrían verse las colas en un momento
dado y así obtendremos algo como esto:
En este esquema, hay 2 procesos A y B en la cola de mayor prioridad. El proceso
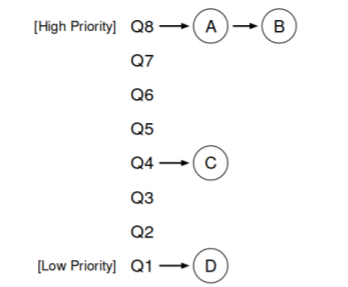
C está en algún lugar a mitad de camino, y el proceso D al final de la cola. De acuerdo con las descripciones
previas del algoritmo MLFQ, el planificador solo ejecutará tareas de mayor prioridad.
описаниям алгоритма MLFQ планировщик будет исполнять задачи только с наивысшим
prioridad según RR, y las tareas C y D no estarán en el lote.
Naturalmente, un snapshot estático no dará una imagen completa de cómo funciona MLFQ.
Es importante entender cómo cambia la situación con el tiempo.
Intento 1: Cómo modificar la prioridad
En este momento, es necesario decidir cómo MLFQ cambiará el nivel de prioridad
de las tareas (y, por ende, la posición de la tarea en la cola) a lo largo de su ciclo de vida. Para
esto, es necesario tener en mente el flujo de trabajo: una cierta cantidad
de tareas interactivas con un corto tiempo de trabajo (y, por lo tanto, una liberación frecuente del
CPU) y algunas tareas largas, que utilizan el CPU durante todo su tiempo de trabajo, donde
el tiempo de respuesta para tales tareas no es crítico. Así, se puede hacer un primer intento de
implementar el algoritmo MLFQ con las siguientes reglas:
- Regla 3: Cuando una tarea entra en el sistema, se coloca en la cola con la más alta
- prioridad.
- Regla 4a: Si la tarea utiliza completamente su ventana de tiempo asignada, entonces su
- prioridad se reduce.
- Regla 4b: Si la Tarea libera el CPU antes de que finalice su ventana de tiempo, entonces
- mantiene la misma prioridad.
Ejemplo 1: Una tarea de larga duración
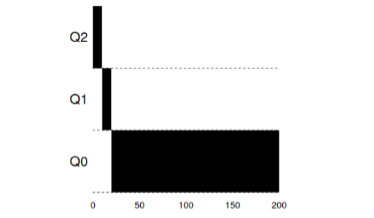
Como se puede ver en este ejemplo, la tarea se asigna con la más alta
prioridad al ingresar. Después de una ventana de tiempo de 10 ms, el proceso disminuye en prioridad
por el programador. Después de la siguiente ventana de tiempo, la tarea finalmente se reduce a
la más baja prioridad en el sistema, donde permanece.
Ejemplo 2: Se introduce una tarea corta
Ahora veamos un ejemplo de cómo MLFQ intentará acercarse a SJF. En este
ejemplo, hay dos tareas: A, que es una tarea de larga duración que utiliza
el CPU continuamente, y B, que es una tarea breve e interactiva. Supongamos que
A ya ha estado trabajando un tiempo cuando llega la tarea B.
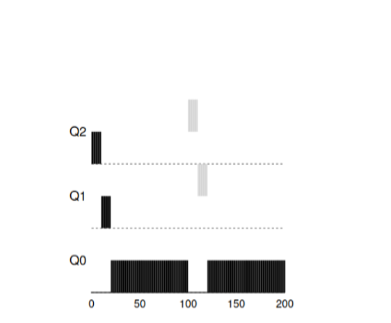
En este gráfico se muestran los resultados del escenario. La tarea A, como cualquier tarea,
que utiliza el CPU se encuentra en la parte inferior. La tarea B llegará en T=100 y será
colocada en la cola con la más alta prioridad. Dado que su tiempo de trabajo es corto,
finalizará antes de llegar a la última cola.
De este ejemplo se deduce el objetivo principal del algoritmo: dado que el algoritmo no
sabe si una tarea es larga o corta, primero supone que la tarea
corta y le da la máxima prioridad. Si realmente es una tarea corta, entonces
se completará rápidamente, de lo contrario, si es una tarea larga, avanzará lentamente
en prioridad hacia abajo y pronto demostrará que realmente es una tarea larga que no
requiere respuesta.
Ejemplo 3: ¿Qué pasa con la entrada-salida?
Ahora echemos un vistazo a un ejemplo de entrada-salida. Como se mencionó en la regla 4b,
si un proceso libera el procesador sin usar completamente su tiempo de CPU,
entonces permanece en el mismo nivel de prioridad. Las intenciones de esta regla son bastante simples
— si una tarea interactiva realiza muchas operaciones de entrada-salida, como esperar
por pulsaciones de tecla o clics del mouse del usuario, tal tarea liberará el procesador
antes del tiempo asignado. No querríamos bajar esa tarea de prioridad,
y así permanecerá en su nivel anterior.
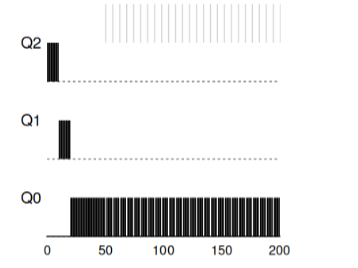
Este ejemplo muestra cómo funcionará el algoritmo con tales procesos: la tarea interactiva B, que necesita CPU solo durante 1 ms antes de ejecutar
un proceso de entrada-salida y la tarea larga A, que utiliza todo su tiempo de CPU.
MLFQ mantiene el proceso B con la más alta prioridad, ya que continúa liberando
CPU todo el tiempo. Si B es una tarea interactiva, entonces el algoritmo ha
alcanzado su objetivo de ejecutar tareas interactivas rápidamente.
Problemas con el algoritmo MLFQ actual
En los ejemplos anteriores, construimos una variante básica de MLFQ. Y parece que
hace su trabajo bien y de manera justa, distribuyendo el tiempo de CPU de manera equitativa entre
tareas largas y permitiendo que las tareas cortas o aquellas que hacen muchas
llamadas de entrada-salida se ejecuten rápidamente. Desafortunadamente, este enfoque tiene varios
problemas graves.
Primero, el problema del hambre: si hay muchas tareas interactivas en el sistema,
consumirán todo el tiempo de CPU y, por lo tanto, ninguna tarea larga
tendrá la oportunidad de ejecutarse (se verán privadas).
En segundo lugar, los usuarios astutos podrían escribir sus programas de tal manera que
engañen al planificador. El engaño consiste en hacer algo que motive al
planificador a asignar más tiempo de CPU al proceso. El algoritmo que
descrito anteriormente es bastante vulnerable a tales ataques: antes de que el tiempo de la ventana prácticamente
se agote, es necesario realizar una operación de entrada-salida (a algún archivo, no importa cuál)
y de esta manera liberar CPU. Este comportamiento permitirá permanecer en la misma
cola y nuevamente obtener un mayor porcentaje de tiempo del procesador. Si se hace
correctamente (por ejemplo, ejecutar el 99% del tiempo de la ventana antes de liberar la CPU),
tarea simplemente puede monopolizar el procesador.
Finalmente, el programa puede cambiar su comportamiento con el tiempo. Aquellas tareas,
que usaban CPU, pueden volverse interactivas. En nuestro ejemplo, tales
tareas no recibirán el debido trato del planificador, al igual que recibirían otras
(originales) tareas interactivas.
Pregunta para el público: ¿qué ataques al planificador se podrían realizar en el mundo moderno?
Intento 2: Aumento de prioridad
Probemos cambiar las reglas y veamos si podemos evitar problemas de
hambruna. ¿Qué podríamos hacer para garantizar que las tareas relacionadas con
CPU obtengan su tiempo (aunque no sea mucho).
Como una solución simple al problema, se puede proponer aumentar periódicamente
la prioridad de todas esas tareas en el sistema. Existen muchas formas
de lograr esto, intentemos implementar como ejemplo algo simple: elevar
todas las tareas a la máxima prioridad, de ahí la nueva regla:
- Regla5: Después de un período de tiempo S, elevar todas las tareas en el sistema a la cola más alta.
Nuestra nueva regla resuelve dos problemas a la vez. En primer lugar, los procesos
no experimentan hambruna garantizada: las tareas en la cola superior compartirán
el tiempo del procesador de acuerdo con el algoritmo RR y así, todos los procesos recibirán
tiempo de procesador. En segundo lugar, si algún proceso que antes usaba
solo CPU se vuelve interactivo, permanecerá en la cola con la mayor
prioridad después de haber recibido una vez un aumento de prioridad a la máxima.
Consideremos un ejemplo. En este escenario, consideremos un proceso que utiliza
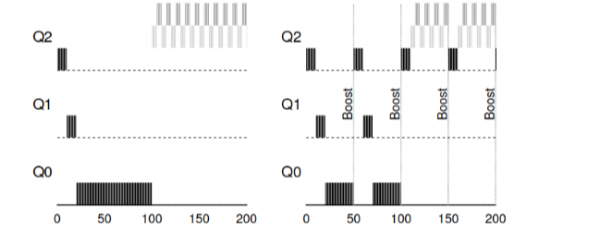
CPU y dos procesos interactivos cortos. A la izquierda, la imagen muestra el comportamiento sin elevación de prioridad, y así, una tarea de larga duración comienza a quedar hambrienta tras la llegada de dos tareas interactivas al sistema. En la imagen de la derecha, cada 50 ms se realiza una elevación de prioridad, garantizando que todos los procesos obtengan tiempo del procesador y se ejecuten periódicamente. 50 ms se ha tomado como ejemplo, en realidad este número es un poco mayor.
Es evidente que la adición del tiempo de elevación periódica S conduce a
la pregunta inevitable: ¿qué valor debe ser establecido? Uno de los merecidos
ingenieros de sistemas, John Ousterhout, se refería a tales magnitudes en los sistemas como voo-doo
constantes, ya que de alguna manera requerían magia negra para ser
ajustadas correctamente. Y, desafortunadamente, S tiene ese aroma. Si se establece un valor demasiado
alto, las tareas largas comenzarán a quedar hambrientas. Y si se establece un valor demasiado bajo,
las tareas interactivas no recibirán el tiempo de procesador adecuado.
Intento 3: Mejor contabilización
Ahora tenemos otro problema que resolver: ¿cómo evitar
que nuestro planificador sea engañado? Los culpables de esta posibilidad son
las reglas 4a y 4b, que permiten que una tarea mantenga prioridad, liberando el procesador
antes de que se agote el tiempo asignado. ¿Cómo se puede manejar esto?
Una solución en este caso podría ser llevar un mejor registro del tiempo de CPU en cada
nivel de MLFQ. En lugar de olvidar el tiempo que el programa utilizó
del procesador durante el periodo asignado, se debe contabilizar y retener. Después de que
un proceso haya consumido su tiempo asignado, su prioridad debe bajarse al siguiente
nivel. Ahora no importa cómo el proceso utilice su tiempo, ya sea como
cálculos continuos en el procesador o como múltiples llamadas. Por lo tanto,
se debe reescribir la regla 4 de la siguiente manera:
- Regla 4: Después de que una tarea haya consumido el tiempo asignado en la cola actual (independientemente de cuántas veces haya liberado el CPU), la prioridad de dicha tarea se reduce (se mueve hacia abajo en la cola).
Veamos un ejemplo:
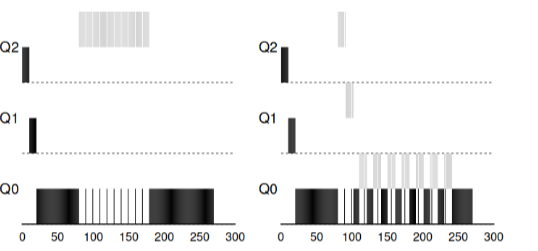 »
La imagen muestra lo que sucede si se intenta engañar al planificador, como
si se mantuvieran las reglas anteriores 4a, 4b, el resultado a la izquierda sería. Con la nueva
regla — el resultado está a la derecha. Antes de la protección, cualquier proceso podía provocar I/O hasta completar y
así dominar la CPU, después de activar la protección, independientemente del comportamiento
de I/O, aún así será relegado en las colas y así no podrá apoderarse de manera deshonesta
de los recursos de la CPU.
Mejorando MLFQ y otros problemas
Con las mejoras mencionadas surgen nuevos problemas: una de las principales
cuestiones es cómo parametrizar tal planificador. Es decir, ¿cuántas deben ser
las colas? ¿Cuál debe ser el tamaño de la ventana de trabajo del programa dentro de la cola? ¿Con
qué frecuencia debería elevarse el privilegio de un programa para evitar el hambre y
considerar el cambio en el comportamiento del programa? No hay una simple
respuesta a estas preguntas y solo los experimentos con cargas y la posterior configuración
del planificador pueden llevar a un cierto equilibrio satisfactorio.
Por ejemplo, la mayoría de las implementaciones de MLFQ permiten asignar diferentes
intervalos de tiempo a diversas colas. A las colas de alto prioridad se les asignan generalmente
intervalos cortos. Estas colas están compuestas por tareas interactivas,
cuyo cambio entre ellas es bastante sensible y debería llevar 10 ms o menos.
En contraste, las colas de baja prioridad están compuestas por tareas largas que utilizan
la CPU. En este caso, los intervalos de tiempo largos son muy adecuados (100 ms).
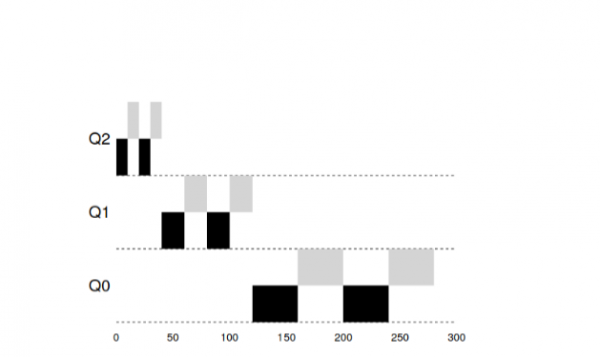
En este ejemplo, hay 2 tareas que trabajaron en la cola de alta prioridad durante 20
ms, divididas en ventanas de 10 ms. 40 ms en la cola media (ventana de 20 ms) y en la cola de baja prioridad
el intervalo de tiempo se volvió de 40 ms, donde las tareas completaron su trabajo.
La implementación de MLFQ en el sistema operativo Solaris es una clase de planificadores de tiempo compartido.
El planificador proporciona un conjunto de tablas que definen con precisión cómo debe
cambiar la prioridad de un proceso a lo largo de su vida, cuál debe ser el tamaño
de la ventana asignada y con qué frecuencia se deben elevar las prioridades de la tarea. El administrador
del sistema puede interactuar con esta tabla y hacer que el planificador se comporte
de manera diferente. Por defecto, esta tabla tiene 60 colas con un aumento gradual
del tamaño de la ventana de 20 ms (alta prioridad) a varios cientos de ms (baja prioridad), y
también con un impulso de todas las tareas por segundo.
Otros planificadores MLFQ no utilizan tablas ni reglas específicas
que se describen en esta lección, por el contrario, calculan las prioridades utilizando
fórmulas matemáticas. Así, por ejemplo, el planificador en FreeBSD utiliza una fórmula para
calcular la prioridad actual de una tarea, basándose en cuánto tiempo ha utilizado el CPU.
Además, el uso de la CPU se degrada con el tiempo, y de esta manera, el aumento de la prioridad ocurre de una manera un poco diferente a la descrita anteriormente. Estos son los
llamados algoritmos de decrecimiento. Desde la versión 7.1 en FreeBSD, se utiliza el planificador ULE.
Finalmente, muchos planificadores tienen otras características. Por ejemplo, algunos
planificadores reservan los niveles más altos para el funcionamiento del sistema operativo, y así
ningún proceso de usuario podrá obtener la prioridad más alta en
el sistema. Algunos sistemas permiten dar sugerencias para ayudar al
planificador a ajustar correctamente las prioridades. Por ejemplo, con el comando
se puede aumentar o disminuir la prioridad de una tarea y, de esta forma, aumentar o nice
reducir las posibilidades de que un programa obtenga tiempo de CPU.
MLFQ: Resumen
Hemos descrito un enfoque para la planificación conocido como MLFQ. Su nombre
se basa en el principio de funcionamiento: tiene varias colas y utiliza la retroalimentación
para determinar la prioridad de la tarea.
La forma final de las reglas será la siguiente:
Regla1
- : Si prioridad(A) > Prioridad(B), se ejecutará la tarea A (B no se ejecutará)Regla2
- : Si prioridad(A) = Prioridad(B), A y B se ejecutan utilizando RRRegla3
- : Cuando una tarea llega al sistema, se coloca en la cola de mayor prioridad.MLFQ es interesante por la siguiente razón: en lugar de requerir conocimiento sobre
- Regla 4: Después de que una tarea haya consumido el tiempo asignado en la cola actual (independientemente de cuántas veces haya liberado el CPU), la prioridad de dicha tarea se reduce (se mueve hacia abajo en la cola).
- Regla5: Después de un período de tiempo S, elevar todas las tareas en el sistema a la cola más alta.
la naturaleza de la tarea de antemano, el algoritmo estudia el comportamiento pasado de la tarea y asigna
las prioridades en consecuencia. De esta manera, intenta sentarse en dos sillas a la vez: alcanzar un rendimiento para tareas pequeñas (SJF, STCF) y ejecutar de manera justa tareas largas y
que ocupan el CPU. Por eso muchos sistemas, incluyendo BSD y sus derivados,
Solaris, Windows, Mac utilizan alguna forma del algoritmo MLFQ como base.
manpages.debian.org/stretch/manpages/sched.7.en.html
en.wikipedia.org/wiki/Scheduling_
Material adicional:
- (computing)
Fuente: habr.com
