

La arquitectura de microservicios, como todo en este mundo, tiene sus pros y sus contras. Algunos procesos se vuelven más sencillos con ella, otros más complejos. Y en aras de la velocidad de los cambios y una mejor escalabilidad, es necesario hacer sacrificios. Uno de ellos es la complejidad del análisis. Si en un monolito toda la analítica operativa se puede reducir a consultas SQL a una réplica de análisis, en una arquitectura de múltiples servicios cada servicio tiene su propia base de datos, y parece que no se puede hacer con una sola consulta (¿o sí?). Para aquellos interesados en cómo resolvimos el problema de la analítica operativa en nuestra empresa y cómo aprendimos a vivir con esta solución, están todos invitados.
Me llamo Pavel Sivash, en DomClick trabajo en el equipo que se encarga del soporte del almacén de datos analíticos. Nuestra actividad se puede clasificar, de forma general, como ingeniería de datos, pero en realidad, el espectro de tareas es mucho más amplio. Existen tareas estándar en la ingeniería de datos como ETL/ELT, mantenimiento y adaptación de herramientas para el análisis de datos y desarrollo de nuestras propias herramientas. En particular, para la generación de informes operativos decidimos «pretender» que tenemos un monolito y dar a los analistas una base de datos en la que estarán todos los datos necesarios.
En general, consideramos diferentes opciones. Podría haberse construido un almacenamiento completo; incluso lo intentamos, pero, siendo honestos, no logramos mucho al intentar conciliar cambios frecuentes en la lógica con un proceso de construcción de almacenamiento y modificación de datos que resultaba bastante lento (si alguien lo consiguió, por favor comente cómo). Podríamos haber dicho a los analistas: "Chicos, aprendan python y utilicen réplicas analíticas", pero eso implica un requisito adicional para la selección de personal, y parecía que era preferible evitarlo si era posible. Decidimos probar la tecnología FDW (Foreign Data Wrapper): en esencia, es un dblink estándar que existe en la norma SQL, pero con una interfaz mucho más conveniente. Basándonos en esto, creamos una solución que finalmente se arraigó y en la que decidimos detenernos. Los detalles serían tema de un artículo aparte, o tal vez varios, ya que hay mucho que contar: desde la sincronización de esquemas de bases hasta la gestión de acceso y la anonimización de datos personales. También es necesario aclarar que esta solución no reemplaza a las verdaderas bases de datos analíticas y almacenes de datos, solo resuelve una tarea específica.
A nivel general, se ve así:
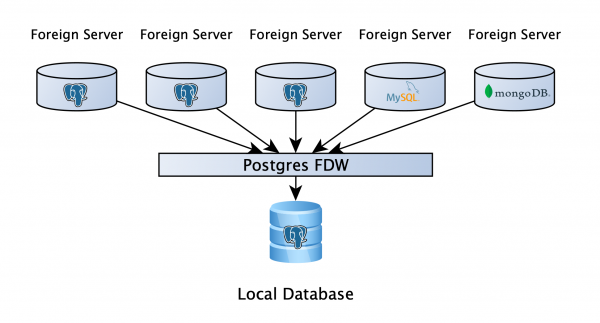
Hay una base de datos PostgreSQL donde los usuarios pueden almacenar sus datos de trabajo, y lo más importante es que a esta base están conectadas, a través de FDW, réplicas analíticas de todos los servicios. Esto permite realizar consultas a varias bases, sin importar si son: PostgreSQL, MySQL, MongoDB o cualquier otra cosa (archivo, API; si no hay un wrapper adecuado, se puede crear uno propio). Bueno, eso parece todo, ¡genial! ¿Nos vamos?
Si todo terminara tan rápido y sencillo, probablemente no habría artículo.
Es importante entender claramente cómo Postgres maneja las consultas a servidores remotos. Esto parece lógico, sin embargo, a menudo se pasa por alto: Postgres divide la consulta en partes que se ejecutan en los servidores remotos de manera independiente, recopila esos datos y realiza los cálculos finales por sí mismo, por lo que la velocidad de ejecución de la consulta dependerá mucho de cómo esté escrita. También cabe mencionar que cuando los datos llegan de un servidor remoto, ya no tienen índices, no hay nada que ayude al planificador, por lo tanto, solo nosotros mismos podemos ayudarlo y orientarlo. Y precisamente sobre esto es lo que me gustaría hablar con más detalle.
Consulta simple y plan asociado
Para mostrar cómo Postgres ejecuta una consulta a una tabla de 6 millones de filas de forma remota servidor, observemos un plan sencillo.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
El uso de la instrucción VERBOSE permite ver la consulta que se enviará al servidor remoto y los resultados que recibiremos para su procesamiento posterior (línea RemoteSQL).
Avancemos un poco más y añadamos varios filtros a nuestra consulta: uno por boolean campo, uno por inclusión timestamp dentro de un intervalo y uno por jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Aquí es donde radica el punto que se debe tener en cuenta al escribir las consultas. Los filtros no se enviaron al servidor remoto, lo que significa que para su ejecución, Postgres extrae todas las 6 millones de filas para luego filtrarlas localmente (línea Filter) y realizar la agregación. La clave del éxito es redactar la consulta de tal manera que los filtros se transfieran a la máquina remota, y así obtengamos y agreguemos solo las filas necesarias.
Eso es un verdadero booleanshit
Con los campos booleanos, es todo simple. La problemática en la consulta original surgió debido al operador is. Si lo reemplazamos por =, obtendremos el siguiente resultado:
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=508010.14..508010.15 rows=1 width=8) (actual time=19064.314..19064.314 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..507988.44 rows=8679 width=0) (actual time=33.035..18951.278 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 3567989
        Remote SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Planning time: 0.834 ms
Execution time: 19064.534 ms
Como pueden ver, el filtro se envió al servidor remoto, y el tiempo de ejecución se redujo de 27 a 19 segundos.
Vale la pena señalar que el operador is se diferencia del operador = en que puede trabajar con el valor Null. Esto significa que is not True en el filtro dejará valores False y Null, mientras que != True dejará solo valores False. Por lo tanto, al reemplazar el operador is not se deben pasar dos condiciones en el filtro con el operador OR, por ejemplo, WHERE (col != True) OR (col is null).
Ya hemos resuelto el booleano, sigamos adelante. Mientras tanto, volvamos a poner el filtro de valor booleano en su forma original para examinar independientemente el efecto de otros cambios.
timestamptz? hz
De hecho, a menudo es necesario experimentar con la forma correcta de escribir una consulta que involucre servidores remotos, y luego buscar explicaciones sobre por qué sucede exactamente eso. Hay muy poca información al respecto en Internet. Así, en los experimentos descubrimos que el filtro de fecha fija se envía al servidor remoto sin problemas, pero cuando queremos establecer la fecha de manera dinámica, por ejemplo, now() o CURRENT_DATE, eso no ocurre. En nuestro ejemplo, agregamos un filtro para que la columna created_at contenga datos exactamente de 1 mes atrás (BETWEEN CURRENT_DATE - INTERVAL '7 month' AND CURRENT_DATE - INTERVAL '6 month'). ¿Qué hicimos en este caso?
explicar analizar detalladamente
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt >'source' = 'test';

Agregado  (costo=306875.17..306875.18 filas=1 ancho=8) (tiempo real=4789.114..4789.115 filas=1 bucles=1)
  Salida: count(1)
  InitPlan 1 (devuelve $0)
    ->  Resultado  (costo=0.00..0.02 filas=1 ancho=8) (tiempo real=0.007..0.008 filas=1 bucles=1)
          Salida: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (devuelve $1)
    ->  Resultado  (costo=0.00..0.02 filas=1 ancho=8) (tiempo real=0.002..0.002 filas=1 bucles=1)
          Salida: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Escaneo Externo en fdw_schema."table"  (costo=100.02..306874.86 filas=105 ancho=0) (tiempo real=23.475..4681.419 filas=1360025 bucles=1)
        Salida: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filtro: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Filas eliminadas por el filtro: 76934
        SQL Remoto: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Tiempo de planeación: 0.703 ms
Tiempo de ejecución: 4789.379 ms
Le sugerimos al planificador que calculara de antemano la fecha en la subconsulta y pasar ya la variable lista al filtro. Y esta sugerencia nos dio un resultado excelente, la consulta se volvió casi 6 veces más rápida.
Nuevamente, aquí es importante tener cuidado: el tipo de datos en la subconsulta debe ser el mismo que el del campo por el que filtramos, de lo contrario, el planificador decidirá que como los tipos son diferentes, es necesario recuperar todos los datos primero y luego filtrarlos localmente.
Volveremos a establecer el filtro por fecha en su valor original.
Freddy vs. Jsonb
En general, los campos booleanos y las fechas ya aceleraron bastante nuestra consulta, sin embargo, aún quedaba otro tipo de datos. La batalla con la filtración por él, para ser honesto, todavía no ha terminado, aunque aquí también hay algunos éxitos. Así que así fue como logramos pasar el filtro por jsonb el campo al servidor remoto.
explicar analizar detalladamente
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta @> '{"source":"test"}'::jsonb;

Agregado  (costo=245463.60..245463.61 filas=1 ancho=8) (tiempo real=6727.589..6727.590 filas=1 bucles=1)
  Salida: count(1)
  ->  Escaneo Externo en fdw_schema."table"  (costo=1100.00..245459.90 filas=1478 ancho=0) (tiempo real=16.213..6634.794 filas=1360025 bucles=1)
        Salida: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filtro: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Tiempo de planeación: 0.747 ms
Tiempo de ejecución: 6727.815 ms
En lugar de operadores de filtración, es necesario usar el operador de existencia de uno. jsonb en otro. 7 segundos en lugar de los 29 originales. Hasta ahora, esta es la única opción exitosa para la transmisión de filtros por jsonb a un servidor remoto, pero aquí es importante tener en cuenta una limitación: estamos usando la versión de la base 9.6, sin embargo, planeamos completar las últimas pruebas y migrar a la versión 12 antes de finales de abril. Una vez que hagamos la actualización, escribiremos sobre cómo esto afectó, ya que hay muchas esperanzas puestas en los cambios: json_path, nuevo comportamiento de CTE, push down (existente desde la versión 10). Tenemos muchas ganas de probarlo pronto.
Finish him
Hemos verificado cómo cada cambio afecta la velocidad de la consulta por separado. Ahora veamos qué sucede cuando los tres filtros están bien escritos.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Sí, la consulta parece más compleja, es un coste forzado, pero la velocidad de ejecución es de 2 segundos, ¡más de 10 veces más rápida! Y estamos hablando de una consulta simple a un conjunto de datos relativamente pequeño. En consultas reales, hemos obtenido aumentos de hasta cientos de veces.
Resumiendo: si estás usando PostgreSQL con FDW, siempre verifica si se están enviando todos los filtros al servidor remoto, y te irá bien… al menos, hasta que llegues a los joins entre tablas de diferentes servidores. Pero esa ya es historia para otro artículo.
¡Gracias por su atención! Estaré encantado de escuchar preguntas, comentarios y también historias sobre su experiencia en los comentarios.
Fuente: habr.com
