

Nota de traducción.: En este artículo, Banzai Cloud comparte un ejemplo del uso de sus herramientas especiales para facilitar la operación de Kafka dentro de Kubernetes. Las instrucciones proporcionadas ilustran cómo se puede determinar el tamaño óptimo de la infraestructura y configurar Kafka para alcanzar la capacidad de rendimiento requerida.
Apache Kafka es una plataforma de streaming distribuida para crear sistemas de streaming en tiempo real que sean confiables, escalables y de alto rendimiento. Sus impresionantes capacidades se pueden ampliar utilizando Kubernetes. Para ello, hemos desarrollado y una herramienta llamada . Estas permiten ejecutar Kafka en Kubernetes y usar sus diversas funciones, como la configuración avanzada del broker, escalado basado en métricas con reequilibrio, rack awareness, "despliegue suave" (graceful) de actualizaciones, etc.
Prueba Supertubes en tu clúster:
curl https://getsupertubes.sh | sh y supertubes install -a --no-democluster --kubeconfigO consulta . También puedes leer sobre algunas de las capacidades de Kafka, cuyo manejo está automatizado mediante Supertubes y el operador Kafka. De ello ya hemos escrito en el blog:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Al decidir desplegar un clúster de Kafka en Kubernetes, seguramente te enfrentarás al problema de determinar el tamaño óptimo de la infraestructura básica y la necesidad de un ajuste fino de la configuración de Kafka para cumplir con los requisitos de capacidad de rendimiento. El rendimiento máximo de cada broker está determinado por el rendimiento de los componentes de infraestructura subyacentes, como la memoria, el procesador, la velocidad del disco, la capacidad de la red, etc.
Idealmente, la configuración del broker debe ser tal que todos los elementos de la infraestructura se utilicen al máximo de su capacidad. Sin embargo, en la vida real, dicha configuración es bastante compleja. Es más probable que los usuarios ajusten la configuración de los brokers de manera que maximicen el uso de uno o dos componentes (disco, memoria o procesador). En general, un broker muestra el rendimiento máximo cuando su configuración permite aprovechar al máximo el componente más lento. Así podemos obtener una idea aproximada de la carga que puede manejar un solo broker.
Teóricamente, también podemos estimar el número de brokers necesarios para manejar una carga dada. Sin embargo, en la práctica, hay tantas opciones de configuración en diferentes niveles que es bastante difícil (si no imposible) evaluar el rendimiento potencial de una cierta configuración. En otras palabras, planificar una configuración basándose en un rendimiento específico es muy complicado.
Para los usuarios de Supertubes, generalmente aplicamos el siguiente enfoque: comenzamos con una cierta configuración (infraestructura + ajustes), luego medimos su rendimiento, ajustamos la configuración del broker y repetimos el proceso una vez más. Esto continúa hasta que se aproveche completamente el potencial del componente más lento de la infraestructura.
De esta manera, obtenemos una visión más clara de cuántos brokers se necesitan en un clúster para manejar una carga determinada (el número de brokers también depende de otros factores, como el número mínimo de réplicas de mensajes para garantizar la resiliencia, el número de líderes de partición, etc.). Además, obtenemos una idea de qué componente de la infraestructura se beneficia del escalado vertical.
En este artículo, abordaremos los pasos que tomamos para "exprimir al máximo" los componentes más lentos en las configuraciones iniciales y medir la capacidad de procesamiento del clúster Kafka. Una configuración altamente resistente requiere al menos tres brokers en funcionamiento (min.insync.replicas=3), distribuidos en tres zonas de disponibilidad diferentes. Para la configuración, escalado y monitoreo de la infraestructura de Kubernetes, utilizamos nuestra propia plataforma de gestión de contenedores para nubes híbridas — . Soporta on-premise (bare metal, VMware) y cinco tipos de nubes (Alibaba, AWS, Azure, Google, Oracle), así como cualquier combinación de ellas.
Reflexiones sobre la infraestructura y configuración del clúster Kafka
Para los ejemplos a continuación, hemos elegido AWS como proveedor de servicios en la nube y EKS como distribución de Kubernetes. Una configuración similar se puede implementar con — distribución de Kubernetes de Banzai Cloud, certificada por la CNCF.
Disco
Amazon ofrece diferentes . En su base, gp2 y io1 se basan en discos SSD, sin embargo, para garantizar un alto rendimiento gp2 consume créditos acumulados (I/O credits), por lo que preferimos el tipo io1, que ofrece un rendimiento alto y estable.
Tipos de instancias
El rendimiento de Kafka depende en gran medida de la caché de páginas del sistema operativo, por lo que necesitamos instancias con suficiente memoria para los brokers (JVM) y para la caché de páginas. La instancia c5.2xlarge es un buen comienzo, ya que tiene 16 GB de memoria y . Su desventaja es que puede ofrecer un rendimiento máximo durante no más de 30 minutos cada 24 horas. Si la carga de trabajo requiere un rendimiento máximo durante períodos más prolongados, es conveniente considerar otros tipos de instancias. Así lo hicimos, eligiendo c5.4xlarge. Proporciona un rendimiento máximo de 593,75 MB/s. El rendimiento máximo del volumen EBS io1 es superior al de la instancia c5.4xlarge, por lo que el elemento más lento de la infraestructura parece ser el rendimiento I/O de este tipo de instancia (lo que también deberían confirmar los resultados de nuestras pruebas de carga).
Red
El ancho de banda de la red debe ser lo suficientemente grande en comparación con el rendimiento de la instancia VM y el disco, de lo contrario, la red se convierte en un cuello de botella. En nuestro caso, la interfaz de red c5.4xlarge soporta velocidades de hasta 10 Gb/s, lo cual es significativamente superior al rendimiento I/O de la instancia VM.
Despliegue de brokers
Los brokers deben desplegarse (planificarse en Kubernetes) en nodos dedicados para evitar competir con otros procesos por recursos de CPU, memoria, red y disco.
Versión de Java
La opción lógica es Java 11, ya que es compatible con Docker en el sentido de que la JVM identifica correctamente los procesadores y la memoria disponibles para el contenedor en el que se ejecuta el broker. Sabiendo que los límites de CPU son importantes, la JVM establece de manera interna y transparente el número de hilos de GC y hilos del compilador JIT. Usamos la imagen de Kafka banzaicloud/kafka:2.13-2.4.0, incluida la versión Kafka 2.4.0 (Scala 2.13) en Java 11.
Si desea saber más sobre Java/JVM en Kubernetes, consulte nuestras siguientes publicaciones:
- ;
- .
Configuraciones de memoria del broker
Hay dos aspectos clave en la configuración de la memoria del broker: configuraciones para la JVM y para el pod de Kubernetes. El límite de memoria establecido para el pod debe ser mayor que el tamaño máximo del heap, de modo que la JVM tenga espacio para el metaspacio de Java, que reside en su propia memoria, y para la caché de páginas del sistema operativo, que Kafka utiliza activamente. En nuestras pruebas, ejecutamos brokers de Kafka con los parámetros -Xmx4G -Xms2G, y el límite de memoria para el pod era 10 Gi. Tenga en cuenta que las configuraciones de memoria para la JVM se pueden obtener automáticamente usando -XX:MaxRAMPercentage y -X:MinRAMPercentage, según el límite de memoria del pod.
Configuraciones de CPU del broker
En general, se puede aumentar el rendimiento aumentando el paralelismo mediante el aumento del número de hilos utilizados por Kafka. Cuantos más procesadores estén disponibles para Kafka, mejor. En nuestra prueba comenzamos con un límite de 6 procesadores y gradualmente (por iteraciones) aumentamos el número a 15. Además, configuramos num.network.threads=12 en la configuración del broker para aumentar el número de hilos que reciben datos de la red y los envían. Al descubrir que los brokers seguidores no pueden recibir réplicas lo suficientemente rápido, aumentamos num.replica.fetchers a 4 para aumentar la velocidad con la que los brokers seguidores replican mensajes de los líderes.
Herramienta de generación de carga
Es necesario asegurarse de que el potencial del generador de carga elegido no se agote antes de que el clúster de Kafka (para el cual se realiza el benchmark) alcance su máxima carga. En otras palabras, es fundamental realizar una evaluación previa de las capacidades de la herramienta de generación de carga, así como elegir tipos de instancias que cuenten con suficientes procesadores y memoria. De esta manera, nuestra herramienta producirá más carga de la que el clúster de Kafka puede manejar. Después de múltiples experimentos, nos decidimos por tres instancias c5.4xlarge, en cada una de las cuales se ejecutó el generador.
Benchmarking
La medición del rendimiento es un proceso iterativo que incluye las siguientes etapas:
- configuración de la infraestructura (clúster EKS, clúster Kafka, herramienta de generación de carga, así como Prometheus y Grafana);
- generación de carga durante un período específico para filtrar desviaciones aleatorias en las métricas de rendimiento recopiladas;
- ajuste de la infraestructura y la configuración del broker basado en las métricas de rendimiento observadas;
- repetir el proceso hasta alcanzar el nivel de capacidad requerido del clúster Kafka. Este debe ser consistentemente reproducible y mostrar variaciones mínimas en la capacidad.
En la siguiente sección se describen los pasos que se llevaron a cabo en el proceso de benchmarking del clúster de prueba.
Herramientas
Para el despliegue rápido de la configuración básica, la generación de carga y la medición del rendimiento se utilizaron las siguientes herramientas:
- para organizar el clúster EKS de Amazon con (para la recolección de métricas de Kafka e infraestructura) y (para la visualización de estas métricas). Aprovechamos servicios integrados en que ofrecen monitoreo federado, recolección centralizada de logs, escaneo de vulnerabilidades, recuperación ante fallos, seguridad a nivel empresarial y mucho más.
- es una herramienta para pruebas de carga del clúster Kafka.
- Paneles de Grafana para la visualización de métricas de Kafka e infraestructura: , .
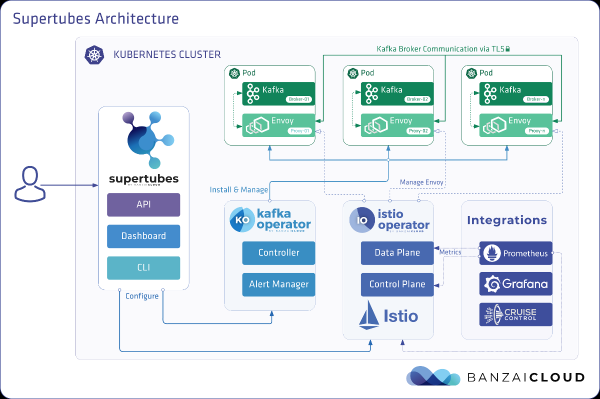
- Supertubes CLI para la configuración más sencilla de un clúster de Kafka en Kubernetes. Zookeeper, el operador de Kafka, Envoy y muchos otros componentes están instalados y configurados correctamente para ejecutar un clúster de Kafka listo para producción en Kubernetes.
- Para la instalación supertubes CLI siga las instrucciones proporcionadas .
Clúster EKS
Prepare el clúster EKS con nodos de trabajo dedicados c5.4xlarge en varias zonas de disponibilidad para los pods con brokers de Kafka, así como nodos dedicados para generadores de carga e infraestructura de monitoreo.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonCuando el clúster EKS esté en funcionamiento, active su — desplegará Prometheus y Grafana en el clúster.
Componentes del sistema Kafka
Instale los componentes del sistema Kafka (Zookeeper, kafka-operator) en EKS utilizando supertubes CLI:
supertubes install -a --no-democluster --kubeconfigClúster Kafka
Por defecto, en EKS se utilizan volúmenes EBS de tipo gp2, por lo que es necesario crear una clase de almacenamiento separada basada en volúmenes io1 para el clúster de Kafka:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Establezca el parámetro para los brokers min.insync.replicas=3 y despliegue pods de brokers en nodos en tres zonas de disponibilidad diferentes:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Tópicos
Ejecutamos en paralelo tres instancias de un generador de carga. Cada una escribe en su propio tópico, es decir, en total necesitamos tres tópicos:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Para cada tópico, el factor de replicación es 3, que es el valor mínimo recomendado para sistemas de producción altamente disponibles.
Herramienta de generación de carga
Lanzamos tres instancias del generador de carga (cada una escribía en un tema separado). Para los pods del generador de carga es necesario establecer la afinidad del nodo, de modo que se planifiquen solo en los nodos asignados para ellos:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Algunos puntos a tener en cuenta:
- El generador de carga genera mensajes de 512 bytes y los publica en Kafka en lotes de 500 mensajes.
- Con el argumento
-required-acks=allla publicación se considera exitosa cuando todas las réplicas sincronizadas del mensaje son recibidas y confirmadas por los brokers de Kafka. Esto significa que en la evaluación medimos no solo la velocidad con la que los líderes reciben los mensajes, sino también la de sus seguidores, que replican los mensajes. El objetivo de esta prueba no es evaluar la velocidad de lectura de los consumidores (consumidores) de mensajes recién llegados, que aún permanecen en la caché de páginas del sistema operativo, y su comparación con la velocidad de lectura de los mensajes almacenados en disco. - El generador de carga inicia paralelamente 20 workers (
-workers=20). Cada worker contiene 5 productores, que comparten la conexión del worker al clúster de Kafka. En total, cada generador cuenta con 100 productores, y todos envían mensajes al clúster de Kafka.
Monitoreo del estado del clúster
Durante las pruebas de carga del clúster de Kafka, también monitoreamos su salud para asegurarnos de que no hubiera reinicios de pods, réplicas desincronizadas y la máxima capacidad de procesamiento con mínimas fluctuaciones:
- El generador de carga escribe estadísticas estándar sobre la cantidad de mensajes publicadas y el nivel de errores. El porcentaje de errores debe mantenerse en:
0,00%. - , desplegado por kafka-operator, proporciona un panel de monitoreo donde también podemos observar el estado del clúster. Para ver este panel, ejecuta:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - El nivel ISR (número de réplicas "in-sync") shrink y expansion es igual a 0.
Resultados de las mediciones
3 brókers, tamaño de mensaje — 512 bytes
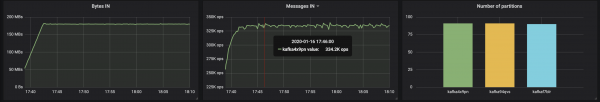
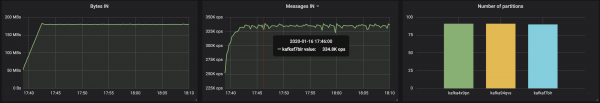
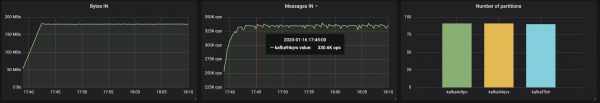
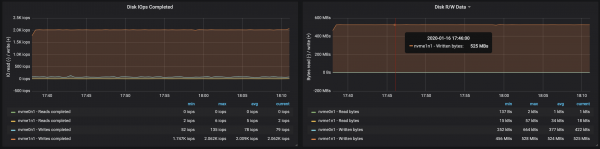
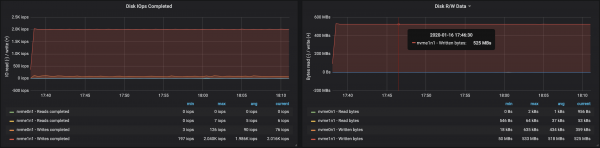
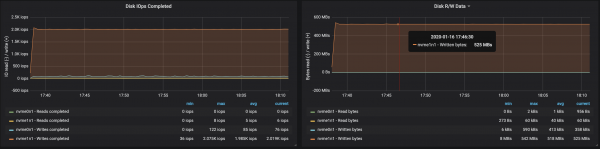
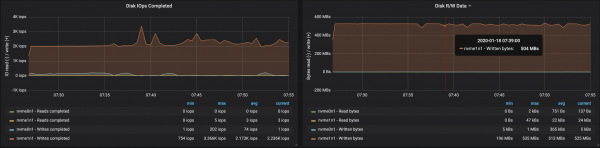
Con las particiones distribuidas uniformemente entre tres brókers, logramos alcanzar un rendimiento ~500 Mb/s (aproximadamente 990 mil mensajes por segundo):
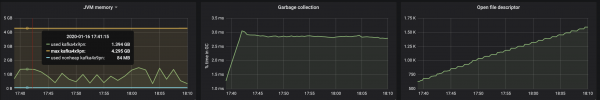
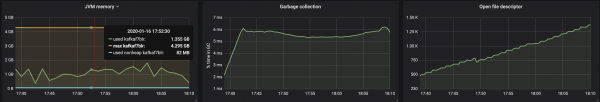
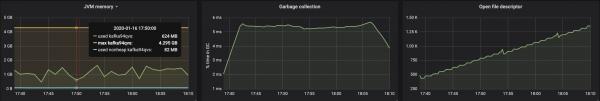
El consumo de memoria de la máquina virtual JVM no excedió 2 Gb:
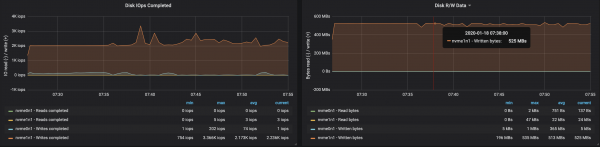
La capacidad de procesamiento del disco alcanzó el máximo rendimiento de I/O del nodo en las tres instancias donde operaban los brókers:
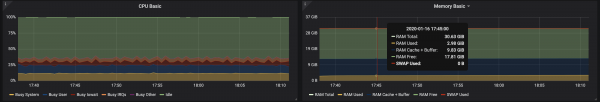
Los datos sobre el uso de memoria de los nodos indican que el buffering y el almacenamiento en caché del sistema tomaron aproximadamente 10-15 Gb:
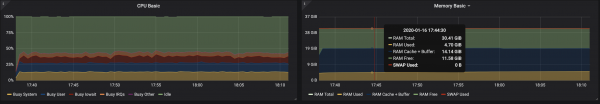
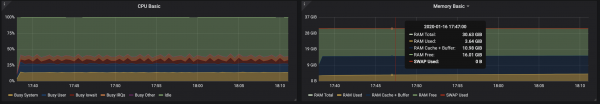
3 brókers, tamaño de mensaje — 100 bytes
Con la reducción del tamaño de los mensajes, la capacidad de procesamiento disminuye aproximadamente en un 15-20%: esto se debe al tiempo requerido para procesar cada mensaje. Además, la carga en el procesador aumentó casi el doble.
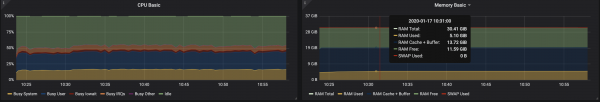
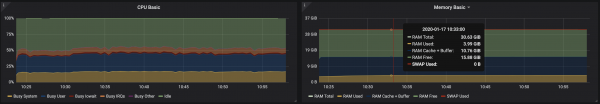
Dado que todavía hay núcleos no utilizados en los nodos de los brókers, se puede mejorar el rendimiento modificando la configuración de Kafka. Esta no es una tarea sencilla, por lo que para aumentar la capacidad de procesamiento es mejor trabajar con mensajes de mayor tamaño.
4 brókers, tamaño de mensaje — 512 bytes
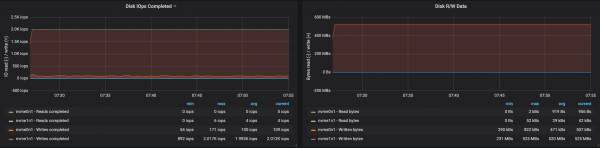
Se puede aumentar fácilmente el rendimiento del clúster de Kafka simplemente añadiendo nuevos brókers y manteniendo el equilibrio de las particiones (esto asegura una distribución uniforme de la carga entre los brókers). En nuestro caso, después de añadir un bróker, la capacidad de procesamiento del clúster aumentó a ~580 Mb/s (~1,1 millones de mensajes por segundo). El aumento fue menor de lo esperado: esto se debe principalmente al desequilibrio en las particiones (no todos los brókers están operando al máximo de su capacidad).
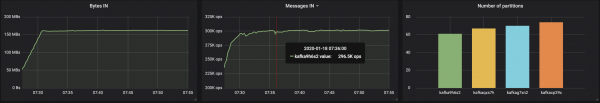
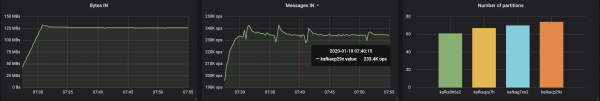
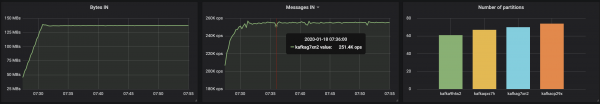
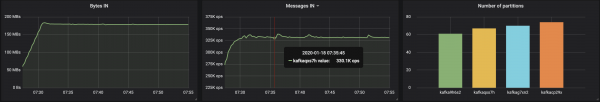
El consumo de memoria de la máquina JVM se mantuvo por debajo de 2 GB:
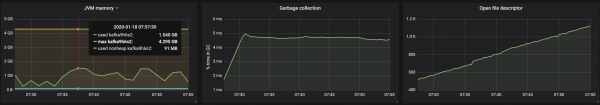
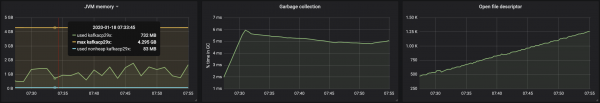
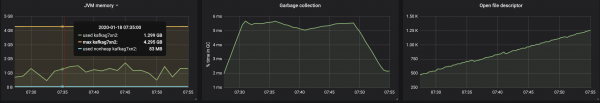
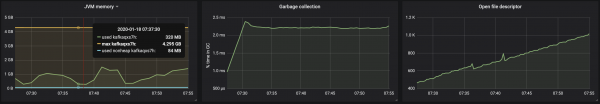
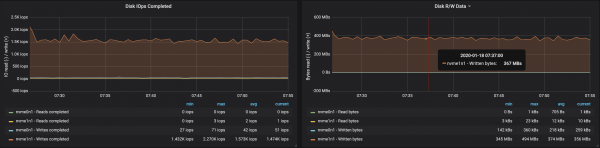
El trabajo de los brokers con los almacenadores se vio afectado por un desequilibrio de particiones:
Conclusiones
El enfoque iterativo presentado anteriormente se puede ampliar para abarcar escenarios más complejos que incluían cientos de consumidores, redistribución de particiones, actualizaciones graduales, reinicios de pods, etc. Todo esto nos permite evaluar los límites de las capacidades del clúster Kafka en diversas condiciones, identificar cuellos de botella en su funcionamiento y encontrar formas de abordarlos.
Hemos desarrollado Supertubes para el despliegue rápido y fácil de clústeres, su configuración, adición/eliminación de brokers y temas, respuesta a alertas y asegurar el correcto funcionamiento de Kafka en Kubernetes en general. Nuestro objetivo es ayudar a concentrarse en la tarea principal ("generar" y "consumir" mensajes de Kafka), mientras que todo el trabajo pesado se deja a Supertubes y al operador de Kafka.
Si te interesan las tecnologías y proyectos de código abierto de Banzai Cloud, sigue a la empresa en , o .
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
