

¡Hola, Habr! Me llamo Maxim Vasiliev, trabajo como analista y gerente de proyectos en FINCH. Hoy me gustaría contar cómo, gracias a ElasticSearch, pudimos procesar 15 millones de solicitudes en 6 minutos y optimizar la carga diaria en el sitio web de uno de nuestros clientes. Lamentablemente, no puedo mencionar nombres debido a que tenemos un NDA, pero espero que el contenido del artículo no se vea afectado. ¡Vamos allá!
Cómo está estructurado el proyecto
En nuestro backend, creamos servicios que garantizan el funcionamiento de los sitios web y la aplicación móvil de nuestro cliente. La estructura general se puede observar en el diagrama:
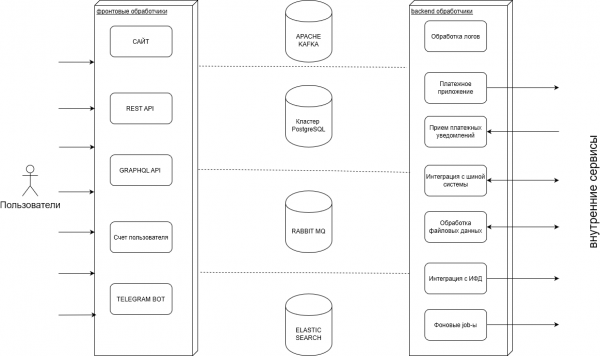
Durante el trabajo, procesamos una gran cantidad de transacciones: compras, pagos, operaciones con los saldos de los usuarios, sobre las cuales almacenamos muchos registros, además de importar y exportar estos datos a sistemas externos.
También hay procesos inversos, cuando recibimos datos del cliente y los transmitimos a los usuarios. Además, existen procesos relacionados con pagos y programas de bonificación.
Una breve historia
Inicialmente, utilizamos PostgreSQL como el único almacén de datos. Sus ventajas estándar para bases de datos: disponibilidad de transacciones, un lenguaje de consulta de datos avanzado, una amplia gama de herramientas de integración; en combinación con un buen rendimiento, satisfacían nuestras necesidades durante bastante tiempo.
Almacenamos absolutamente todos los datos en Postgres: desde transacciones hasta noticias. Pero el número de usuarios crecía, y con él, la cantidad de solicitudes.
Para ponerlo en perspectiva, el número anual de sesiones en 2017 solo en el sitio de escritorio fue de 131 millones. En 2018, fueron 125 millones. En 2019 nuevamente 130 millones. Si agregas otros 100-200 millones de la versión móvil del sitio y la aplicación móvil, obtendrás una enorme cantidad de solicitudes.
Con el crecimiento del proyecto, Postgres dejó de manejar la carga, no podíamos seguir el ritmo; había una gran cantidad de solicitudes diversas para las cuales no pudimos crear suficientes índices.
Nos dimos cuenta de que necesitábamos otros almacenes de datos que satisfacerían nuestras necesidades y aliviarían la carga de PostgreSQL. Consideramos como posibles opciones Elasticsearch y MongoDB. Este último perdía en los siguientes puntos:
- La velocidad de indexación es lenta con el crecimiento del volumen de datos en los índices. Con Elastic, la velocidad no depende del volumen de datos.
- No hay búsqueda de texto completo
Así que elegimos Elastic y nos preparamos para la migración.
Migración a Elastic
1. Comenzamos la migración desde el servicio de búsqueda de puntos de venta. Nuestro cliente tiene un total de aproximadamente 70,000 puntos de venta, y se requieren varios tipos de búsqueda en el sitio y la aplicación:
- Búsqueda por nombre de localidad
- Búsqueda geográfica dentro de un radio de un punto específico. Por ejemplo, si un usuario quiere ver qué puntos de venta están más cerca de su hogar.
- Búsqueda en un cuadrado definido: el usuario delimita un cuadrado en el mapa y se le muestran todos los puntos dentro de ese radio.
- Búsqueda por filtros adicionales. Los puntos de venta difieren entre sí por su surtido.
Si hablamos de la organización, en Postgres tenemos la fuente de datos tanto para el mapa como para las noticias, mientras que en Elastic se hacen instantáneas (Snapshots) de los datos originales. El problema es que inicialmente Postgres no podía manejar la búsqueda por todos los criterios. No solo había muchos índices, sino que también podían intersecarse, lo que confundía al planificador de Postgres, que no sabía qué índice utilizar.
2. El siguiente en la lista fue la sección de noticias. En el sitio, cada día aparecen publicaciones, y para que el usuario no se pierda en el flujo de información, los datos deben ser ordenados antes de la entrega. Para esto es necesaria la búsqueda: en el sitio se puede buscar por coincidencia de texto y, además, activar filtros adicionales, ya que también están hechos a través de Elastic.
3. Luego trasladamos el procesamiento de transacciones. Los usuarios pueden comprar ciertos productos en el sitio y participar en sorteos. Después de tales compras, procesamos una gran cantidad de datos, especialmente durante los fines de semana y festivos. A modo de comparación, si en días normales la cantidad de compras es de aproximadamente 1.5-2 millones, en festivos la cifra puede alcanzar los 53 millones.
A su vez, los datos deben ser procesados en el menor tiempo posible, ya que a los usuarios no les gusta esperar varios días por los resultados. A través de Postgres, no se pueden alcanzar esos plazos; a menudo recibíamos bloqueos y, mientras procesábamos todas las solicitudes, los usuarios no podían verificar si habían ganado o no. Esto no es muy agradable para el negocio, por lo que trasladamos el procesamiento a Elasticsearch.
Periodicidad
Ahora las actualizaciones están configuradas por eventos, bajo las siguientes condiciones:
- Puntos de venta. Tan pronto como recibimos datos de una fuente externa, iniciamos la actualización de inmediato.
- Noticias. En cuanto se edita una noticia en el sitio, se envía automáticamente a Elastic.
Aquí vale la pena reiterar las ventajas de Elastic. En Postgres, al enviar una solicitud, se debe esperar a que procese todas las entradas. En Elastic, se puede enviar 10,000 entradas y comenzar a trabajar de inmediato, sin esperar a que los datos se distribuyan entre todos los Shards. Por supuesto, algún Shard o Réplica puede no ver los datos de inmediato, pero pronto estará todo disponible.
Métodos de integración
Hay 2 métodos de integración con Elastic:
- A través del cliente nativo por TCP. El controlador nativo está quedando obsoleto: ha dejado de ser soportado y tiene una sintaxis muy incómoda. Por eso, prácticamente no lo usamos y tratamos de abandonarlo por completo.
- A través de la interfaz HTTP, en la que se pueden usar tanto solicitudes JSON como la sintaxis Lucene. Esta última es el motor de texto que utiliza Elastic. En esta modalidad, obtenemos la posibilidad de Batch a través de solicitudes JSON por HTTP. Precisamente esta opción tratamos de utilizar.
Gracias a la interfaz HTTP, podemos utilizar bibliotecas que ofrecen una implementación asíncrona del cliente HTTP. Podemos aprovechar Batch y la API asíncrona, lo que finalmente proporciona un alto rendimiento, que fue muy útil en los días de las grandes promociones (sobre esto más adelante)
Un poco de cifras para comparar:
- Guardar usuarios que recibieron premios en Postgres en 20 hilos sin agrupaciones: 460,713 registros en 42 segundos
- Elastic + cliente reactivo en 10 hilos + batch de 1000 elementos: 596,749 registros en 11 segundos
- Elastic + cliente reactivo en 10 hilos + batch de 1000 elementos: 23,801,684 registros en 4 minutos
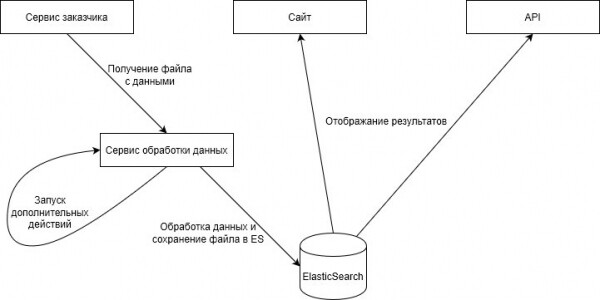
Ahora hemos escrito un gestor de solicitudes por HTTP que construye JSON, como Batch/no Batch y envía a través de cualquier cliente HTTP independientemente de la biblioteca. También se puede elegir enviar solicitudes de forma sincrónica o asíncrona.
En algunas integraciones, todavía usamos el transport client oficial, pero esto es solo cuestión de un próximo refactor. Para el procesamiento se utiliza un cliente propio, basado en Spring WebClient.
Gran promoción
Una vez al año, el proyecto organiza una gran promoción para los usuarios. Este es el verdadero Highload, ya que durante este tiempo trabajamos con decenas de millones de usuarios simultáneamente.
Normalmente, los picos de carga ocurren en días festivos, pero esta promoción es de un nivel completamente diferente. En el año anterior, durante el día de la promoción, vendimos 27,580,890 unidades de producto. Los datos fueron procesados durante más de media hora, lo que provocó inconvenientes para los usuarios. Los participantes recibieron premios, pero quedó claro que el proceso necesitaba ser acelerado.
A principios de 2019, decidimos que necesitábamos ElasticSearch. Durante un año, organizamos el procesamiento de los datos recibidos en Elastic y su entrega a la API de la aplicación móvil y al sitio web. Como resultado, al año siguiente, durante la promoción, procesamos 15,131,783 registros en 6 minutos.
Dado que hay muchas personas interesadas en comprar productos y participar en el sorteo de premios, esta es una medida temporal. En este momento, estamos enviando información actual a Elastic, pero en el futuro planeamos trasladar la información histórica de los meses pasados a Postgres, como almacenamiento permanente. Esto evitará saturar el índice de Elastic, que también tiene sus propias limitaciones.
Conclusión/Conclusiones
Actualmente, hemos trasladado todos los servicios que queríamos a Elastic y por ahora hemos hecho una pausa en eso. Ahora, sobre el almacenamiento persistente principal en Postgres, estamos construyendo un índice en Elastic que asume la carga de los usuarios.
En el futuro, planeamos trasladar servicios si entendemos que la solicitud de datos se vuelve demasiado variada y busca en un número ilimitado de columnas. Esa ya no es una tarea para Postgres.
Si necesitamos búsqueda de texto completo en la funcionalidad o si tenemos muchos criterios de búsqueda diversos, ya sabemos que eso debe ser trasladado a Elastic.
⌘⌘⌘
Gracias por leer. Si en su empresa también utilizan ElasticSearch y tienen sus propios casos de implementación, compártanlo. Será interesante conocer cómo lo hacen otros 🙂
Fuente: habr.com
