

¿Qué puede llevar a una empresa tan grande como Lamoda, con un proceso afinado y decenas de servicios interrelacionados, a cambiar su enfoque de manera significativa? La motivación puede ser muy diversa: desde cuestiones legislativas hasta el deseo de experimentar que caracteriza a todos los programadores.
Pero eso no significa en absoluto que no se pueda contar con beneficios adicionales. Sergey Zaika explicará en qué se puede ganar específicamente si se implementa un API orientado a eventos en Kafka,). También habrá historias sobre errores cometidos y descubrimientos interesantes; no puede haber experimentación sin ellos.
Descargo de responsabilidad: Este artículo se basa en los materiales de un meetup que Sergey realizó en noviembre de 2018 en HighLoad++. La experiencia viva de Lamoda trabajando con Kafka atrajo a la audiencia tanto como otras conferencias en la programación. Nos parece un excelente ejemplo de que siempre se pueden y deben encontrar personas afines, y los organizadores de HighLoad++ seguirán esforzándose por crear un ambiente que lo facilite.
Sobre el proceso
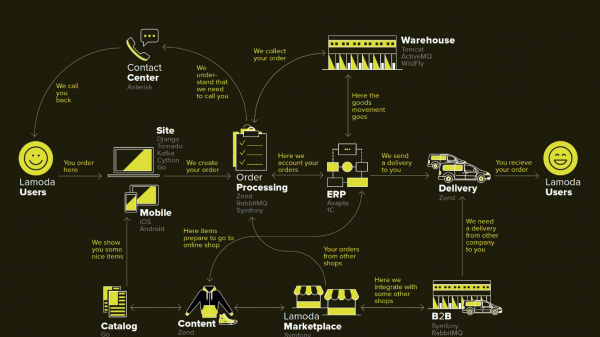
Lamoda es una gran plataforma de comercio electrónico que cuenta con su propio centro de contacto, servicio de entrega (y muchos socios), estudio fotográfico, un enorme almacén y todo esto opera con su propio software. Existen decenas de métodos de pago, socios B2B que pueden utilizar parte o todos estos servicios y quieren conocer información actual sobre sus productos. Además, Lamoda opera en tres países además de Rusia, y allí todo funciona un poco diferente. En total, probablemente hay más de un centenar de maneras de configurar un nuevo pedido, que debe ser procesado de manera particular. Todo esto funciona a través de decenas de servicios que a veces se comunican de manera no obvia. También hay un sistema central cuya principal responsabilidad son los estados de los pedidos. Lo llamamos BOB, y yo trabajo con él.
Herramienta de reembolso con API orientada a eventos
La palabra orientada a eventos está bastante desgastada; más adelante definiremos en detalle a qué nos referimos con esto. Comenzaré con el contexto en el que decidimos probar el enfoque de API orientada a eventos en Kafka.
En cualquier tienda, además de los pedidos que los clientes pagan, hay momentos en que se requiere que la tienda devuelva dinero, porque el producto no le convenía al cliente. Este proceso relativamente corto implica confirmar la información, si es necesario, y transferir el dinero.
Sin embargo, el proceso de devolución se ha complicado debido a cambios en la legislación, y hemos tenido que implementar un microservicio separado para ello.
Nuestra motivación:
- Ley FZ-54 — en resumen, la ley exige informar a la agencia fiscal sobre cada operación monetaria, ya sea una devolución o un ingreso, en un SLA bastante corto de unos minutos. Nosotros, como e-commerce, realizamos un gran número de operaciones. Técnicamente esto significa una nueva responsabilidad (y, por lo tanto, un nuevo servicio) y ajustes en todos los sistemas implicados.
- BOB split — es un proyecto interno de la empresa para liberar a BOB de un gran número de responsabilidades no esenciales y reducir su complejidad general.
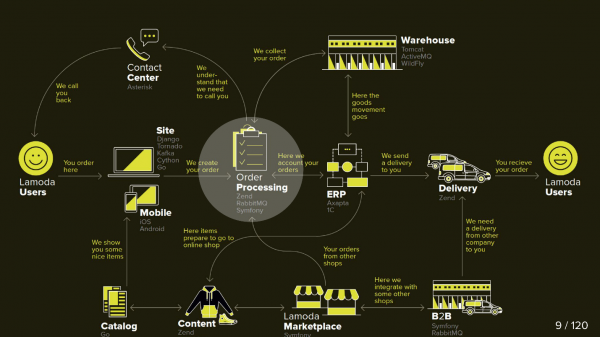
En este diagrama se muestran los principales sistemas de Lamoda. Actualmente, la mayoría de ellos son más bien un conjunto de 5-10 microservicios alrededor de un monolito en reducción. Están creciendo lentamente, pero tratamos de hacerlos menos numerosos, porque desplegar un fragmento aislado en medio es aterrador: no se puede permitir que falle. Todos los intercambios (las flechas) debemos reservarlos y asumir que cualquiera de ellos puede volverse inaccesible.
En BOB también hay bastantes intercambios: sistemas de pago, entrega, notificaciones, etc.
Técnicamente, BOB es:
- ~150k líneas de código + ~100k líneas de pruebas;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 integraciones salientes;
- 4 países con su lógica de negocio.
Desplegar BOB es costoso y doloroso, la cantidad de código y las tareas que resuelve son tales que nadie puede retenerlo en su mente completamente. En general, hay muchas razones para simplificarlo.
Proceso de devolución
Inicialmente, el proceso involucra dos sistemas: BOB y Payment. Ahora aparecen otros dos:
- Fiscalization Service, que asumirá los problemas de fiscalización y la comunicación con los servicios externos.
- Refund Tool, donde simplemente se trasladan nuevos intercambios, para no inflar a BOB.
Ahora el proceso se ve así:
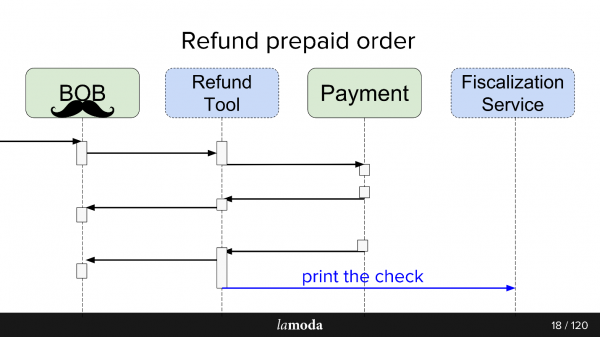
- BOB recibe una solicitud de reembolso.
- BOB informa de esto a Refund Tool.
- Refund Tool indica a Payment: «Devuelve el dinero».
- Payment devuelve el dinero.
- Refund Tool y BOB sincronizan sus estados entre sí, porque por ahora ambos lo necesitan. Aún no estamos listos para cambiar completamente a Refund Tool, ya que en BOB hay una interfaz de usuario, informes para contabilidad, y en general muchos datos que no se transfieren tan fácilmente. Tenemos que estar en dos lugares a la vez.
- Se envía una solicitud para fiscalizar.
Al final, hemos creado un bus de eventos en Kafka, en el que todo está interconectado. Hurra, ahora tenemos un único punto de falla (sarcasmo).
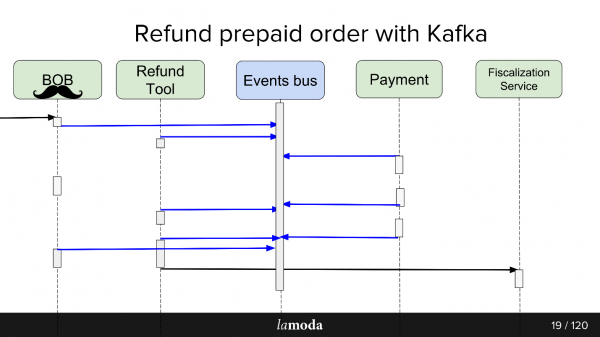
Los pros y los contras son bastante evidentes. Hicimos el bus, por lo que ahora todos los servicios dependen de él. Esto simplifica el diseño, pero introduce un único punto de falla en el sistema. Si Kafka cae, el proceso se detiene.
Qué es una API impulsada por eventos
Una buena respuesta a esta pregunta se encuentra en la presentación de Martin Fowler (GOTO 2017) .
En resumen, lo que hicimos:
- Enrollamos toda la comunicación asincrónica a través de almacenamiento de eventos. En lugar de informar a cada consumidor interesado a través de la red sobre el cambio de estado, escribimos en un repositorio centralizado un evento sobre el cambio de estado, y los consumidores interesados en el tema leen todo lo que aparece allí.
- Un evento en este caso es una notificación (notifications) de que algo ha cambiado en algún lugar. Por ejemplo, el estado de un pedido cambió. Un consumidor que necesita algunos datos adicionales relacionados con el cambio de estado y que no están en la notificación puede averiguar su estado por sí mismo.
- La opción máxima es una fuente de eventos completa, transferencia de estado, en la que el evento contiene toda la información necesaria para el procesamiento: de dónde y en qué estado pasaron, cómo exactamente cambiaron los datos, etc. La única cuestión es la viabilidad y el volumen de información que puede permitirse almacenar.
En el marco del lanzamiento de Refund Tool, utilizamos la tercera opción. Esto simplificó el procesamiento de eventos, ya que no era necesario obtener información detallada, además de que eliminó el escenario en el que cada nuevo evento genera una oleada de solicitudes get de aclaración de los consumidores.
El servicio Refund Tool no está sobrecargado, por lo que Kafka allí es más una prueba que una necesidad. No creo que, si el servicio de reembolso se convirtiera en un proyecto de alta carga, la empresa estaría satisfecha.
Intercambio asíncrono tal cual
Para intercambios asíncronos, el departamento de PHP suele utilizar RabbitMQ. Reunimos datos para la solicitud, los colocamos en la cola, y el consumidor de ese mismo servicio los leyó y los envió (o no los envió). Para la propia API, Lamoda utiliza activamente Swagger. Diseñamos la API, la describimos en Swagger, generamos el código del cliente y del servidor. También utilizamos un JSON RPC 2.0 ligeramente ampliado.
En algunos lugares se utilizan buses ESB, algunos operan con ActiveMQ, pero en general, RabbitMQ — estándar.
Intercambio asíncrono A SER
Al diseñar el intercambio a través del events-bus, se tiene una analogía. Describimos de manera similar el intercambio futuro de datos a través de las descripciones de la estructura del evento. El formato YAML, la generación de código tuvo que hacerse nosotros mismos, el generador según la especificación crea DTO y enseña a los clientes y servidores a trabajar con ellos. La generación se realiza en dos lenguajes — golang y php. Esto permite mantener las bibliotecas alineadas. El generador está escrito en golang, por lo que recibió el nombre de gogi.
El event-sourcing en Kafka es algo típico. Hay una solución de la versión enterprise principal de Kafka Confluent, hay , una solución de nuestros "hermanos" en el dominio de Zalando. Nuestra motivación para comenzar con vanilla Kafka es mantener la solución gratuita, mientras decidimos finalmente si la utilizaremos de manera generalizada, así como dejarnos espacio para maniobras y mejoras: queremos soporte para nuestro JSON RPC 2.0, generadores para dos lenguajes y veremos qué más.
Irónicamente, incluso en un caso tan afortunado, cuando hay un negocio similar a Zalando que ha hecho una solución similar, no podemos utilizarlo de manera efectiva.
Arquitectónicamente, en el inicio, el patrón es el siguiente: leemos directamente de Kafka, pero escribimos solo a través del events-bus. Para la lectura en Kafka hay mucho listo: brokers, balanceadores y está más o menos preparado para el escalado horizontal, esto quería conservarse. Sin embargo, quisimos envolver la escritura a través de un Gateway, también conocido como Events-bus, y aquí está el porqué.
Events-bus
O autobús de eventos. Es simplemente un gateway http sin estado, que asume varios roles importantes:
- Validación de producción — verificamos que los eventos cumplen con nuestra especificación.
- Sistema maestro de eventos, es decir, es el único sistema principal en la empresa que responde a la pregunta de qué eventos con qué estructuras se consideran válidos. La validación incluye simplemente tipos de datos y enums para una especificación rígida del contenido.
- Función hash para el sharding — la estructura del mensaje Kafka es de clave-valor y el hash de la clave se utiliza para calcular dónde colocar esto.
Por qué
Trabajamos en una gran empresa con un proceso bien establecido. ¿Por qué cambiar algo? Es un experimento, y esperamos obtener algunas ventajas.
Intercambios 1:n+1 (uno a muchos)
Es muy sencillo conectar nuevos consumidores al API con Kafka.
Supongamos que tienes un directorio que necesitas mantener actualizado en varios sistemas a la vez (y en algunos nuevos). Antes inventamos un bundle que implementaba un set-API, y a la sistema maestra le comunicábamos las direcciones de los consumidores. Ahora, la sistema maestra envía actualizaciones a un tópico, y todos los interesados lo leen. Ha aparecido un nuevo sistema: lo hemos suscrito al tópico. Sí, también es un bundle, pero más sencillo.
En el caso de refund-tool, que es una pieza de BOB, nos resulta conveniente mantenerlos sincronizados a través de Kafka. Payment dice que el dinero ha sido devuelto: BOB y RT se enteran de esto, cambian sus estados, y el Servicio de Fiscalización se entera y emite el recibo.
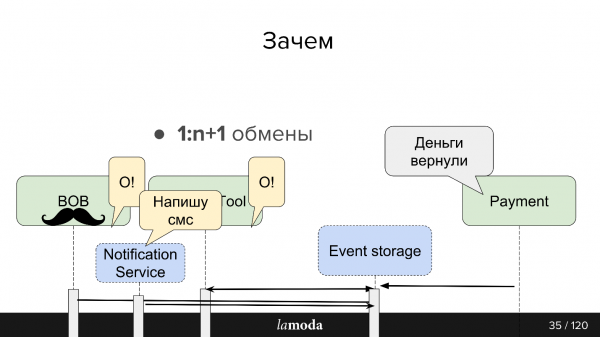
Tenemos planes de hacer un único Servicio de Notificaciones que avise al cliente sobre las novedades en su pedido/devoluciones. Actualmente, esta responsabilidad está repartida entre sistemas. Nos bastará con enseñar al Servicio de Notificaciones a captar información relevante de Kafka y a reaccionar a ella (y desactivar estas notificaciones en los demás sistemas). No se requerirán intercambios directos nuevos.
Impulsado por datos
La información entre sistemas se vuelve transparente, sin importar cuán 'sangriento' sea tu 'enterprise' ni cuán numeroso sea tu backlog. En Lamoda hay un departamento de Análisis de Datos que recopila información de los sistemas y la transforma en un formato reutilizable, tanto para el negocio como para sistemas inteligentes. Kafka permite proporcionarles rápidamente muchos datos y mantener este flujo de información actualizado.
Registro de replicación
Los mensajes no desaparecen después de ser leídos, como en RabbitMQ. Cuando un evento contiene suficiente información para el procesamiento, tenemos un historial de los últimos cambios en el objeto y, si se desea, la posibilidad de aplicar esos cambios.
El tiempo de almacenamiento del registro de replicación depende de la intensidad de las escrituras en este tópico; Kafka permite configurar flexiblemente los límites de tiempo de almacenamiento y en cuanto al volumen de datos. Para los tópicos intensivos, es importante que todos los consumidores puedan leer la información antes de que desaparezca, incluso en caso de un breve período de inactividad. Generalmente se logra almacenar datos por unidades de días, lo cual es suficiente para el soporte.
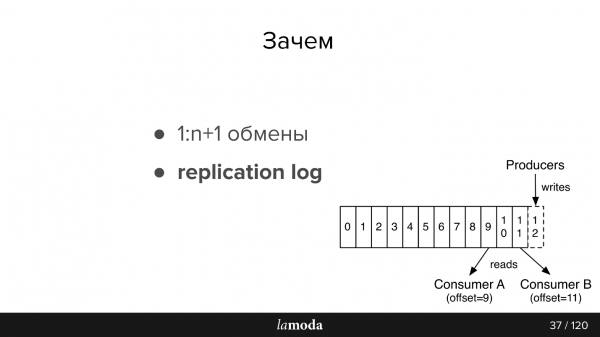
A continuación, un pequeño resumen de la documentación, para aquellos que no están familiarizados con Kafka (la imagen también es de la documentación)
En AMQP hay colas: escribimos mensajes en la cola para el consumidor. Por lo general, una cola es procesada por un solo sistema con la misma lógica de negocio. Si es necesario notificar a varios sistemas, se puede enseñar a la aplicación a escribir en varias colas o configurar un exchange con un mecanismo fanout, que las clona automáticamente.
En Kafka hay una abstracción similar tema, en el que escribes mensajes, pero no desaparecen después de ser leídos. Por defecto, al conectarte a Kafka, recibes todos los mensajes y hay la posibilidad de guardar la ubicación donde te detuviste. Es decir, lees de manera secuencial, puedes no marcar el mensaje como leído, pero guardar el id desde el cual luego continuarás leyendo. El id donde te detuviste se llama offset, y el mecanismo es commit offset.
Por lo tanto, se puede implementar lógica diferente. Por ejemplo, tenemos BOB en 4 instancias para diferentes países: Lamoda está en Rusia, Kazajistán, Ucrania y Bielorrusia. Dado que se despliegan por separado, tienen un poco de su propia configuración y lógica de negocio. Indicamos en el mensaje a qué país pertenece. Cada consumidor BOB en cada país lee con diferentes groupId, y si el mensaje no le corresponde, lo omite, es decir, comitea directamente offset +1. Si el mismo tema es leído por nuestro Servicio de Pagos, lo hace con un grupo separado, por lo que los offsets no se cruzan.
Requisitos para eventos:
- Integridad de los datos. Me gustaría que el evento contuviera suficientes datos para poder procesarlo.
- Integralidad. Delegamos al Events-bus la verificación de que el evento es consistente y que puede procesarlo.
- El orden es importante. En el caso de devoluciones, tenemos que trabajar con el historial. Con las notificaciones, el orden no es importante si son notificaciones homogéneas, el email será el mismo sin importar cuál pedido llegó primero. En el caso de las devoluciones, hay un proceso claro; si se cambia el orden, surgirán excepciones, no se creará o procesará el reembolso, y caeremos en otro estado.
- Consistencia. Tenemos un almacenamiento y ahora, en lugar de API, estamos creando eventos. Necesitamos una forma de transmitir rápida y económicamente información sobre nuevos eventos y cambios en los ya existentes a nuestros servicios. Esto se logra mediante una especificación común en un repositorio git separado y generadores de código. Por lo tanto, los clientes y servidores en diferentes servicios están coordinados.
Kafka en Lamoda
Tenemos tres instalaciones de Kafka:
- Logs;
- I+D;
- Bus de eventos.
Hoy solo hablaremos del último punto. En el bus de eventos no tenemos instalaciones muy grandes: 3 brokers (servidores) y solo 27 temas. Como regla general, un tema es un proceso. Pero este es un detalle sutil que ahora abordaremos.
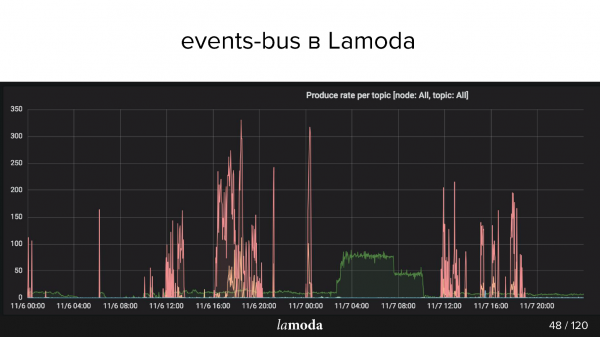
Arriba está el gráfico de rps. El proceso de reembolsos está marcado con una línea turquesa (sí, esa que está en el eje X) y el proceso de actualización de contenido está marcado en rosa.
El catálogo de Lamoda contiene millones de productos, y los datos se actualizan constantemente. Algunas colecciones quedan fuera de moda y se lanzan nuevas en su reemplazo; nuevos modelos aparecen continuamente en el catálogo. Intentamos predecir qué será interesante para nuestros clientes mañana, por lo que constantemente compramos nuevas cosas, las fotografiamos y actualizamos nuestra vitrina.
Los picos rosas son actualizaciones de productos, es decir, cambios en los productos. Se puede ver que el equipo estaba tomando muchas fotos, y luego, ¡zas! — se cargó un montón de eventos.
Casos de uso de eventos de Lamoda
La arquitectura construida la utilizamos para las siguientes operaciones:
- Seguimiento de estados de devoluciones: call-to-action y seguimiento de estados de todos los sistemas involucrados. Pagos, estados, fiscalización, notificaciones. Aquí hemos probado un enfoque, creamos herramientas, recopilamos todos los errores, escribimos documentación y contamos a los colegas cómo usarlas.
- Actualización de fichas de productos: configuración, metadatos y características. Un sistema lee (el que muestra), y varios escriben.
- Email, push y sms: el pedido se ha reunido, el pedido ha llegado, la devolución ha sido aceptada, etc., hay muchos.
- Inventario, actualización de stock — actualización cuantitativa de artículos, solo números: llegada a stock, devolución. Es necesario que todos los sistemas relacionados con la reserva de productos operen con datos lo más actualizados posible. Actualmente, el sistema de actualización de stock es bastante complejo; Kafka permitirá simplificarlo.
- Análisis de datos (Departamento de I+D), herramientas de ML, análisis, estadísticas. Queremos que la información sea transparente, y para eso Kafka es una buena opción.
Ahora, pasemos a la parte más interesante sobre los golpes y los descubrimientos interesantes que han ocurrido en medio año.
Problemas de diseño
Supongamos que queremos crear algo nuevo, por ejemplo, trasladar todo el proceso de entrega a Kafka. Actualmente, parte del proceso se implementa en el Order Processing en BOB. Tras la transmisión del pedido al servicio de entrega, movimiento al almacén intermedio y demás, hay un modelo de estado. Hay un monolito entero, incluso dos, más un montón de API dedicadas a la entrega. Ellos saben mucho más sobre la entrega.
Parece que estas son áreas similares, pero para el Order Processing en BOB y para el sistema de entrega, los estados son diferentes. Por ejemplo, algunos servicios de mensajería no envían estados intermedios, solo finales: 'entregado' o 'perdido'. Otros, en cambio, informan detalladamente sobre el movimiento del producto. Todos tienen sus propias reglas de validación: para algunos, si el correo electrónico es válido, entonces lo procesarán; para otros, es no válido, pero el pedido se procesará de todos modos porque hay un teléfono para contacto, y algunos dirán que tal pedido no se procesará en absoluto.
Flujo de datos
En el caso de Kafka surge la cuestión de la organización del flujo de datos. Esta tarea está relacionada con la elección de estrategias en varios puntos, vamos a revisarlos todos.
¿En un topic o en varios?
Tenemos una especificación del evento. En BOB escribimos que un pedido determinado debe ser entregado, y especificamos: número de pedido, su contenido, algunos SKU y códigos de barras, etc. Cuando el producto llegue al almacén, la entrega podrá recibir estados, timestamps y todo lo necesario. Pero luego queremos recibir actualizaciones sobre estos datos en BOB. Se plantea un proceso inverso de obtención de datos de la entrega. ¿Es el mismo evento? ¿O es un intercambio separado que merece un topic separado?
Lo más probable es que sean muy similares, y la tentación de crear un solo topic es comprensible, porque un topic separado significa consumidores separados, configuraciones separadas, generación separada de todo esto. Pero no es un hecho.
¿Un nuevo campo o un nuevo evento?
Pero si utilizamos los mismos eventos, surge otro problema. Por ejemplo, no todos los sistemas de entrega pueden generar un DTO que pueda generar BOB. Les enviamos un id, pero ellos no lo guardan, porque no lo necesitan, y desde el punto de vista del inicio del proceso de event-bus, este campo es obligatorio.
Si establecemos para el event-bus que este campo es obligatorio, nos vemos obligados a introducir reglas adicionales de validación en BOB o en el manejador del evento inicial. La validación comienza a proliferar por el servicio, lo que no es muy conveniente.
Otro problema es la tentación del desarrollo incremental. Nos dicen que necesitamos añadir algo al evento, y, tal vez, si lo pensamos bien, debería haber sido un evento separado. Pero en nuestro esquema, un evento separado es un tópico separado. Un tópico separado implica todo el proceso que describí anteriormente. El desarrollador se siente tentado a simplemente agregar otro campo al esquema JSON y regenerar.
En el caso de refunds, en seis meses llegamos a un evento de eventos. Teníamos un metaevento llamado refund update, que incluía un campo type, describiendo en qué consistía realmente esta actualización. A partir de eso, teníamos "hermosos" switches con validadores que indicaban cómo se debía validar este evento con este type.
Versionado de eventos
Para validar mensajes en Kafka, se puede utilizar , pero había que tener eso en cuenta desde el principio y utilizar Confluent. En nuestro caso con el versionado, hay que ser cauteloso. No siempre será posible volver a leer los mensajes del replication log, porque el modelo "se fue". En general, se construyen versiones de tal manera que el modelo sea retrocompatible: por ejemplo, hacer que un campo sea temporalmente no obligatorio. Si las diferencias son demasiado grandes, comenzamos a escribir en un nuevo tópico, y trasladamos a los clientes cuando hayan terminado de leer el viejo.
Garantía de orden de lectura de las partitions
Los tópicos dentro de Kafka se dividen en partitions. Esto no es muy importante mientras diseñemos entidades e intercambios, pero es crucial cuando decidimos cómo consumir y escalar.
En circunstancias normales, escribes a un único tópico en Kafka. Por defecto, se utiliza una sola partición, y todos los mensajes de este tópico caen en ella. El consumidor, a su vez, lee esos mensajes de forma secuencial. Supongamos que ahora es necesario expandir el sistema para que dos consumidores diferentes lean los mensajes. Si, por ejemplo, estás enviando un SMS, puedes decirle a Kafka que haga una partición adicional, y Kafka comenzará a repartir los mensajes en dos partes: mitad aquí, mitad allí.
¿Cómo los divide Kafka? Cada mensaje tiene un cuerpo (donde almacenamos el JSON) y tiene una clave. A esta clave se le puede aplicar una función hash, que determinará en qué partición caerá el mensaje.
En nuestro caso con los reembolsos, esto es importante, ya que si tomamos dos particiones, existe la posibilidad de que un consumidor paralelo procese el segundo evento antes que el primero, lo que podría causar problemas. La función hash garantiza que los mensajes con la misma clave caerán en la misma partición.
Eventos vs comandos
Este es otro problema con el que nos encontramos. Un evento es un cierto suceso: decimos que algo ocurrió (something_happened), por ejemplo, que un artículo fue cancelado o que ocurrió un reembolso. Si hay alguien escuchando estos eventos, cuando se produzca "el artículo fue cancelado", se creará la entidad de reembolso, y "ocurrió un reembolso" se registrará en alguna parte de las configuraciones.
Pero generalmente, cuando diseñas eventos, no quieres escribirlos en vano: esperas que alguien los lea. Existe una fuerte tentación de no escribir something_happened (item_canceled, refund_refunded), sino algo como something_should_be_done. Por ejemplo, el artículo está listo para el retorno.
Por un lado, esto sugiere cómo se utilizará el evento. Por otro lado, se parece mucho menos a un nombre normal de evento. Además, de aquí ya no está lejos el comando do_something. Pero no tienes garantía de que este evento sea leído por alguien; y si es leído, no hay garantía de que se haya leído correctamente; y si se leyó correctamente, no hay seguridad de que se haya hecho algo, y que ese algo haya tenido éxito. En el momento en que el evento se convierte en do_something, se necesita retroalimentación, y este es un problema.
En el intercambio asincrónico en RabbitMQ, cuando lees un mensaje, vas a HTTP, y tienes una respuesta: al menos que el mensaje fue recibido. Cuando escribes en Kafka, existe un mensaje que indica que escribiste en Kafka, pero no sabes nada sobre cómo fue procesado.
Por lo tanto, en nuestro caso tuvimos que introducir un evento de respuesta y configurar la monitorización para que, si se produjeron cierta cantidad de eventos, dentro de un tiempo determinado debería llegar la misma cantidad de eventos de respuesta. Si esto no sucedió, parece que algo salió mal. Por ejemplo, si enviamos el evento «item_ready_to_refund», esperamos que se genere un reembolso, que se devuelvan los fondos al cliente y que tengamos el evento «money_refunded». Pero esto no es seguro, por lo que se necesita monitorización.
Matices
Hay un problema bastante obvio: si estás leyendo de un tópico de forma secuencial y tienes un mensaje que es malo, el consumidor falla y no puedes avanzar. Necesitas detener todos los consumidores, confirmar el offset para poder continuar leyendo.
Sabíamos de esto, nos preparamos para ello, y aun así ocurrió. Esto sucedió porque el evento era válido desde la perspectiva del events-bus, el evento era válido desde la perspectiva del validador de la aplicación, pero no era válido desde la perspectiva de PostgreSQL, porque en un sistema teníamos MySQL con UNSIGNED INT, y en el nuevo sistema solo había PostgreSQL con INT. Este último tiene un tamaño un poco menor y el Id no cabía. Symfony murió con una excepción. Por supuesto, capturamos la excepción, porque estábamos preparados para ello, y estábamos planeando confirmar este offset, pero antes queríamos incrementar el contador de problemas, dado que el mensaje se procesó de manera fallida. Los contadores en este proyecto también se almacenan en la base de datos, y Symfony ya había cerrado la comunicación con la base de datos, y otra excepción mató todo el proceso sin posibilidad de confirmar el offset.
El servicio estuvo inactivo por un tiempo; afortunadamente, con Kafka no es tan grave, porque los mensajes permanecen. Cuando se reanude el trabajo, se podrán leer. Esto es conveniente.
Kafka tiene la posibilidad, a través de herramientas, de establecer un offset arbitrario. Pero para hacerlo, es necesario detener todos los consumidores; en nuestro caso, preparar un lanzamiento separado en el que no haya consumidores ni reasignaciones. Entonces, a través de herramientas, se puede mover el offset en Kafka y el mensaje pasará.
Otro matiz es replication log vs rdkafka.so — está relacionado con la especificidad de nuestro proyecto. Usamos PHP, y en PHP, por lo general, todas las bibliotecas se comunican con Kafka a través del repositorio rdkafka.so, y luego hay algún tipo de envoltura. Puede que sean nuestras dificultades personales, pero resultó que simplemente releer un fragmento ya leído no es tan sencillo. En general, tuvimos problemas de programación.
Volviendo a las características del trabajo con partitions, está escrito directamente en la documentación. consumers >= topic partitions. Pero supe de esto mucho después de lo que me gustaría. Si deseas escalar y tener dos consumidores, necesitas al menos dos partitions. Es decir, si tenías una partition en la que se acumularon 20,000 mensajes y creaste una fresca, el número de mensajes no se equilibrará rápidamente. Por lo tanto, para tener dos consumidores en paralelo, debes comprender cómo funcionan las partitions.
Monitoreo
Creo que, según monitoreamos, será aún más claro qué problemas hay en el enfoque actual.
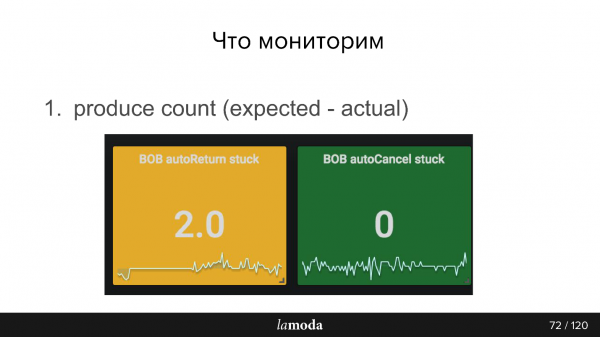
Por ejemplo, contamos cuántos productos en la base han cambiado recientemente su estado, y, por ende, a partir de estos cambios deberían haber ocurrido eventos, y enviamos este número a nuestro sistema de monitoreo. Luego, de Kafka recibimos un segundo número, cuántos eventos se registraron realmente. Obviamente, la diferencia entre estos dos números siempre debería ser cero.
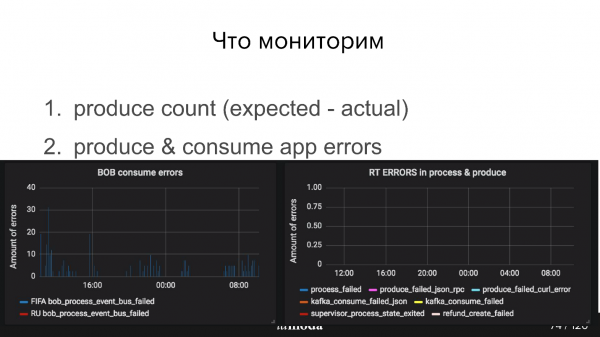
Además, es necesario monitorear cómo está el productor, si el events-bus ha recibido los mensajes y cómo está el consumidor. Por ejemplo, en los gráficos de abajo, todo está bien con el Refund Tool, pero claramente hay algunos problemas con BOB (picos azules).
Ya mencioné el consumer-group lag. En términos simples, es la cantidad de mensajes no leídos. En general, nuestros consumidores trabajan rápido, así que el lag suele ser 0, pero a veces puede haber un pico temporal. Kafka lo maneja de forma predeterminada, pero es necesario establecer un intervalo.
Hay un proyecto , que te dará más información sobre Kafka. Simplemente a través de la API, te proporciona el estado de cada grupo de consumidores respecto a cómo va ese grupo. Además de OK y Failed, hay advertencias, y podrás saber si tus consumidores no están manejando el ritmo de producción: no logran procesar lo que se escribe. El sistema es bastante inteligente y es fácil de usar.
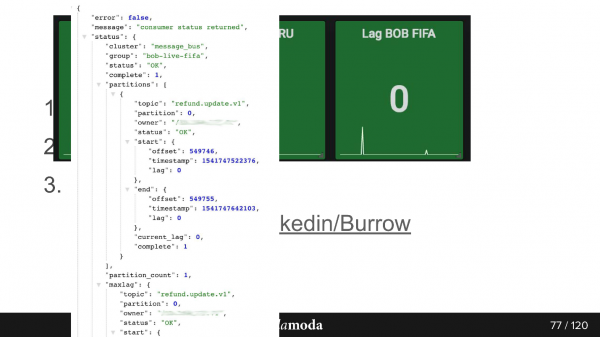
Así se ve la respuesta de la API. Aquí el grupo bob-live-fifa, partition refund.update.v1, estado OK, lag 0 — el último offset final es tal.
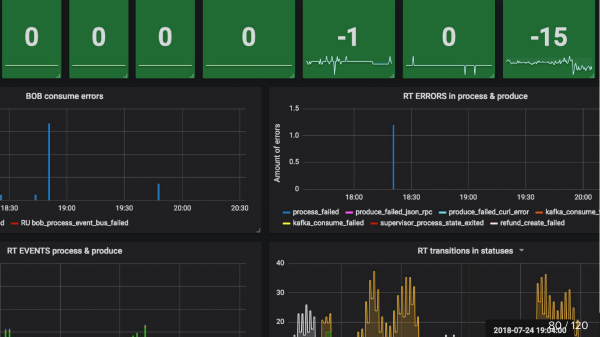
Monitoreo updated_at SLA (atrapado) Ya mencioné anteriormente. Por ejemplo, un producto ha pasado al estado de estar listo para la devolución. Configuramos un Cron que indica que si en 5 minutos este objeto no ha pasado a refund (devolvemos el dinero a través de los sistemas de pago muy rápido), entonces algo definitivamente ha salido mal y es un caso para soporte. Así que simplemente utilizamos un Cron que lee tales situaciones, y si son más de 0, envía una alerta.
En resumen, es conveniente utilizar eventos cuando:
- la información es necesaria para varios sistemas;
- el resultado del procesamiento no es importante;
- hay pocos eventos o son eventos pequeños.
A primera vista, el artículo tiene un tema muy específico: API asíncrono en Kafka, pero sobre él me gustaría recomendar muchas cosas desde el principio.
En primer lugar, el siguiente no hay que esperar hasta noviembre, habrá una versión en San Petersburgo en abril y en junio hablaremos sobre cargas altas en Novosibirsk.
En segundo lugar, el autor del informe, Sergey Zaika, es miembro del Comité Programático de nuestra nueva conferencia sobre gestión del conocimiento. La conferencia es de un día, tendrá lugar el 26 de abril, y su programa es muy completo.
Además, en mayo habrá y (con DevOpsConf en el programa) — todavía se pueden presentar propuestas, compartir experiencias y quejarse de sus errores cometidos.
Fuente: habr.com
