

Cualquier gran proyecto comenzó con un par de servidores. Primero hubo un servidor de base de datos, luego se añadieron esclavos para escalar la lectura. Y aquí—¡alto! Hay un maestro y muchos esclavos; si uno de los esclavos se va, todo estará bien, pero si el maestro se va, será un problema: tiempo de inactividad, los administradores se apresuran a levantar el servidor. ¿Qué hacer? Reservar el maestro. Mi colega Pavel ya ha escrito sobre esto , no lo repetiré. En su lugar, les contaré por qué necesitan un Orchestrator para MySQL.
Comencemos con la pregunta principal: "¿Cómo vamos a cambiar el código a la nueva máquina cuando el maestro se vaya?".
- El esquema con VIP (IP Virtual) es el que más me gusta, y de eso hablaremos a continuación. Es el más sencillo y evidente, aunque tiene una limitación clara: el maestro que vamos a reservar debe estar en el segmento L2 con la nueva máquina, es decir, se puede olvidar del segundo centro de datos. Además, si seguimos la regla de que un gran L2 es un mal, porque el L2 solo va en la estantería, y entre estanterías es L3, un esquema así tiene aún más limitaciones.
- Se puede escribir el nombre DNS en el código y resolverlo a través de /etc/hosts. En realidad, no habrá resolución. La ventaja del esquema es que no hay la limitación que caracteriza al primer método, es decir, se puede organizar incluso cross-Datacenter. Pero entonces surge la pregunta obvia, ¿qué tan rápido llevaremos el cambio a /etc/hosts a través de Puppet-Ansible?
- Se puede modificar un poco el segundo método: en todos los servidores web instalamos DNS caché, por el cual el código consultará la base de datos maestro. Se puede establecer un TTL de 60 para este registro en DNS. Parece que con la implementación correcta el método es bueno.
- El esquema con descubrimiento de servicios, que implica el uso de Consul y etcd.
- Una variante interesante con . Se debe redirigir todo el tráfico a MySQL a través de ProxySQL, que puede determinar quién es actualmente el maestro. De hecho, se puede leer sobre una de las variantes de uso de este producto en mi .
El autor de Orchestrator, trabajando en Github, primero implementó el primer esquema con VIP y luego lo rehizo al esquema con Consul.
Esquema típico de infraestructura:
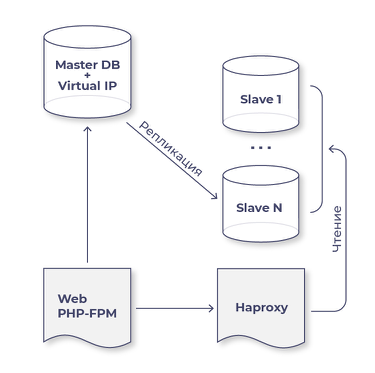
Describiré de inmediato las situaciones obvias que deben tenerse en cuenta:
- La dirección VIP no debe estar configurada en el archivo de configuración de ninguno de los servidores. Imaginemos la situación: el maestro se reinició, y mientras se carga, Orchestrator entra en modo failover y hace de uno de los esclavos el nuevo maestro; luego se levanta el antiguo maestro, y ahora VIP está en dos máquinas. Esto es malo.
- Para el orquestador, será necesario escribir un script para comunicarse con el antiguo maestro y el nuevo maestro. En el antiguo, se debe ejecutar ifdown, y en el nuevo maestro, se debe ejecutar ifup vip. También sería bueno incluir en este script que, en caso de failover, el puerto en el conmutador del antiguo maestro simplemente se apague para evitar cualquier split-brain.
- Después de que el Orquestador invoque su script para primero quitar el VIP y/o apagar el puerto en el conmutador, y luego invoque el script para levantar el VIP en el nuevo maestro, no olvide usar el comando arping para avisar a todos que el nuevo VIP ahora está aquí.
- Todos los esclavos deben tener read_only=1, y tan pronto como promueva un esclavo a maestro, este debe cambiar a read_only=0.
- No olvide que cualquier esclavo que seleccionemos puede convertirse en maestro (el Orquestador tiene todo un mecanismo de preferencia para determinar qué esclavo considerar primero como candidato a nuevo maestro, cuál en segundo lugar y cuál nunca debe ser elegido como maestro bajo ninguna circunstancia). Si un esclavo se convierte en maestro, mantendrá la carga del esclavo y añadirá la carga del maestro, esto debe tenerse en cuenta.
¿Por qué necesita necesariamente un Orquestador si no lo tiene?
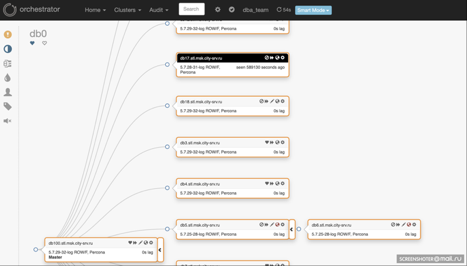
- El Orquestador tiene una interfaz gráfica muy conveniente que muestra toda la topología (vea la captura de pantalla a continuación).
- El Orquestador puede rastrear qué esclavos están atrasados y dónde ha fallado completamente la replicación (tenemos scripts conectados al Orquestador para enviar SMS).
- El Orquestador le dice en qué esclavos hay un error de GTID errant.
Interfaz del Orquestador:
¿Qué es un GTID errant?
Hay dos requisitos principales para que funcione el Orquestador:
- Es necesario que en todas las máquinas del clúster MySQL esté activado pseudo GTID; en nuestro caso, GTID está habilitado.
- Es necesario que haya un solo tipo de binlogs en todas partes, puede ser statement. Tuvimos una configuración donde el maestro y la mayoría de los esclavos tenían Row, pero en dos historicamente quedó el modo Mixed. Como resultado, estos esclavos simplemente no fueron aceptados por el Orquestador en el nuevo maestro.
Recuerde que lo más importante en un esclavo de producción es su consistencia con el maestro. Si tiene GTID habilitado tanto en el maestro como en el esclavo, a través de la función gtid_subset puede verificar si realmente se han ejecutado las mismas instrucciones de modificación de datos en estas máquinas. Puede leer más sobre esto. .
Por lo tanto, Orchestrator le muestra a través del error GTID errante que en el esclavo hay transacciones que no están en el maestro. ¿Por qué sucede esto?
- El read_only=1 no está habilitado en el esclavo, alguien se conectó y ejecutó una consulta para modificar datos.
- El super_read_only=1 no está habilitado en el esclavo, por lo que un administrador, confundiendo el servidor, se conectó y ejecutó una consulta allí.
- Si ha tenido en cuenta los dos puntos anteriores, hay otro truco: en MySQL, la consulta para hacer flush de los binlogs también se registra en el binlog, por lo que con el primer flush en el maestro y en todos los esclavos aparecerá un GTID errante. ¿Cómo evitar esto? En perona-5.7.25-28 se introdujo la configuración binlog_skip_flush_commands=1, que prohíbe escribir flush en los binlogs. En el sitio mysql.com hay registrado .
Resumiendo todo lo mencionado anteriormente. Si aún no desea utilizar Orchestrator en modo de failover, configúrelo en modo de supervisión. Así siempre tendrá frente a usted un mapa de interacción de las máquinas MySQL y una información visual sobre qué tipo de replicación hay en cada máquina, si los esclavos se están atrasando y, lo más importante, ¡cuán consistentes son con el maestro!
La pregunta obvia es: "¿Cómo debe funcionar Orchestrator?". Debe seleccionar un nuevo maestro de los esclavos actuales y luego reconectar todos los esclavos a él (¡para esto se necesita GTID; si se utiliza el antiguo mecanismo con binlog_name y binlog_pos, entonces el cambio del esclavo del maestro actual al nuevo simplemente es imposible!). Antes de que tuviéramos Orchestrator, una vez tuve que hacer todo esto manualmente. El antiguo maestro se colgaba debido a un controlador Adaptec defectuoso y tenía alrededor de 10 esclavos. Necesitaba mover el VIP del maestro a uno de los esclavos y reconectar todos los demás esclavos a él. Cuántas consolas tuve que abrir, cuántos comandos simultáneos introducir... Tuve que esperar hasta las 3 de la mañana, quitar la carga de todos los esclavos, excepto de dos, hacer de la primera máquina la nueva maestra de las dos, conectar la segunda máquina a ella, luego conectar todos los demás esclavos al nuevo maestro y devolver la carga. En resumen, un desastre…
¿Cómo funciona Orchestrator cuando entra en modo de failover? Es más fácil mostrarlo con el ejemplo de una situación en la que queremos convertir una máquina más potente y moderna en el nuevo maestro que la que tenemos actualmente.
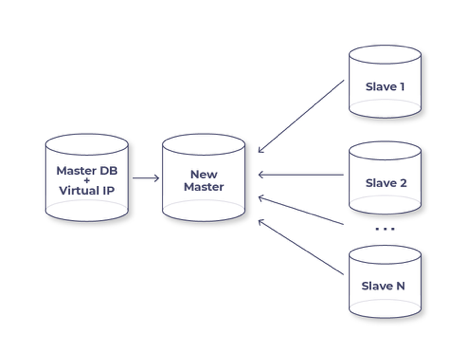
La imagen muestra el centro del proceso. ¿Qué se había hecho antes de este momento? Dijimos que queríamos hacer que un esclavo se convirtiera en un nuevo maestro, el Orchestrator comenzó a reconectar todos los demás esclavos a él, mientras que el nuevo maestro actúa como una máquina de tránsito. Con este esquema no hay errores, todos los esclavos funcionan, el Orchestrator quita el VIP del antiguo maestro, lo mueve al nuevo, establece read_only=0 y olvida el antiguo maestro. ¡Eso es todo! El tiempo de inactividad de nuestro servicio es el tiempo que toma transferir el VIP, son 2-3 segundos.
Eso es todo por hoy, gracias a todos. Pronto habrá un segundo artículo sobre Orchestrator. En una conocida película soviética «Garaż», un personaje dijo: «¡No iría con él a la exploración!» Así que, Orchestrator, ¡yo iría contigo a la exploración!
Fuente: habr.com
