

En Sitimobil utilizamos la base de datos MySQL como nuestro principal almacenamiento de datos persistentes. Tenemos varios clústeres de bases de datos para distintos servicios y objetivos.
La disponibilidad continua del maestro es un indicador crítico del funcionamiento de todo el sistema y sus partes individuales. La recuperación automática del clúster en caso de fallo del maestro reduce significativamente el tiempo de respuesta a incidentes y el tiempo de inactividad del sistema. En este artículo, revisaré el esquema de alta disponibilidad (HA) del clúster MySQL basado en y direcciones IP virtuales (VIP).
Solución HA basada en VIP
Primero, haré un breve resumen sobre nuestra arquitectura de almacenamiento de datos.
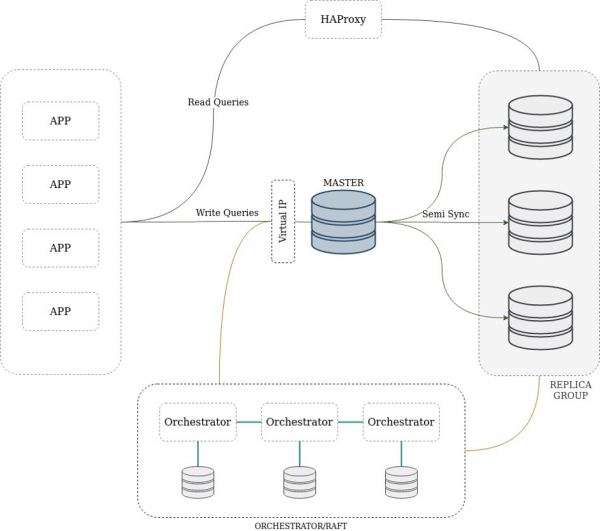
Utilizamos un esquema clásico de replicación con un único maestro, disponible para escritura, y múltiples réplicas, que se utilizan solo para lectura. El clúster puede contener un maestro intermedio: un nodo que es simultáneamente réplica y maestro para otros. Los clientes se conectan a las réplicas a través de HAProxy, lo que permite distribuir la carga de manera uniforme y escalar fácilmente. El uso de HAProxy se debe a razones históricas, y ahora estamos en proceso de migración a ProxySQL.
La replicación se lleva a cabo en modo semisíncrono basado en GTID. Esto significa que al menos una réplica debe registrar la transacción en el registro antes de que se considere exitosa. Este modo de replicación garantiza un equilibrio óptimo entre rendimiento y conservación de datos en caso de fallo del nodo principal. Principalmente, todos los cambios se transmiten del maestro a las réplicas mediante Row Based Replication (RBR), pero algunos nodos pueden tener mixed binlog format.
El Orchestrator actualiza periódicamente el estado de la topología del clúster, analiza la información recibida y, en caso de problemas, puede iniciar el procedimiento de recuperación automática. Este procedimiento está a cargo del desarrollador, ya que se puede implementar de diversas maneras: basándose en VIP, DNS, utilizando servicios de descubrimiento o mecanismos personalizados.
Una de las formas más sencillas de recuperar el maestro en caso de fallo es utilizar direcciones VIP flotantes.
Lo que necesitas saber sobre esta solución antes de continuar:
- VIP es una dirección IP que no está vinculada a una interfaz de red física específica. En caso de que un nodo falle o durante el mantenimiento programado, podemos transferir el VIP a otro recurso con un tiempo de inactividad mínimo.
- Liberar y emitir una dirección IP virtual son operaciones baratas y rápidas.
- Para trabajar con VIP se requiere acceso al servidor por SSH, o el uso de utilidades especiales, como
keepalived.
Consideremos posibles problemas con nuestro maestro y presentemos cómo debe funcionar el mecanismo de recuperación automática.
Se perdió la conectividad de red con el maestro, o surgió un problema a nivel de hardware, y el servidor no está disponible.
- El orquestador actualiza la topología del clúster, cada réplica informa sobre la falta de disponibilidad del maestro. El orquestador inicia el proceso de elección de una réplica adecuada para convertirse en el nuevo maestro y comienza la recuperación.
- Intentamos retirar el VIP del viejo maestro - sin éxito.
- La réplica asume el rol de maestro. La topología se reestructura.
- Agregamos una nueva interfaz de red con VIP. Dado que no se pudo retirar el VIP, en segundo plano iniciamos el envío periódico de un gratuitous ARP. Este tipo de solicitud/respuesta permite actualizar en los switches conectados la tabla de correspondencia entre las direcciones IP y MAC, notificando así sobre el traslado de nuestro VIP. Esto minimiza la probabilidad de
split brainal volver el viejo maestro. - Todas las nuevas conexiones se redirigen de inmediato al nuevo maestro. Las conexiones antiguas terminan sin éxito, y se realizan reintentos a la base de datos a nivel de aplicación.
El servidor funciona en modo normal, hubo una falla a nivel de SGBD.
El algoritmo es análogo al caso anterior: actualización de la topología e inicio del proceso de recuperación. Dado que el servidor está disponible, liberamos exitosamente el VIP del viejo maestro, lo transferimos al nuevo y enviamos varias solicitudes ARP. El posible retorno del viejo maestro no debe afectar el clúster reestructurado y el funcionamiento de la aplicación.
Otros problemas
Fallas de réplicas o maestros intermedios no conducen a acciones automáticas y requieren intervención manual.
La interfaz de red virtual siempre se agrega temporalmente, es decir, después de reiniciar el servidor, el VIP no se asigna automáticamente. Cada instancia de la BD se inicia por defecto en modo solo lectura; el orquestador cambia automáticamente el nuevo maestro a modo escritura y trata de establecer solo lectura en el antiguo maestro. Estas acciones están destinadas a disminuir la probabilidad de split brain.
Durante el proceso de recuperación pueden surgir problemas, los cuales también se deben notificar a través de la interfaz de usuario del orquestador además de los medios de monitoreo estándar. Hemos ampliado la API REST agregando esta posibilidad ( actualmente está en revisión).
El esquema general de la solución HA se presenta a continuación.
Selección de un nuevo maestro
El orquestador es lo suficientemente inteligente y trata de elegir como nuevo maestro según los siguientes criterios:
- retraso de la réplica respecto al maestro;
- versión de MySQL del maestro y de la réplica;
- tipo de replicación (RBR, SBR o mixta);
- ubicación en uno o distintos centros de datos;
- presencia de
GTID errante— transacciones que se han ejecutado en la réplica y que faltan en el maestro; - también se tienen en cuenta las reglas personalizadas de selección.
No cada réplica es un candidato ideal para ser maestro. Por ejemplo, la réplica puede usarse para crear copias de seguridad de datos, o el servidor puede tener una configuración de hardware más débil. El orquestador reglas manuales, mediante las cuales se pueden ajustar las preferencias para la selección de candidatos desde los más preferidos hasta los ignorados.
Tiempo de respuesta y recuperación
En caso de un incidente, es importante minimizar el tiempo de inactividad del sistema; de ahí que consideremos los parámetros de MySQL que afectan la construcción y actualización de la topología del clúster por parte del orquestador:
- — cantidad de segundos durante los cuales la réplica espera la llegada de nuevos datos o la señal de latido del maestro antes de que la conexión se considere perdida y se realice la reconexión. Cuanto menor sea el valor, más rápido podrá la réplica determinar que la conexión con el maestro se ha interrumpido. Establecemos este valor en 5 segundos.
- — cantidad de segundos entre los intentos de reconexión. En caso de problemas de red, un valor bajo de este parámetro permitirá reconectarse rápidamente y evitar el inicio del proceso de recuperación del clúster. Se recomienda un valor de 1 segundo.
MASTER_RETRY_COUNT— número máximo de intentos de reconexión.MASTER_HEARTBEAT_PERIOD— intervalo en segundos, después del cual el maestro envía una señal de latido. Por defecto es la mitad del valor deslave_net_timeout.
Parámetros del orquestador:
DelayMasterPromotionIfSQLThreadNotUpToDate— si es igual atrue, el rol de maestro no se aplicará en el replicador candidato hasta que el hilo SQL del replicador haya ejecutado todas las transacciones no aplicadas del Relay Log. Usamos esta opción para no perder transacciones en condiciones de retraso de todos los replicadores candidatos.InstancePollSeconds— frecuencia de construcción y actualización de la topología.RecoveryPollSeconds— frecuencia de análisis de la topología. Si se detecta un problema, se inicia la recuperación de la topología. Esto es, igual a 1 segundo.
Cada nodo del clúster es sondeado por el orquestador una vez cada InstancePollSeconds segundos. Al detectar un problema, el estado del clúster se actualiza forzosamenteBanco de pruebas
Comenzamos las pruebas del esquema de HA con el desarrollo de un
banco de pruebas local Durante los ejercicios, elegimos uno de los métodos de simulación de problemas: eliminar instantáneamente al maestro usando
kill -9 , finalizar suavemente el proceso y detener el servidor (docker-compose stop), simular problemas de red usandoiptables -j REJECT iptables -j DROP o . Esperamos los siguientes resultados:el orquestador detectará problemas con el maestro y actualizará la topología en no más de 10 segundos;
- se iniciará automáticamente el procedimiento de recuperación: la configuración de red cambiará, el rol de maestro se transferirá al replicador, la topología se reconstruirá;
- se iniciará automáticamente el procedimiento de recuperación: se cambiará la configuración de red, el rol de maestro pasará a la réplica y la topología se reestructurará;
- la nueva maestro estará disponible para escritura, las réplicas en vivo no se perderán durante el proceso de reconstrucción;
- los datos comenzarán a escribirse en el nuevo maestro y a replicarse;
- el tiempo total de recuperación será de no más de 30 segundos.
Como saben, el sistema puede comportarse de manera diferente en entornos de prueba y producción debido a la configuración diferente del "hardware" y la red, diferencias en la carga sintética y real, etc. Por eso, periódicamente realizamos ejercicios en condiciones reales, verificando cómo se comporta el sistema ante la pérdida de conectividad de red o la degradación de sus partes individuales. En el futuro, queremos construir una infraestructura completamente idéntica para ambos entornos y automatizar su prueba.
Conclusiones
El funcionamiento del nodo principal del sistema de almacenamiento de datos es una de las principales tareas del equipo SRE y de operaciones. La implementación de un orquestador y soluciones de alta disponibilidad basadas en VIP ha permitido lograr los siguientes resultados:
- detección confiable de problemas con la topología del clúster de base de datos;
- respuesta automática y rápida a incidentes relacionados con el maestro, lo que reduce el tiempo de inactividad del sistema.
Sin embargo, la solución tiene sus limitaciones y desventajas:
- escalar el esquema de HA a varios centros de datos requerirá una red L2 única entre ellos;
- antes de asignar VIP al nuevo maestro, necesitamos liberarlo en el viejo. El proceso es secuencial, lo que aumenta el tiempo de recuperación;
- liberar VIP requiere acceso SSH al servidor, o cualquier otro método de invocación de procedimientos remotos. Dado que el servidor o la base de datos está experimentando problemas que provocaron el proceso de recuperación, no podemos estar seguros de que la liberación de VIP será exitosa. Esto puede llevar a la aparición de dos servidores con la misma dirección IP virtual y un problema.
split brain.
Para evitar split brain, se puede utilizar el método (“Shoot The Other Node In The Head”), que aísla o apaga completamente el nodo problemático. Existen también otros métodos para implementar alta disponibilidad en el clúster: una combinación de VIP y DNS, detección de servicios y proxies, replicación síncrona y otros métodos que tienen sus desventajas y ventajas.
He hablado sobre nuestro enfoque para crear un clúster MySQL tolerante a fallos. Es fácil de implementar y proporciona un nivel aceptable de confiabilidad en las condiciones actuales. A medida que toda la sistema en general y la infraestructura en particular evolucionen, este enfoque sin duda también evolucionará.
Fuente: habr.com
