

Le presento la transcripción de la presentación de Alexey Lesovsky de Data Egret "Fundamentos de monitoreo de PostgreSQL"
En esta presentación, Alexey Lesovsky hablará sobre los aspectos clave de la estadística de PostgreSQL, lo que significan y por qué deben estar presentes en el monitoreo; sobre qué gráficos deben incluirse en el monitoreo, cómo agregarlos y cómo interpretarlos. La presentación será útil para administradores de bases de datos, administradores de sistemas y desarrolladores interesados en la resolución de problemas de Postgres.
Me llamo Alexey Lesovsky, represento a la empresa Data Egret.
Unas palabras sobre mí. Comencé hace mucho tiempo como administrador de sistemas.
Administré diversas distribuciones de Linux, ocupándome de cosas como virtualización, monitoreo, trabajando con proxies, etc. Pero en algún momento me dediqué más a las bases de datos, PostgreSQL. Me encantaba. Y poco a poco, pasé la mayor parte de mi tiempo laboral trabajando con PostgreSQL. Así, gradualmente me convertí en DBA de PostgreSQL.
A lo largo de mi carrera, siempre me han interesado los temas de estadística, monitoreo y obtención de telemetría. Cuando era administrador de sistemas, trabajé mucho con Zabbix. Y escribí un pequeño conjunto de scripts como . Fue bastante popular en su momento. Y se podía monitorear cosas muy diversas, no solo Linux, sino también diferentes componentes.
Ahora trabajo con PostgreSQL. Estoy escribiendo otra herramienta que permite trabajar con la estadística de PostgreSQL. Se llama (artículo en Habr — ).
Una breve introducción. ¿Cuáles son las situaciones que enfrentan nuestros clientes? Ocurre algún tipo de accidente relacionado con la base de datos. Y cuando ya se ha recuperado la base de datos, el jefe del departamento o el jefe de desarrollo dice: «Amigos, necesitamos monitorear la base de datos, porque algo malo ha sucedido y debemos asegurarnos de que esto no vuelva a ocurrir en el futuro». Y aquí comienza un interesante proceso de elección de un sistema de monitoreo o la adaptación de un sistema de monitoreo existente para poder monitorear nuestra base de datos: PostgreSQL, MySQL o alguna otra. Y los colegas comienzan a proponer: «He oído que hay una cierta base de datos. Vamos a utilizarla». Los colegas comienzan a discutir entre ellos. Y al final resulta que elegimos alguna base de datos, pero el monitoreo de PostgreSQL en ella está bastante limitado y siempre hay que modificar algo. Tomar ciertos repositorios de GitHub, clonarlos, adaptar scripts, ajustarlos de alguna manera. Y al final, esto resulta en un trabajo manual.
Por lo tanto, en esta presentación intentaré brindarles algunos conocimientos sobre cómo elegir un monitoreo no solo para PostgreSQL, sino también para bases de datos en general. Y proporcionar los conocimientos que les permitan mejorar su monitoreo, para obtener algún beneficio, para poder monitorear su base de datos de manera efectiva, y prevenir a tiempo posibles situaciones de emergencia que puedan surgir.
Las ideas presentadas en esta exposición pueden adaptarse directamente a cualquier base de datos, ya sea un SGBD o noSQL. Por lo tanto, no se limita solo a PostgreSQL, sino que habrá muchas recetas sobre cómo implementarlo en PostgreSQL. Habrá ejemplos de consultas, ejemplos de entidades que existen en PostgreSQL para monitoreo. Y si su SGBD tiene características similares que permiten integrarlas en el monitoreo, también puede adaptarlas, añadirlas y será excelente.
 En la presentación no hablaré
sobre cómo recopilar y almacenar métricas. No diré nada sobre el post-procesamiento de datos ni su presentación al usuario. Y no hablaré sobre alertas.
A lo largo de la narrativa, iré mostrando diferentes capturas de pantalla de los monitoreos existentes, y las criticaré de alguna manera. Sin embargo, trataré de no mencionar marcas para no hacer publicidad ni antireclamo a estos productos. Por lo tanto, todas las coincidencias son aleatorias y quedan a su imaginación.
Para empezar, aclaremos qué es el monitoreo. El monitoreo es algo muy importante que se debe tener. Todos lo entienden. Pero al mismo tiempo, el monitoreo no se considera un producto comercial y no influye directamente en las ganancias de la empresa, por lo que siempre se le presta atención de manera residual. Si tenemos tiempo, trabajamos en el monitoreo; si no hay tiempo, bien, lo dejamos en el backlog y volveremos a estas tareas algún día.
Por lo tanto, de nuestra experiencia al llegar a los clientes, el monitoreo a menudo está subdesarrollado y carece de elementos interesantes que nos ayuden a mejorar nuestro trabajo con la base de datos. Por eso, el monitoreo siempre necesita ser perfeccionado.
Las bases de datos son cosas complejas que también necesitan ser monitoreadas, porque las bases de datos son almacenes de información. Y la información es muy importante para la empresa; no se puede perder de ninguna manera. Pero al mismo tiempo, las bases de datos son piezas de software muy complejas. Están compuestas por una gran cantidad de componentes. Y muchos de estos componentes necesitan ser monitoreados.
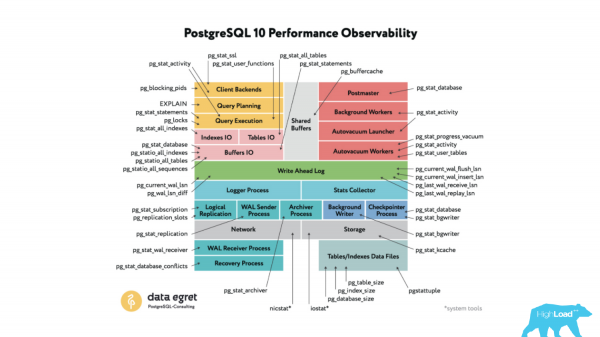 Si hablamos específicamente de PostgreSQL, se puede representar como un esquema que consta de muchos componentes. Estos componentes interactúan entre sí. Al mismo tiempo, en PostgreSQL existe lo que se llama el subsistema Stats Collector, que permite recopilar estadísticas sobre el funcionamiento de estos subsistemas y proporcionar una interfaz al administrador o usuario para que pueda ver estas estadísticas.
Estas estadísticas se presentan en forma de un conjunto de funciones y vistas (views). También se pueden llamar tablas. Es decir, con un cliente psql común, puede conectarse a la base de datos, hacer un select a estas funciones y vistas, y obtener cifras concretas sobre el funcionamiento de los subsistemas de PostgreSQL.
Puede agregar estas cifras a su sistema de monitoreo favorito, dibujar gráficos, agregar funciones y obtener análisis a largo plazo.
Sin embargo, en este informe no abordaré todas estas funciones de manera exhaustiva, ya que eso podría llevar todo un día. Me centraré en literal dos o tres cosas y explicaré cómo ayudan a mejorar la monitorización.
Y si hablamos sobre la monitorización de la base de datos, ¿qué es lo que hay que monitorear? En primer lugar, hay que monitorear la disponibilidad, ya que una base de datos es un servicio que proporciona acceso a datos a los clientes, y necesitamos vigilar su disponibilidad, así como algunas características cualitativas y cuantitativas.
También es necesario monitorear a los clientes que se conectan a nuestra base de datos, porque pueden ser tanto clientes normales como clientes dañinos que pueden perjudicar la base de datos. También hay que vigilarlos y rastrear su actividad.
Cuando los clientes se conectan a la base de datos, es evidente que comienzan a trabajar con nuestros datos, por lo que necesitamos monitorear también cómo interactúan los clientes con los datos: con qué tablas, y en menor medida, con qué índices. Es decir, tenemos que evaluar la carga de trabajo (workload) que generan nuestros clientes.
Pero la carga de trabajo también consiste, por supuesto, en consultas. Las aplicaciones se conectan a la base y acceden a los datos mediante consultas, por lo que es importante evaluar qué consultas tenemos en nuestra base de datos, monitorizar su adecuación, asegurarnos de que no estén mal escritas, y que algunas opciones necesiten ser reescritas para que funcionen más rápido y con mejor rendimiento.
Y dado que estamos hablando de bases de datos, hay que considerar que siempre hay procesos en segundo plano. Los procesos en segundo plano permiten mantener el rendimiento de la base de datos en un buen nivel, y por lo tanto requieren una cierta cantidad de recursos para su funcionamiento. Al mismo tiempo, pueden cruzarse con los recursos de las consultas de los clientes, por lo que el trabajo intensivo de los procesos en segundo plano puede afectar directamente el rendimiento de las consultas de los clientes. Por eso también hay que monitorearlos y asegurarse de que no haya desequilibrios relacionados con los procesos en segundo plano.
Y todo esto en términos de monitoreo de bases de datos permanece en la métrica del sistema. Pero considerando que la mayor parte de nuestra infraestructura se está trasladando a la nube, las métricas del sistema de un host individual siempre quedan en segundo plano. Sin embargo, en bases de datos siguen siendo relevantes y, por supuesto, también es necesario monitorear estas métricas del sistema.
Con las métricas del sistema más o menos todo está bien, todos los sistemas modernos de monitoreo ya admiten estas métricas, pero en general hay algunos componentes que aún faltan y se necesita añadir ciertas cosas. También voy a mencionarlos, habrá unas diapositivas al respecto.
El primer punto del plan es la disponibilidad. ¿Qué es la disponibilidad? La disponibilidad, en mi entendimiento, es la capacidad de la base de datos para manejar conexiones, es decir, la base de datos está activa, acepta conexiones de los clientes como un servicio. Y esta disponibilidad se puede evaluar con ciertas características. Estas características son muy convenientes para mostrar en los dashboards.
Todos saben qué es un dashboard. Es cuando echas un vistazo a la pantalla donde se resume la información necesaria. Y ya puedes determinar de inmediato si hay un problema en la base de datos o no.
Por lo tanto, la disponibilidad de la base de datos y otras características clave siempre deben mostrarse en los dashboards, para que esta información esté a mano, siempre cerca de ti. Algunos detalles adicionales que ya ayudan en la investigación de incidentes o situaciones de emergencia deben mostrarse en dashboards secundarios o esconderse en enlaces de drilldown que llevan a sistemas de monitoreo externos.
Ejemplo de un sistema de monitoreo conocido. Es un sistema de monitoreo muy impresionante. Recopila una gran cantidad de datos, pero desde mi punto de vista, tiene una concepción extraña de los dashboards. Hay un enlace ‘crear dashboard’. Pero cuando creas un dashboard, estás creando una lista compuesta por dos columnas, una lista de gráficos. Y cuando necesitas ver algo, comienzas a hacer clic con el ratón, desplazarte, buscar el gráfico que necesitas. Y esto lleva tiempo, es decir, no hay dashboards como tales. Solo hay listas de gráficos.
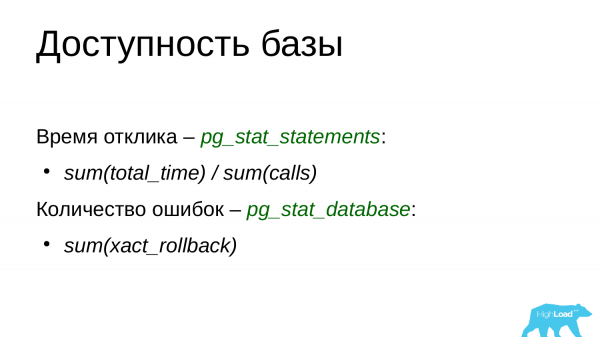
¿Qué se debe agregar a estos paneles? Se puede comenzar con una característica como el tiempo de respuesta. En PostgreSQL hay una vista pg_stat_statements. Por defecto, está desactivada, pero es una de las vistas del sistema más importantes que siempre se deben habilitar y utilizar. Esta almacena información sobre todas las consultas que se han ejecutado en la base de datos.
Por lo tanto, podemos partir de que se puede tomar el tiempo total de ejecución de todas las consultas y dividirlo entre el número de consultas utilizando los campos mencionados anteriormente. Pero esto es como una temperatura media en un hospital. Podemos basarnos en otros campos: el tiempo mínimo de ejecución de consultas, el máximo y el mediano. Incluso podemos construir percentiles, ya que en PostgreSQL existen funciones correspondientes para esto. Y podemos obtener algunos números que caracterizan el tiempo de respuesta de nuestra base a partir de consultas ya ejecutadas; es decir, no ejecutamos una consulta ficticia ‘select 1’ y medimos el tiempo de respuesta, sino que analizamos los tiempos de respuesta de consultas realizadas y representamos eso con un número único o graficamos.
También es importante monitorear la cantidad de errores que el sistema está generando en este momento. Para esto, se puede utilizar la vista pg_stat_database. Nos enfocamos en el campo xact_rollback. Este campo muestra no solo la cantidad de rollbacks que ocurren en la base, sino que también considera la cantidad de errores. En otras palabras, podemos mostrar este número en nuestro panel y observar cuántos errores hay en este momento. Si hay muchos errores, es un buen motivo para revisar los registros y ver qué tipos de errores son y por qué están ocurriendo, y luego investigar y resolverlos.
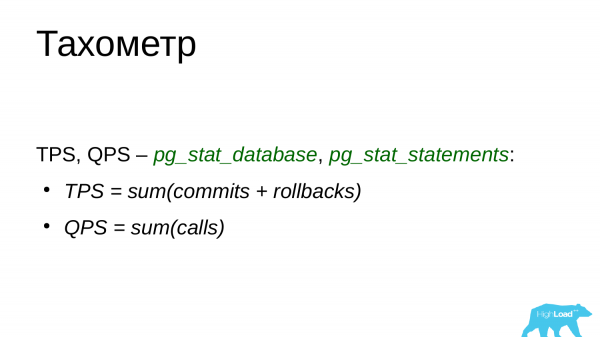
Se puede añadir algo como un Tacómetro. Esto es la cantidad de transacciones por segundo y la cantidad de consultas por segundo. En otras palabras, puedes utilizar estos números como el rendimiento actual de tu base de datos y observar si hay picos en las consultas, picos en las transacciones o, por el contrario, si la base no está completamente cargada porque algún backend se ha caído. Es importante siempre observar este número y recordar que para nuestro proyecto, ese rendimiento es normal, mientras que los valores por encima o por debajo son problemáticos y extraños, lo que significa que hay que investigar por qué hay esos números.
Para evaluar la cantidad de transacciones, podemos volver a consultar la vista pg_stat_database. Podemos sumar el número de commits y el número de rollbacks para obtener la cantidad de transacciones por segundo.
¿Todos entienden que en una transacción pueden incluirse varias consultas? Por eso, TPS y QPS son un poco diferentes.
La cantidad de consultas por segundo se puede obtener a través de pg_stat_statements y simplemente calcular la suma de todas las consultas ejecutadas. Es claro que comparamos el valor actual con el anterior, restamos y obtenemos la delta, obteniendo así la cantidad.
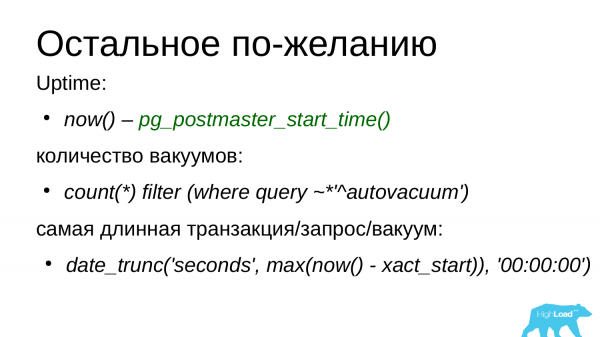
Se pueden agregar métricas adicionales si se desea, que también ayudan a evaluar la disponibilidad de nuestra base y a rastrear si ha habido algún tiempo de inactividad.
Una de estas métricas es el uptime. Pero el uptime en PostgreSQL es un tema un poco complicado. A continuación, explicaré por qué. Cuando PostgreSQL arranca, comienza a contabilizar el uptime. Sin embargo, si en algún momento, por ejemplo, durante la noche, se ejecuta alguna tarea, y el OOM-killer finaliza forzosamente un proceso hijo de PostgreSQL, el sistema finaliza las conexiones de todos los clientes, restablece el área de memoria compartida y comienza la recuperación desde el último punto de control. Durante este tiempo de recuperación, la base no acepta conexiones, es decir, esta situación se puede considerar como downtime. Sin embargo, el contador de uptime no se reiniciará, porque cuenta el tiempo desde el inicio del postmaster desde el primer momento. Por lo tanto, se pueden pasar por alto tales situaciones.
También se debe monitorear la cantidad de trabajadores de autovacuum. ¿Todos saben qué es el autovacuum en PostgreSQL? Es un subsistema interesante en PostgreSQL. Se han escrito muchos artículos sobre él y se han realizado muchas presentaciones. Hay muchas discusiones sobre el vacuum y cómo debería funcionar. Muchos lo consideran un mal inevitable. Y así es. Es una especie de recolector de basura que limpia las versiones obsoletas de filas que no son necesarias por ninguna de las transacciones y libera espacio en las tablas e índices para nuevas filas.
¿Por qué es necesario monitorearlo? Porque el autovacuum a veces puede causar mucho daño. Consume una gran cantidad de recursos, lo que afecta las consultas de los clientes.
Y se debe monitorear a través de la vista pg_stat_activity, de la que hablaré en la siguiente sección. Esta vista muestra la actividad actual en la base de datos. A través de esta actividad, podemos rastrear la cantidad de procesos de limpieza (vacuum) que están funcionando en este momento. Podemos supervisar los procesos de limpieza y ver que si se supera el límite, es una razón para revisar la configuración de PostgreSQL y optimizar el funcionamiento del proceso de limpieza.
Otra característica de PostgreSQL es que PostgreSQL sufre mucho con transacciones que se prolongan. Especialmente, con transacciones que permanecen activas y no hacen nada. Estos son los llamados stat idle-in-transaction. Esta transacción mantiene bloqueos, impide el funcionamiento del proceso de limpieza. Y como resultado, las tablas se inflan y aumentan su tamaño. Y las consultas que trabajan con estas tablas comienzan a funcionar más lentamente, porque hay que mover todas las versiones antiguas de las filas de la memoria al disco y de regreso. Por lo tanto, el tiempo, la duración de las transacciones más largas y las consultas más prolongadas del proceso de limpieza también deben ser monitoreados. Y si vemos algunos procesos que están funcionando durante mucho tiempo, 10-20-30 minutos para una carga OLTP, entonces ya debemos prestar atención a ellos y finalizarlos forzosamente, o optimizar la aplicación para que no se llamen y no se queden colgados tanto tiempo. Para una carga analítica, 10-20-30 minutos es normal, a veces pueden ser aún más largas.
A continuación, tenemos la opción con los clientes conectados. Cuando hemos formado el panel de control y hemos publicado las métricas clave de disponibilidad, también podemos agregar información adicional sobre los clientes conectados.
La información sobre los clientes conectados es importante porque, desde el punto de vista de PostgreSQL, los clientes pueden ser diferentes. Hay buenos clientes y hay malos clientes.
Un ejemplo sencillo. Por cliente entiendo una aplicación. La aplicación se conecta a la base de datos y comienza a enviar sus consultas; la base de datos las procesa y ejecuta, devolviendo los resultados al cliente. Estos son los clientes buenos y correctos.
Hay situaciones en las que un cliente se conecta, mantiene la conexión, pero no hace nada. Se encuentra en estado idle.
Pero hay clientes problemáticos. Por ejemplo, un cliente se conecta, abre una transacción, hace algo en la base de datos y luego se va al código, supongamos, para acceder a una fuente externa o para procesar los datos obtenidos. Pero no cierra la transacción. Y la transacción queda abierta en la base de datos, manteniendo un bloqueo en una fila. Este es un estado negativo. Y si, por alguna razón, la aplicación falla por una excepción (Exception), la transacción puede quedarse abierta durante mucho tiempo. Esto afecta directamente el rendimiento de PostgreSQL. PostgreSQL funcionará más lento. Por eso es importante monitorear a estos clientes y finalizar su trabajo de manera forzada. Además, es necesario optimizar la aplicación para evitar tales situaciones.
Otros clientes problemáticos son los clientes en espera. Pero se convierten en problemáticos debido a las circunstancias. Por ejemplo, una transacción simple en espera: puede abrir una transacción, obtener bloqueos en ciertas filas, luego en algún lugar del código falla, y queda una transacción colgada. Llegará otro cliente, solicitará los mismos datos, pero se encontrará con un bloqueo porque la transacción colgada ya tiene bloqueos en algunas filas necesarias. Y la segunda transacción quedará en espera de que la primera transacción finalice o sea cerrada forzosamente por su administrador. De este modo, las transacciones en espera pueden acumularse y sobrepasar el límite de conexiones a la base de datos. Y cuando se alcanza el límite, la aplicación ya no puede trabajar con la base. Esto es una situación crítica para el proyecto. Por lo tanto, es necesario monitorear a los clientes problemáticos y reaccionar a tiempo.
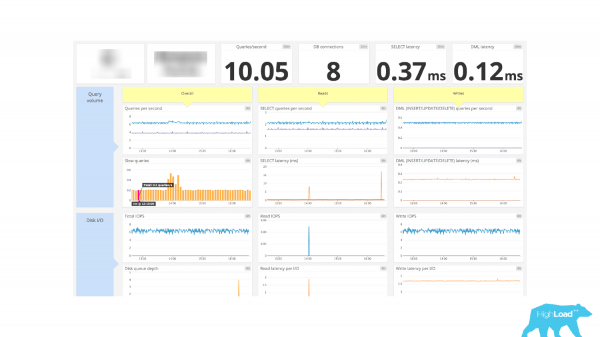
Otro ejemplo de monitoreo. Y aquí hay un buen panel de control. Hay información sobre las conexiones en la parte superior. Conexiones a la base de datos - 8. Y eso es todo. No tenemos información sobre qué clientes están activos, cuáles simplemente están inactivos, sin hacer nada. No hay información sobre transacciones colgadas ni sobre conexiones en espera, es decir, es una cifra que muestra el número de conexiones y nada más. Y después, adivinen ustedes.
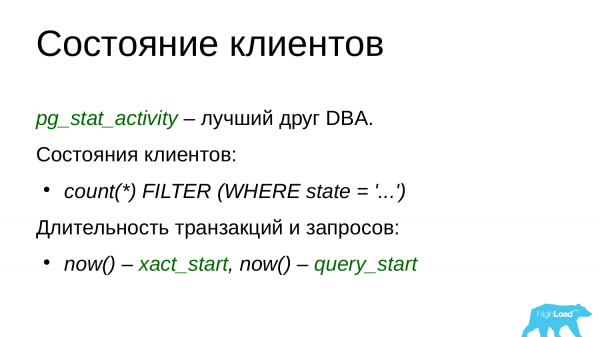
Por lo tanto, para añadir esta información a la monitorización, es necesario consultar la vista del sistema pg_stat_activity. Si pasas mucho tiempo en PostgreSQL, esta es una vista excelente que debería convertirse en tu aliada, ya que muestra la actividad actual en PostgreSQL, es decir, lo que está sucediendo en él. Cada proceso tiene una línea separada que muestra información sobre ese proceso: desde qué host se realizó la conexión, bajo qué usuario, bajo qué nombre, cuándo se inició la transacción, qué consulta se está ejecutando actualmente y cuál fue la última consulta ejecutada. Y, por consiguiente, podemos evaluar el estado del cliente a través del campo stat. En cierto modo, podemos hacer un agrupamiento por este campo y obtener las estadísticas actuales en la base de datos y el número de conexiones que tienen ese stat en la base de datos. Los números obtenidos los podemos enviar a nuestra monitorización y graficar a partir de ellos.
También es importante evaluar la duración de la transacción. Ya he mencionado que es fundamental evaluar la duración de los vacíos, pero las transacciones se evalúan de la misma manera. Hay campos xact_start y query_start. Estos, en cierto modo, muestran el tiempo de inicio de la transacción y el tiempo de inicio de la consulta. Tomamos la función now(), que muestra la marca de tiempo actual y restamos el timestamp de la transacción y de la consulta. Y obtenemos la duración de la transacción, la duración de la consulta.
Si vemos transacciones largas, debemos finalizarlas. Para una carga OLTP, las transacciones largas son superiores a 1-2-3 minutos.. Para una carga OLAP, las transacciones largas son normales, pero si se ejecutan durante más de dos horas, también es un indicio de que hay un desequilibrio en algún lugar.
Cuando los clientes se conectan a la base de datos, comienzan a trabajar con nuestros datos. Acceden a las tablas, consultan los índices para obtener datos de la tabla. Y es importante evaluar cómo los clientes interactúan con estos datos.
Esto es necesario para evaluar nuestra carga de trabajo y comprender aproximadamente cuáles son nuestras tablas más "calientes". Por ejemplo, esto es útil en situaciones en las que queremos colocar tablas "calientes" en un almacenamiento SSD rápido. Por otro lado, algunas tablas de archivo que ya no utilizamos desde hace tiempo se pueden mover a un archivo "frío" en discos SATA y pueden permanecer allí, accediendo a ellas solo cuando sea necesario.
También es útil para detectar anomalías después de lanzamientos y despliegues. Supongamos que el proyecto ha lanzado alguna nueva característica. Por ejemplo, se ha añadido nueva funcionalidad para trabajar con la base de datos. Y si construimos gráficos del uso de las tablas, podremos detectar fácilmente estas anomalías en esos gráficos. Por ejemplo, picos en las actualizaciones o picos en las eliminaciones. Eso será muy evidente.
También se pueden detectar anomalías en las estadísticas "desviadas". ¿Qué significa esto? PostgreSQL tiene un planificador de consultas muy fuerte y eficiente. Los desarrolladores dedican mucho tiempo a su desarrollo. ¿Cómo funciona? Para construir buenos planes, PostgreSQL recopila estadísticas sobre la distribución de datos en las tablas a intervalos y periodicidades específicas. Estas son las estadísticas más frecuentes: la cantidad de valores únicos, información sobre NULL en la tabla, y mucha información más.
Basándose en estas estadísticas, el planificador construye varias consultas, selecciona la más óptima y utiliza este plan para ejecutar la consulta y devolver los datos.
A veces, las estadísticas "fluyen". La calidad y cantidad de los datos han cambiado en las tablas, pero la estadística no se ha actualizado. Los planes formados pueden resultar no óptimos. Y si nuestros planes resultan no óptimos según la monitorización recopilada, podremos ver estas anomalías. Por ejemplo, donde los datos han cambiado cualitativamente y, en lugar del índice, se ha utilizado un escaneo secuencial de la tabla; es decir, si la consulta necesita devolver solo 100 filas (con un límite de 100), se realizará un escaneo completo. Y esto siempre afecta negativamente al rendimiento.
Y podremos ver esto en la monitorización. Ya podremos observar esta consulta, realizar un explain para ella, recopilar estadísticas, construir un nuevo índice adicional. Y así responder a este problema. Por lo tanto, esto es importante.
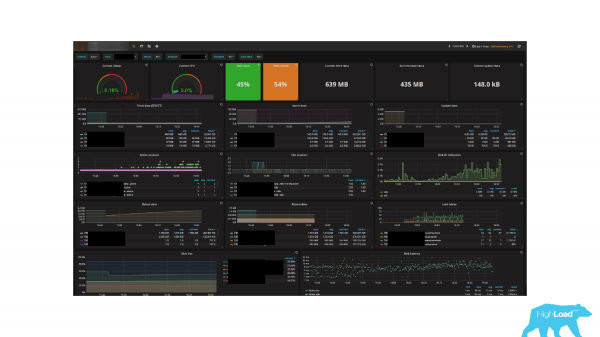
Otro ejemplo de monitorización. Creo que muchos lo reconocen, porque es muy popular. Quien lo utiliza en sus proyectos ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Pero hay un inconveniente.
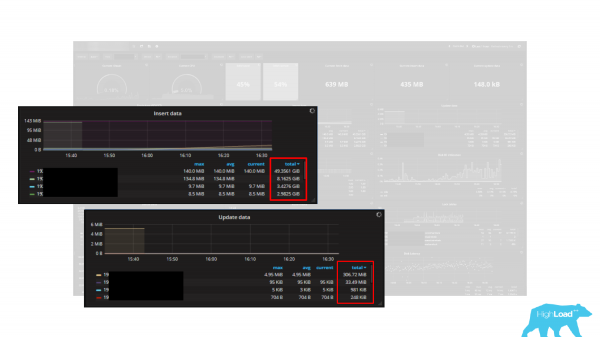
Hay varios gráficos. Y en forma de unidad se indican bytes, es decir, hay 5 gráficos. Estos son Insert data, Update data, Delete data, Fetch data y Return data. Como unidad de medida se indican bytes. Pero el hecho es que las estadísticas en PostgreSQL devuelven los datos en tuplas (filas). Y, en consecuencia, estos gráficos son una muy buena manera de subestimar su carga de trabajo varias veces, incluso decenas de veces, porque una tupla no es un byte, una tupla es una fila, que son muchos bytes y siempre de longitud variable. Es decir, calcular la carga de trabajo en bytes usando tuplas es una tarea irreal o muy complicada. Por lo tanto, cuando usas un panel de control o monitorización incorporada, siempre es importante entender que funcione correctamente y te devuelva datos evaluados de manera precisa.
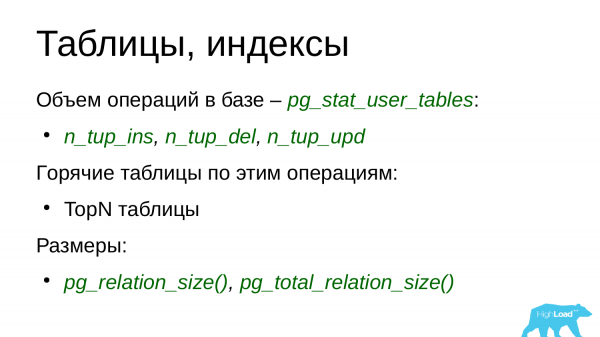
¿Cómo obtener estadísticas de estas tablas? Para esto, en PostgreSQL hay un cierto conjunto de vistas. Y la vista principal es . User_tables significa que son tablas creadas por el usuario. En contraste, hay vistas del sistema que son utilizadas por PostgreSQL mismo. Y hay una tabla consolidada Alltables, que incluye tanto las sistemáticas como las de usuario. Puedes basarte en cualquiera de ellas, la que más te guste.
Por los campos mencionados arriba se puede estimar la cantidad de insert, update y delete. El ejemplo de panel de control que utilicé utiliza precisamente estos campos para evaluar las características de la carga de trabajo. Por lo tanto, también podemos basarnos en ellos. Pero hay que recordar que son tuplas, no bytes, así que no podemos simplemente tomar y convertirlo en bytes.
Basándonos en estos datos, podemos construir lo que se denomina tablas TopN. Por ejemplo, Top-5, Top-10. Y se pueden rastrear las tablas calientes que se utilizan más que las demás. Por ejemplo, las 5 tablas "calientes" por inserciones. Y con estos TopN, evaluamos nuestra carga de trabajo y podemos valorar los picos de carga de trabajo después de diversas liberaciones, actualizaciones y despliegues.
También es importante evaluar el tamaño de la tabla, porque a veces los desarrolladores lanzan una nueva función y nuestras tablas empiezan a crecer en tamaño, ya que deciden añadir un volumen adicional de datos, pero no pronostican cómo esto afectará al tamaño de la base de datos. Estos casos también pueden ser sorpresas para nosotros.
Y ahora una pequeña pregunta para ustedes. ¿Qué pregunta surge cuando notan una carga en el servidor con la base de datos? ¿Cuál es la siguiente pregunta que se les ocurre?
Pero en realidad, surge la siguiente pregunta. ¿Cuáles son las consultas que están causando la carga? Es decir, no es interesante observar los procesos que generan la carga. Está claro que si hay un host con base de datos, entonces se está ejecutando una base de datos ahí y es evidente que solo las bases de datos son las que la utilizan. Si abrimos Top, veríamos una lista de procesos en PostgreSQL que están haciendo algo. Desde Top no queda claro qué es lo que están haciendo.
Por lo tanto, es necesario identificar aquellas consultas que generan la mayor carga, porque generalmente, la optimización de consultas proporciona más beneficios que la optimización de la configuración de PostgreSQL o del sistema operativo, o incluso la optimización del hardware. Según mi estimación, esto representa aproximadamente un 80-85-90 %. Y se realiza mucho más rápido. Es más fácil corregir una consulta que ajustar la configuración, planificar un reinicio, especialmente si no se puede reiniciar la base de datos o añadir hardware. Es más sencillo reescribir una consulta o añadir un índice para obtener un mejor resultado de esta consulta.
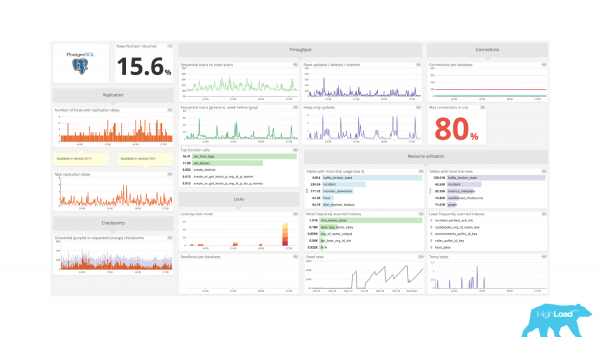
Por lo tanto, es necesario monitorear las consultas y su adecuación. Tomemos otro ejemplo de monitoreo. Y aquí también parece un excelente monitoreo. Hay información sobre replicación, hay información sobre capacidad, bloqueos, y utilización de recursos. Todo es perfecto, pero no hay información sobre las consultas. No está claro qué consultas se están ejecutando en nuestra base de datos, cuánto tiempo tardan en ejecutarse y cuántas de estas consultas hay. Siempre necesitamos tener esta información en el monitoreo.
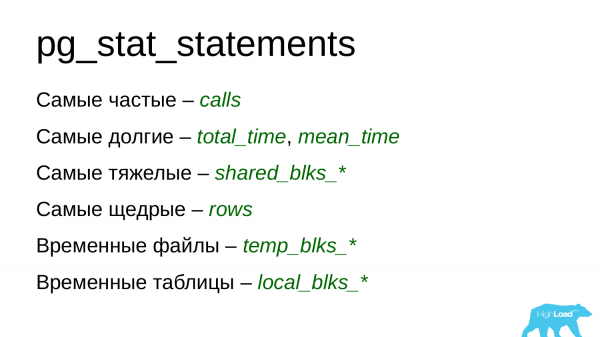
Y para obtener esta información, podemos usar el módulo pg_stat_statements. A partir de él, se pueden construir diversos gráficos. Por ejemplo, podemos obtener información sobre las consultas más frecuentes, es decir, aquellas que se ejecutan con mayor frecuencia. Sí, también es muy útil revisar esto después de los despliegues y entender si hay algún pico en las consultas.
Podemos monitorear las consultas más largas, es decir, aquellas que tardan más en ejecutarse. Estas consumen CPU y también utilizan entrada/salida. También podemos evaluar esto a través de los campos total_time, mean_time, blk_write_time y blk_read_time.
Podemos evaluar y monitorear las consultas más pesadas en términos de uso de recursos, aquellas que leen desde el disco, que trabajan con memoria o, por el contrario, que generan alguna carga de escritura.
Podemos evaluar las consultas más generosas. Estas son las consultas que devuelven un gran número de filas. Por ejemplo, podría ser una consulta donde se olvidó establecer un límite y retorna todo el contenido de la tabla o consulta de las tablas solicitadas.
Y también se pueden monitorear las consultas que utilizan archivos temporales o tablas temporales.
Y nos quedan los procesos en segundo plano. Los procesos en segundo plano son, en primer lugar, los checkpoints, también llamados puntos de control, el autovacuum y la replicación.
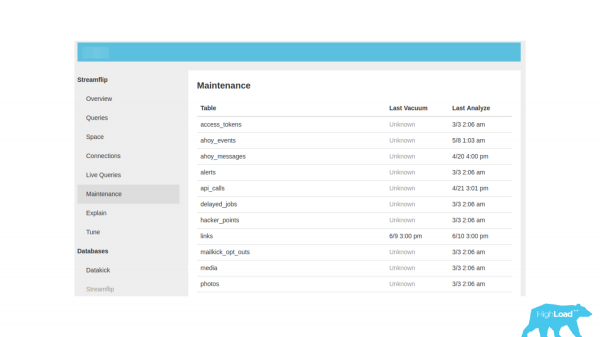
Otro ejemplo de monitoreo. Hay una pestaña a la izquierda llamada Mantenimiento, la abrimos con la esperanza de ver algo útil. Pero aquí solo hay tiempo de ejecución del vacuum y la recolección de estadísticas, nada más. Esta es una información muy escasa, por lo que siempre es necesario tener información sobre cómo están funcionando los procesos en segundo plano en nuestra base de datos y si hay problemas por su funcionamiento.
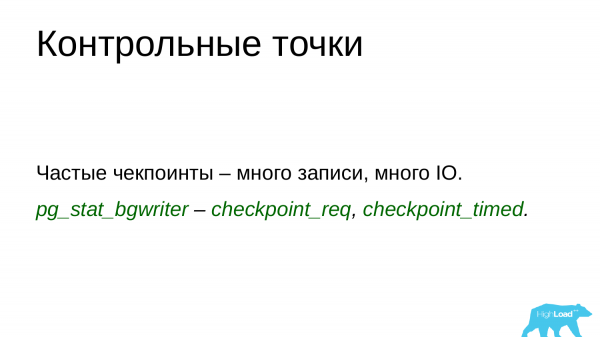
Cuando consideramos los puntos de control, debemos recordar que los puntos de control descargan las páginas 'sucias' del área de memoria compartida al disco y luego crean un punto de control. Este punto de control puede ser utilizado posteriormente como un lugar durante la recuperación, en caso de que PostgreSQL se cierre de manera anómala.
Por lo tanto, para volcar todas las páginas «sucias» en el disco, es necesario ejecutar un cierto volumen de escritura. Y, por lo general, en sistemas con una gran cantidad de memoria, esto conlleva un volumen muy elevado. Si los puntos de control se realizan con mucha frecuencia en un corto intervalo de tiempo, el rendimiento del disco disminuirá significativamente. Las consultas de los clientes sufrirán por la falta de recursos. Lucharán por los recursos y no tendrán suficiente rendimiento.
Por lo tanto, a través de pg_stat_bgwriter, podemos monitorear el número de puntos de control que ocurren por los campos especificados. Si en un intervalo de tiempo determinado (10-15-20 minutos, media hora) se producen muchos puntos de control, por ejemplo, 3-4-5, esto ya puede ser un problema. Y es necesario revisar la base de datos, examinar la configuración para ver qué está causando tal abundancia de puntos de control. Puede ser que se esté realizando una gran escritura. Con la carga de trabajo, ya podemos evaluar, ya que tenemos los gráficos de carga de trabajo añadidos. Podemos ajustar los parámetros de los puntos de control y hacer que no influyan demasiado en el rendimiento de las consultas.
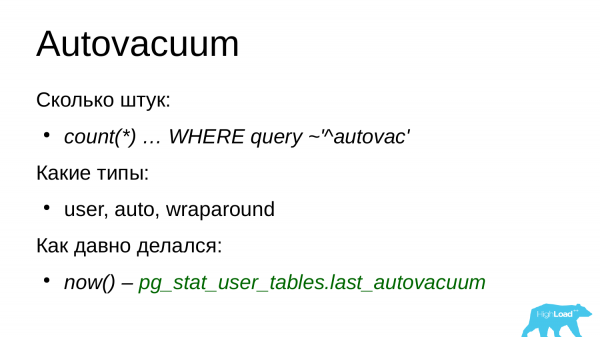
Vuelvo a mencionar el autovacuum, porque es algo que, como ya he mencionado, puede afectar fácilmente tanto al rendimiento de los discos como al de las consultas, por lo que siempre es importante evaluar la cantidad de autovacuum.
El número de trabajadores de autovacuum en la base de datos está limitado. Por defecto, hay tres, así que si siempre hay tres trabajadores funcionando en la base, eso significa que nuestro autovacuum está mal configurado; es necesario aumentar los límites y revisar las configuraciones de autovacuum y entrar en la configuración.
Es importante evaluar qué trabajadores de vacuum están activos. Puede ser que haya un vacuum iniciado por un usuario, donde un DBA lo haya ejecutado manualmente, lo que ha creado una carga. Puede haberse presentado algún problema. O puede ser por la cantidad de vacuums que están contabilizando las transacciones. Para algunas versiones de PostgreSQL, estos son vacuums muy pesados. Y pueden afectar considerablemente al rendimiento, ya que leen toda la tabla en su totalidad, escaneando todos los bloques de esa tabla.
Y, por supuesto, la duración de los vacíos. Si tenemos vacíos largos que funcionan durante mucho tiempo, significa que debemos volver a prestar atención a la configuración del vacío y, posiblemente, revisar sus ajustes. Porque puede surgir una situación en la que el vacío esté trabajando en una tabla durante mucho tiempo (3-4 horas), pero durante ese tiempo se ha acumulado un gran volumen de filas muertas en la tabla. Y tan pronto como el vacío se complete, necesitará volver a vaciar esa tabla. Y llegamos a una situación de vacío interminable. En ese caso, el vacío no cumple su función, y las tablas comienzan a aumentar de tamaño, aunque el volumen de datos útiles permanezca constante. Por lo tanto, en el caso de vacíos prolongados, siempre revisamos la configuración y tratamos de optimizarla, pero sin afectar el rendimiento de las consultas de los clientes.
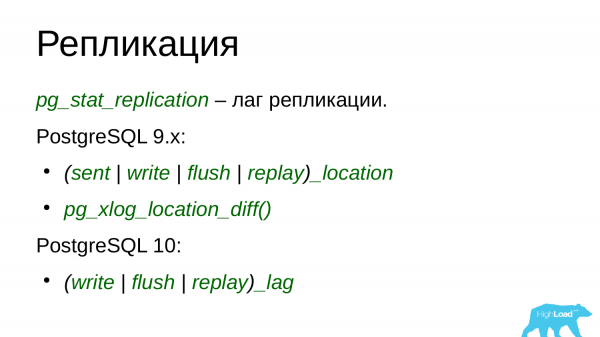
Hoy en día, prácticamente no hay instalaciones de PostgreSQL que no tengan replicación en streaming. La replicación es el proceso de transferencia de datos del maestro a la réplica.
La replicación en PostgreSQL se basa en el registro de transacciones. El maestro genera el registro de transacciones. El registro de transacciones se envía a través de una conexión de red a la réplica, donde se reproduce. Todo es bastante simple.
Por lo tanto, para monitorear el retraso en la replicación se utiliza la vista pg_stat_replication. Pero no es tan simple. En la versión 10, la vista sufrió varios cambios. En primer lugar, algunos campos fueron renombrados. Y se añadieron algunos campos. En la versión 10 aparecieron campos que permiten evaluar el retraso de la replicación en segundos. Esto es muy conveniente. Antes de la versión 10, era posible evaluar el retraso de la replicación en bytes. Esa opción se mantuvo también en la versión 10, es decir, puedes elegir lo que te convenga más: evaluar el retraso en bytes o en segundos. Muchos hacen ambas cosas.
Sin embargo, para evaluar el retraso en la replicación, es necesario conocer la posición del registro en la transacción. Y esas posiciones del registro de transacciones están en la vista pg_stat_replication. En términos simples, con la función pg_xlog_location_diff() podemos tomar dos puntos en el registro de transacciones, calcular la diferencia entre ellos y obtener el retraso de la replicación en bytes. Esto es muy conveniente y simple.
En la versión 10, esta función fue renombrada a pg_wal_lsn_diff(). En general, en todas las funciones, vistas y utilidades donde aparecía la palabra «xlog», se ha reemplazado por «wal». Esto aplica tanto a las vistas como a las funciones. Esta es una novedad.
Además, en la versión 10 se añadieron líneas que muestran específicamente el retraso. Esto incluye write lag, flush lag y replay lag. Es decir, estas métricas son importantes para monitorear. Si vemos que hay un retraso en la replicación, es necesario investigar por qué ocurrió, de dónde proviene y solucionar el problema.
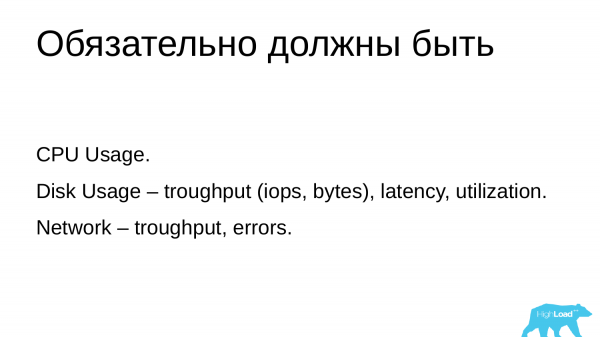
Con las métricas del sistema, prácticamente todo está en orden. Cuando se implementa cualquier tipo de monitoreo, comienza con las métricas del sistema. Esto incluye la utilización de CPU, memoria, swap, red y disco. Sin embargo, muchos parámetros por defecto no están disponibles.
Si la utilización del proceso está en orden, hay problemas con la utilización del disco. Por regla general, los desarrolladores de monitoreo añaden información sobre el ancho de banda. Esto puede expresarse en IOPS o bytes. Pero se olvidan de la latencia y la utilización de los dispositivos de disco. Estos son parámetros más importantes que permiten evaluar cuán ocupados están los discos y cuán lentos son. Si tenemos una alta latencia, significa que hay problemas con los discos. Si la utilización es alta, significa que los discos no están rindiendo adecuadamente. Estas son características de mayor calidad que el ancho de banda.
A pesar de que esta estadística también se puede obtener del sistema de archivos /proc, como se hace para la utilización de CPU. No sé por qué esta información no se añade a los monitoreos. Sin embargo, es importante tenerla en tu monitoreo.
Lo mismo ocurre con las interfaces de red. Hay información sobre el ancho de banda de la red en paquetes, en bytes, pero no hay información sobre la latencia ni sobre la utilización, aunque esto también es información útil.
Todos los monitoreos tienen desventajas. Cualquier monitoreo que elijas siempre no cumplirá con algunos criterios. Sin embargo, están evolucionando, se añaden características nuevas, así que elige algo y ajústalo.
Y para ajustar, siempre es necesario tener claro qué significa la estadística entregada y cómo puede ayudar a resolver problemas.
Y varios puntos clave:
- Siempre es necesario monitorear la disponibilidad, tener paneles de control para que puedas evaluar rápidamente que la base de datos está en orden.
- Siempre es fundamental tener una idea de qué clientes están trabajando con tu base de datos para filtrar a aquellos que no son buenos clientes y excluirlos.
- Es importante evaluar cómo estos clientes interactúan con los datos. Necesitas tener una noción de tu carga de trabajo.
- Es crucial evaluar cómo se forma esta carga de trabajo, qué tipos de consultas se utilizan. Puedes medir las consultas, optimizarlas, refactorizarlas y construir índices para ellas. Esto es muy importante.
- Los procesos en segundo plano pueden afectar negativamente las consultas de los clientes, por lo que es importante monitorear que no usen demasiados recursos.
- Las métricas del sistema te permiten planificar la escalabilidad y el aumento de la capacidad de tus servidores, por lo que también es esencial monitorearlas y evaluarlas.
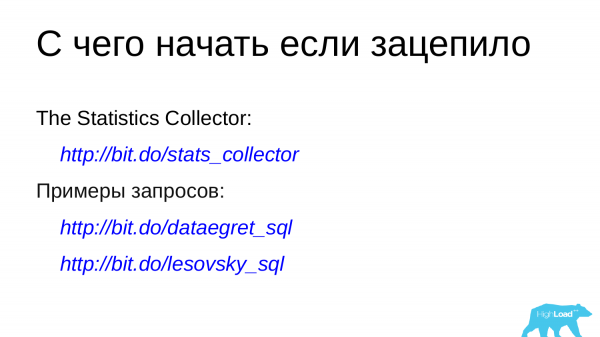
Si te interesa este tema, puedes seguir estos enlaces.
— es la documentación oficial de los recolectores de estadísticas. Allí se describe todas las vistas estadísticas y todos los campos. Puedes leerlos, entenderlos y analizarlos. Y ya en base a ellos construir tus propios gráficos, añadirlos a tus monitoreos.
Ejemplos de consultas:
Este es nuestro repositorio corporativo y el mío personal. Contiene ejemplos de consultas. No hay consultas del tipo select * from algo. Ya están preparadas las consultas con joins y el uso de funciones interesantes que permiten convertir números crudos en valores legibles y útiles, es decir, bytes, tiempo. Puedes explorarlos, revisarlos, analizarlos, incluirlos en tus monitoreos y construir tus propios análisis basados en ellos.
Preguntas
Pregunta: Dijiste que no ibas a promocionar marcas, pero tengo curiosidad, ¿qué paneles de control utilizas en tus proyectos?
Respuesta: De varias maneras. A veces llegamos al cliente y ya tiene su propio monitoreo. Y nosotros asesoramos al cliente sobre qué debería agregar a su monitoreo. Lo que más complica es Zabbiх, porque no tiene la capacidad de construir gráficos TopN. Nosotros utilizamos , porque asesoramos a estos chicos sobre monitoreo. Ellos establecieron un monitoreo de PostgreSQL basado en nuestros requisitos. Estoy trabajando en mi proyecto personal, que recopila datos a través de Prometheus y los visualiza en . Tengo la tarea de crear mi propio exportador en Prometheus y luego representar todo en Grafana.
Pregunta: ¿Hay algunos análogos de los informes AWR o... agregaciones? ¿Sabe usted algo sobre esto?
Respuesta: Sí, sé qué es AWR, es algo genial. Actualmente hay diversas implementaciones que realizan aproximadamente el mismo modelo. A intervalos de tiempo, se escriben algunos baselines en PostgreSQL o en un almacenamiento separado. Se pueden encontrar en internet, existen. Uno de los desarrolladores de tal cosa está en el foro sql.ru en la sección de PostgreSQL. Se le puede contactar allí. Sí, existen tales métodos, se pueden usar. Además, yo también estoy creando algo que permite hacer lo mismo. también estoy escribiendo una cosa que permite hacer lo mismo.
P.D.1 Si está utilizando postgres_exporter, ¿qué panel de control está usando? Hay varios. Están algo desactualizados. ¿Tal vez la comunidad pueda crear una plantilla actualizada?
P.D.2 He eliminado pganalyze, ya que es una oferta SaaS propietaria que se centra en el monitoreo del rendimiento y sugerencias de ajuste automático.
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Cuál es el monitoreo postgresql autohospedado (con panel de control) que considera el mejor?
30,0%Zabbix + complementos de Alexey Lesovsky o zabbix 4.4 o libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze es una plataforma SaaS propietaria — no puedo eliminarlo1
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 usuarios votaron. 26 usuarios se abstuvieron.
Fuente: habr.com
