

Introducción
 «Es necesario correr con todas nuestras fuerzas solo para mantenernos en el lugar,
y para llegar a algún lugar, hay que correr al menos el doble de rápido!»
(c) Alicia en el país de las maravillas
Hace algún tiempo, se me pidió que diera una conferencia a los analistas de nuestra empresa sobre el diseño de modelos de datos, ya que al estar mucho tiempo en proyectos (a veces durante varios años) perdemos de vista lo que sucede en el mundo de las tecnologías de la información. En nuestra empresa (así ha sucedido) en muchos proyectos no se utilizan bases de datos NoSQL (al menos por ahora), por lo que en mi conferencia presté un poco de atención a ellas usando como ejemplo HBase y traté de orientar la presentación del material a aquellos que nunca han trabajado con ellas. En particular, ilustré algunas características del diseño del modelo de datos con un ejemplo que leí hace unos años . Al analizar ejemplos, comparé entre sí varias opciones para resolver la misma tarea, con el fin de transmitir mejor las ideas principales a los oyentes.
Recientemente, «sin nada que hacer», me hice la pregunta (los largos fines de semana de mayo en modo de cuarentena son especialmente propicios para ello), ¿en qué medida las teorías se corresponden con la práctica? Así fue como nació la idea de este artículo. Un desarrollador que trabaja con NoSQL desde hace tiempo quizás no encuentre nada nuevo en él (y por eso puede pasar rápidamente la mitad del artículo). Pero para los analistas, que aún no han trabajado intensamente con NoSQL, creo que será útil para obtener una comprensión básica de las características del diseño de modelos de datos para HBase.
Análisis de un ejemplo
En mi opinión, antes de comenzar a utilizar bases de datos NoSQL, es necesario reflexionar bien y sopesar los "pros" y "contras". A menudo, es probable que se pueda resolver el problema también con bases de datos relacionales tradicionales. Por lo tanto, es mejor no usar NoSQL sin razones sólidas para ello. Si, sin embargo, se toma la decisión de usar una base de datos NoSQL, hay que tener en cuenta que los enfoques de diseño son algo diferentes. Especialmente algunos de ellos pueden ser poco familiares para aquellos que solo han trabajado con bases de datos relacionales (según mis observaciones). Así, en el mundo "relacional" solemos partir de la modelación del dominio y después, si es necesario, realizamos la desnormalización del modelo. En NoSQL, en cambio, debemos considerar desde el inicio los escenarios previstos para trabajar con los datos y desnormalizar los datos desde el principio. Además, hay una serie de otras diferencias que se describirán a continuación.
Consideremos el siguiente problema "sintético" con el que trabajaremos a continuación:
Es necesario diseñar la estructura de almacenamiento de la lista de amigos de los usuarios de una red social abstracta. Para simplificar, supongamos que todas las conexiones son unidireccionales (como en Instagram, y no en Linkedin). La estructura debe permitir eficientemente:
- Responder a la pregunta de si el usuario A sigue al usuario B (patrón de lectura)
- Permitir agregar/eliminar conexiones en caso de que el usuario A siga/deje de seguir al usuario B (patrón de modificación de datos)
Por supuesto, hay muchas formas de resolver el problema. En una base de datos relacional normal, probablemente simplemente crearíamos una tabla de relaciones (posiblemente tipificada, si, por ejemplo, se necesita almacenar el grupo de usuarios: familia, trabajo, etc., al que pertenece este "amigo"), y para optimizar la velocidad de acceso, agregaríamos índices/particionamiento. Lo más probable es que la tabla final se vería algo así:
user_id
friend_id
Vasya
Petya
Vasya
Olya
aquí y en lo sucesivo, para mayor claridad y mejor comprensión, en lugar de ID utilizaré nombres
En el caso de HBase, sabemos que:
- una búsqueda efectiva que no conduzca a un escaneo completo de la tabla es posible exclusivamente por clave
- De hecho, por eso escribir las consultas SQL familiares para este tipo de bases de datos es una mala idea; técnicamente, claro, puedes enviar una consulta SQL con joins y otra lógica a HBase desde Impala, pero cuán eficiente será eso...
Por eso, debemos usar el ID del usuario como clave. Y la primera idea sobre "dónde y cómo almacenar los ID de los amigos" puede ser la de almacenarlos en columnas. Esta opción es la más obvia y "naïve", y se vería algo así (llámalo Opción 1 (predeterminada), para hacer referencia a ello más adelante):
RowKey
Columnas
Vasya
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Aquí, cada fila corresponde a un usuario de la red. Las columnas tienen nombres: 1, 2, ... — según el número de amigos, y en las columnas se almacenan los ID de los amigos. Es importante notar que cada fila tendrá un número diferente de columnas. En el ejemplo de la imagen anterior, una fila tiene tres columnas (1, 2 y 3), mientras que la segunda tiene solo dos (1 y 2): aquí hemos utilizado dos propiedades de HBase que no están en las bases de datos relacionales:
- la capacidad de cambiar dinámicamente la composición de las columnas (agregamos un amigo -> añadimos una columna, eliminamos un amigo -> eliminamos una columna)
- las diferentes filas pueden tener configuraciones de columnas distintas
Verifiquemos nuestra estructura para ver si cumple con los requisitos de la tarea:
- Lectura de datos: para entender si Vasya sigue a Olya, necesitamos leer toda la fila por la clave RowKey = "Vasya" y revisar los valores de las columnas hasta "encontrar" a Olya en ellas. O revisar los valores de todas las columnas, "no encontrar" a Olya y devolver la respuesta False;
- Modificación de datos: agregar un amigo: para dicha tarea, también necesitaremos leer toda la fila por la clave RowKey = "Vasya", para contar el número total de amigos que tiene. Este número total de amigos es necesario para determinar el número de la columna en la que se debe escribir el ID del nuevo amigo.
- Modificación de datos: eliminar un amigo:
- Es necesario leer toda la fila por la clave RowKey = "Vasya" y revisar las columnas para encontrar aquella en la que está registrado el amigo que se elimina;
- Después, tras eliminar al amigo, necesitamos "desplazar" todos los datos una columna hacia arriba, para evitar "saltos" en su numeración.
Ahora evaluemos qué tan eficientes serán los algoritmos que necesitamos implementar del lado de la "aplicación hipotética" utilizando Llamemos a la cantidad de nuestra hipotética red social n. Entonces, el número máximo de amigos que un usuario puede tener puede ser (n-1). Podemos desestimar este (-1) para nuestros propósitos, ya que en el uso de la notación Big O es irrelevante.
- Lectura de datos: es necesario leer toda la fila y examinar todos sus columnas al límite. Por lo tanto, la estimación superior de los costos será aproximadamente O(n)
- Modificación de datos: agregar un amigo: para determinar la cantidad de amigos es necesario revisar todas las columnas de la fila, después de lo cual se inserta una nueva columna => O(n)
- Modificación de datos: eliminar un amigo:
- De manera similar a la adición, es necesario revisar todas las columnas al límite => O(n)
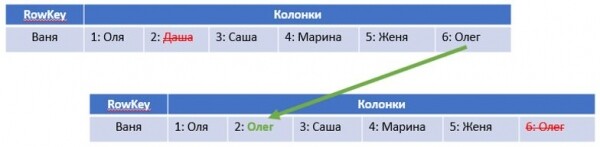
- Después de eliminar columnas, necesitamos "desplazarlas". Si se implementa de manera "directa", al límite se requerirán hasta (n-1) operaciones. Sin embargo, aquí y en adelante, en la parte práctica aplicaremos un enfoque diferente que realizará un "pseudo-desplazamiento" utilizando un número fijo de operaciones; es decir, tomará tiempo constante independientemente de n. Este tiempo constante (siendo precisos, O(2)) se puede desestimar en comparación con O(n). Este enfoque se ilustra en la figura a continuación: simplemente copiamos los datos de la "última" columna a aquella de donde se deben eliminar los datos, después de lo cual eliminamos la última columna:

En resumen, en todos los escenarios hemos obtenido una complejidad computacional asintótica O(n).
Probablemente ya habrán notado que casi siempre tenemos que leer toda la fila desde la base, y en dos de los tres casos, solo para revisar todas las columnas y contar el número total de amigos. Por lo tanto, como un intento de optimización, podemos añadir una columna "count", donde se almacene el número total de amigos de cada usuario de la red. En este caso, no necesitamos leer toda la fila para contar el número total de amigos, sino que solo leeremos una columna "count". Lo importante es no olvidar actualizar "count" al manipular los datos. Así obtenemos una mejora. Opción 2 (count):
RowKey
Columnas
Vasya
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
En comparación con la primera opción:
- Lectura de datos: para obtener una respuesta a la pregunta "¿Lee Vasya a Olya?" nada ha cambiado => O(n)
- Modificación de datos: agregar un amigo: Hemos simplificado la inserción de un nuevo amigo, ya que ahora no necesitamos leer toda la fila y recorrer sus columnas, sino que podemos obtener solo el valor de la columna «count» y así determinar de inmediato el número de columna para insertar el nuevo amigo. Esto reduce la complejidad computacional a O(1)
- Modificación de datos: eliminar un amigo: Al eliminar un amigo, también podemos utilizar esta columna para reducir el número de operaciones de entrada/salida al «desplazar» los datos una celda a la izquierda. Pero la necesidad de recorrer las columnas para encontrar la que necesitamos eliminar sigue presente, por lo tanto => O(n)
- Por otro lado, ahora, al actualizar los datos, necesitamos actualizar cada vez la columna «count», pero esto toma un tiempo constante, que en el marco de la notación O se puede despreciar.
En general, la opción 2 parece un poco más óptima, pero es más bien una «evolución en lugar de una revolución». Para realizar una «revolución» necesitaremos Opción 3 (col).
Invertiremos todo «de pies a cabeza»: asignaremos el nombre de la columna como identificador del usuario.! Lo que se registre en la propia columna ya no es importante para nosotros, puede ser el número 1 (en realidad, se pueden almacenar cosas útiles, como grupos «familia/amigos/etc.»). Este enfoque puede sorprender a un «profano» no preparado que no tuvo experiencia previa con bases de datos NoSQL, pero es el que permite aprovechar el potencial de HBase en esta tarea de manera mucho más eficiente:
RowKey
Columnas
Vasya
Petya: 1
Olya: 1
Dasha: 1
Petya
Masha: 1
Vasya: 1
Aquí obtenemos varias ventajas al mismo tiempo. Para entenderlas, analicemos la nueva estructura y evaluemos la complejidad computacional:
- Lectura de datos: para responder a la pregunta de si Vasya está suscrito a Olya, basta con leer una columna «Olya»: si existe, la respuesta es True, si no, es False => O(1)
- Modificación de datos: agregar un amigo: Agregar un amigo: solo es necesario agregar una nueva columna «ID de amigo» => O(1)
- Modificación de datos: eliminar un amigo: solo es necesario eliminar la columna «ID de amigo» => O(1)
Como vemos, una ventaja significativa de este modelo de almacenamiento es que en todos los escenarios necesarios solo operamos con una única columna, evitando la lectura de toda la fila de la base de datos y, mucho menos, el recorrido de todas las columnas de esa fila. Podríamos detenernos aquí, pero…
Se puede reflexionar y profundizar aún más en la optimización del rendimiento y la reducción de las operaciones de entrada/salida al acceder a la base de datos. ¿Qué pasaría si almacenamos toda la información de la relación directamente en la clave de la fila? Es decir, hacer una clave compuesta del tipo userID.friendID? En este caso, ni siquiera tendríamos que leer las columnas de la fila.Opción 4 (fila)):
RowKey
Columnas
Vasya.Petya
Petya: 1
Vasya.Olya
Olya: 1
Vasya.Dasha
Dasha: 1
Petya.Masha
Masha: 1
Petya.Vasya
Vasya: 1
Es obvio que la evaluación de todos los escenarios de manipulación de datos en esta estructura será, al igual que en la opción anterior, O(1). La diferencia con la opción 3 será exclusivamente en la eficiencia de las operaciones de entrada/salida en la base de datos.
Y por último, un 'detalle'. Es fácil notar que en la opción 4 la clave de la fila tendrá una longitud variable, lo que podría afectar el rendimiento (recordemos que HBase almacena datos como un conjunto de bytes y las filas en las tablas están ordenadas por clave). Además, tenemos un separador que en algunos escenarios puede necesitar ser procesado. Para eliminar esta influencia, se pueden utilizar hashes de userID y friendID, y como ambos hashes tendrán una longitud constante, se pueden concatenar sin separador. Entonces, los datos en la tabla se verían así:Opción 5 (hash)):
RowKey
Columnas
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petya: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olya: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
Es evidente que la complejidad algorítmica del trabajo con tal estructura en los escenarios considerados será la misma que en la opción 4 – es decir, O(1).
Por lo tanto, resumamos todas nuestras estimaciones de complejidad computacional en una sola tabla:
Agregar amigo
Verificar amigo
Eliminar amigo
Opción 1 (predeterminada)
O(n)
O(n)
O(n)
Opción 2 (cuenta)
O(1)
O(n)
O(n)
Opción 3 (columna)
O(1)
O(1)
O(1)
Opción 4 (fila)
O(1)
O(1)
O(1)
Opción 5 (hash)
O(1)
O(1)
O(1)
Como se puede ver, las opciones 3-5 parecen ser las más preferibles y teóricamente garantizan la ejecución de todos los escenarios necesarios de manipulación de datos en tiempo constante. En el enunciado de nuestra tarea no hay un requisito explícito para obtener la lista de todos los amigos del usuario, pero en la actividad profesional real, como buenos analistas, sería prudente "prever" que tal tarea puede surgir y "preparar el terreno". Por lo tanto, mis preferencias están del lado de la opción 3. Sin embargo, es bastante probable que en un proyecto real esta consulta ya se haya resuelto por otros medios, por lo que sin una visión general del problema, es mejor no sacar conclusiones definitivas.
Preparación del experimento
Las reflexiones teóricas expuestas anteriormente me gustaría comprobarlas en la práctica - este fue el objetivo de la idea que surgió durante un largo fin de semana. Para esto, es necesario evaluar la velocidad de funcionamiento de nuestra "aplicación hipotética" en todos los escenarios de uso de la base descrita, así como el aumento de este tiempo con el crecimiento del tamaño de la red social (n). El parámetro objetivo que nos interesa y que mediremos durante el experimento es el tiempo que tarda la "aplicación hipotética" en realizar una "operación comercial". Por "operación comercial" entendemos una de las siguientes:
- Agregar un nuevo amigo
- Verificar si el usuario A es amigo del usuario B
- Eliminar un amigo
Así, teniendo en cuenta los requisitos delineados en la formulación inicial, el escenario de verificación se presenta de la siguiente manera:
- Registro de datos. Generar aleatoriamente una red inicial de tamaño n. Para aproximarnos más al "mundo real", la cantidad de amigos de cada usuario también será una variable aleatoria. Medir el tiempo que tarda nuestra "aplicación hipotética" en registrar todos los datos generados en HBase. Luego, dividir el tiempo obtenido por el número total de amigos añadidos, así obtendremos el tiempo promedio por una "operación comercial".
- Lectura de datos. Para cada usuario, crear una lista de "identidades" para las cuales se debe obtener una respuesta sobre si el usuario está suscrito o no. La longitud de la lista es aproximadamente igual al número de amigos del usuario, de los cuales la mitad debe tener una respuesta de "Sí" y la otra mitad de "No". La verificación se realiza de tal manera que las respuestas de "Sí" y "No" se alternen (es decir, en cada segundo caso, tendremos que revisar todas las columnas de la fila para las opciones 1 y 2). El tiempo total de verificación se divide luego entre el número de amigos verificados para obtener el tiempo promedio de verificación de un sujeto.
- Eliminación de datos. Eliminar todos los amigos de un usuario. El orden de eliminación será aleatorio (es decir, "mezclamos" la lista original utilizada para registrar los datos). El tiempo total de verificación se divide luego entre el número de amigos eliminados para obtener el tiempo promedio de una verificación.
Los escenarios deben ejecutarse para cada uno de los 5 variantes de modelos de datos y para diferentes tamaños de la red social, para observar cómo varía el tiempo a medida que crece. Dentro de una n conexiones en la red, la lista de usuarios para verificar debe ser, naturalmente, la misma para las 5 variantes.
Para una mejor comprensión, a continuación, presento un ejemplo de datos generados para n= 5. El "generador" escrito produce tres diccionarios de ID:
- el primero – para insertar
- el segundo – para verificar
- el tercero – para eliminar
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # total 15 amigos

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # total 18 sujetos verificados

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # total 15 amigos
Como se puede notar, todos los ID mayores a 10,000 en el diccionario para verificar son precisamente aquellos que inevitablemente darán una respuesta False. La inserción, verificación y eliminación de "amigos" se realizan exactamente en el orden indicado en el diccionario.
El experimento se realizó en una computadora portátil con Windows 10, donde en un contenedor de Docker se ejecutaba una base de datos HBase y en el otro – Python con Jupyter Notebook. Se asignaron 2 núcleos de CPU y 2 GB de memoria RAM al contenedor de Docker. Toda la lógica, tanto la emulación del funcionamiento de una "aplicación condicional" como la "envoltura" para generar datos de prueba y medir el tiempo, fueron escritas en Python. Para trabajar con HBase se utilizó la biblioteca , para calcular los hashes (MD5) para la opción 5 — hashlib
Teniendo en cuenta la potencia de cálculo de la laptop específica, se eligió experimentalmente una ejecución para n = 10, 30, … 170, cuando el tiempo total de ejecución de todo el ciclo de pruebas (todos los escenarios para todas las opciones para todos los n) aún era más o menos razonable y cabía en el tiempo de una merienda (promedio 15 minutos).
Es necesario hacer una observación aquí, que en este experimento en primer lugar no estamos evaluando las cifras absolutas de rendimiento. Incluso la comparación relativa de las dos opciones puede no ser del todo correcta. Ahora nos interesa principalmente el carácter del cambio en el tiempo en función de n, ya que, teniendo en cuenta la configuración del 'entorno de pruebas' mencionada anteriormente, es muy complicado obtener estimaciones de tiempo 'limpias' de la influencia de factores aleatorios y otros (y tal tarea no estaba planteada).
Resultado del experimento
La primera prueba – cómo cambia el tiempo dedicado a llenar la lista de amigos. Resultado – en el gráfico a continuación.
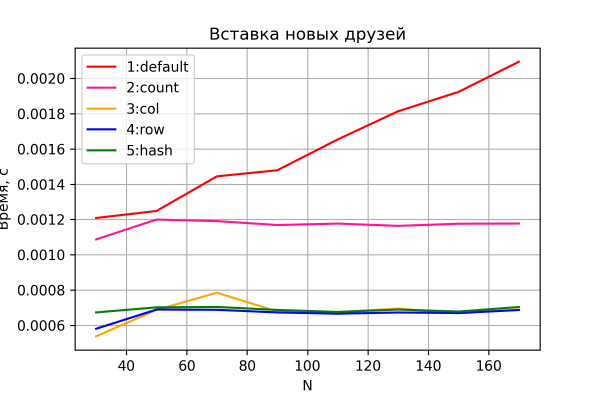
Las opciones 3-5 muestran, como era de esperar, un tiempo prácticamente constante para la 'operación de negocio', que no depende del crecimiento del tamaño de la red y una diferencia de rendimiento indistinguible.
La opción 2 también muestra un rendimiento constante, pero un poco peor, siendo prácticamente exactamente 2 veces menor que las opciones 3-5. Y esto no puede dejar de ser positivo, ya que coincide con la teoría: en esta opción, el número de operaciones de entrada/salida hacia/desde HBase es precisamente 2 veces mayor. Esto puede servir como un indicio indirecto de que nuestro entorno de pruebas da en principio una buena precisión.
La opción 1, como era de esperar, resulta ser la más lenta y demuestra un aumento lineal del tiempo dedicado a agregar un amigo con el tamaño de la red.
Veamos ahora los resultados de la segunda prueba.
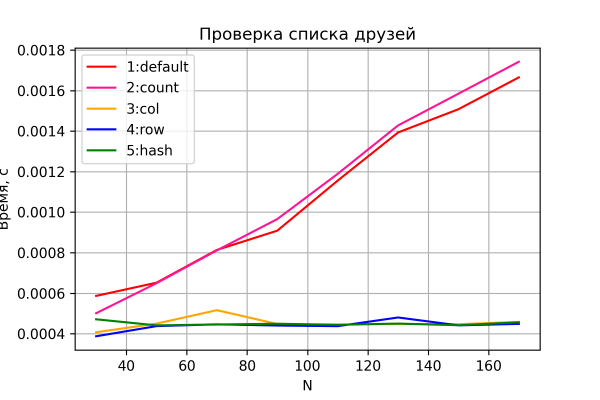
Las variantes 3-5 se comportan como se esperaba: tiempo constante, independientemente del tamaño de la red. Las variantes 1 y 2 muestran un crecimiento lineal del tiempo a medida que aumenta el tamaño de la red y un rendimiento similar. Sin embargo, la variante 2 resulta ser un poco más lenta, probablemente debido a la necesidad de leer y procesar la columna adicional 'count', lo que se vuelve más evidente con el aumento de n. Sin embargo, me abstendré de cualquier conclusión, ya que la precisión de esta comparación es relativamente baja. Además, estas relaciones (qué variante, 1 o 2, es más rápida) cambiaron de una ejecución a otra (manteniendo el carácter de la dependencia y "yendo codo a codo").
Y el último gráfico: el resultado de las pruebas de eliminación.
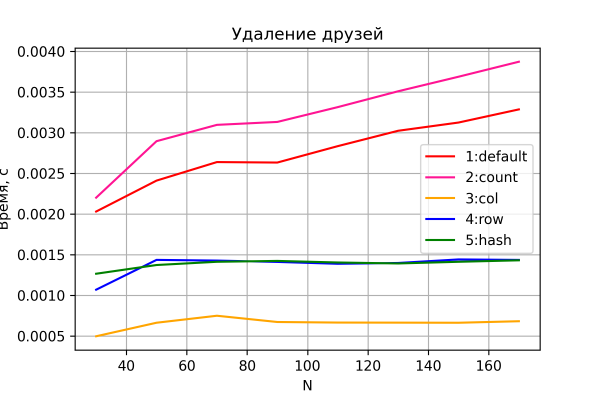
Aquí, de nuevo, sin sorpresas. Las variantes 3-5 realizan la eliminación en un tiempo constante.
De hecho, lo interesante es que las variantes 4 y 5, a diferencia de los escenarios anteriores, muestran un rendimiento notablemente peor que la variante 3. Parece que la operación de eliminación de filas es más costosa que la operación de eliminación de columnas, lo cual es bastante lógico.
Las variantes 1 y 2, como se esperaba, demon muestran un crecimiento lineal del tiempo. La variante 2 es consistentemente más lenta que la variante 1, debido a la operación de E/S adicional para "mantener" la columna count.
Conclusiones generales del experimento:
- Las variantes 3-5 muestran una mayor eficiencia, ya que aprovechan las ventajas de HBase; su rendimiento difiere entre sí por una constante y no depende del tamaño de la red.
- No se ha registrado diferencia entre las variantes 4 y 5. Pero esto no significa que la variante 5 no deba utilizarse. Es bastante probable que el escenario experimental utilizado, considerando las especificaciones del banco de pruebas, no haya permitido identificarla.
- El carácter del crecimiento del tiempo necesario para realizar "operaciones comerciales" con los datos, en general, confirmó las conclusiones teóricas obtenidas previamente para todas las variantes.
Epílogo
Los experimentos realizados no deben considerarse como la verdad absoluta. Hay muchos factores que no se tuvieron en cuenta y que distorsionaron los resultados (especialmente estas fluctuaciones son muy visibles en los gráficos con un tamaño de red pequeño). Por ejemplo, la velocidad de operación de thrift, que se utiliza en happybase, el volumen y la forma de implementación de la lógica que tenía escrita en Python (no afirmo que el código estuviera escrito de la manera óptima y eficiente utilizando todas las capacidades de los componentes), quizás las características de caché de HBase, la actividad en segundo plano de Windows 10 en mi computadora portátil, etc. En general, se puede considerar que todas las extrapolaciones teóricas mostraron su validez experimental. O al menos no fue posible refutarlas de esta manera en un
En conclusión — recomendaciones para todos aquellos que recién comienzan a diseñar modelos de datos en HBase: abstraerse de la experiencia previa con bases de datos relacionales y recordar los “mandamientos”:
- Al diseñar, partimos del problema y de las plantillas de manipulación de datos, no del modelo del dominio
- Acceso eficiente (sin escaneo completo de la tabla) – solo por clave
- Denormalización
- Diferentes filas pueden contener columnas distintas
- Composición dinámica de columnas
Fuente: habr.com
