

Al continuar revisando las tecnologías para acelerar las operaciones de entrada/salida en relación con los sistemas de almacenamiento, comenzando en , no se puede dejar de mencionar una opción bastante popular como el tiering (Auto Tiering). Aunque la ideología de funcionamiento de esta función es bastante similar entre los diferentes fabricantes de sistemas de almacenamiento, veremos las características de la implementación del tiering tomando como ejemplo .
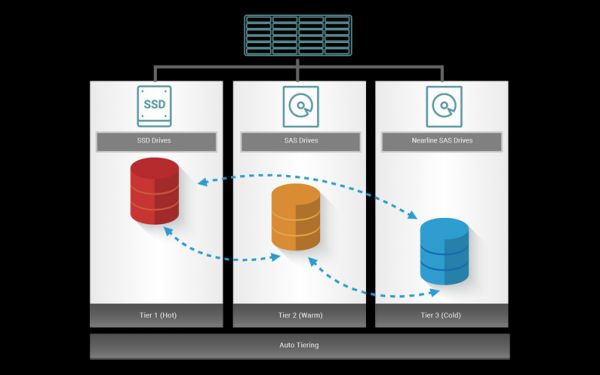
A pesar de la diversidad de datos almacenados en el sistema de almacenamiento, estos datos se pueden dividir en varios grupos según su demanda (frecuencia de uso). Para los datos más populares ('calientes'), es crucial organizar un acceso lo más rápido posible, mientras que el procesamiento de datos menos demandados ('fríos') se puede realizar con un menor prior.
Para organizar tal esquema, se aplica precisamente la funcionalidad del tiering. En este caso, el conjunto de datos no consiste en discos homogéneos, sino en varios grupos de dispositivos que forman diferentes niveles (tier) de almacenamiento. Mediante un algoritmo especial, los datos se mueven automáticamente entre los niveles con el fin de asegurar el máximo rendimiento final.
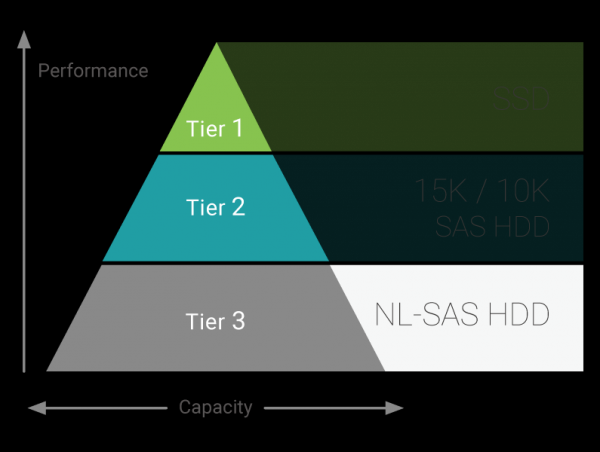
Sistema de almacenamiento soportan hasta tres niveles de almacenamiento:
- Tier 1: SSD, máxima rendimiento
- Tier 2: HDD SAS 10K/15K, alto rendimiento
- Tier 3: HDD NL-SAS 7.2K, máxima capacidad
El pool de Auto Tiering puede contener tanto los tres niveles como solo dos en cualquier combinación. Dentro de cada Tier, los dispositivos se agrupan en las habituales configuraciones RAID. Para una flexibilidad máxima, el nivel RAID en cada Tier puede ser diferente. Es decir, por ejemplo, nada impide organizar una estructura como 4x SSD RAID10 + 6x HDD 10K RAID5 + 12 HDD 7.2K RAID6
Después de crear volúmenes (discos virtuales) en el pool comienza la recopilación de estadísticas sobre todas las operaciones de entrada/salida en segundo plano. Para ello, el espacio se 'divide' en bloques de 1GB (los llamados sub LUN). En cada acceso a tal bloque, se le asigna un coeficiente de 1. Luego, con el tiempo, este coeficiente disminuye. Después de 24 horas, en ausencia de solicitudes de entrada/salida hacia este bloque, será igual a 0.5 y continuará disminuyendo cada hora siguiente.
En un momento determinado (por defecto, cada día a medianoche), se clasifica los resultados recopilados según la actividad de sub LUN basándose en sus coeficientes. A partir de esto, se toma la decisión sobre qué bloques mover y en qué dirección. Posteriormente, se lleva a cabo la reubicación de datos entre los niveles.
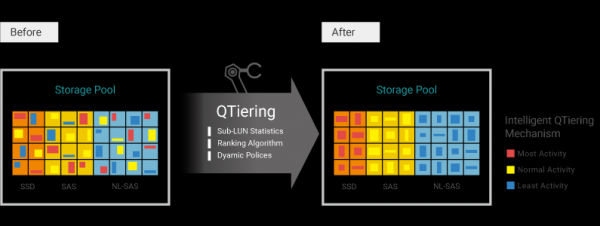
En el sistema de almacenamiento Qsan, la gestión del proceso de tiering está excelentemente implementada a través de múltiples parámetros, lo que permite ajustar de manera muy flexible el rendimiento final de la matriz.
Para determinar la ubicación inicial de los datos y la dirección prioritaria de su movimiento, se utilizan políticas que se establecen por separado para cada volumen:
- Auto Tiering – política por defecto, la ubicación inicial y la dirección de los movimientos se determinan automáticamente, es decir, los datos "calientes" tienden a ir al nivel más alto, mientras que los datos "fríos" se desplazan hacia abajo. La ubicación inicial se elige en función del espacio disponible en cada uno de los niveles. Sin embargo, hay que entender que el sistema intenta utilizar al máximo los dispositivos más rápidos. Por lo tanto, si hay espacio libre, los datos se ubicarán en los niveles superiores. Esta política es adecuada para la mayoría de los escenarios, cuando no se puede predecir la demanda de los datos con antelación.
- Comenzar alto y luego Auto Tiering – la diferencia con la anterior solo es la ubicación inicial de los datos (en el nivel más rápido)
- Nivel máximo alto – los datos siempre tienden a ocupar el nivel más rápido. Si durante el funcionamiento se desplazan hacia abajo, en la primera oportunidad se regresan. Esta política es adecuada para los datos que requieren acceso extremadamente rápido.
- Nivel mínimo – los datos siempre tienden a ocupar el nivel más bajo. Esta política es excelente para datos que se utilizan raramente (por ejemplo, archivos de respaldo).
- Sin movimiento – el sistema determina automáticamente la ubicación inicial de los datos y no realiza su movimiento. Sin embargo, las estadísticas continúan recopilándose por si en el futuro se requiere su reubicación.
Cabe destacar que, a pesar de que las políticas se definen al crear cada volumen, pueden cambiarse varias veces "en tiempo real" durante el ciclo de vida del sistema.
Además de las políticas para el mecanismo de tiering, también se configura la frecuencia y el ritmo de movimiento de los datos entre niveles. Se puede establecer un momento específico para la transferencia: diariamente o en días concretos de la semana, así como reducir el intervalo de recopilación de estadísticas a unas pocas horas (la frecuencia mínima es de 2 horas). Si es necesario limitar el tiempo de ejecución de la operación de transferencia de datos, se pueden definir límites temporales (ventanas para el movimiento). Además, se indica la velocidad de reubicación: 3 modos: rápido, medio, lento.
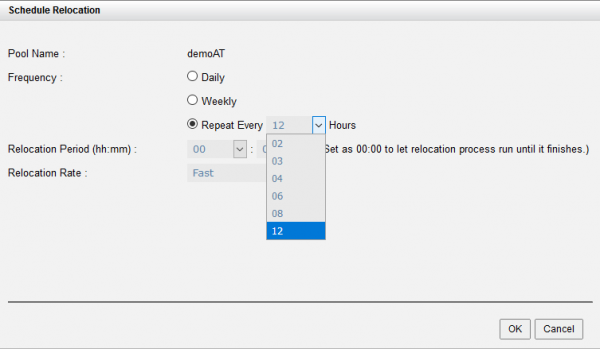
En caso de necesidad de una reubicación inmediata de datos, existe la posibilidad de realizarla manualmente en cualquier momento por orden del administrador.
Está claro que cuanto más frecuentemente y rápidamente se produzca el movimiento de datos entre niveles, más flexible será el sistema de almacenamiento bajo demanda en adaptarse a las condiciones de operación actuales. Pero también hay que recordar que el movimiento implica una carga adicional (principalmente en los discos), por lo que no se debe 'forzar' los datos sin una necesidad extrema. Es mejor programar el movimiento en momentos de carga mínima. Si el funcionamiento del sistema de almacenamiento siempre requiere un alto rendimiento en modo 24/7, entonces es recomendable reducir el ritmo de reubicación al mínimo.
La abundancia de configuraciones de tiering sin duda alegrará a los usuarios avanzados. Sin embargo, incluso para aquellos que se enfrentan a esta tecnología por primera vez, no hay nada de qué preocuparse. Es completamente posible confiar en las configuraciones predeterminadas (política de Auto Tiering, movimiento a máxima velocidad una vez al día por la noche) y, a medida que se acumule la estadística, ajustar algunos parámetros para alcanzar el resultado deseado.
Al comparar el tiering con otra tecnología igualmente popular de aumento de rendimiento, como , hay que recordar los diferentes principios que rigen sus algoritmos de trabajo.
el almacenamiento en caché SSD
Auto Tiering
La rapidez del efecto
Casi instantáneo. Pero el efecto notable solo se produce después de 'calentar' la caché (minutos-horas).
Después de la recopilación de estadísticas (desde 2 horas, idealmente – 24 horas) más el tiempo de movimiento de datos.
Duración del efecto
Hasta que los datos sean reemplazados por un nuevo conjunto (minutos-horas).
Mientras la demanda de los datos sea relevante (24 horas o más).
Indicaciones para su uso
Aumento instantáneo del rendimiento en un corto período (bases de datos, entornos de virtualización)
Aumento del rendimiento a largo plazo (servidores de archivos, web, correo)
Una de las características del tiering es la posibilidad de usarlo no solo para configuraciones del tipo «SSD + HDD», sino también para «HDD rápidos + HDD lentos» o incluso los tres niveles, lo que en el caso de la utilización de SSD para caché es en principio imposible.
Pruebas
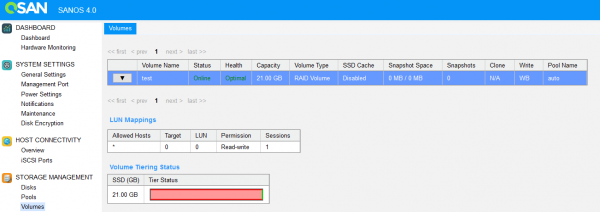
Para verificar el funcionamiento de los algoritmos de tiering, realizamos una prueba sencilla. Se creó un pool de dos niveles SSD (RAID 1) + HDD 7.2K (RAID 1), en el cual se ubicó un volumen con la política de «mínimo nivel». Es decir, los datos siempre deben estar en los discos lentos.
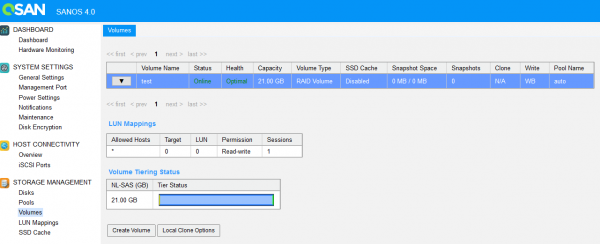
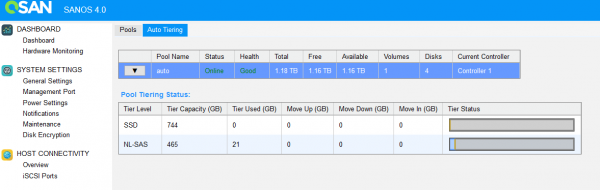
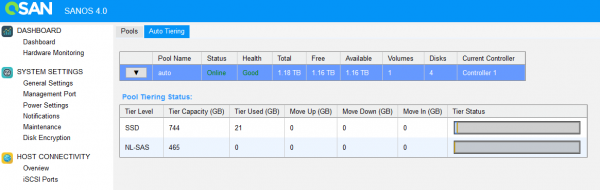
La interfaz de gestión muestra claramente la ubicación de los datos entre los niveles
Después de llenar el volumen con datos, cambiamos la política de ubicación a Auto Tiering y ejecutamos la prueba IOmeter.
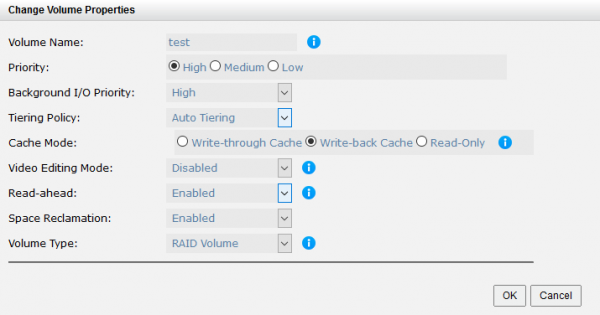
Después de varias horas de prueba, cuando el sistema pudo acumular estadísticas, comenzó el proceso de reubicación.
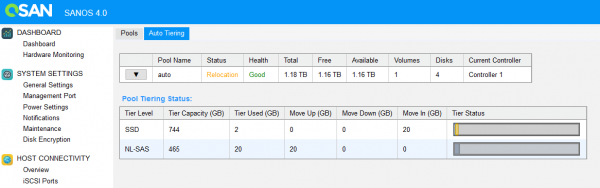
Al finalizar la transferencia de datos, nuestro volumen de prueba se trasladó completamente al nivel superior (SSD).
Veredicto
Auto Tiering es una tecnología magnífica que permite aumentar el rendimiento del sistema de almacenamiento con un mínimo costo material y de tiempo, a través de un uso más intensivo de los dispositivos de alta velocidad. Aplicable a la única inversión es la licencia, que se adquiere de una vez por todas sin limitaciones en la cantidad/volumen de discos/repositorios. Esta funcionalidad cuenta con configuraciones tan ricas que puede satisfacer prácticamente cualquier necesidad empresarial. Además, la visualización de los procesos en la interfaz permitirá gestionar el dispositivo de manera efectiva.
Fuente: habr.com
