

Si su infraestructura de TI crece demasiado rápido, tarde o temprano se enfrentará a la elección de aumentar linealmente los recursos humanos para su soporte o comenzar la automatización. Hasta cierto punto, vivimos en la primera paradigma, y luego comenzó un largo camino hacia la Infraestructura como Código.
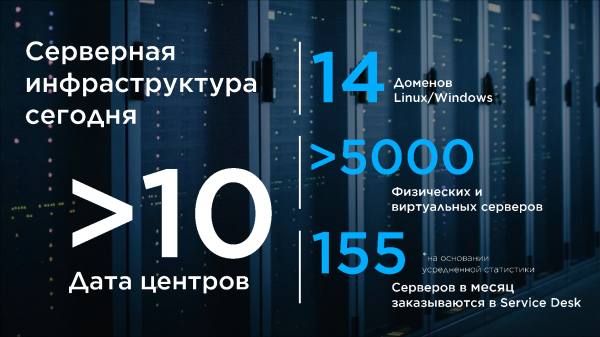
Por supuesto, NSPK no es un startup, pero esa atmósfera reinaba en la empresa durante los primeros años de existencia, y fueron años muy interesantes. Me llamo , durante más de 10 años he mantenido una infraestructura de Linux con altos requisitos de disponibilidad. Me uní al equipo de NSPK en enero de 2016 y, lamentablemente, no vi el inicio de la existencia de la empresa, pero llegué en una etapa de grandes cambios.
En general, se puede decir que nuestro equipo entrega a la empresa 2 productos. El primero es la infraestructura. El correo debe funcionar, DNS debe estar operativo, y los controladores de dominio deben permitirle acceder a servidores que no deben caerse. ¡El paisaje de TI de la empresa es enorme! Son sistemas críticos para el negocio y la misión, y algunos tienen requisitos de disponibilidad del 99,999. El segundo producto son los propios servidores, físicos y virtuales. Hay que supervisar los existentes y proporcionar regularmente nuevos a los clientes de múltiples departamentos. En este artículo quiero enfatizar cómo hemos desarrollado una infraestructura que es responsable del ciclo de vida servidores.
El comienzo del camino
Al principio, nuestra pila de tecnologías se veía así:
Sistema operativo CentOS 7
Controladores de dominio FreeIPA
Automatización — Ansible(+Tower), Cobbler
Todo esto estaba distribuido en 3 dominios, repartidos en varios centros de datos. En un centro de datos — sistemas de oficina y entornos de prueba, en los demás PROD.
La creación de servidores en algún momento se veía así:
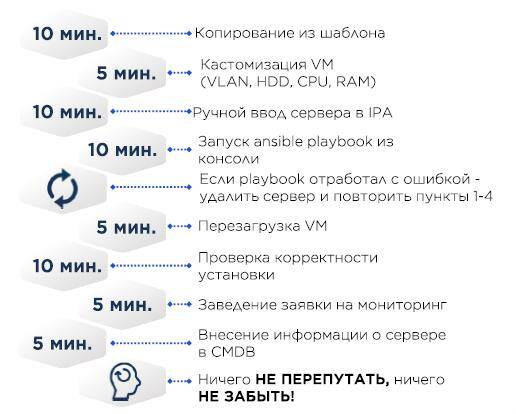
En la plantilla de VM CentOS minimal y el mínimo necesario como un correcto /etc/resolv.conf, lo demás llega a través de Ansible.
CMDB — Excel.
Si el servidor es físico, en lugar de copiar la máquina virtual, se instalaba el sistema operativo con Cobbler: se agregan las direcciones MAC del servidor objetivo al configurador de Cobbler, el servidor obtiene una dirección IP a través de DHCP y luego se instala el sistema operativo.
Al principio, incluso intentamos hacer algún tipo de gestión de configuración en Cobbler. Pero con el tiempo, esto comenzó a causar problemas con la portabilidad de las configuraciones tanto a otros centros de datos como en el código de Ansible para preparar las VM.
Muchos de nosotros en ese momento veíamos Ansible como una conveniente extensión de Bash y no escatimábamos en la construcción de scripts con shell y sed. En general, era como un Bashsible. Esto, en última instancia, llevaba a que si un playbook no funcionaba por alguna razón en el servidor, era más fácil eliminar el servidor, corregir el playbook y ejecutarlo nuevamente. No había realmente versionado los scripts ni portabilidad de las configuraciones.
Por ejemplo, quisimos cambiar alguna configuración en todos los servidores:
- Cambiamos la configuración en los servidores existentes en el segmento lógico/centro de datos. A veces no en un solo día, ya que los requisitos de disponibilidad y la ley de grandes números no permiten aplicar todos los cambios de una vez. Algunos cambios son potencialmente destructivos y requieren reiniciar algo, desde servicios hasta el mismo sistema operativo.
- Corregimos en Ansible
- Corregimos en Cobbler
- Repetimos N veces para cada segmento lógico/centro de datos
Para que todos los cambios se realicen sin problemas, era necesario tener en cuenta muchos factores, y los cambios ocurren constantemente.
- Refactorización del código ansible, archivos de configuración
- Cambio de prácticas recomendadas internas
- Cambios a raíz del análisis de incidentes/accidentes
- Cambio de estándares de seguridad, tanto internos como externos. Por ejemplo, PCI DSS se complementa cada año con nuevos requisitos.
Crecimiento de la infraestructura y comienzo del camino
El número de servidores/domains lógicos/centros de datos aumentaba, y con ello la cantidad de errores en las configuraciones. En algún momento llegamos a tres áreas en las que debíamos desarrollar la gestión de configuraciones:
- Automatización. En la medida de lo posible, hay que evitar el factor humano en operaciones repetitivas.
- Repetibilidad. Es mucho más fácil gestionar la infraestructura cuando es predecible. La configuración de los servidores y las herramientas para su preparación debe ser la misma en todas partes. Esto también es importante para los equipos de producto: la aplicación debe garantizar, tras la prueba, que llegue al entorno productivo configurado de manera similar al de prueba.
- Simplicidad y transparencia en la implementación de cambios en la gestión de configuraciones.
Solo queda agregar un par de herramientas.
Como repositorio de código elegimos GitLab CE, no en menor medida por la existencia de módulos integrados de CI/CD.
El almacenamiento de secretos es Hashicorp Vault, en parte por su excelente API.
Pruebas de configuraciones y roles de ansible – Molecule+Testinfra. Las pruebas son mucho más rápidas si conectas mitogen a ansible. Paralelamente, comenzamos a escribir nuestra propia CMDB y orquestador para el despliegue automático (en la imagen sobre Cobbler), pero esa es otra historia completamente diferente, de la que mi colega y principal desarrollador de estos sistemas hablará en el futuro.
Nuestra elección:
Molecule + Testinfra
Ansible + Tower + AWX
Mundo Servidores + DITNET (Desarrollo propio)
Cobbler
Gitlab + GitLab runner
Hashicorp Vault
Por cierto, sobre los roles de ansible. Inicialmente había uno, después de varias refactorizaciones se convirtieron en 17. Recomiendo encarecidamente dividir el monolito en roles idempotentes que luego se puedan ejecutar por separado, además se pueden añadir etiquetas. Dividimos los roles según funcionalidad – red, registro, paquetes, hardware, molecule, etc. En general, nos adherimos a la estrategia que se menciona a continuación. No insisto en que esto sea una verdad universal, pero a nosotros nos funcionó.
- ¡Copiar servidores desde una "imagen dorada" es un error!Entre las principales desventajas, no sabes en qué estado se encuentran las imágenes actualmente, y que todos los cambios se aplicarán a todas las imágenes en todas las granjas de virtualización.
- Usa los archivos de configuración por defecto lo menos posible y ponlo de acuerdo con otros departamentos, que tú eres responsable de los principales archivos del sistema., por ejemplo:
- Deja /etc/sysctl.conf vacío, las configuraciones deben estar solo en /etc/sysctl.d/. Tu configuración predeterminada en un archivo, personalizada para la aplicación en otro.
- Utiliza archivos override para editar unidades de systemd.
- Template todos los configs y colócalos enteros, siempre que sea posible, evita el uso de sed y sus análogos en los playbooks.
- Refactorizando el código del sistema de gestión de configuraciones:
- Divide las tareas en entidades lógicas y reescribe el monolito a roles.
- ¡Usa linters! Ansible-lint, yaml-lint, etc.
- ¡Cambia el enfoque! Nada de bashsible. Necesitamos describir el estado del sistema.
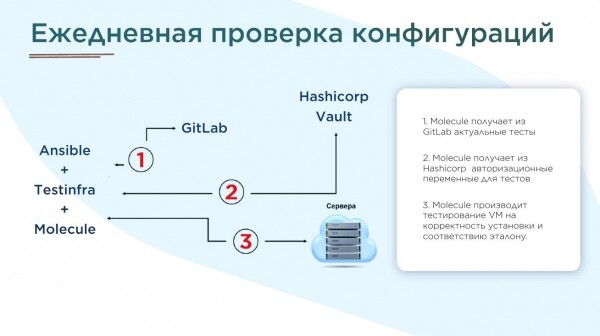
- Para todos los roles de Ansible, deben escribirse pruebas en molecule y generar informes una vez al día.
- En nuestro caso, después de preparar las pruebas (de las cuales hay más de 100) se encontraron alrededor de 70000 errores. Estuvimos corrigiendo durante varios meses.

Nuestra implementación
Entonces, los roles de ansible estaban listos, templateados y verificados por linters. Incluso los gits estaban levantados por todas partes. Pero la cuestión de la entrega confiable del código a diferentes segmentos seguía abierta. Decidimos sincronizar con scripts. Se ve así:
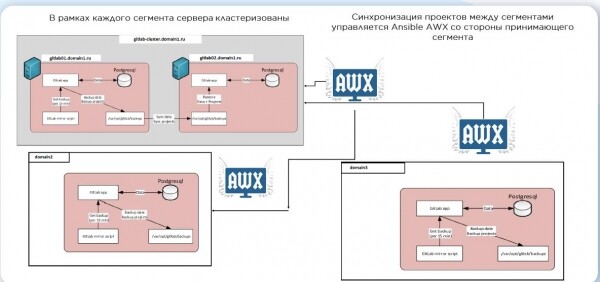
Una vez que llega el cambio, se lanza el CI, se crea un servidor de prueba, se aplican los roles y se prueba con Molecule. Si todo está bien, el código se mueve a la rama de producción. Sin embargo, no aplicamos el nuevo código automáticamente en los servidores existentes. Esto funciona como un freno, necesario para la alta disponibilidad de nuestros sistemas. Y cuando la infraestructura se vuelve enorme, también entra en juego la ley de los grandes números: incluso si estás seguro de que el cambio es inofensivo, puede tener consecuencias desastrosas.
Hay muchas maneras de crear servidores. Al final, elegimos scripts personalizados en Python. Y para el CI, Ansible:
- name: create1.yml - Crear una VM de una plantilla
  vmware_guest:
    hostname: "{{datacenter}}".domain.ru
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.ru
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Esto es a lo que hemos llegado, el sistema continúa viviendo y desarrollándose.
- 17 roles de Ansible para la configuración del servidor. Cada uno de los roles está destinado a resolver una tarea lógica específica (registro, auditoría, autorización de usuarios, monitoreo, etc.).
- Pruebas de roles. Molecule + TestInfra.
- Desarrollo propio: CMDB + Orquestador.
- El tiempo de creación de un servidor es de aproximadamente 30 minutos, automatizado y prácticamente independiente de la cola de tareas.
- Estado/nombre uniforme de la infraestructura en todos los segmentos: playbooks, repositorios, elementos de virtualización.
- Revisión diaria del estado de los servidores con generación de informes sobre discrepancias con el estándar.
Espero que mi relato sea útil para aquellos que están al principio del camino. ¿Qué conjunto de herramientas de automatización utilizas tú?
Fuente: habr.com
