

Hoy en la infraestructura de TI, con el uso generalizado de la virtualización, los sistemas de almacenamiento son el núcleo que aloja todas las máquinas virtuales. La falla de este nodo puede detener por completo el funcionamiento del centro de datos. Aunque una parte considerable del hardware del servidor tiene redundancia de alguna forma 'por defecto', debido al papel especial del DAS en un centro de datos, se le imponen requisitos más estrictos en términos de 'resiliencia'.
El método más eficaz para garantizar la redundancia en TI es el uso de múltiples instancias de hardware y software (en su forma más simple, la duplicación). Por supuesto, el DAS se puede duplicar completamente. Y para recuperación ante desastres, este enfoque se utiliza. Pero no todas las empresas pueden permitirse tal solución. No se trata solo del costo duplicado del hardware, sino también de otros gastos relacionados con la organización de tal solución y su posterior mantenimiento.
Sin embargo, la posibilidad de duplicar el hardware no elimina la necesidad de garantizar la resiliencia a nivel de componentes. En particular, en el DAS se aplica la redundancia en las fuentes de alimentación, módulos de enfriamiento, discos y, por supuesto, controladores. Todo esto se ha convertido en algo común. Es difícil encontrar un DAS que no utilice este tipo de diseño. aquí no es una excepción. Pero en este artículo queremos hablar de lo que no es evidente a primera vista y que está dirigido principalmente a mejorar la resiliencia del sistema en su conjunto.
Módulos de enfriamiento
Muy a menudo en cajas de 2U-3U se utilizan módulos combinados, que agrupan bloques de alimentación y ventiladores. Por un lado, esto es conveniente, ya que solo se necesita mantener un bloque. Por otro lado, si el sistema de refrigeración falla, se puede desconectar forzosamente el bloque de alimentación para evitar el sobrecalentamiento. Y aunque no parecería una situación crítica, claramente no se deberían añadir vulnerabilidades al DAS.
La refrigeración en el almacenamiento Qsan se organiza en módulos separados con reemplazo en «caliente», independientes de las fuentes de alimentación. En las fuentes de alimentación hay ventiladores propios destinados a la refrigeración de las mismas. El módulo de refrigeración contiene dos ventiladores independientes que se respaldan entre sí. Hay dos de estos módulos en el sistema de almacenamiento, uno a la derecha y otro a la izquierda, para ventilar eficazmente todos los componentes. Si uno de los ventiladores falla, todos los demás aumentan automáticamente su velocidad para compensar la falta de flujo de aire. Por eso, una falla en un ventilador no representa un peligro de sobrecalentamiento para el dispositivo en su conjunto.
Topología de conexión de los estantes de expansión
Esquema clásico de conexión al sistema de almacenamiento implica una topología denominada cascada. En este caso, los controladores correspondientes del estante y del sistema de almacenamiento se conectan entre sí mediante un único cable SAS. En total, esto resulta en 2 cables para un sistema de dos controladores. Si se requiere conectar un segundo estante, se conecta de la misma manera al primer estante. Y así sucesivamente. La ventaja de esta topología es la simplicidad de implementación del hardware. Sin embargo, una desventaja es una cierta vulnerabilidad ante una interrupción repentina de la cadena SAS debido a la falla cruzada de controladores no conectados entre sí del sistema de almacenamiento y el estante, o debido a la falta de energía en uno de los estantes de expansión en medio de la cadena. Como resultado, se perderá el acceso a parte de los dispositivos y podría colapsar un grupo RAID si está «disperso» entre varios chasis.
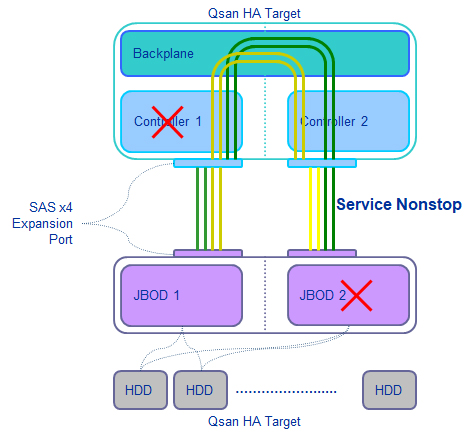
Qsan tiene protección contra fallos cruzados de controladores a través de una conexión lógica interna de los controladores mediante el backplane del sistema de almacenamiento. Es decir, el controlador del sistema de almacenamiento ve no solo el controlador JBOD conectado directamente a él, sino también el controlador «vecino» a través de un enlace especial en el backplane. Como resultado, si ocurre tal situación y nadie desconecta físicamente los cables SAS entre el sistema de almacenamiento y el estante, el acceso a todos los dispositivos se mantendrá.
Para proteger contra la ruptura del bus SAS, por ejemplo, debido a la falta de energía en el módulo de expansión, generalmente se utiliza una topología de conexión diferente: el backup cascada. En este caso, el sistema de almacenamiento se conecta directamente al primer y último módulo de la cadena, accediendo a los discos desde ambos extremos.
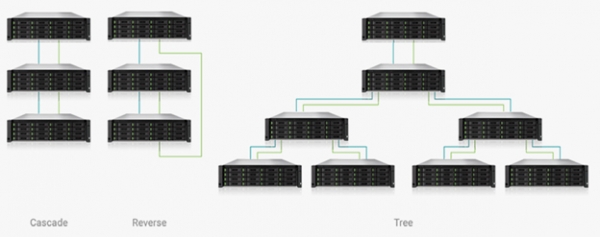
Si se desea una protección más sólida, se pueden construir configuraciones más grandes, utilizando, por ejemplo, una topología de árbol. O incluso complicar más la configuración combinando las topologías mencionadas. Esto es posible gracias a la gran cantidad de conectores SAS en los dispositivos (2 en cada controlador de almacenamiento y 5 en cada controlador JBOD) con detección automática de los modos de operación de entrada/salida. Lo principal es que el propio administrador no se enrede. El sistema de almacenamiento podrá configurar correctamente la configuración.
Fast rebuild
La presencia de discos de repuesto en caliente (hot spare) en el sistema incrementa considerablemente la fiabilidad del almacenamiento de información. Sin embargo, el simple hecho de asignar tales discos no garantiza una protección absoluta. El proceso de recuperación (rebuild) es bastante laborioso y a menudo prolongado en el tiempo. La dificultad se debe al acceso continuo a los datos primarios. Es decir, el sistema, además de su trabajo actual, también debe copiar datos en el nuevo disco. La duración del rebuild depende directamente de la capacidad del disco y sus características de velocidad. Dado que el sistema no conoce el espacio real ocupado en los discos, simplemente copia todo: bloque por bloque.
Como resultado, la recuperación de un disco moderno de gran capacidad de más de 10 TB bajo una carga pesada en el sistema de almacenamiento puede fácilmente tardar una semana o más. También se debe tener en cuenta que durante el rebuild, la probabilidad de fallo de otros discos aumenta significativamente debido a la carga adicional. Esto puede representar un grave peligro en el uso de, por ejemplo, RAID5.
Como solución a este problema, muchos desarrolladores de sistemas de almacenamiento han trabajado en acelerar el proceso de recuperación. Se pueden aplicar diferentes enfoques, pero la esencia es la misma: copiar solo los bloques realmente ocupados durante el rebuild. Qsan también ha abordado este problema. En los sistemas de almacenamiento de este proveedor, con la opción activada, El sistema realiza un seguimiento de los bloques utilizados para la grabación, lo que permite, en caso de fallo del disco, copiar solo esos bloques a un nuevo dispositivo de almacenamiento.
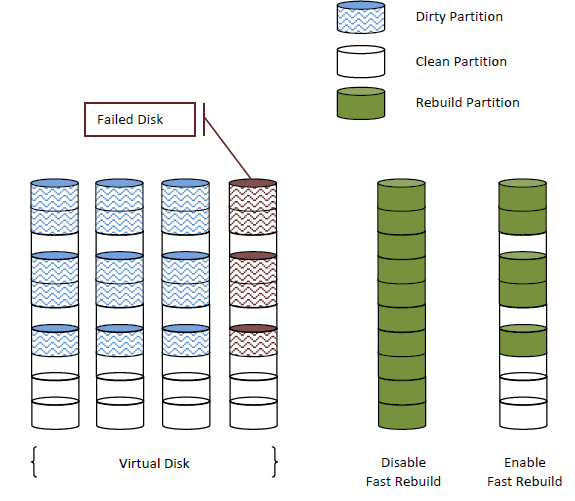
La opción Fast Rebuild no está habilitada por defecto al crear nuevos volúmenes, ya que su uso puede afectar el rendimiento, especialmente en operaciones de escritura aleatoria, porque:
- Es necesario rastrear la grabación en bloques;
- Durante el rebuildeo, no se recalculan los checksums para el espacio no ocupado, por lo que al grabar nuevamente en esta área, primero se debe ‘inicializar’.
Por eso, no se recomienda usar Fast Rebuild para volúmenes, por ejemplo, con bases de datos muy cargadas o en sistemas de videovigilancia, donde el volumen eventualmente se llenará al 100%. Sin embargo, para servidores de archivos o de correo, esta opción será muy útil.
En conclusión
Cada fabricante de sistemas de almacenamiento conectado en red asume que sus dispositivos son fiables. Y si no hay fallos fatales en el diseño de los dispositivos y una increíble tendencia a ahorrar en sus procesos de producción y pruebas, en general se puede coincidir con el proveedor. Sin embargo, hay que entender:
- la resistencia básica de los sistemas de almacenamiento conectado en red es, ante todo, una forma de continuar teniendo acceso a los datos en caso de fallos de alguno(s) de sus componentes;
- las opciones adicionales en cuanto a la resistencia (como las descritas anteriormente) son excepciones a ciertos tipos de fallos y aumentan sus posibilidades de tener acceso a los datos;
- La fiabilidad del 100%, lamentablemente, no existe. Pero para acercarse lo más posible a ella, la mayoría de los proveedores de sistemas de almacenamiento conectado en red (y entre ellos) hacen todo lo posible para mejorar continuamente sus productos tanto en hardware como en software.
Además, no hay que olvidar que ninguna fiabilidad absoluta de un sistema de almacenamiento conectado en red elimina la necesidad de copias de seguridad, planes claros y ensayados para la recuperación en caso de emergencia y soporte técnico operativo del proveedor.
Fuente: habr.com
