

Mi trabajo principal consiste, en su mayoría, en implementar sistemas de software, así que paso mucho tiempo tratando de responder preguntas como estas:
- El software funciona para el desarrollador, pero no para mí. ¿Por qué?
- Ayer este software funcionaba para mí, pero hoy no. ¿Por qué?
Esto es una especie de depuración que difiere un poco de la depuración habitual del software. La depuración normal se refiere a la lógica del código, mientras que la depuración de implementación se refiere a la interacción entre el código y el entorno. Incluso si la raíz del problema es un error lógico, el hecho de que funcione en una máquina y en otra no, significa que de alguna manera está relacionado con el entorno.
Por lo tanto, en lugar de las herramientas de depuración habituales como gdb tengo otro conjunto de herramientas para depuración de implementación. Y mi herramienta favorita para abordar el problema del tipo ‘¿por qué este software no está funcionando para mí?’ se llama strace.
¿Qué es strace?
— es una herramienta para ‘trazar llamadas al sistema’. Originalmente fue creada para Linux, pero las mismas características de depuración se pueden emplear con herramientas para otros sistemas ( o ).
La aplicación principal es muy simple. Solo hay que iniciar strace con cualquier comando y enviará un volcado de todas las llamadas al sistema (aunque probablemente primero hay que instalar strace) strace):
$ strace echo Hello
...Recorte un montón de cosas...
write(1, "Hellon", 6)                  = 6
close(1)                                = 0
close(2)                                = 0
exit_group(0)                           = ?
+++ salió con 0 +++
¿Qué son estas llamadas al sistema? Son algo así como una API para el núcleo del sistema operativo. Hace mucho tiempo, el software tenía acceso directo al ‘hardware’ en el que se ejecutaba. Si, por ejemplo, necesitaba mostrar algo en la pantalla, manipulaba los puertos o los registros de video en memoria. Cuando los sistemas informáticos multiprogramados se hicieron populares, reinó el caos, ya que varias aplicaciones competían por el ‘hardware’. Los errores en una aplicación podían hacer que otras fallaran, si no que toda la sistema se desplomara. Entonces, en la CPU aparecieron los modos de privilegio (o ‘protección en anillo’). El núcleo se convirtió en el más privilegiado: tenía acceso total al ‘hardware’, creando aplicaciones menos privilegiadas que tenían que solicitar acceso al núcleo para interactuar con el ‘hardware’ — a través de llamadas al sistema.
A nivel binario, la llamada del sistema es un poco diferente a una simple llamada a función, sin embargo, la mayoría de los programas utilizan un envoltorio en la biblioteca estándar. Es decir, la biblioteca estándar POSIX C contiene la llamada a función write(), que incluye todo el código dependiente de la arquitectura para la llamada del sistema write.
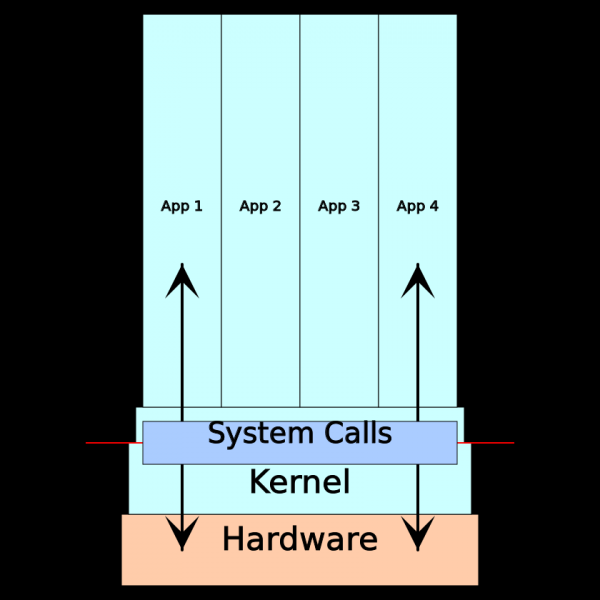
En resumen, cualquier interacción de una aplicación con su entorno (sistemas computacionales) se realiza a través de llamadas al sistema. Por eso, cuando un software funciona en una máquina y en otra no, sería bueno mirar los resultados de la traza de las llamadas del sistema. Si se quiere ser más específico, aquí hay una lista de puntos típicos que se pueden analizar mediante la traza de llamadas del sistema:
- Entrada/salida de consola
- Entrada/salida de red
- Acceso al sistema de archivos y entrada/salida de archivos
- Control del ciclo de vida de los procesos/hilos
- Gestión de memoria a bajo nivel
- Acceso a controladores de dispositivos especiales
¿Cuándo usar strace?
En teoría, strace se utiliza con cualquier programa en el espacio de usuario, ya que cualquier programa en el espacio de usuario debe realizar llamadas al sistema. Es más efectivo con programas compilados y de bajo nivel, pero también funciona con lenguajes de alto nivel como Python, si se logra filtrar el ruido adicional del entorno de ejecución y del intérprete.
En todo su esplendor strace se manifiesta durante la depuración de software que funciona bien en una máquina, pero de repente deja de funcionar en otra, generando mensajes confusos sobre archivos, permisos o intentos fallidos de ejecutar ciertos comandos o algo similar... Es una pena, pero no se combina tan bien con problemas de alto nivel como errores de verificación de certificados. Normalmente se requiere una combinación de strace, a veces y herramientas de nivel superior (como la herramienta de línea de comando openssl para depurar certificados).
Por ejemplo, tomemos el trabajo en un servidor aislado, pero la traza de llamadas del sistema se puede realizar a menudo en plataformas de implementación más complejas. Solo es necesario seleccionar el conjunto de herramientas adecuado.
Ejemplo de depuración simple
Supongamos que quieres ejecutar una impresionante aplicación de servidor foo, y esto es lo que obtienes:
$ foo
Error al abrir el archivo de configuración: No existe tal archivo o directorio
Es evidente que no logró encontrar el archivo de configuración que usted escribió. Esto ocurre porque a veces, cuando los administradores de paquetes compilan una aplicación, redefinen la ubicación esperada de los archivos. Y si sigues la guía de instalación para una distribución, en otra encuentras los archivos en lugares completamente inesperados. El problema podría resolverse en unos pocos segundos si el mensaje de error indicara dónde se debe buscar el archivo de configuración, pero no lo hace. Entonces, ¿dónde buscar?
Si hay acceso al código fuente, se puede leer y descubrir todo. Es un buen plan alternativo, pero no es la solución más rápida. Se puede utilizar un depurador paso a paso como gdb y ver lo que hace el programa, pero es mucho más eficiente usar una herramienta que esté diseñada específicamente para mostrar la interacción con el entorno: strace.
Salida strace puede parecer redundante, pero la buena noticia es que se puede ignorar la mayor parte de él con confianza. A menudo es útil usar el operador -o para guardar los resultados del trazado en un archivo separado:
$ strace -o /tmp/trace foo
Error opening configuration file: No such file or directory
$ cat /tmp/trace
execve("foo", ["foo"], 0x7ffce98dc010 /* 16 vars */) = 0
brk(NULL) = 0x56363b3fb000
access("/etc/ld.so.preload", R_OK) = -1 ENOENT (No such file or directory)
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=25186, ...}) = 0
mmap(NULL, 25186, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f2f12cf1000
close(3) = 0
openat(AT_FDCWD, "/lib/x86_64-linux-gnu/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "177ELF2113 3 > 1 260A2 "..., 832) = 832
fstat(3, {st_mode=S_IFREG|0755, st_size=1824496, ...}) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f2f12cef000
mmap(NULL, 1837056, PROT_READ, MAP_PRIVATE|MAP_DENYWRITE, 3, 0) = 0x7f2f12b2e000
mprotect(0x7f2f12b50000, 1658880, PROT_NONE) = 0
mmap(0x7f2f12b50000, 1343488, PROT_READ|PROT_EXEC, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x22000) = 0x7f2f12b50000
mmap(0x7f2f12c98000, 311296, PROT_READ, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x16a000) = 0x7f2f12c98000
mmap(0x7f2f12ce5000, 24576, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x1b6000) = 0x7f2f12ce5000
mmap(0x7f2f12ceb000, 14336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0) = 0x7f2f12ceb000
close(3) = 0
arch_prctl(ARCH_SET_FS, 0x7f2f12cf0500) = 0
mprotect(0x7f2f12ce5000, 16384, PROT_READ) = 0
mprotect(0x56363b08b000, 4096, PROT_READ) = 0
mprotect(0x7f2f12d1f000, 4096, PROT_READ) = 0
munmap(0x7f2f12cf1000, 25186) = 0
openat(AT_FDCWD, "/etc/foo/config.json", O_RDONLY) = -1 ENOENT (No such file or directory)
dup(2) = 3
fcntl(3, F_GETFL) = 0x2 (flags O_RDWR)
brk(NULL) = 0x56363b3fb000
brk(0x56363b41c000) = 0x56363b41c000
fstat(3, {st_mode=S_IFCHR|0620, st_rdev=makedev(0x88, 0x8), ...}) = 0
write(3, "Error opening configuration file"..., 60) = 60
close(3) = 0
exit_group(1) = ?
+++ exited with 1 +++
Ejemplo de toda la primera página de salida strace — esto suele ser una preparación de bajo nivel para la ejecución. (Muchos llamados mmap, mprotect, brk para cosas como la detección de memoria de bajo nivel y el mapeo de bibliotecas dinámicas.) En general, durante la depuración, las salidas strace es mejor leerlas desde el final. Abajo estará la llamada write, que genera un mensaje de error. Miramos hacia arriba y vemos la primera llamada al sistema que falló: la llamada openat, que arroja el error ENOENT (“archivo o directorio no encontrado”), tratando de abrir /etc/foo/config.json. Aquí es donde debería estar el archivo de configuración.
Fue solo un ejemplo, pero diría que el 90% del tiempo que uso strace, no tengo que realizar nada mucho más complicado que esto. A continuación, una guía paso a paso completa para la depuración:
- Frustrarse por un mensaje impreciso de error del sistema de la aplicación
- Reiniciar la aplicación con strace
- Buscar en los resultados de traza el mensaje de error
- Ir hacia arriba hasta que se tope con la primera llamada al sistema fallida
Es muy probable que la llamada al sistema en el paso 4 muestre qué salió mal.
Consejos
Antes de mostrar un ejemplo de depuración más compleja, les daré algunos trucos para un uso efectivo. strace:
man — tu amigo
En muchos sistemas *nix, puedes obtener la lista completa de llamadas al sistema del núcleo ejecutando man syscalls. Verás cosas como brk(2), lo que significa que puedes obtener más información ejecutando man 2 brk.
Pequeñas trampas: man 2 fork me muestra la página para la shell fork() en GNU libc, que, por cierto, se implementa mediante la llamada clone(). La semántica de la llamada fork sigue siendo la misma si escribes un programa que utiliza fork(), y al ejecutar un trazo — no encontraré llamadas fork, en su lugar habrá clone(). Esas trampas pueden confundir si comienzas a comparar el código fuente con la salida. strace.
Usa -o para guardar la salida en un archivo.
strace Puede generar una salida extensa, por lo que a menudo es útil almacenar los resultados del trazo en archivos separados (como en el ejemplo anterior). Además, esto ayuda a no confundir la salida del programa con la salida strace en la consola.
Usa -s para ver más datos del argumento.
Probablemente notaste que la segunda mitad del mensaje de error no se muestra en el ejemplo de trazo anterior. Esto se debe a que strace por defecto solo muestra los primeros 32 bytes del argumento de cadena. Si deseas ver más, añade algo como -s 128 a la llamada. strace.
-u facilita el seguimiento de archivos, sockets y demás.
«Todo es un archivo» significa que los sistemas *nix realizan todas las entradas y salidas usando descriptores de archivo, ya sea aplicable a un archivo, a la red o a canales de comunicación entre procesos. Esto es conveniente para la programación, pero dificulta el seguimiento de lo que realmente está sucediendo cuando ves generales read y write en los resultados del trazo de llamadas al sistema.
Al agregar el operador -u, harás que strace anote cada descriptor de archivo en la salida con una nota sobre a qué apunta.
Adjunto a un proceso ya en ejecución con -p
Como se verá en el siguiente ejemplo, a veces es necesario trazar un programa que ya está en ejecución. Si sabes que se está ejecutando como el proceso 1337 (digamos, de las salidas ps), puedes trazarlo así:
$ strace -p 1337
...salida del trazo de llamadas al sistema...
Es posible que necesites privilegios de root.
Usa -f para seguir los procesos secundarios.
strace Por defecto, rastrea solo un proceso. Si este proceso genera procesos hijos, se podrá ver la llamada del sistema para generar el proceso hijo, pero las llamadas del sistema del proceso hijo no se mostrarán.
Si crees que el error está en el proceso hijo, utiliza el operador -f, esto habilitará su rastreo. La desventaja de esto es que la salida todavía te confundirá más. Cuando strace rastrea un proceso o una rama, muestra un flujo unificado de eventos de llamadas. Cuando rastrea varios procesos a la vez, es posible que veas el inicio de una llamada interrumpida por el mensaje <unfinished …>, luego, un grupo de llamadas para otras ramas de ejecución, y solo después, la finalización de la primera con <… foocall resumed>. O divide todos los resultados del rastreo en diferentes archivos, utilizando también el operador -ff (más detalles en en strace).
Filtra el rastreo utilizando -e
Como puedes ver, el resultado del rastreo es un verdadero montón de todas las posibles llamadas del sistema. Con la bandera -e puedes filtrar el rastreo (ver en strace). La principal ventaja es que ejecutar el rastreo con filtrado es más rápido que hacer un rastreo completo y luego grep`ar. Para ser honesto, casi siempre me da igual.
No todos los errores son malos
Un ejemplo simple y común es un programa que busca un archivo en varios lugares, como una shell que busca en cuál de las carpetas de reciclaje se encuentra un archivo ejecutable:
$ strace sh -c uname
...
stat("/home/user/bin/uname", 0x7ffceb817820) = -1 ENOENT (No such file or directory)
stat("/usr/local/bin/uname", 0x7ffceb817820) = -1 ENOENT (No such file or directory)
stat("/usr/bin/uname", {st_mode=S_IFREG|0755, st_size=39584, ...}) = 0
...
La heurística del tipo "última solicitud fallida antes del mensaje de error" es buena para encontrar errores relevantes. De todos modos, tiene sentido comenzar desde el final.
Los manuales de programación en C ayudan mucho a entender las llamadas del sistema.
Las llamadas estándar a las bibliotecas de C no son llamadas del sistema, sino solo una delgada capa superficial. Así que, si entiendes un poco cómo y qué hacer en C, te será más fácil comprender los resultados del rastreo de llamadas del sistema. Por ejemplo, si tienes problemas depurando llamadas a sistemas de red, revisa ese clásico .
Un ejemplo de depuración un poco más complicado.
Ya he mencionado que un ejemplo simple de depuración es un caso con el que, en su mayor parte, trato en mi trabajo con strace. Sin embargo, a veces se requiere una verdadera investigación, así que aquí tienes un ejemplo de depuración un poco más complicado.
— un programador de tareas, otra implementación de un demonio *nix cron. Está instalado en el servidor, pero cuando alguien intenta editar el horario, sucede lo siguiente:
# crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
Bien, entonces, bcron intentó escribir un archivo, pero no pudo, y no reconoce por qué. Vamos a desarmar strace:
# strace -o /tmp/trace crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
# cat /tmp/trace
...
openat(AT_FDCWD, "bcrontab.14779.1573691864.847933", O_RDONLY) = 3
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
read(3, "#Ansible: logsaggn20 14 * * * lo"..., 8192) = 150
read(3, "", 8192)                       = 0
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
socket(AF_UNIX, SOCK_STREAM, 0)         = 3
connect(3, {sa_family=AF_UNIX, sun_path="/var/run/bcron-spool"}, 110) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
write(3, "156:Slogs #Ansible: logsaggn20 1"..., 161) = 161
read(3, "32:ZCould not create temporary f"..., 8192) = 36
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
write(2, "bcrontab: Fatal: Could not creat"..., 49) = 49
unlink("bcrontab.14779.1573691864.847933") = 0
exit_group(111)                         = ?
+++ exited with 111 +++
Cerca del final hay un mensaje de error write, pero esta vez hay algo diferente. Primero, no hay ningún error relevante de llamada al sistema que normalmente ocurre antes. En segundo lugar, se puede ver que alguien ya ha leído el mensaje de error. Parece que el verdadero problema está en otro lugar, y bcrontab simplemente reproduce el mensaje.
Si miramos man 2 read, podemos ver que el primer argumento (3) es un descriptor de archivo que *nix utiliza para todas las operaciones de entrada/salida. ¿Cómo saber qué representa el descriptor de archivo 3? En este caso específico, podemos ejecutar strace con el operador -u (ver arriba), y te contará automáticamente, sin embargo, para calcular cosas similares, es útil saber cómo leer y analizar los resultados del rastreo.
La fuente del descriptor de archivo puede ser una de muchas llamadas al sistema (depende de para qué se usa el descriptor: para la consola, un socket de red, un archivo en sí o algo más), pero como sea, buscamos llamadas que devuelvan 3 (es decir, buscamos «= 3» en los resultados del rastreo). En este resultado hay 2: openat en la parte superior y socket en el medio. openat abre el archivo, pero close(3) después de eso mostrará que se cierra de nuevo. (Precaución: los descriptores de archivo pueden reutilizarse cuando se abren y cierran). La llamada socket() es válida, ya que es la última antes de read(), y resulta que bcrontab trabaja con algo a través de un socket. La siguiente línea muestra que el descriptor de archivo está conectado a unix domain socket en la ruta /var/run/bcron-spool.
Así que hay que encontrar el proceso enlazado a unix socket del otro lado. Para esto, hay un par de trucos ingeniosos, y ambos serán útiles para depurar implementaciones del servidor. El primero es usar netstat o un nuevo más reciente ss (estado del socket). Ambos comandos muestran conexiones de red activas del sistema y utilizan el operador -l para describir los sockets en escucha, así como el operador -p para mostrar los programas conectados al socket como clientes. (Hay muchas más opciones útiles, pero para esta tarea son suficientes estas dos.)
# ss -pl | grep /var/run/bcron-spool
u_str LISTEN 0   128   /var/run/bcron-spool 1466637   * 0   users:(("unixserver",pid=20629,fd=3))
Esto indica que el que escucha es el comando inixserver, que trabaja con el ID de proceso 20629. (Y, por casualidad, utiliza el descriptor de archivo 3 como socket.)
La segunda herramienta realmente útil para encontrar la misma información se llama lsof. Enumera todos los archivos abiertos (o descriptores de archivos) en el sistema. O se puede obtener información sobre un archivo específico:
# lsof /var/run/bcron-spool
COMMAND   PID   USER  FD  TYPE  DEVICE              SIZE/OFF  NODE    NAME
unixserve 20629 cron  3u  unix  0x000000005ac4bd83  0t0       1466637 /var/run/bcron-spool type=STREAM
El proceso 20629 es un servidor de larga duración, por lo que se puede adjuntar a él strace usando algo como strace -o /tmp/trace -p 20629. Si se edita la tarea cron en otra terminal, obtendremos la salida de los resultados de la traza junto con el error que ocurre. Y aquí está el resultado:
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21181
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Se reiniciará si SA_RESTART está configurado)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21181, si_uid=998, si_status=0, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 0}], WNOHANG|WSTOPPED, NULL) = 21181
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (No hay procesos hijos)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21200
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Se reiniciará si SA_RESTART está configurado)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21200, si_uid=998, si_status=111, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 111}], WNOHANG|WSTOPPED, NULL) = 21200
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (No hay procesos hijos)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL
(El último accept() no se completará durante la trazabilidad.) Y de nuevo, por más que lo lamentemos, este resultado no contiene el error que estamos buscando. No vemos ningún mensaje que bcrontag envíe al socket o reciba de él. En su lugar, solo hay un control del proceso (clone, wait4, SIGCHLD y otros.) Este proceso genera un proceso secundario que, como se puede suponer, realiza el trabajo real. Y si necesitamos seguir su rastro, agreguemos a la llamada strace -f. Esto es lo que encontraremos al buscar un mensaje de error en el nuevo resultado con strace -f -o /tmp/trace -p 20629:
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Permiso denegado)
21470 write(1, "32:ZNo se pudo crear el archivo temporal f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (No existe tal archivo o directorio)
21470 exit_group(111)                   = ?
21470 +++ salió con 111 +++
Aquí, esto ya es algo. El proceso 21470 recibe el error «permiso denegado» al intentar crear un archivo en la ruta tmp/spool.21470.1573692319.854640 (relativo al directorio de trabajo actual). Si supiéramos simplemente cuál es el directorio de trabajo actual, conoceríamos la ruta completa y podríamos averiguar por qué el proceso no puede crear su archivo temporal allí. Desafortunadamente, el proceso ya ha salido, así que no podremos usar simplemente lsof -p 21470 para encontrar el directorio actual, pero se puede trabajar al revés: buscar llamadas al sistema PID 21470 que cambien de directorio. (Si no hay tales, el PID 21470 probablemente las heredó del padre, y esto ya es a través de lsof -p no se puede averiguar.) Esta llamada al sistema es chdir (lo cual no es difícil de determinar con la ayuda de modernos motores de búsqueda en la red). Aquí está el resultado de las búsquedas inversas de la traza, hasta el propio servidor PID 20629:
20629 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21470
...
21470 execve("/usr/sbin/bcron-spool", ["bcron-spool"], 0x55d2460807e0 /* 27 vars */) = 0
...
21470 chdir("/var/spool/cron")          = 0
...
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Permiso denegado)
21470 write(1, "32:ZNo se pudo crear el archivo temporal f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (No existe tal archivo o directorio)
21470 exit_group(111)                   = ?
21470 +++ salió con 111 +++
(Si te pierdes, es posible que quieras leer mi publicación anterior .) Así que el servidor PID 20629 no obtuvo permiso para crear un archivo en la ruta /var/spool/cron/tmp/spool.21470.1573692319.854640. Lo más probable es que la causa sean las configuraciones clásicas de permisos del sistema de archivos. Verifiquemos:
# ls -ld /var/spool/cron/tmp/
drwxr-xr-x 2 root root 4096 Nov  6 05:33 /var/spool/cron/tmp/
# ps u -p 20629
USER       PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
cron     20629  0.0  0.0   2276   752 ?        Ss   Nov14   0:00 unixserver -U /var/run/bcron-spool -- bcron-spool
¡Aquí está el problema! El servidor trabaja como un cron de usuario, pero solo root tiene permiso para escribir en el directorio /var/spool/cron/tmp/. Un sencillo comando chown cron /var/spool/cron/tmp/ resolverá bcron trabajar correctamente. (Si el problema no estaba en esto, el siguiente sospechoso más probable es un módulo de seguridad del núcleo como SELinux o AppArmor, así que revisaría el registro de mensajes del núcleo con dmesg.)
Total
Para un principiante, los resultados del seguimiento de llamadas al sistema pueden ser abrumadores, pero espero haber mostrado que son una forma rápida de depurar toda una clase de problemas comunes de implementación. Imagina que intentas depurar un entorno multiprocesador bcron, utilizando un depurador paso a paso.
Analizar los resultados del seguimiento en retroceso a lo largo de la cadena de llamadas al sistema requiere habilidad, pero como ya he mencionado, casi siempre, utilizando strace, simplemente obtengo el resultado del seguimiento y busco errores desde el final. De todos modos, strace me ayuda a ahorrar mucho tiempo en la depuración. Espero que también te sea útil.
Fuente: habr.com
