

Hace un par de años, Kubernetes en el blog oficial de GitHub. Desde entonces, se ha convertido en la tecnología estándar para la implementación de servicios. Ahora, Kubernetes gestiona una parte significativa de los servicios internos y públicos. A medida que nuestros clústeres han crecido y las demandas de rendimiento se han vuelto más estrictas, hemos comenzado a notar que en algunos servicios en Kubernetes aparecen retrasos esporádicos que no se pueden explicar por la carga de la propia aplicación.
En esencia, en las aplicaciones se presenta una especie de retraso de red aleatorio de hasta 100 ms o más, lo que resulta en tiempos de espera o reintentos. Se esperaba que los servicios pudieran responder a las solicitudes mucho más rápido que 100 ms. Pero esto no es posible si la propia conexión consume tanto tiempo. Además, hemos observado solicitudes de MySQL que deberían tomar milisegundos, y MySQL realmente lo hacía en milisegundos, pero desde la perspectiva de la aplicación solicitante, la respuesta tardaba 100 ms o más.
De inmediato quedó claro que el problema ocurría solo al conectarse a un nodo de Kubernetes, incluso si la llamada provenía de fuera de Kubernetes. Lo más sencillo para reproducir el problema es en la prueba , que se ejecuta desde cualquier host interno, prueba el servicio de Kubernetes en un puerto específico y registra esporádicamente un gran retraso. En este artículo, analizaremos cómo logramos rastrear la causa de este problema.
Eliminando la complejidad innecesaria en la cadena de falla
Reproduciendo el mismo ejemplo, queríamos centrar el enfoque del problema y eliminar capas innecesarias de complejidad. Inicialmente, había demasiados elementos en el flujo entre Vegeta y los pods de Kubernetes. Para determinar un problema de red más profundo, necesitamos excluir algunos de ellos.
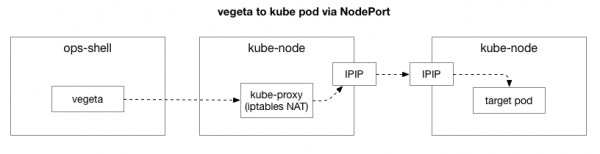
El cliente (Vegeta) establece una conexión TCP con cualquier nodo en el clúster. Kubernetes actúa como una red de superposición (sobre la red existente del centro de datos), que utiliza , es decir, encapsula paquetes IP de la red de superposición dentro de paquetes IP del centro de datos. Al conectarse al primer nodo, se realiza la traducción de direcciones de red. (NAT) con seguimiento del estado para la conversión de la dirección IP y el puerto del nodo de Kubernetes en una dirección IP y un puerto en la red superpuesta (en particular, el pod con la aplicación). Para los paquetes que llegan, se realiza la secuencia inversa de acciones. Es un sistema complejo con muchos estados y numerosos elementos que se actualizan y cambian constantemente a medida que se despliegan y mueven los servicios.
Utilidad tcpdump en la prueba de Vegeta da retraso durante el apretón de manos TCP (entre SYN y SYN-ACK). Para eliminar esta complejidad innecesaria, se puede usar hping3 para simples "pings" con paquetes SYN. Verificamos si hay un retraso en el paquete de respuesta y luego cerramos la conexión. Podemos filtrar los datos, incluyendo solo los paquetes con más de 100 ms, y obtener una variante más simple para reproducir el problema que la prueba completa de nivel de red 7 en Vegeta. Aquí están los "pings" del nodo de Kubernetes utilizando TCP SYN/SYN-ACK en el "puerto del nodo" del servicio (30927) con un intervalo de 10 ms, filtrados por las respuestas más lentas:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Se puede hacer una primera observación de inmediato. Por los números de secuencia y los tiempos, se puede ver que no son congestiones aisladas. El retraso se acumula a menudo y, en última instancia, se procesa.
A continuación, queremos averiguar qué componentes pueden estar involucrados en la congestión. ¿Podría ser alguna de las cientos de reglas de iptables en NAT? ¿O algún problema con el tunneling IPIP en la red? Una forma de verificar esto es revisar cada paso del sistema, excluyéndolo. ¿Qué pasará si se elimina NAT y la lógica del firewall, dejando solo la parte de IPIP?
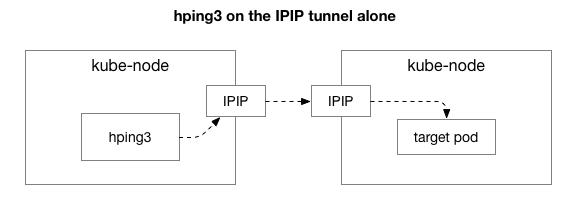
Afortunadamente, Linux permite acceder fácilmente directamente a la capa superpuesta de IP, si la máquina está en la misma red:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Según los resultados, ¡el problema sigue presente! Esto excluye iptables y NAT. ¿Significa esto que el problema está en TCP? Veamos cómo va el ping ICMP normal:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Los resultados muestran que el problema no ha desaparecido. ¿Podría ser un túnel IPIP? Usemos una prueba más sencilla:
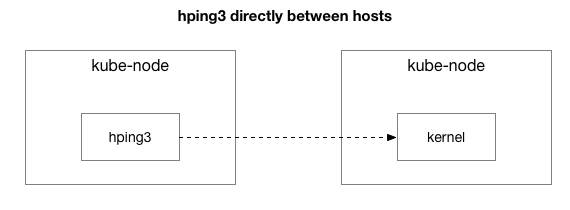
¿Se envían todos los paquetes entre estos dos hosts?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Hemos simplificado la situación a dos nodos de Kubernetes enviándose cualquier paquete, incluso un ping ICMP. Aún ven latencia si el host de destino es 'malo' (algunos son peores que otros).
Ahora la última pregunta: ¿por qué la latencia ocurre solo en los servidores kube-node? ¿Y ocurre cuando kube-node es el remitente o el receptor? Afortunadamente, esto también es bastante fácil de averiguar, enviando un paquete desde un host fuera de Kubernetes, pero con el mismo 'malo conocido' receptor. Como vemos, el problema no ha desaparecido:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Entonces realizaremos las mismas solicitudes desde el kube-node de origen anterior a un host externo (lo que excluye el host de origen, ya que el ping incluye tanto el componente RX como TX):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 estadísticas de hping ---
 22352 paquetes transmitidos, 22350 paquetes recibidos, 1% de pérdida de paquetes
 tiempo de ida y vuelta min/avg/max = 0.2/7.6/1010.6 ms
Analizando la captura de paquetes con retraso, obtuvimos información adicional. En particular, el remitente (abajo) observa este tiempo de espera, mientras que el destinatario (arriba) no lo ve; consulte la columna Delta (en segundos):
Además, si observamos la diferencia en el orden de los paquetes TCP e ICMP (por los números de secuencia) en el lado del receptor, los paquetes ICMP siempre llegan en el mismo orden en que fueron enviados, pero con diferentes tiempos. Al mismo tiempo, los paquetes TCP a veces se entrelazan y algunos se quedan atrapados. En particular, al examinar los puertos de los paquetes SYN, en el lado del remitente llegan en orden, mientras que en el lado del receptor no.
Hay una sutil diferencia en cómo de los servidores modernos (como en nuestro centro de datos) manejan paquetes que contienen TCP o ICMP. Cuando un paquete llega, el adaptador de red "lo hash" por conexión, es decir, intenta dividir las conexiones en filas y enviar cada fila a un núcleo de CPU separado. Para TCP, este hash incluye tanto la dirección IP de origen como la de destino y el puerto. En otras palabras, cada conexión se hash de manera (potencialmente) diferente. Para ICMP, solo se hash las direcciones IP, ya que no hay puertos.
Otra nueva observación: durante este período vemos retrasos de ICMP en todas las comunicaciones entre dos hosts, y en TCP no. Esto nos indica que la causa está probablemente relacionada con el hash de las filas RX: casi con certeza el atasco ocurre en el procesamiento de paquetes RX, no en el envío de respuestas.
Esto elimina la posibilidad de que la causa sea el envío de paquetes. Ahora sabemos que el problema de procesamiento de paquetes está en el lado de recepción en algunos servidores kube-node.
Investigando el procesamiento de paquetes en el núcleo de Linux
Para entender por qué el problema ocurre en el receptor en algunos servidores kube-node, veamos cómo el núcleo de Linux maneja los paquetes.
Volviendo a la implementación más simple y tradicional, la tarjeta de red recibe un paquete y envía al núcleo de Linux, notificando que hay un paquete que necesita ser procesado. El núcleo detiene otro trabajo, cambia el contexto al manejador de interrupciones, procesa el paquete y luego vuelve a las tareas actuales.
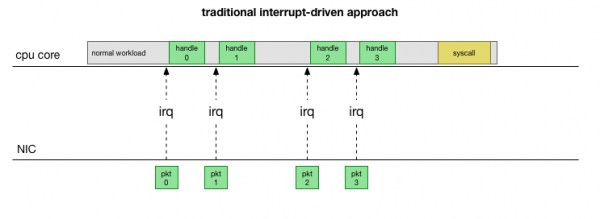
Este cambio de contexto ocurre lentamente: quizás la latencia no era perceptible en las tarjetas de red de 10 megabits en los años 90, pero en las tarjetas modernas de 10G con una capacidad máxima de 15 millones de paquetes por segundo, cada núcleo de un pequeño servidor de ocho núcleos puede ser interrumpido millones de veces por segundo.
Para evitar el procesamiento constante de interrupciones, hace muchos años se añadió en Linux : una API de red que utilizan todos los controladores modernos para mejorar el rendimiento a altas velocidades. A bajas velocidades, el núcleo todavía recibe interrupciones de la tarjeta de red de la manera tradicional. Una vez que llegan suficientes paquetes que superan un umbral, el núcleo desactiva las interrupciones y en su lugar comienza a sondear el adaptador de red y recoger paquetes por lotes. El procesamiento se realiza en softirq, es decir, en después de llamadas al sistema y interrupciones de hardware, cuando el núcleo (a diferencia del espacio de usuario) ya está en funcionamiento.
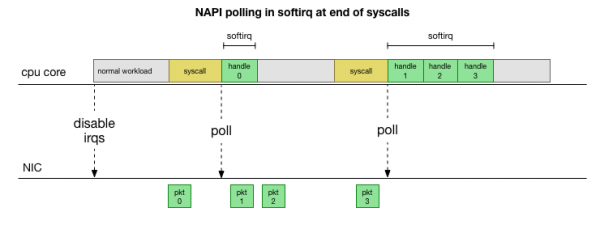
Esto es mucho más rápido, pero plantea otro problema. Si hay demasiados paquetes, todo el tiempo se dedica al procesamiento de paquetes de la tarjeta de red, y los procesos del espacio de usuario no pueden vaciar efectivamente estas colas (lectura de conexiones TCP, etc.). Al final, las colas se llenan y comenzamos a descartar paquetes. Tratando de encontrar un equilibrio, el núcleo establece un presupuesto para el número máximo de paquetes procesados en el contexto de softirq. Una vez que se excede este presupuesto, se despierta un hilo separado ksoftirqd (verás uno para ps cada núcleo), que procesa estos softirq fuera de la ruta normal de syscall/interrupción. Este hilo se programa utilizando el planificador de procesos estándar, que intenta distribuir los recursos de manera justa.
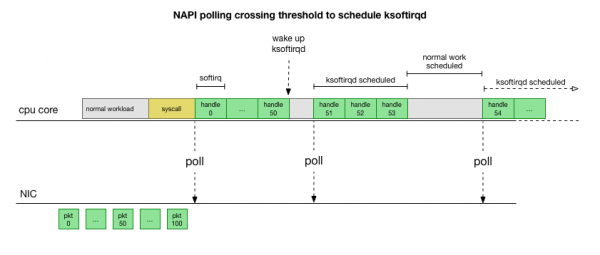
Al estudiar cómo el núcleo procesa los paquetes, se puede notar que hay una cierta probabilidad de congestión. Si las llamadas softirq ocurren con menos frecuencia, los paquetes tendrán que esperar un tiempo para ser procesados en la cola RX de la tarjeta de red. Esto puede deberse a alguna tarea que bloquea el núcleo del procesador, o algo más impide que el núcleo ejecute softirq.
Limitamos el procesamiento al núcleo o al método
Las demoras de softirq son, por ahora, solo una hipótesis. Pero tiene sentido, y sabemos que estamos observando algo muy parecido. Por lo tanto, el siguiente paso es confirmar esta teoría. Y si se confirma, encontrar la causa de las demoras.
Volvamos a nuestros paquetes lentos:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Como se discutió anteriormente, estos paquetes ICMP se agrupan en una sola cola del NIC RX y son procesados por un solo núcleo de la CPU. Si queremos entender cómo funciona Linux, es útil saber dónde (en qué núcleo de la CPU) y cómo (softirq, ksoftirqd) se procesan estos paquetes para rastrear el proceso.
Ahora es el momento de utilizar herramientas que permiten rastrear en tiempo real el funcionamiento del núcleo de Linux. Aquí utilizamos . Este conjunto de herramientas permite escribir pequeños programas en C que interceptan funciones arbitrarias en el núcleo y almacenan eventos en un programa en Python de espacio de usuario, que puede procesarlos y devolverte el resultado. Los ganchos para funciones arbitrarias en el núcleo son complicados, pero la utilidad está diseñada para la máxima seguridad y está destinada a rastrear precisamente esos problemas de producción que son difíciles de reproducir en un entorno de prueba o desarrollo.
El plan aquí es simple: sabemos que el núcleo procesa estos pings ICMP, así que colocaremos un gancho en la función del núcleo , que acepta un paquete ICMP "echo request" entrante y inicia el envío de una respuesta ICMP "echo response". Podemos identificar el paquete por el aumento en el número de icmp_seq, que muestra hping3 superior.
Código parece complicado, pero no es tan aterrador como parece. La función icmp_echo informa struct sk_buff *skb: es un paquete con una solicitud de "echo request". Podemos rastrearlo, extraer la secuencia echo.sequence que se corresponde con icmp_seq de hping3 arriba), y enviarla al espacio de usuario. También es conveniente capturar el nombre actual del proceso/id. A continuación se muestran los resultados que vemos directamente durante el procesamiento de paquetes por parte del núcleo:
TGID    PID     NOMBRE DEL PROCESO    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Es importante señalar que en este contexto softirq los procesos que han hecho llamadas al sistema aparecerán como «procesos», aunque en realidad el núcleo maneja de forma segura los paquetes en el contexto del núcleo.
Con esta herramienta, podemos establecer una conexión entre procesos específicos y paquetes específicos que muestran latencia en hping3. Realizamos un simple grep en esta captura para ciertos valores icmp_seq. Los paquetes que corresponden a los valores icmp_seq mencionados anteriormente fueron marcados con su RTT, que observamos anteriormente (los valores esperados de RTT de los paquetes que filtramos debido a RTT inferiores a 50 ms se indican entre paréntesis):
TGID    PID     NOMBRE DEL PROCESO    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Los resultados nos dicen varias cosas. En primer lugar, todos estos paquetes son manejados por el contexto ksoftirqd/11. Esto significa que para este par específico de máquinas, los paquetes ICMP se han asignado al núcleo 11 en el lado receptor. También vemos que en cada congestión hay paquetes que se manejan en el contexto de la llamada al sistema cadvisor. Luego ksoftirqd asume la tarea y maneja la cola acumulada: es decir, la cantidad de paquetes que se han acumulado después de cadvisor.
El hecho de que justo antes de esto siempre esté funcionando cadvisor, implica su implicación en el problema. Irónicamente, la misión es «analizar el uso de recursos y las características de rendimiento de los contenedores en ejecución», no causar este problema de rendimiento.
Al igual que con otros aspectos del trabajo de los contenedores, se trata de una herramienta sumamente avanzada, de la que se pueden esperar problemas de rendimiento en ciertas circunstancias imprevistas.
¿Qué es lo que hace cadvisor que ralentiza la cola de paquetes?
Ahora tenemos una comprensión bastante buena de cómo ocurre la falla, qué proceso la provoca y en qué CPU. Vemos que debido a un bloqueo severo, el núcleo de Linux no puede programar a tiempo. ksoftirqd. Y vemos que los paquetes se procesan en el contexto de cadvisor. Es lógico suponer que cadvisor lanza una llamada al sistema lenta, después de la cual se procesan todos los paquetes acumulados durante ese tiempo:
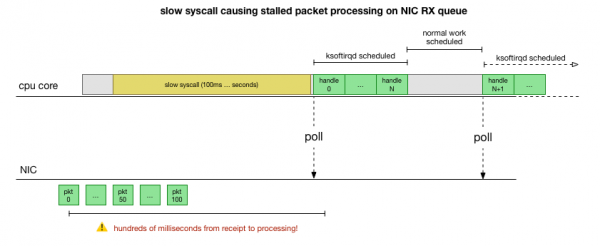
Esa es la teoría, pero, ¿cómo podemos comprobarla? Lo que podemos hacer es rastrear el funcionamiento del núcleo de la CPU a lo largo de todo este proceso, encontrar el punto donde se excede el límite de paquetes y se activa ksoftirqd, y luego mirar un poco antes: qué estaba funcionando en el núcleo de la CPU justo antes de ese momento. Es como una radiografía de la CPU cada pocos milisegundos. Se verá algo así:
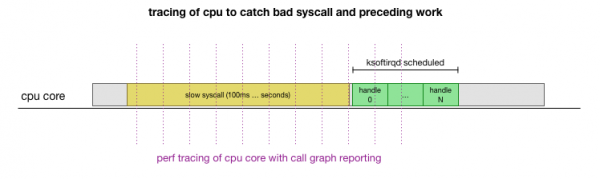
Convenientemente, todo esto se puede hacer con herramientas existentes. Por ejemplo, verifica el núcleo de la CPU especificado con regularidad y puede generar un gráfico de llamadas del sistema en funcionamiento, incluyendo tanto el espacio de usuario como el núcleo de Linux. Se puede tomar esta grabación y procesarla con un pequeño fork del programa de Brendan Gregg, que conserva el orden de la traza de la pila. Podemos guardar trazas de pila de una línea cada 1 ms, y luego seleccionar y guardar una muestra de 100 milisegundos antes de que la traza incluya ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Estos son los resultados:
(cientos de trazas que parecen similares)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Aquí hay muchas cosas, pero lo principal es que encontramos el patrón «cadvisor antes de ksoftirqd», que ya habíamos visto antes en el rastreador de ICMP. ¿Qué significa esto?
Cada línea es una traza del CPU en un momento determinado. Cada llamada descendente en la pila en la línea se separa por un punto y coma. En medio de las líneas vemos la llamada al syscall: read(): .... ;do_syscall_64;sys_read; .... Por lo tanto, cadvisor pasa mucho tiempo en una llamada del sistema read(), relacionada con las funciones mem_cgroup_* (parte superior de la pila de llamadas/final de la línea).
En la traza de llamadas es incómodo ver qué se está leyendo, así que ejecutaremos strace y veremos qué está haciendo cadvisor, y encontraremos las llamadas al sistema que tardan más de 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Como se podía suponer, aquí vemos llamadas lentas read(). Del contenido de las operaciones de lectura y el contexto mem_cgroup es evidente que estas llamadas read() se refieren al archivo memory.stat, que muestra el uso de memoria y las limitaciones de cgroup (tecnología de aislamiento de recursos en Docker). La herramienta cadvisor interroga este archivo para obtener información sobre el uso de recursos para los contenedores. Verifiquemos si es el núcleo o cadvisor lo que está haciendo algo inesperado:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Ahora podemos reproducir el error y entendemos que el núcleo de Linux enfrenta una patología.
¿Por qué la operación de lectura es tan lenta?
En esta etapa, es mucho más fácil encontrar mensajes de otros usuarios sobre problemas similares. Como resultado, en el rastreador de cadvisor se informó sobre este error como un , simplemente nadie se dio cuenta de que el retraso también se refleja aleatoriamente en la pila de red. De hecho, se notó que cadvisor consume más tiempo de CPU de lo esperado, pero no se le prestó mucha atención, ya que nuestros servidores tienen muchos recursos de CPU, por lo que no se estudiaron detenidamente el problema.
El problema radica en que los grupos de control (cgroups) consideran el uso de memoria dentro del espacio de nombres (contenedor). Cuando todos los procesos en este cgroup finalizan, Docker libera el grupo de control de memoria. Sin embargo, "memoria" no es simplemente la memoria del proceso. Aunque la memoria de los procesos ya no se utiliza, resulta que el núcleo asigna contenido en caché adicional, como dentries e inodes (metadatos de directorios y archivos), que se almacenan en la cgroup de memoria. De la descripción del problema:
zombie cgroups: grupos de control sin procesos que han sido eliminados, pero para los cuales aún se ha asignado memoria (en mi caso, del caché de dentry, pero también puede ser del caché de páginas o tmpfs).
La comprobación del núcleo de todas las páginas en caché al liberar el cgroup puede ser muy lenta, por lo que se eligió un proceso perezoso: esperar hasta que estas páginas sean solicitadas nuevamente, y solo entonces, cuando realmente se necesite la memoria, limpiar finalmente el cgroup. Hasta ese momento, el cgroup todavía se considera al recopilar estadísticas.
En términos de rendimiento, sacrificaron memoria por velocidad: acelerando la limpieza inicial al dejar un poco de memoria en caché. Esto está bien. Cuando el núcleo utiliza la última parte de la memoria caché, el cgroup, en última instancia, se limpia, así que no se puede considerar una 'fuga'. Desafortunadamente, la implementación específica del mecanismo de búsqueda memory.stat en esta versión del núcleo (4.9), combinada con la gran cantidad de memoria en nuestros servidores, resulta en que se requiere mucho más tiempo para recuperar los últimos datos en caché y limpiar los cgroup zombie.
Resulta que en algunos de nuestros nodos había tantos cgroup zombie que la lectura y la latencia superaban el segundo.
Una forma de evitar el problema de cadvisor es liberar inmediatamente las cachés de dentries/inodes en todo el sistema, lo cual elimina de inmediato la latencia de lectura, así como la latencia de red en el host, ya que eliminar la caché incluye las páginas en caché de los cgroup zombie, que también se liberan. No es una solución, pero confirma la causa del problema.
Resultó que en versiones más nuevas del núcleo (4.19+) se mejoró el rendimiento de la llamada memory.stat, por lo que migrar a este núcleo solucionaba el problema. Al mismo tiempo, teníamos herramientas para detectar nodos problemáticos en clústeres de Kubernetes, su elegante desecho y reinicio. Revisamos todos los clústeres, encontramos nodos con latencias suficientemente altas y los reiniciamos. Esto nos dio tiempo para actualizar el sistema operativo en los demás servidores.
Resumiendo
Dado que este bug detenía el procesamiento de las colas de NIC RX durante cientos de milisegundos, también causaba una gran latencia en conexiones cortas y latencias en medio de la conexión, como entre solicitudes de MySQL y paquetes de respuesta.
Comprender y mantener el rendimiento de sistemas tan fundamentales como Kubernetes es crucial para la fiabilidad y velocidad de todos los servicios que se basan en ellos. Todos los sistemas en ejecución se benefician de las mejoras de rendimiento de Kubernetes.
Fuente: habr.com
