

Cuanto más compleja es la sistema, más alertas se generan. Surge la necesidad de reaccionar a estas alertas, agregarlas y visualizarlas. Creo que es una situación familiar para muchos, que puede inducir a un tic nervioso.
La solución de la que hablaremos no es del todo inesperada, pero no se encuentra un artículo completo sobre este tema.
Por lo tanto, decidí compartir la experiencia de FunCorp y contar cómo está estructurado el proceso de guardia, quién llama, por qué y cómo se puede gestionar todo esto.
¿Qué es PagerDuty?
Así que, para abordar todas estas tareas, comenzamos a buscar una herramienta conveniente. Después de breves búsquedas, nos decidimos por PagerDuty. PD nos pareció una solución bastante completa y concisa, con una gran cantidad de integraciones y configuraciones. ¿Qué es exactamente?
En resumen, PagerDuty es una plataforma para el manejo de incidentes que puede gestionar incidentes entrantes a través de diversas integraciones, configurar el orden de las guardias y luego alertar al ingeniero de guardia según el nivel del incidente (con un nivel alto se realiza una llamada, con uno bajo se envía una notificación push de la aplicación/SMS).
¿Quién es el de guardia?
Probablemente, este es el primer aspecto del que se debe hablar al configurar PD.
En FunCorp, como en otras empresas, existe el honoroso puesto de de guardia. Se transfiere de ingeniero a ingeniero una vez al día. Hay una primera y una segunda línea de respuesta a las alertas de PagerDuty. Supongamos que llega una alerta de alta prioridad, y si después de 10 minutos de la llamada al de guardia de primera línea no hay respuesta (es decir, no ha sido cambiada a estado de reconocimiento o resuelto), la llamada se transfiere al segundo ingeniero de guardia. Esto se configura en PagerDuty a través de las Políticas de Escalamiento.
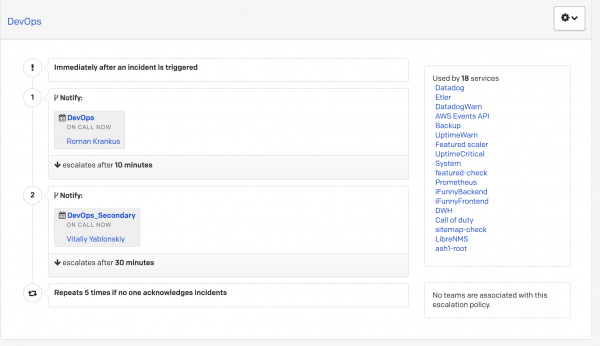
Si el segundo de guardia tampoco responde, la notificación regresa al principal de guardia.
De esta manera, cualquier alerta entrante de alta prioridad no puede quedar sin respuesta.
Ahora veamos de dónde pueden provenir los incidentes.
¿Qué integraciones utilizamos?
En PD llegan una multitud de diversos incidentes de varios servicios. Actualmente tenemos alrededor de 25 de estos servicios, y para su manejo usamos algunas de las integraciones disponibles.
- Prometheus
El sistema principal de recopilación de métricas es Prometheus. Ya se ha escrito mucho sobre ello en Habré, solo diré que tenemos varios para diferentes entornos: uno recopila métricas de máquinas virtuales y contenedores Docker, otro de los servicios de Amazon, y el tercero de máquinas físicas. Principalmente, utilizamos Telegraf como exportador de métricas.
- Correo Electrónico
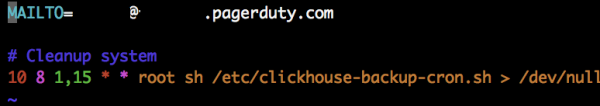
Aquí también, creo que está claro por el nombre. Esta integración se utiliza para enviar notificaciones desde ciertos scripts que se ejecutan por cron. PD te proporciona una dirección a la que envías correos. Al crear un servicio con esta integración, puedes configurar las prioridades en el orden en que se procesarán los incidentes entrantes, así como cómo crear la alerta (por cada correo recibido, por cada correo recibido + alguna regla, etc.).
- Slack
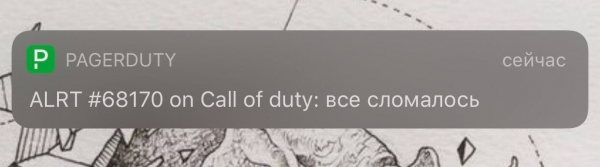
En mi opinión, es una integración bastante interesante. Hay casos en los que ocurre algo, pero no se cubre con incidentes. Por eso añadimos una integración de Slack para crear un incidente. Es decir, en el Slack corporativo puedes escribir /callofduty все тормозит и скоро сломается y PD lo procesará y enviará el incidente al ingeniero de guardia.
Hacemos:
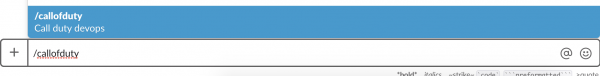
Vemos:
- API
Integración por HTTP. Aquí, en realidad, no hay nada especialmente interesante, solo una solicitud POST con cuerpo en formato JSON. Por ejemplo, de lo interesante: la usamos para monitoreo externo mediante . Este servicio verifica la disponibilidad de nuestros sitios desde diferentes puntos del mundo. En caso de que recibamos un código de respuesta inaceptable (por ejemplo, 502), se crea un incidente y todo continúa por la cadena descrita anteriormente. En StatusCake hay opción de monitoreo de URLs internas, del vencimiento de certificados SSL o de dominios.
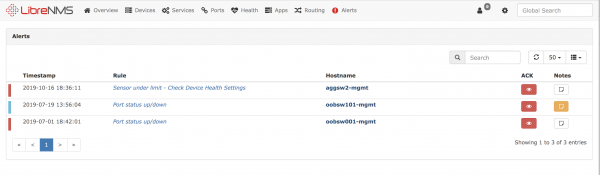
- LibreNMS
Es otro sistema de monitoreo, puedes leer más sobre él en su sitio web . Con él supervisamos las interfaces de red y iDRAC de los servidores.
Hubo también tales integraciones como Datadog, CloudWatch. Más detalles sobre qué les ha pasado se pueden ver .
Visualización
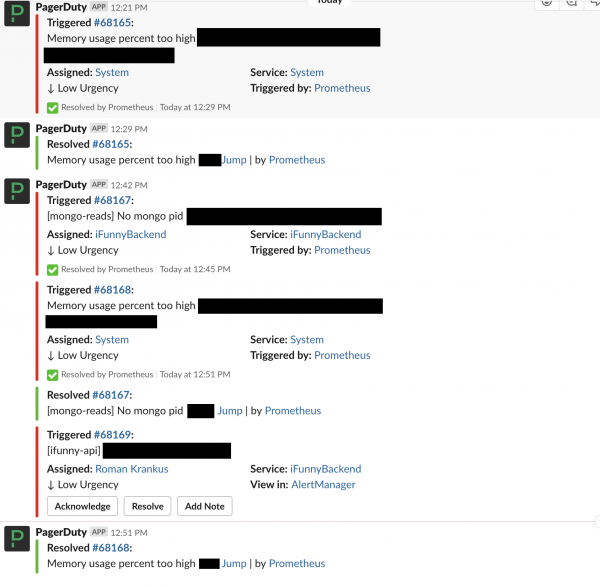
El sistema principal de notificación de incidentes es Slack. En un chat especial se registran todos los incidentes recibidos en PD, y si cambia su estado, también se refleja en el chat.
Cuando surgió la oportunidad de mostrar datos útiles en las pantallas suspendidas del techo, de repente nos dimos cuenta de que nosotros (en el departamento de DevOps) no teníamos nada que mostrar. Hay una maravillosa Grafana, pero no abarca todo, y además los empleados responden a las alertas, no a los gráficos.
Después de una búsqueda minuciosa pero infructuosa en GitHub de un «tablero» conciso e informativo para PD, decidimos crear el nuestro, solo con lo que necesitamos. Aunque al principio teníamos la idea de mostrar la interfaz de PD en la pantalla, eso parecía aún más incómodo.
Para escribirlo, solo se necesita obtener la clave de PD con permisos de solo lectura.
Y esto es lo que logramos:
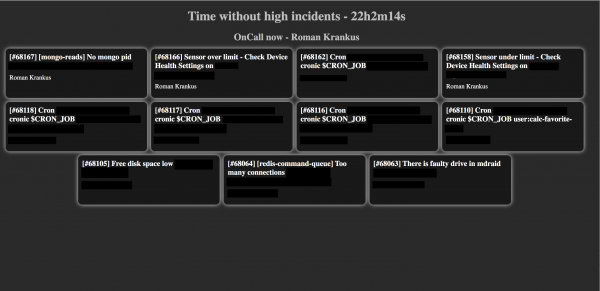
En la pantalla se muestran los incidentes abiertos actuales, el nombre del ingeniero de guardia actual del horario seleccionado y el tiempo sin incidentes de alta prioridad (el panel con el incidente de alta prioridad se resaltará en rojo).
.
Al final, obtuvimos un tablero cómodo para visualizar todos nuestros incidentes. Estaré encantado si nuestra experiencia le resulta útil a alguno de ustedes.
Fuente: habr.com
