

El objetivo principal de Patroni es garantizar la alta disponibilidad para PostgreSQL. Pero Patroni es solo una plantilla, no una herramienta lista para usar (como se menciona en la documentación). A primera vista, al configurar Patroni en un laboratorio de pruebas, se puede ver lo magnífico que es y lo fácil que maneja nuestros intentos de hacer fallar el clúster. Sin embargo, en la práctica, en un entorno de producción, no siempre todo ocurre de manera tan hermosa y elegante como en el laboratorio de pruebas.
Permítanme contarles un poco sobre mí. Comencé como administrador de sistemas. Trabajé en desarrollo web. Desde 2014 trabajo en Data Egret. La empresa se dedica a la consultoría en el ámbito de Postgres. Atendemos específicamente a Postgres y trabajamos con él todos los días, por lo que tenemos una diversa experiencia relacionada con su operación.
A finales de 2018 comenzamos a utilizar Patroni poco a poco. Y acumulamos cierta experiencia. Lo diagnosticamos, lo ajustamos y llegamos a nuestras mejores prácticas. En esta presentación hablaré de ellas.
Además de Postgres, me encanta Linux. Disfruto trastear e investigar, me gusta compilar núcleos. Me fascinan la virtualización, los contenedores, Docker y Kubernetes. Todo esto me interesa, ya que refleja los viejos hábitos de administrador. Me gusta entender los sistemas de monitoreo. Y disfruto de las cuestiones de administración de Postgres, es decir, replicación, copias de seguridad. En mi tiempo libre, programo en Go. No soy ingeniero de software, solo programo para mí, y me da placer.
- Creo que muchos de ustedes saben que Postgres no tiene HA (alta disponibilidad) de forma nativa. Para obtener HA, es necesario instalar algo, configurarlo, esforzarse y conseguirlo.
- Hay varias herramientas, y Patroni es una de ellas, que resuelve HA de manera bastante efectiva y muy bien. Pero al instalar todo esto en el laboratorio de pruebas y ponerlo en marcha, podemos ver que funciona, podemos reproducir ciertos problemas y observar cómo Patroni los maneja. Y veremos que todo funciona a la perfección.
- Pero en la práctica hemos enfrentado diferentes problemas. Y sobre esos problemas hablaré.
- Les contaré cómo lo diagnosticamos, qué ajustes hicimos - si nos ayudó o no.
- No voy a contar cómo instalar Patroni, porque se puede buscar en internet, se pueden ver los archivos de configuración para entender cómo se inicia y se configura todo. Se puede entender los esquemas y arquitecturas encontrando información al respecto en línea.
- No voy a hablar de la experiencia de otros. Solo hablaré de los problemas que nosotros enfrentamos.
- Y no hablaré de problemas que están fuera de Patroni y PostgreSQL. Por ejemplo, problemas relacionados con el balanceo de carga, cuando nuestro clúster se colapsó; de eso no hablaré.
Y un pequeño aviso antes de empezar nuestra presentación.
Todos estos problemas con los que nos encontramos ocurrieron durante los primeros 6-7-8 meses de operación. Con el tiempo llegamos a nuestras mejores prácticas internas y los problemas desaparecieron. Por eso, la presentación fue programada hace aproximadamente medio año, cuando todo estaba fresco en mi mente y lo recordaba perfectamente.
Durante la preparación de la presentación, revisé antiguos informes post-mortem y revisé los registros. Y algunas partes de los detalles podrían haberse olvidado, o podrían no haber sido completamente investigadas durante el análisis de los problemas, por lo que en algunos momentos puede parecer que los problemas no fueron completamente explorados o que falta información. Por eso, les pido disculpas por este aspecto.
¿Qué es Patroni?
- Es una plantilla para construir HA. Así está escrito en la documentación. Y desde mi punto de vista, es una aclaración muy correcta. Patroni no es una solución mágica que resolverá todos tus problemas, es decir, se necesita hacer un esfuerzo para que empiece a funcionar y sea de utilidad.
- Es un servicio de agente que se instala en cada servicio con una base de datos, que actúa como una especie de sistema init para tu Postgres. Arranca Postgres, lo detiene, lo reinicia, cambia la configuración y la topología de tu clúster.
- Por lo tanto, para almacenar el estado del clúster, su representación actual, cómo se ve, se necesita algún tipo de almacenamiento. Y desde este punto de vista, Patroni optó por almacenar el estado en un sistema externo. Es un sistema de almacenamiento de configuración distribuido. Puede ser Etcd, Consul, ZooKeeper, o Etcd de Kubernetes, es decir, alguna de estas opciones.
- Una de las características de Patroni es que el autofailover lo obtienes listo para usar, simplemente configurándolo. Si comparamos con Repmgr, el failover allí viene incluido. Con Repmgr obtenemos switchover, pero si queremos un autofailover, necesitamos configurarlo adicionalmente. En Patroni, el autofailover ya está incluido por defecto.
- Y hay muchas otras cosas. Por ejemplo, el mantenimiento de configuraciones, la adición de nuevas réplicas, copias de seguridad, etc. Pero eso está fuera del alcance de esta presentación, de eso no hablaré.
Y un pequeño resumen es que la principal tarea de Patroni es realizar el autofailover de manera adecuada y confiable, de modo que nuestro clúster siga funcionando y la aplicación no note cambios en la topología del clúster.
Pero cuando empezamos a usar Patroni, nuestro sistema se vuelve un poco más complicado. Si antes teníamos Postgres, al usar Patroni tenemos a Patroni mismo, obtenemos DCS, donde se almacena el estado. Y todo esto debe funcionar de alguna manera. Así que, ¿qué puede fallar?
Puede fallar:
- Puede fallar Postgres. Puede ser un maestro o una réplica, algo de ellos puede fallar.
- Puede fallar el propio Patroni.
- Puede fallar el DCS, donde se almacena el estado.
- Y puede fallar la red.
Todos estos aspectos los estaré tratando en la presentación.
Voy a considerar los casos según se vayan complicando, no desde el punto de vista de que el caso involucra muchos componentes. Sino desde el punto de vista de sensaciones subjetivas, que este caso fue complicado para mí, que fue difícil de desglosar... y al contrario, que algún caso fue fácil y fue fácil de desglosar.
Y el primer caso es el más simple. Es aquel en el que tomamos un clúster de bases de datos y en este mismo clúster desplegamos nuestro almacén DCS. Este es un error muy común. Es un error de construcción arquitectónica, es decir, la combinación de diferentes componentes en un mismo lugar.
Entonces, ocurrió el failover, vamos a investigar qué sucedió.
Y aquí nos interesa saber cuándo ocurrió el failover. Es decir, nos interesa este momento en el tiempo cuando ocurrió el cambio de estado del clúster.
Pero el failover no siempre es inmediato, es decir, no ocupa una unidad de tiempo, puede extenderse. Puede ser prolongado en el tiempo.
Por lo tanto, tiene un tiempo de inicio y un tiempo de finalización, es decir, es un evento prolongado. Dividimos todos los eventos en tres intervalos: tenemos el tiempo antes del failover, durante el failover y después del failover. Es decir, consideramos todos los eventos en esta línea de tiempo.
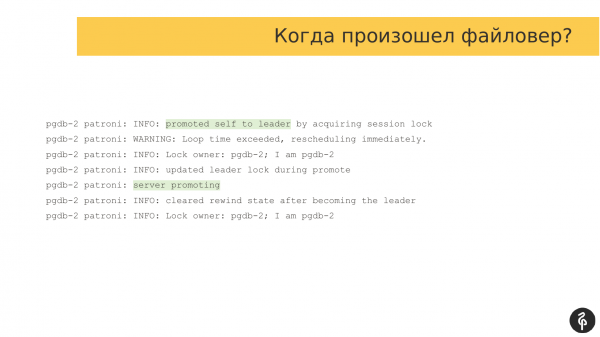
Y lo primero que hacemos cuando ocurre el failover es buscar la causa, qué sucedió, qué provocó que se produjera el failover.
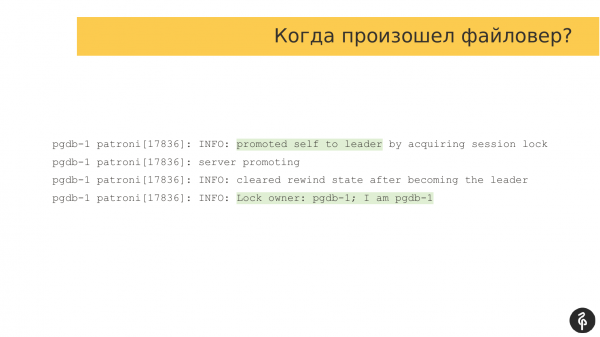
Si miramos los registros, serán los registros clásicos de Patroni. En ellos nos informa que el servidor se ha convertido en el maestro y que el rol de maestro ha pasado a este nodo. Aquí está resaltado.
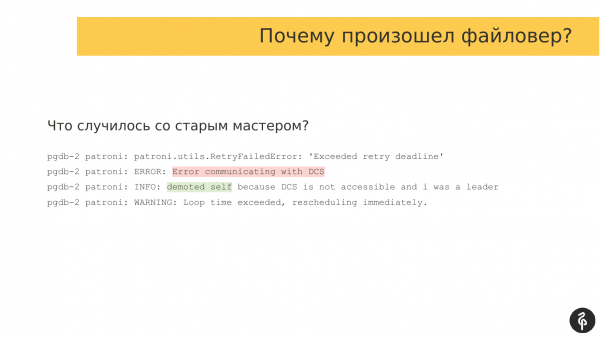
Luego, necesitamos entender por qué ocurrió el failover, es decir, qué eventos ocurrieron que hicieron que el rol de maestro se trasladara de un nodo a otro. En este caso, es muy sencillo. Tenemos un error de interacción con el sistema de almacenamiento. El maestro se dio cuenta de que no podía trabajar con DCS, es decir, surgió algún problema de comunicación. Y dice que ya no puede ser más maestro y renuncia a sus funciones. Esta línea "demoted self" habla precisamente de eso.
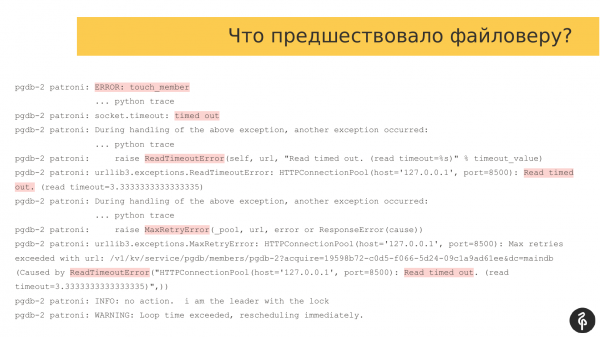
Si vemos los eventos que precedieron al failover, podemos ver las causas que generaron problemas para la continuación del funcionamiento del maestro.
Si consultamos los registros de Patroni, veremos que tenemos una gran cantidad de errores, timeouts, es decir, el agente de Patroni no puede trabajar con DCS. En este caso, se trata del agente Consul, con el cual se comunica a través del puerto 8500.
Y el problema radica en que Patroni y la base de datos se ejecutan en el mismo host. Y en este mismo nodo se ejecutaron servidores Consul. Al crear carga en el servidor, generamos problemas también para el servidores Consul. No pudieron comunicarse correctamente.
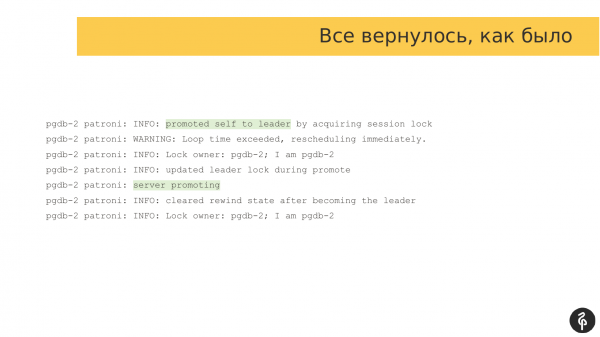
Después de un tiempo, cuando la carga disminuyó, nuestro Patroni pudo comunicarse nuevamente con los agentes. La operación normal se reanudó. Y el mismo servidor Pgdb-2 volvió a ser el maestro. Es decir, hubo un pequeño flip, debido al cual el nodo renunció a su rol de maestro y luego lo asumió de nuevo, es decir, todo volvió a la normalidad.
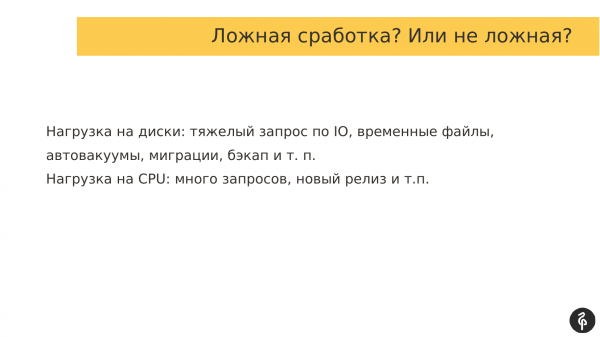
Y esto puede considerarse como un falso disparo, o se puede considerar que Patroni hizo todo correctamente. Es decir, entendió que no podía mantener el estado del clúster y renunció a su rol.
Y aquí surgió el problema porque los servidores Consul están en el mismo hardware que las bases de datos. Por lo tanto, cualquier carga: ya sea en discos o en procesadores, también afecta la interacción con el clúster de Consul.
Y decidimos que esto no debería coexistir, separamos un clúster para Consul. Y Patroni trabajó ya con un Consul separado, es decir, había un clúster de Postgres separado y un clúster de Consul separado. Esta es la guía básica sobre cómo distribuir todas estas cosas y mantenerlas, para que no vivan juntas.
Como opción, se pueden ajustar los parámetros ttl, loop_wait, retry_timeout, es decir, intentar sobrevivir a estos picos de carga a corto plazo al aumentar estos parámetros. Pero esta no es la mejor opción, porque esta carga puede ser prolongada. Y simplemente superaremos los límites de estos parámetros. Y esto puede no ser de gran ayuda.
El primer problema, como entendieron, es simple. Juntamos DCS con la base de datos y obtuvimos un problema.
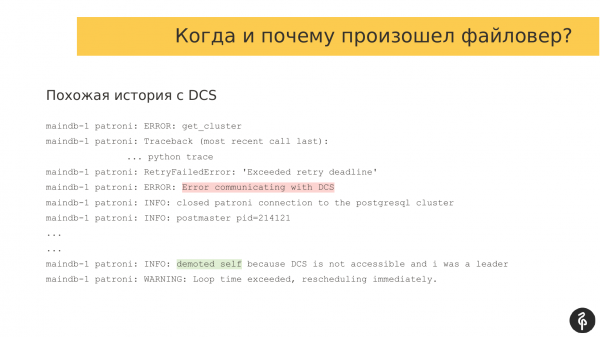
El segundo problema es similar al primero. Es similar en que de nuevo tenemos problemas de interacción con el sistema DCS.
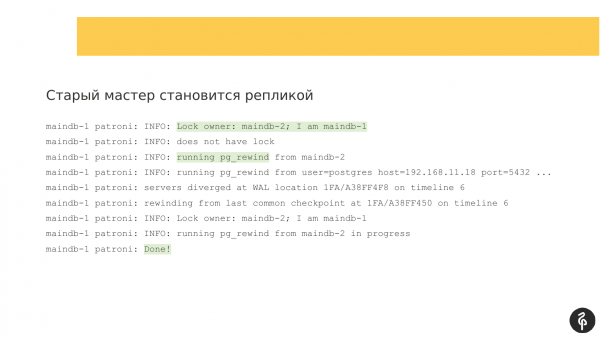
Si miramos los registros, veremos que nuevamente hay un error de comunicación. Y Patroni dice que no puede interactuar con DCS, por lo que el maestro actual pasa a modo réplica.
El viejo maestro se convierte en réplica, aquí Patroni actúa como se espera. Ejecuta pg_rewind para retroceder el registro de transacciones y luego conectarse al nuevo maestro, y ya alcanzar al nuevo maestro. Aquí Patroni actúa como se supone que debe.
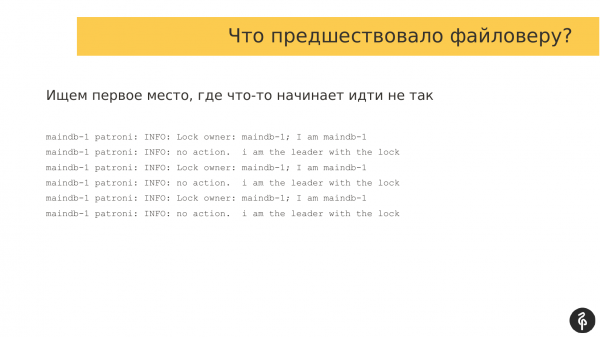
Aquí debemos encontrar el lugar que precedió al failure, es decir, los errores que causaron por qué ocurrió el failure. En este sentido, es bastante conveniente trabajar con los registros de Patroni. Escribe los mismos mensajes en intervalos determinados. Y si comenzamos a recorrer estos registros rápidamente, veremos que han cambiado, lo que significa que han comenzado algunos problemas. Volvemos rápidamente a ese lugar y vemos qué está sucediendo.
Y en una situación normal, los registros se ven aproximadamente así. Se verifica el propietario del bloqueo. Y si el propietario, digamos, cambió, pueden ocurrir ciertos eventos que Patroni debe manejar. Pero en este caso, todo está bien. Buscamos el lugar cuando comenzaron los errores.
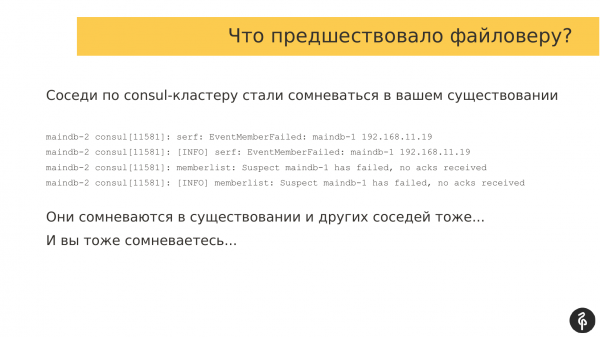
Al desplazarnos hasta el punto donde comenzaron a aparecer los errores, vemos que se produjo un failover automático. Y dado que nuestros errores estaban relacionados con la interacción con DCS y en nuestro caso usamos Consul, también revisamos los registros de Consul para ver qué sucedió allí.
Al comparar aproximadamente el tiempo del failover con el tiempo en los registros de Consul, vemos que nuestros vecinos en el clúster de Consul comenzaron a dudar de la existencia de otros participantes en el clúster de Consul.
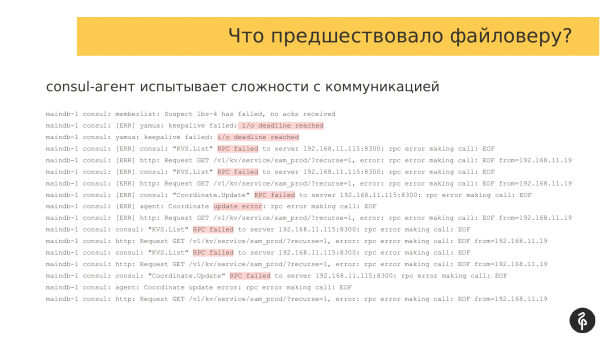
Y si también miramos los registros de otros agentes de Consul, también se puede observar que hay algún colapso de red ocurriendo. Y todos los participantes del clúster de Consul dudan de la existencia de los demás. Esto fue un catalizador para el failover.
Si observamos lo que sucedió antes de estos errores, podemos ver que hay todo tipo de errores, como deadline, RPC fallido, es decir, claramente hay algún problema en la interacción entre los participantes del clúster de Consul.
La respuesta más sencilla es reparar la red. Pero desde mi posición, es fácil decirlo. Sin embargo, las circunstancias son tales que el cliente no siempre podrá permitirse reparar la red. Puede vivir en un centro de datos y no tener la capacidad de reparar la red o influir en el equipo. Por lo tanto, se necesitan otras opciones.
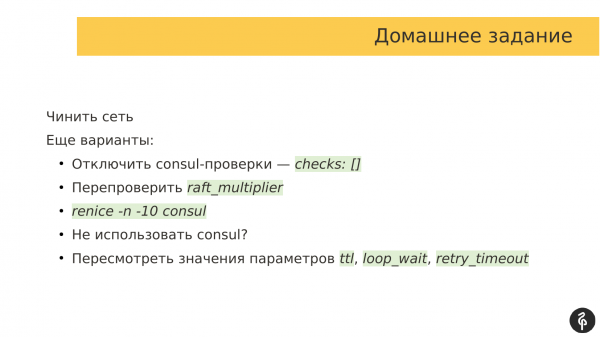
Existen opciones:
- La opción más sencilla, que creo que está incluso escrita en la documentación, es desactivar las comprobaciones de Consul, es decir, simplemente pasar un arreglo vacío. Y le decimos al agente de Consul que no use ninguna verificación. Gracias a estas verificaciones, podemos ignorar estas tormentas de red y no iniciar un failover.
- Otra opción es volver a verificar el raft_multiplier. Este es un parámetro del servidor Consul. Por defecto, se establece en un valor de 5. Este valor es recomendado por la documentación para entornos de staging. En esencia, afecta la frecuencia de intercambio de mensajes entre los participantes de la red de Consul. En realidad, este parámetro influye en la velocidad de la comunicación auxiliar entre los participantes del clúster de Consul. Y para producción, ya se recomienda reducirlo para que los nodos intercambien mensajes con más frecuencia.
- Otra opción que hemos comenzado a utilizar es aumentar la prioridad de los procesos de Consul entre otros procesos para el planificador de procesos del sistema operativo. Hay un parámetro llamado «nice», que define precisamente la prioridad de los procesos que es considerada por el planificador del SO al programar. Hemos reducido el valor de nice para los agentes de Consul, es decir, hemos aumentado la prioridad para que el sistema operativo proporcione más tiempo a los procesos de Consul para trabajar y ejecutar su código. En nuestro caso, esto resolvió el problema.
- Otra opción es no usar Consul. Tengo un amigo que es un gran defensor de Etcd. Y discutimos regularmente sobre qué es mejor, Etcd o Consul. Pero en términos de cuál es mejor, normalmente coincidimos en que Consul tiene un agente que debe estar en funcionamiento en cada nodo con la base de datos. Es decir, la interacción de Patroni con el clúster de Consul se realiza a través de este agente. Y este agente se convierte en un cuello de botella. Si algo le sucede al agente, Patroni ya no puede trabajar con el clúster de Consul. Esto es un problema. En el caso de Etcd, no hay ningún agente. Patroni puede trabajar directamente con la lista de servidores de Etcd y comunicarse con ellos. En este sentido, si en su empresa utilizan Etcd, probablemente sea una mejor opción que Consul. Pero para nuestros clientes siempre estamos limitados por lo que el cliente ha elegido y utiliza. Y en su mayoría, Consul está presente en todos los clientes.
- Y el último punto es revisar los valores de los parámetros. Podemos aumentar estos parámetros con la esperanza de que nuestros problemas de red transitorios sean breves y no entren en el intervalo de estos parámetros. De esta manera, podemos reducir la agresividad de Patroni en la ejecución del failover automático si surgen problemas de red.
Creo que muchos que utilizan Patroni están familiarizados con este comando.
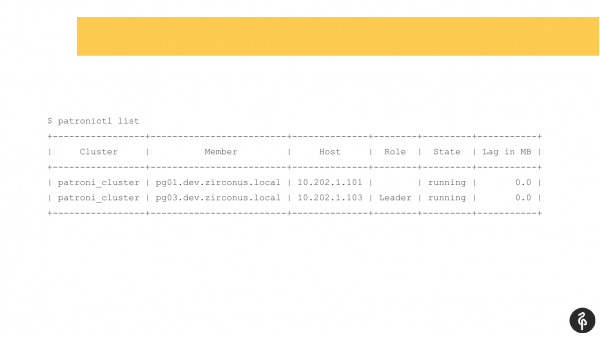
Este comando muestra el estado actual del clúster. Y a primera vista, esta imagen puede parecer normal. Tenemos un maestro, tenemos una réplica, no hay retraso en la replicación. Pero esta imagen es normal solo hasta que sabemos que en este clúster deberían haber tres nodos, no dos.
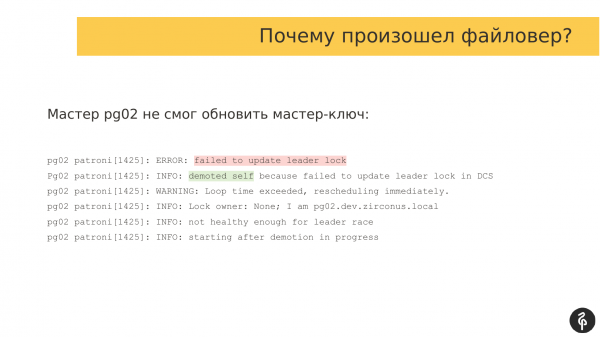
Por lo tanto, ocurrió un autofailover. Y después de este autofailover, nuestra réplica desapareció. Necesitamos averiguar por qué desapareció y recuperarla. Y de nuevo, revisamos los registros para ver por qué ocurrió el autofailover.
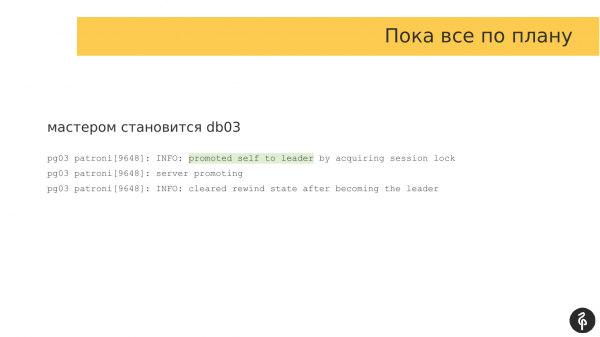
En este caso, la segunda réplica se convirtió en maestro. Todo está bien aquí.
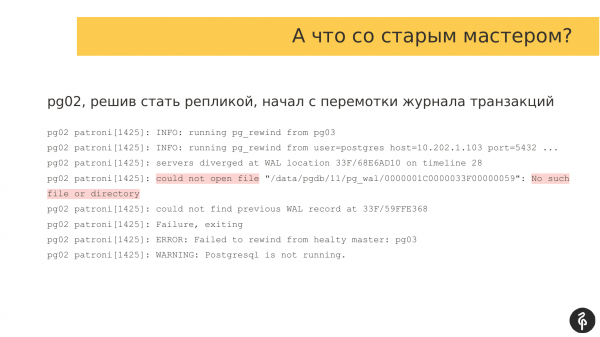
Y necesitamos observar la réplica que se desconectó y que no está en el clúster. Abrimos los registros de Patroni y vemos que surgió un problema en el proceso de conexión al clúster en la fase de pg_rewind. Para conectarse al clúster, es necesario retroceder el registro de transacciones, solicitar el registro de transacciones necesario del maestro y alcanzarlo.
En este caso, no tenemos el registro de transacciones y la réplica no puede iniciarse. Por lo tanto, detenemos Postgres con un error. Y es por eso que no está en el clúster.
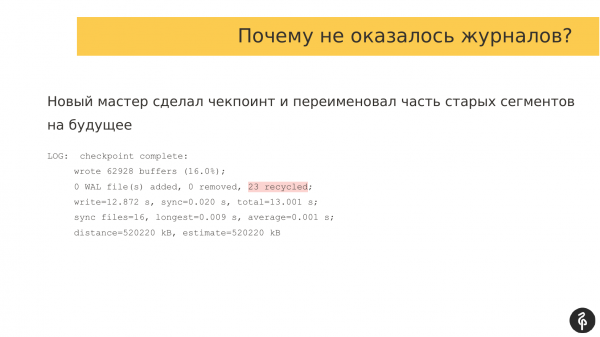
Es necesario entender por qué no está en el clúster y por qué no había registros. Vamos al nuevo maestro y vemos qué hay en sus registros. Resulta que cuando se hizo el pg_rewind, ocurrió un checkpoint. Y parte de los antiguos registros de transacciones simplemente fue renombrada. Cuando el antiguo maestro intentó conectarse al nuevo maestro y solicitar esos registros, ya habían sido renombrados; simplemente no estaban.
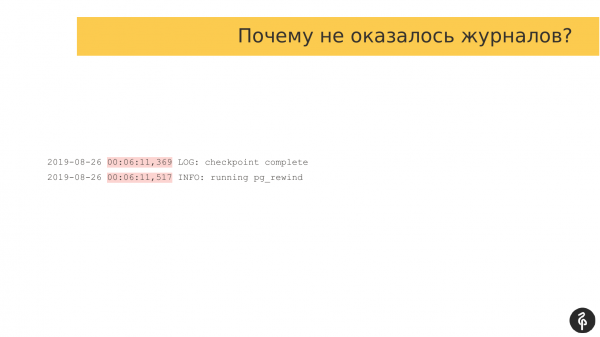
Comparé las marcas de tiempo cuando ocurrieron estos eventos. Y la diferencia es de apenas 150 milisegundos, es decir, el checkpoint se completó en 369 milisegundos y los segmentos WAL fueron renombrados. Y apenas 517 milisegundos después, se inició el rewind en la antigua réplica. Es decir, se necesitó literalmente 150 milisegundos para que la réplica no pudiera conectarse y funcionar.
¿Cuáles son las opciones?
Inicialmente utilizamos slots de replicación. Nos parecía que esto era bueno. Sin embargo, en la primera etapa de uso, desactivamos los slots. Pensamos que, si los slots acumulaban muchos segmentos WAL, podríamos caer el maestro. Por un tiempo, lidiamos sin slots. Y luego entendimos que los slots son necesarios, así que los recuperamos.
Pero aquí hay un problema, que cuando el maestro cambia a la réplica, elimina los slots y junto con los slots elimina los segmentos WAL. Y para evitar que este problema ocurra, decidimos aumentar el parámetro wal_keep_segments. Por defecto son 8 segmentos. Lo subimos a 1,000 y vimos cuánto espacio libre teníamos. Y donamos 16 gigabytes para wal_keep_segments. Es decir, al hacer el cambio, siempre tenemos en todos los nodos un margen de 16 gigabytes de registros de transacciones.
Y además, esto es relevante para tareas de mantenimiento prolongadas. Supongamos que necesitamos actualizar una de las réplicas. Y queremos apagarla. Necesitamos actualizar el software, tal vez el sistema operativo, o algo más. Y cuando apagamos la réplica, también se elimina el slot de esa réplica. Y si usamos un wal_keep_segments pequeño, al estar la réplica ausente durante un largo tiempo, los registros de transacciones se reproducirán. Reiniciaremos la réplica, pedirá esos registros de transacciones donde se detuvo, pero en el maestro puede que no existan. Y la réplica tampoco podrá conectarse. Por eso mantenemos un gran margen de registros.
Tenemos una base de producción. Allí ya están funcionando proyectos.
Ha ocurrido un failover. Entramos y revisamos: todo está bien, las réplicas están en su lugar, no hay retraso en la replicación. No hay errores en los registros, todo está en orden.
El equipo de producto dice que deberían haber algunos datos, pero los vemos en una fuente, y en la base no los vemos. Y necesitamos entender qué ocurrió con ellos.
Está claro que pg_rewind los ha sobrescrito. Nos dimos cuenta de esto de inmediato, pero fuimos a investigar qué había pasado.
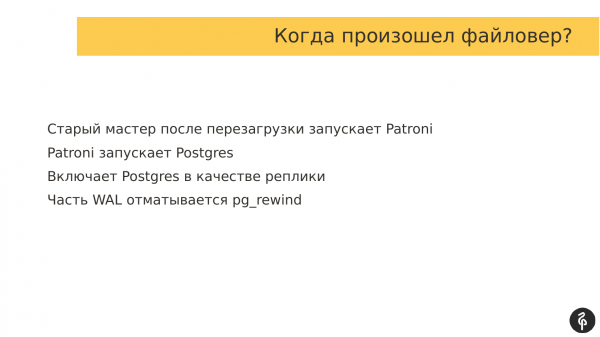
En los logs siempre podemos encontrar cuándo ocurrió el failover, quién se convirtió en maestro y podemos determinar quién era el antiguo maestro y cuándo quiso convertirse en réplica, es decir, necesitamos esos logs para averiguar el volumen de registros de transacciones que se perdió.
Nuestro antiguo maestro se reinició. Y en el autoarranque estaba escrito Patroni. Se inició Patroni. Luego inició Postgres. Más precisamente, antes de iniciar Postgres y antes de hacerlo réplica, Patroni ejecutó el proceso pg_rewind. Por lo tanto, eliminó parte de los registros de transacciones, descargó nuevos y se conectó. Aquí Patroni funcionó de maravilla, es decir, como se esperaba. Nuestro clúster se recuperó. Tuvimos 3 nodos, después del failover 3 nodos: todo genial.
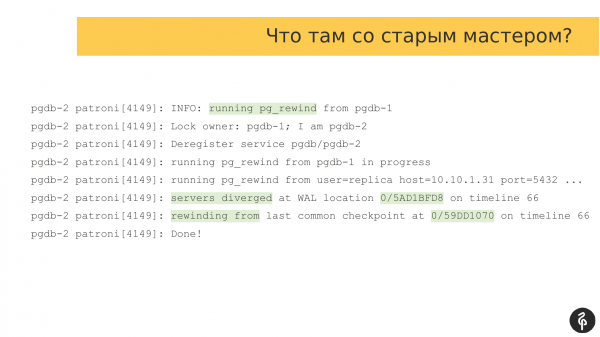
Hemos perdido parte de los datos. Y necesitamos entender cuánto hemos perdido. Estamos buscando el momento exacto en el que ocurrió el rewind. Podemos encontrar esto a través de registros en el log. Se inició el rewind, hizo algo y finalizó.
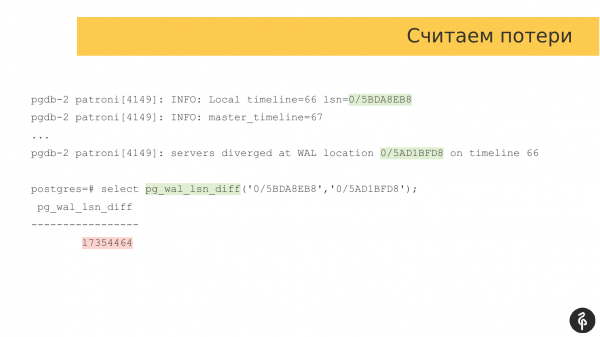
Necesitamos encontrar la posición en el log de transacciones donde se detuvo el antiguo maestro. En este caso, este es el marcador. Y necesitamos un segundo marcador, es decir, la distancia que difiere el antiguo maestro del nuevo.
Tomamos la diferencia pg_wal_lsn_diff habitual y comparamos estos dos marcadores. En este caso, obtenemos 17 megabytes. Cada uno decide si esto es mucho o poco. Porque para algunos 17 megabytes es poco, para otros es mucho e inaceptable. Aquí cada uno determina individualmente de acuerdo con las necesidades del negocio.
¿Pero qué hemos descubierto para nosotros?
En primer lugar, debemos decidir si siempre necesitamos el autoarranque de Patroni tras un reinicio del sistema. A menudo sucede que debemos acceder al antiguo maestro, ver cuán lejos ha llegado. Posiblemente inspeccionar los segmentos del log de transacciones, ver qué hay allí. Y entender si podemos perder estos datos o si necesitamos arrancar el antiguo maestro en modo independiente para recuperar estos datos.
Y solo después de esto debemos tomar decisiones sobre si podemos descartar estos datos o si podemos restaurarlos, conectando este nodo como réplica en nuestro clúster.
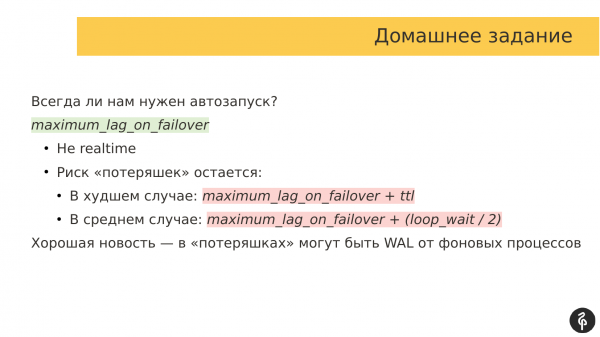
Además, hay un parámetro llamado 'maximum_lag_on_failover'. Por defecto, si no me equivoco, este parámetro tiene un valor de 1 megabyte.
¿Cómo funciona? Si nuestra réplica tiene un retraso de 1 megabyte de datos por el lag de replicación, esta réplica no participa en las elecciones. Y si ocurre un failover, Patroni verifica qué réplicas están retrasadas. Si están atrasadas en una gran cantidad de logs de transacciones, no pueden convertirse en maestro. Esta es una muy buena función de protección que evita la pérdida de muchos datos.
Pero aquí hay un problema: el lag de replicación en el clúster Patroni y DCS se actualiza a intervalos específicos. Creo que el valor predeterminado de ttl es de 30 segundos.
Por lo tanto, puede haber una situación en la que el retraso de replicación para las réplicas en el DCS sea uno, mientras que en realidad puede haber un retraso completamente diferente o, de hecho, puede que no haya retraso alguno, es decir, esta cosa no es en tiempo real. Y no siempre refleja la imagen real. No vale la pena construir una lógica compleja sobre ello.
Y el riesgo de pérdidas siempre permanece. Y en el peor de los casos, una fórmula, y en el caso promedio, otra fórmula. Es decir, cuando planeamos la implementación de Patroni y evaluamos cuántos datos podemos perder, debemos basarnos en estas fórmulas y tener una idea aproximada de cuántos datos podemos perder.
Y hay una buena noticia. Cuando el viejo maestro se ha adelantado, puede haberse adelantado debido a algunos procesos de fondo. Es decir, hubo un autovacuum, escribió datos, los guardó en el registro de transacciones. Y esos datos podemos ignorar fácilmente y perder. No hay ningún problema en ello.
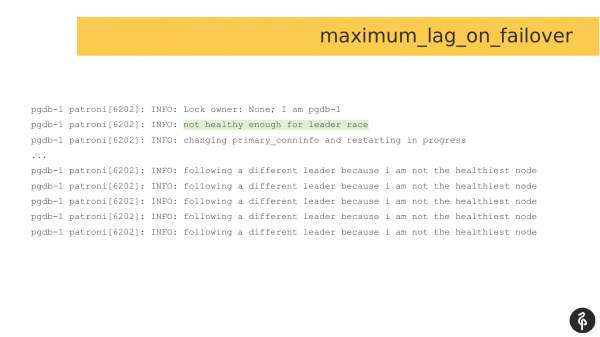
Y así se ven los registros en caso de que se establezca maximum_lag_on_failover y ocurra un failover, y sea necesario elegir un nuevo maestro. La réplica se evalúa a sí misma como incapaz de participar en las elecciones. Y se niega a participar en la carrera por ser el líder. Y espera a que se elija un nuevo maestro para luego conectarse a él. Esta es una medida adicional contra la pérdida de datos.
Aquí nuestro equipo de producto escribió que su producto tiene problemas al trabajar con Postgres. Al mismo tiempo, no se puede acceder al propio maestro porque no está disponible por SSH. Y el auto-failover tampoco ocurre.
Este host fue forzado a reiniciarse. Debido al reinicio, ocurrió un auto-failover, aunque podría haberse realizado un failover manual, como entiendo ahora. Y después del reinicio, ya vamos a ver qué pasó con el maestro actual.
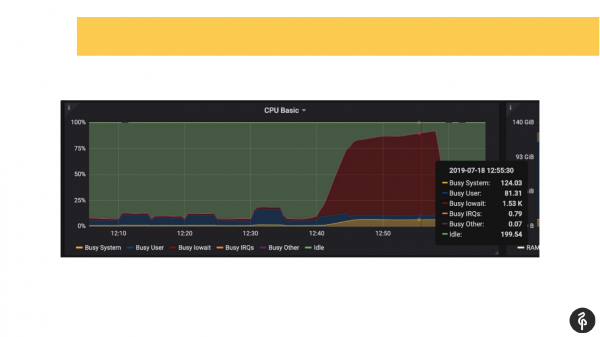
Y al mismo tiempo, ya sabíamos de antemano que teníamos problemas con los discos, es decir, ya teníamos conocimiento por monitoreo de dónde investigar y qué buscar.
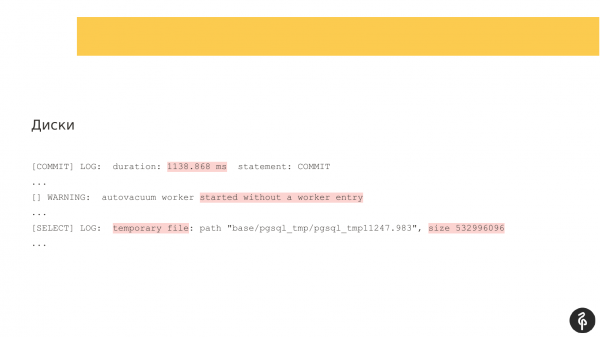
Revisamos el registro de postgres, comenzamos a ver qué estaba sucediendo. Vimos commits que duraban de uno a tres segundos, lo cual no es normal. Vimos que nuestro autovacuum se iniciaba muy lentamente y de manera extraña. Y vimos archivos temporales en el disco. Es decir, todos estos son indicadores de problemas con los discos.
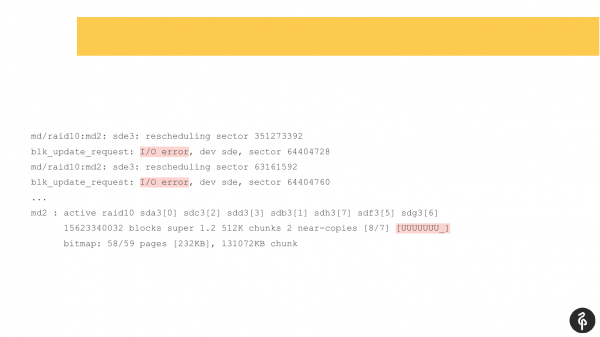
Examinamos el dmesg del sistema (en el registro de mensajes del núcleo). Y vimos que teníamos problemas con uno de los discos. La subsistema de discos representaba un software Raid. Revisamos /proc/mdstat y vimos que faltaba un disco. Es decir, aquí hay un Raid de 8 discos, nos falta uno. Si miramos detenidamente la diapositiva, podemos ver que nos falta sde. Es como si, por decirlo de alguna manera, se hubiera caído un disco. Esto activó problemas en los discos, y las aplicaciones también experimentaron problemas al trabajar con el clúster de Postgres.
Y en este caso, Patroni no nos habría ayudado, porque Patroni no tiene la tarea de monitorear el estado del servidor ni el estado del disco. Debemos rastrear este tipo de situaciones con monitoreo externo. Agregamos rápidamente el monitoreo de discos al monitoreo externo.
Y se nos ocurrió la idea: ¿podría ayudarnos el fencing o un watchdog de software? Pensamos que probablemente no nos ayudaría en este caso, porque durante los problemas, Patroni continuó interactuando con el clúster DCS y no vio ningún problema. Es decir, desde el punto de vista del DCS y de Patroni, todo estaba bien en el clúster, aunque de hecho hubo problemas con el disco y problemas de disponibilidad de la base de datos.
En mi opinión, este es uno de los problemas más extraños, que investigué durante mucho tiempo, leí muchos registros y lo llamé simulador de clúster.
El problema era que el antiguo maestro no podía convertirse en una réplica normal, es decir, Patroni lo iniciaba, Patroni mostraba que este nodo estaba presente como réplica, pero al mismo tiempo no era una réplica normal. Ahora verán por qué. Esto lo tengo guardado desde el análisis de aquel problema.
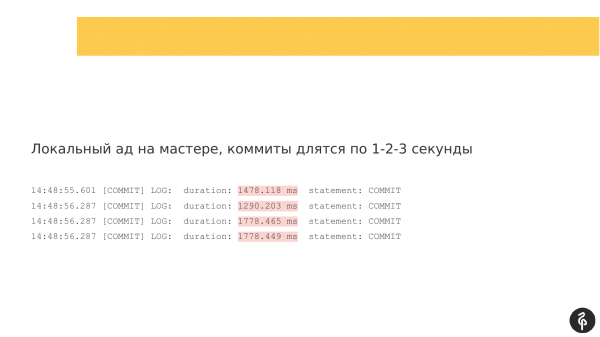
¿Y cómo comenzó todo? Comenzó, al igual que en el problema anterior, con lentitud en los discos. Teníamos confirmaciones de uno o dos por segundo.
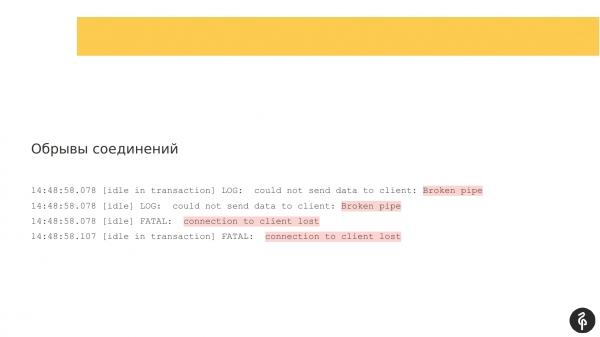
Hubo interrupciones de conexiones, es decir, los clientes se desconectaban.
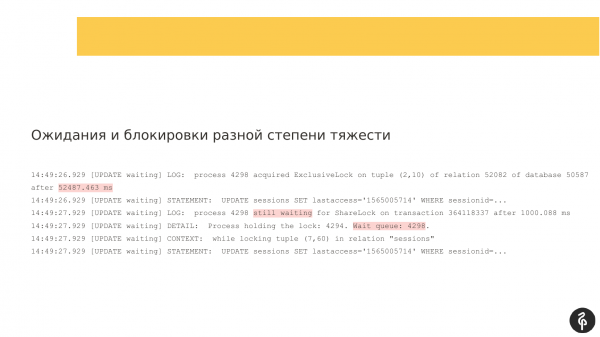
Hubo bloqueos de diversas severidades.
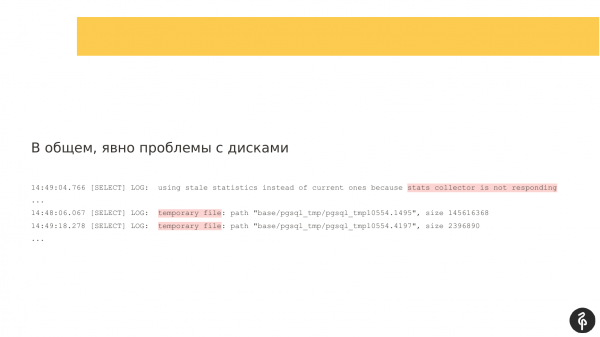
Y, por lo tanto, la subsistema de discos no era muy receptiva.
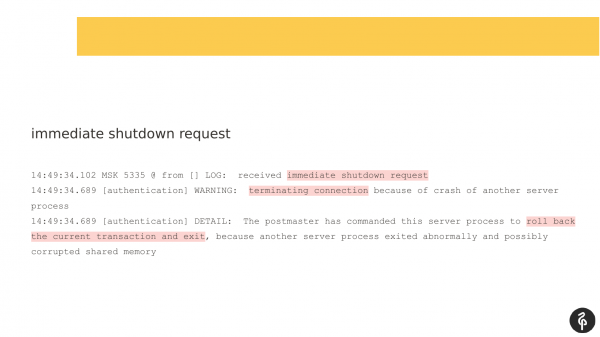
Y lo más misterioso para mí fue la solicitud de apagado inmediato que llegó. Postgres tiene tres modos de apagado:
- El modo graceful, donde esperamos a que todos los clientes se desconecten de forma autónoma.
- El modo fast, donde obligamos a los clientes a desconectarse porque vamos a apagar.
- Y inmediato. En este caso, inmediato ni siquiera informa a los clientes que deben desconectarse, simplemente se apaga sin previo aviso. Y a todos los clientes, el sistema operativo envía un mensaje RST (mensaje TCP que indica que la conexión se ha interrumpido y que el cliente no tiene nada más que buscar).
¿Quién envió esta señal? Los procesos en segundo plano de Postgres no se envían tales señales entre sí, es decir, es un kill-9. No se envían entre ellos, solo reaccionan a ello, es decir, es un reinicio de emergencia de Postgres. No sé quién lo envió.
Mirei el comando 'last' y vi a una persona que también inició sesión en este servidor junto con nosotros, pero me dio vergüenza preguntar. Quizás fue un kill -9. Vería en los logs un kill -9, porque Postgres registra que recibió un kill -9, pero no lo vi en los logs.
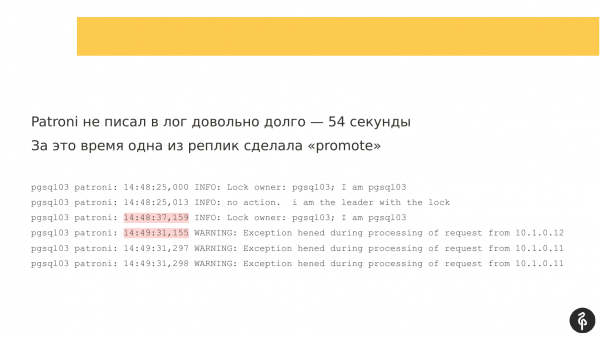
Investigando más, vi que Patroni no había escrito en el log durante bastante tiempo: 54 segundos. Y si comparamos dos timestamps, aquí aproximadamente 54 segundos no hubo mensajes.
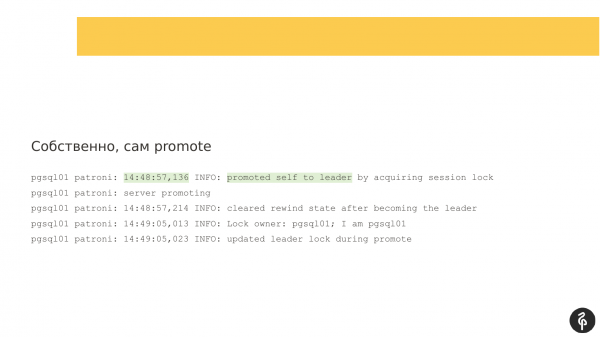
Y durante ese tiempo ocurrió un failover automático. Patroni funcionó perfectamente aquí. Nuestro antiguo maestro estaba inalcanzable, algo le estaba sucediendo. Y comenzaron las elecciones de un nuevo maestro. Todo funcionó bien aquí. pgsql01 se convirtió en el nuevo líder.
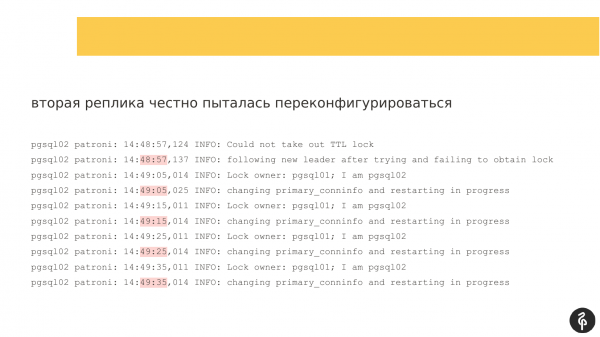
Tenemos una réplica que se convirtió en maestro. Y hay una segunda réplica. Y hubo problemas con la segunda réplica. Estaba intentando reconfigurarse. Según entiendo, intentaba cambiar recovery.conf, reiniciar Postgres y conectarse al nuevo maestro. Cada 10 segundos escribe mensajes indicando que lo intenta, pero no lo logra.
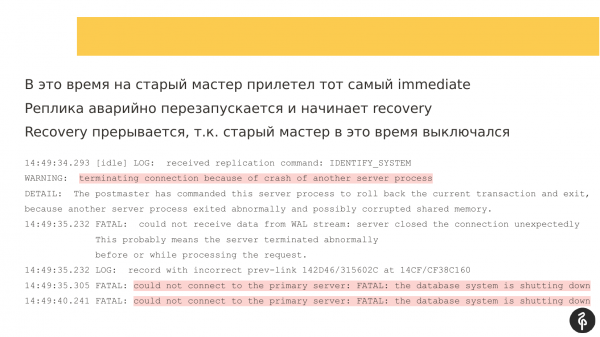
Y durante esos intentos, un señal de immediate-shutdown llega al antiguo maestro. El maestro se reinicia. Y también se detiene la recuperación, porque el antiguo maestro se reinicia. Es decir, la réplica no puede conectarse a él porque está en modo apagado.
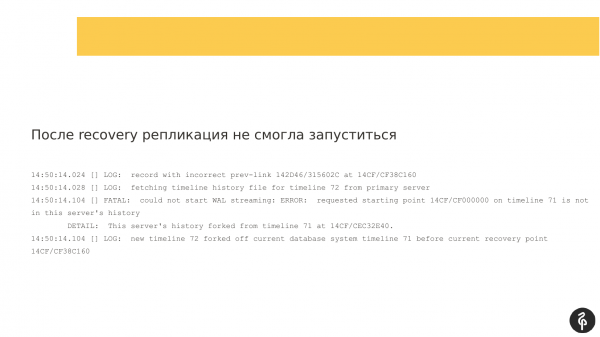
En algún momento funcionó, pero la replicación no se inició.
Tengo una única hipótesis: que en recovery.conf había la dirección del antiguo maestro. Y cuando apareció el nuevo maestro, la segunda réplica todavía intentaba conectarse al antiguo maestro.
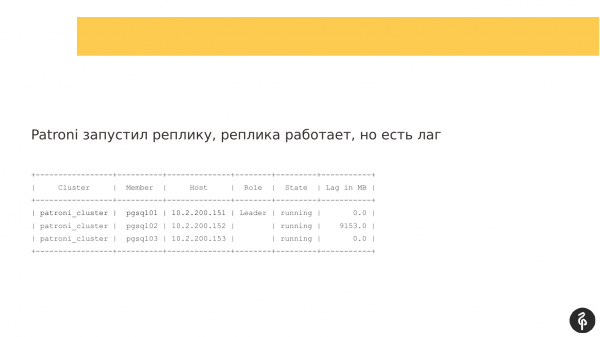
Cuando Patroni se inició en la segunda réplica, el nodo se inició, pero no pudo conectarse a la replicación. Y surgió un retraso en la replicación que se veía más o menos así. Es decir, los tres nodos estaban en su lugar, pero el segundo nodo estaba atrasado.
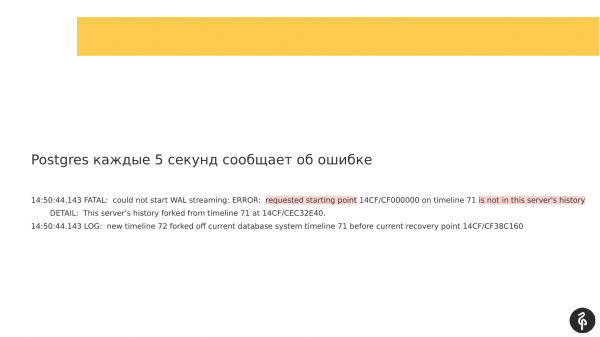
Sin embargo, si miras los registros que se escribieron, se podía ver que la replicación no podía iniciarse porque los registros de transacciones eran diferentes. Y los registros de transacciones que ofrece el maestro, que están indicados en recovery.conf, simplemente no son adecuados para nuestro nodo actual.
Y aquí cometí un error. Debí haber ido a verificar qué había en recovery.conf para comprobar mi hipótesis de que nos estábamos conectando al maestro equivocado. Pero en ese momento apenas estaba aprendiendo sobre esto y no se me ocurrió, o vi que la replicación estaba desactualizada y tendría que volver a configurarla; es decir, de alguna manera lo manejé de forma descuidada. Fue mi fallo.
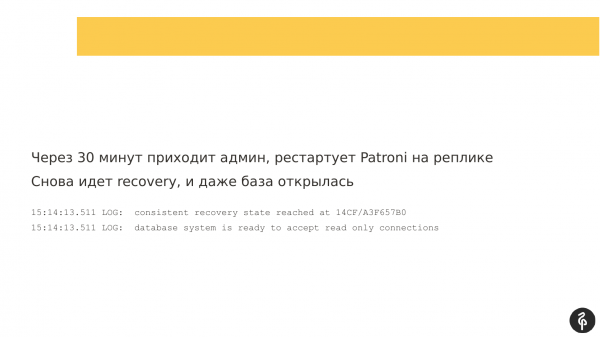
Treinta minutos después, llegó el administrador; es decir, reinicié Patroni en la réplica. Ya había perdido la esperanza en ella, pensaba que tendría que volver a configurarla. Y pensé: voy a reiniciar Patroni, tal vez algo bueno suceda. Se inició la recuperación. Y la base de datos incluso se abrió, estaba lista para aceptar conexiones.
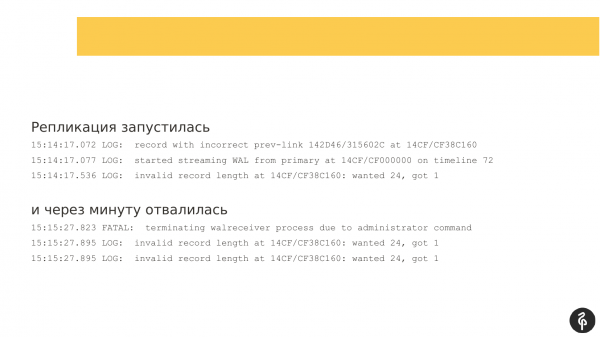
La replicación se inició. Pero después de un minuto, se cayó con un error de que los registros de transacciones no eran adecuados.
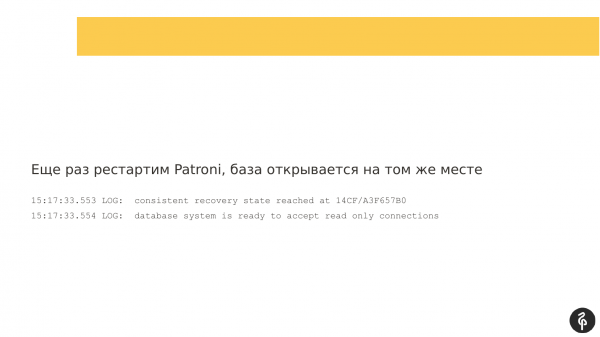
Pensé que lo volvería a reiniciar. Reinicié Patroni otra vez, y no reinicié Postgres, sino que reinicié específicamente Patroni, con la esperanza de que iniciara la base de datos de manera mágica.
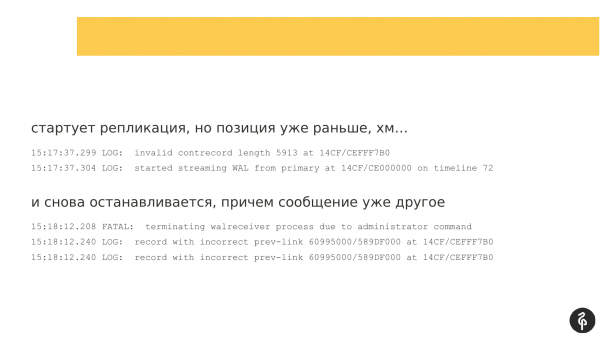
La replicación se reinició, pero las marcas en el registro de transacciones eran diferentes, no eran las que estaban en el intento anterior. La replicación se detuvo nuevamente. Y el mensaje era un poco diferente. Y no era muy informativo para mí.
Y aquí se me ocurrió: ¿qué tal si reinicio Postgres y, en ese momento, en el maestro actual hago un checkpoint para mover el punto en el registro de transacciones un poco más adelante, para que la recuperación comience desde otro momento? Además, teníamos espacio de WAL disponible.
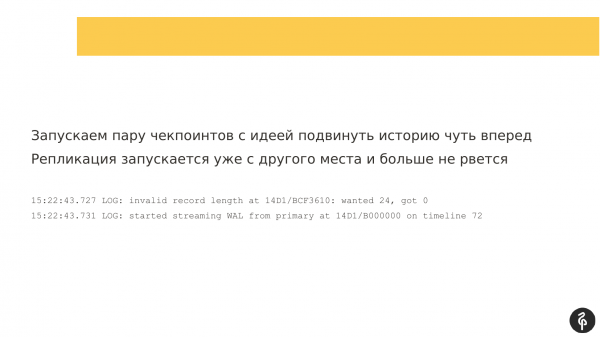
Reinicié Patroni, hice un par de checkpoints en el maestro, unos puntos de reinicio en la réplica cuando se abrió. Y eso ayudó. Pensé mucho sobre por qué eso ayudó y cómo funcionó. Y la réplica se inició. Y la replicación no se interrumpió más.
Este problema es uno de los más enigmáticos para mí, sobre el que aún sigo reflexionando, sobre qué estaba ocurriendo realmente.
¿Cuáles son las conclusiones aquí? Patroni puede funcionar como se espera y sin errores. Pero esto no garantiza al 100 % que todo esté bien. La réplica puede iniciarse, pero puede estar en un estado semi-operativo, y la aplicación no puede trabajar con esa réplica porque contendrá datos antiguos.
Y después de cada failover, siempre debemos verificar que todo esté en orden con el clúster, es decir, que haya el número adecuado de réplicas y que no haya latencia en la replicación.
Y a medida que reviso estos problemas, formularé recomendaciones. Intenté agruparlas en dos diapositivas. Probablemente, todas las historias se podrían haber resumido en dos diapositivas y solo contar eso.
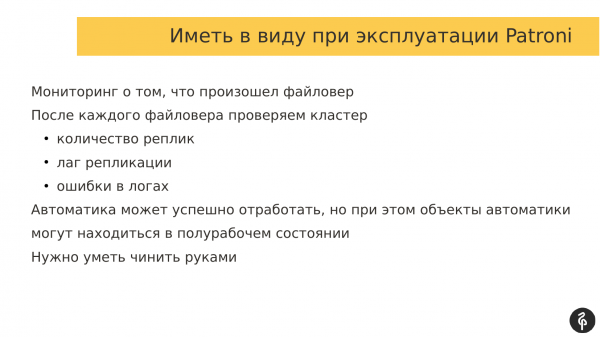
Cuando usas Patroni, es imprescindible tener monitoreo. Siempre debes saber cuándo ocurrió un failover automático, porque si no sabes que hubo un failover automático, no estás controlando el clúster. Y eso es malo.
Después de cada failover, siempre debemos verificar manualmente el clúster. Debemos asegurarnos de que siempre tengamos el número adecuado de réplicas, que no haya latencia en la replicación, y que en los registros no haya errores relacionados con la replicación en flujo, con Patroni, o con el sistema DCS.
La automatización puede funcionar con éxito; Patroni es una herramienta muy buena. Puede funcionar, pero eso no llevará al clúster al estado deseado. Y si no nos enteramos de ello, tendremos problemas.
Y Patroni no es una balas de plata. Aún debemos tener una comprensión de cómo funciona Postgres, cómo se lleva a cabo la replicación y cómo Patroni opera con Postgres, así como asegurar la interacción entre los nodos. Esto es necesario para poder solucionar los problemas que surgen manualmente.
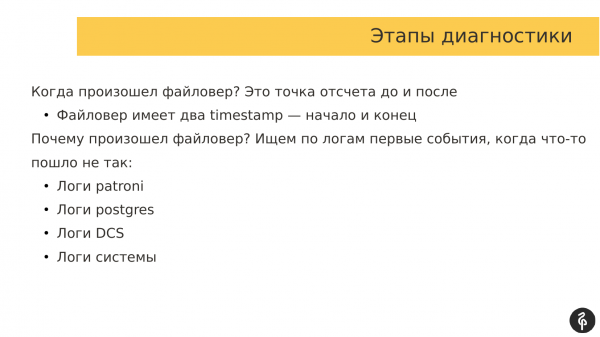
¿Cómo abordo la cuestión del diagnóstico? Ha sucedido que trabajamos con diferentes clientes y nadie tiene un stack ELK, así que necesito revisar los registros abriendo 6 consolas y 2 pestañas. En una pestaña están los registros de Patroni para cada nodo, en la otra pestaña están los registros de Consul, o Postgres si es necesario. Diagnosticar esto es muy complicado.
¿Qué enfoques he desarrollado? Primero, siempre miro cuándo ocurrió el failover. Y para mí, este es un punto de inflexión. Observo lo que sucedió antes del failover, durante el failover y después del failover. Un failover tiene dos marcas: el tiempo de inicio y el tiempo de finalización.
Luego, reviso en los registros los eventos previos al failover, es decir, estoy buscando las causas por las que ocurrió el failover.
Y esto proporciona una imagen de lo que sucedió y qué se puede hacer en el futuro para evitar que tales circunstancias ocurran (y, como resultado, un failover).
¿Y a dónde miramos normalmente? Yo miro:
- Primero en los registros de Patroni.
- Luego reviso los registros de Postgres, o los registros de DCS dependiendo de lo que se encuentre en los registros de Patroni.
- Y los registros del sistema también a veces dan una idea de qué fue lo que causó el failover.
¿Qué opinó de Patroni? Tengo una muy buena opinión de Patroni. En mi opinión, es lo mejor que hay hoy en día. Conozco muchos otros productos. Son Stolon, Repmgr, Pg_auto_failover, PAF. Cuatro herramientas. Las he probado todas. A Patroni le tengo más aprecio.
Si me preguntan: "¿Recomiendo Patroni?". Diré que sí, porque me gusta Patroni. Y, me parece que he aprendido a configurarlo.
Si te interesa ver qué otros problemas hay con Patroni, aparte de los problemas que he mencionado, siempre puedes ir a la página en GitHub. Hay muchas historias diferentes y se discuten muchos problemas interesantes. Y, al final, se han reportado y resuelto algunos errores, es decir, es una lectura interesante.
Ahí hay historias interesantes sobre cómo la gente se dispara en el pie. Muy instructivo. Lees y entiendes que así no se debe hacer. Ya he tomado nota.
Y quisiera dar un gran agradecimiento a la empresa Zalando por desarrollar este proyecto, en particular a Alexander Kukushkin y Alexey Klyukin. Alexey Klyukin es uno de los co-autores, ya no trabaja en Zalando, pero son dos personas que empezaron a trabajar con este producto.
Y creo que Patroni es una herramienta muy genial. Estoy contento de que exista, es interesante de usar. Y muchas gracias a todos los contribuidores que escriben parches para Patroni. Espero que Patroni se vuelva más maduro, genial y funcional con el tiempo. Ya es funcional, pero espero que siga mejorando. Así que si planeas usar Patroni, no temas. Es una buena solución, se puede implementar y usar.
Eso es todo. Si tienes preguntas, no dudes en preguntar.
Preguntas
¡Gracias por la presentación! Si después del failover todavía hay que revisarlo con mucho cuidado, ¿entonces para qué necesitamos un failover automático?
Porque es algo nuevo. Solo hemos estado trabajando con ello durante un año. Es mejor ser precavido. Queremos entrar y ver que todo realmente ha funcionado como se supone. Ese es un nivel de desconfianza adulta: es mejor verificar y comprobar.
Por ejemplo, entramos y miramos por la mañana, ¿verdad?
No por la mañana, normalmente nos enteramos del failover prácticamente de inmediato. Recibimos notificaciones y vemos que ha ocurrido un failover. Casi de inmediato entramos y revisamos. Pero todas esas comprobaciones deben entrar en el nivel de monitoreo. Si consultamos a Patroni a través de la API REST, hay un historial. A través del historial se pueden ver las marcas de tiempo cuando ocurrió el failover. Con base en eso se puede hacer un monitoreo. Se puede ver el historial, cuántos eventos han ocurrido. Si tenemos más eventos, significa que ocurrió un failover automático. Podemos verificar y ver. O nuestra automatización en el monitoreo comprobó que todas nuestras réplicas están en su lugar, no hay retraso y todo está bien.
¡Gracias!
¡Muchas gracias por la excelente charla! Si llevamos el clúster DCS a algún lugar alejado del clúster de Postgres, ¿también hay que mantener este clúster periódicamente? ¿Cuáles son las mejores prácticas para apagar algunas partes del clúster DCS, hacer algo con ellas, etc.? ¿Cómo vive toda esta estructura durante esto? ¿Y cómo se deben hacer estas cosas?
Para una empresa, fue necesario hacer una matriz de problemas, que detalla qué sucede si alguno o varios componentes fallan. Con esta matriz, revisamos todos los componentes en secuencia y construimos escenarios en caso de que esos componentes fallen. Por lo tanto, para cada escenario de falla, se puede tener un plan de acción para la recuperación. Y en el caso de DCS, esto se considera parte de la infraestructura estándar. Así que el administrador se encarga de ello y ya confiamos en los administradores que lo manejan y en su capacidad para repararlo en caso de fallos. Si no hay DCS, lo desplegamos nosotros, pero no lo monitoreamos específicamente porque no somos responsables de la infraestructura, aunque damos recomendaciones sobre qué y cómo monitorear.
Es decir, ¿he entendido correctamente que hay que desactivar Patroni, desactivar el failover, desactivar todo antes de hacer algo con los hosts?
Esto depende de cuántos nodos tengamos en el clúster DCS. Si hay muchos nodos y si solo estamos fallando uno de los nodos (réplica), el clúster mantiene su quórum. Y Patroni sigue operativo. No se dispara nada. Si tenemos operaciones complejas que afectan a más nodos, cuya ausencia puede romper el quórum, entonces, sí, tal vez tenga sentido pausar Patroni. Hay un comando correspondiente: patronictl pause, patronictl resume. Simplemente hacemos una pausa, y el autofailover no se activa en ese momento. Realizamos mantenimiento en el clúster DCS, luego levantamos la pausa y continuamos operando.
¡Muchas gracias!
¡Muchas gracias por la presentación! ¿Qué opina el equipo de producto sobre la posible pérdida de datos?
Al equipo de producto no le importa, pero los líderes de equipo están preocupados.
¿Qué garantías existen?
Es muy difícil dar garantías. Hay una presentación de Alexander Kukushkin sobre 'Cómo calcular RPO y RTO', es decir, el tiempo de recuperación y cuántos datos podemos perder. Creo que necesitamos encontrar esas diapositivas y estudiarlas. Por lo que recuerdo, hay pasos concretos sobre cómo calcular estas cosas. Cuántas transacciones podemos perder, cuántos datos podemos perder. Como opción, podemos usar replicación síncrona a nivel de Patroni, pero esto es una espada de doble filo: o tenemos fiabilidad de datos o perdemos en velocidad. Existe replicación síncrona, pero tampoco garantiza una protección del 100% contra la pérdida de datos.
Alexey, gracias por la excelente presentación. ¿Tienes experiencia usando Patroni para protección de nivel cero? Es decir, en conjunto con un standby síncrono. Esa es la primera pregunta. Y la segunda pregunta. Has utilizado diferentes soluciones. Nosotros usamos Repmgr, pero sin autofailover y ahora estamos planeando añadir autofailover. Y estamos considerando a Patroni como una solución alternativa. ¿Qué puedes decir a favor de Patroni en comparación con Repmgr?
La primera pregunta fue sobre réplicas síncronas. Nadie usa replicación síncrona porque todos tienen miedo (Ya hay varios clientes que la utilizan, en principio no han notado problemas de rendimiento — Nota del presentador). Pero nosotros hemos establecido una regla de que en un clúster de replicación síncrona debe haber al menos tres nodos, porque si tenemos dos nodos y el maestro o una réplica falla, Patroni convierte ese nodo en modo standalone para que la aplicación continúe funcionando. En este caso, hay riesgos de pérdida de datos.
Respecto a la segunda pregunta, hemos utilizado Repmgr y todavía lo usamos con algunos clientes por razones históricas. ¿Qué se puede decir? En Patroni, el auto failover viene por defecto, mientras que en Repmgr es una función adicional que necesita ser habilitada. Es necesario ejecutar el daemon de Repmgr en cada nodo y entonces podemos configurar el auto failover.
Repmgr verifica si los nodos de Postgres están vivos. Los procesos de Repmgr verifican la existencia entre sí, lo cual no es un enfoque muy eficiente, ya que pueden ocurrir casos complejos de aislamiento de red en los que un gran clúster de Repmgr puede dividirse en varios más pequeños y continuar funcionando. No sigo Repmgr desde hace tiempo, tal vez esto lo hayan solucionado... o tal vez no. Sin embargo, extraer la información sobre el estado del clúster en DCS, como lo hacen Stolon y Patroni, es la opción más viable.
Alexey, tengo una pregunta, quizás algo básica. En uno de los primeros ejemplos sacaste DCS de una máquina local a un nodo remoto. Entendemos que la red es algo que tiene sus particularidades, vive por sí misma. ¿Y qué pasará si por alguna razón el clúster DCS se vuelve inaccesible? No mencionaré las razones, pueden ser muchas: desde manos torpes de los administradores de red hasta problemas reales.
No lo mencioné en voz alta, pero el clúster DCS también debe ser tolerante a fallos, es decir, debe tener un número impar de nodos para que se pueda alcanzar un quórum. ¿Qué ocurre si el clúster DCS se vuelve inaccesible o no se puede reunir el quórum, es decir, si hay un cortocircuito de red o falla en los nodos? En este caso, el clúster Patroni pasa a modo de solo lectura. El clúster Patroni no puede determinar el estado del clúster ni qué hacer. No puede comunicarse con DCS y guardar el nuevo estado del clúster, por lo que todo el clúster pasa a modo de solo lectura. Y espera o intervención manual del operador o la recuperación de DCS.
En términos simples, ¿se convierte DCS en un servicio tan importante para nosotros como la propia base de datos?
Sí, sí. En muchas empresas modernas, el Service Discovery es una parte integral de la infraestructura. Se implementa incluso antes de que exista una base de datos en la infraestructura. En otras palabras, lanzamos la infraestructura, nos desplegamos en el centro de datos y ya tenemos el Service Discovery. Si es Consul, se puede construir sobre él y el DNS. Si es Etcd, podría ser parte de un clúster de Kubernetes, donde ya se desplegará todo lo demás. Me parece que el Service Discovery ya es una parte indispensable de las infraestructuras modernas. Y se considera mucho antes que las bases de datos.
¡Gracias!
Fuente: habr.com
