

¡Hola, Habr!
Te recordamos que hemos lanzado otro libro extremadamente interesante y útil Patronesestá en pleno auge Kubernetes ha cambiado fundamentalmente los patrones tradicionales de desarrollo y despliegue de aplicaciones. Ahora, un equipo puede tardar solo unos días en desarrollar, probar y desplegar una aplicación en diferentes entornos, todo dentro de clústeres de Kubernetes. Este trabajo con tecnologías de generaciones anteriores solía llevar semanas, si no meses.
Esta aceleración ha sido posible gracias a la abstracción que proporciona Kubernetes, es decir, gracias a que Kubernetes maneja las interacciones con los detalles de bajo nivel de máquinas físicas o virtuales, permitiendo a los usuarios declarar entre otros parámetros el procesador necesario, la cantidad de memoria requerida y el número de instancias de contenedores. Dado que una enorme comunidad está involucrada en el soporte de Kubernetes y su uso sigue expandiéndose, se sitúa con gran ventaja como la plataforma líder en orquestación de contenedores.
A medida que aumenta el uso de Kubernetes, también crece la confusión sobre los patrones de almacenamiento de datos que se aplican en él.
Con la competencia general por una porción del mercado de Kubernetes (es decir, por almacenamiento de datos), cuando se habla de almacenamiento, la señal se pierde en un fuerte ruido..
Kubernetes encarna un modelo moderno de desarrollo, despliegue y gestión de aplicaciones. Este modelo moderno desacopla el almacenamiento de datos de los cálculos. Para entender completamente este desacoplamiento en el contexto de Kubernetes, también es necesario comprender qué son las aplicaciones con y sin estado, y cómo se relaciona esto con el almacenamiento de datos. Aquí es donde el enfoque API REST utilizado por S3 tiene ventajas claras sobre el enfoque POSIX/CSI característico de otras soluciones.
Kubernetes encarna un modelo moderno de desarrollo y despliegue de aplicaciones, así como de su gestión. Este modelo moderno desacopla el almacenamiento de datos de la computación. Para comprender completamente este desacoplamiento en el contexto de Kubernetes, también es necesario entender qué son las aplicaciones con y sin estado, así como cómo se combina esto con el almacenamiento de datos. Aquí es donde el enfoque de REST API utilizado por S3 tiene claras ventajas en comparación con el enfoque POSIX/CSI, típico de otras soluciones.
En este artículo hablaremos sobre los patrones de almacenamiento de datos en Kubernetes y abordaremos por separado la discusión sobre las aplicaciones sin estado y con estado, para entender completamente cuál es la diferencia entre ellas y por qué es importante. A continuación, se examinarán las aplicaciones y los patrones de almacenamiento de datos utilizados en ellas a la luz de las mejores prácticas para trabajar con contenedores y Kubernetes.
Contenedores sin estado
Los contenedores son por naturaleza livianos y efímeros. Se pueden detener, eliminar o desplegar en otro nodo sin dificultad; todo esto lleva solo unos segundos. En un gran sistema de orquestación de contenedores, estas operaciones suceden constantemente, y los usuarios ni siquiera notan esos cambios. Sin embargo, los movimientos son posibles solo si el contenedor no tiene ninguna dependencia del nodo en el que se encuentra. A estos contenedores se les dice que funcionan sin estado.
Contenedores con estado
Si un contenedor almacena datos en dispositivos conectados localmente (o en un dispositivo de bloques), entonces el almacenamiento de datos en el que se encuentra tendrá que ser trasladado a un nuevo nodo junto con el propio contenedor en caso de fallo. Esto es importante, ya que de lo contrario, la aplicación que se ejecuta en el contenedor no podrá funcionar correctamente, ya que necesita acceder a los datos almacenados en los dispositivos locales. A estos contenedores se les dice que funcionan con estado.
Desde un punto de vista puramente técnico, los contenedores con estado también pueden trasladarse a otros nodos. Esto generalmente se logra mediante sistemas de archivos distribuidos o almacenes de datos en red de bloques conectados a todos los nodos donde funcionan los contenedores. De este modo, los contenedores acceden a volúmenes para el almacenamiento persistente de datos, y la información se almacena en discos distribuidos por toda la red. Llamaré a este método elenfoque de contenedor con estado, y en el resto del artículo lo llamaré así por uniformidad.
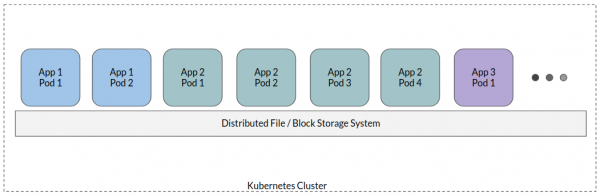
En un enfoque típico de contenedor con estado, todos los pods de aplicaciones se adjuntan a un sistema de archivos distribuido, formando una especie de almacenamiento compartido donde residen todos los datos de las aplicaciones. Aunque pueden existir algunas variaciones, este es un enfoque de alto nivel.
Ahora, examinemos por qué el enfoque de contenedor con estado en un mundo orientado a la nube es un antipatrón.
Diseño de aplicaciones orientado a la nube
Tradicionalmente, las aplicaciones utilizaban bases de datos para el almacenamiento estructurado de información y discos locales o sistemas de archivos distribuidos donde se almacenaban todos los datos no estructurados o incluso semi-estructurados. A medida que aumentaba el volumen de datos no estructurados, los desarrolladores se dieron cuenta de que POSIX era demasiado "charlatán", asociado con costos significativos y, en última instancia, perjudicaba el rendimiento de la aplicación al escalar realmente a gran escala.
Esto, en gran medida, contribuyó a la aparición de un nuevo estándar de almacenamiento de datos, es decir, los almacenes orientados a la nube que operan principalmente sobre la base de REST API y liberan a la aplicación del oneroso mantenimiento de un almacenamiento de datos local. En este caso, la aplicación efectivamente opera en modo sin estado (ya que el estado se almacena en un almacenamiento remoto). Las aplicaciones modernas se construyen desde cero teniendo en cuenta este factor. Por lo general, cualquier aplicación moderna que maneje algún tipo de datos (registros, metadatos, blobs, etc.) se construye bajo la paradigma orientada a la nube, donde el estado se transfiere a un sistema de software específicamente designado para su almacenamiento.
El enfoque de contenedor con estado obliga a toda esta paradigma a retroceder exactamente a donde comenzó.
Al utilizar interfaces POSIX para el almacenamiento de datos, las aplicaciones funcionan de la misma manera que si estuvieran guardando estado, y por ello se desvían de los postulados más importantes del diseño orientado a la nube, es decir, de la capacidad de variar los tamaños de los flujos de trabajo de la aplicación según la carga entrante, de trasladarse a un nuevo nodo tan pronto como el nodo actual falle, etc.
Al observar esta situación más de cerca, descubrimos que al elegir un almacenamiento de datos nos encontramos una y otra vez con el dilema "POSIX vs REST API", PERO con un agravamiento adicional de los problemas de POSIX debido a la naturaleza distribuida de los entornos de Kubernetes. En particular,
- POSIX es verboso: la semántica de POSIX requiere asociar metadatos y descriptores de archivos con cada operación, lo que ayuda a mantener el estado de la operación. Esto conduce a costos significativos que no tienen un valor real. Las API para el almacenamiento de objetos, en particular la API de S3, han eliminado estos requisitos, permitiendo que la aplicación funcione y luego "olvide" la llamada. La respuesta del sistema de almacenamiento indica si la acción se llevó a cabo con éxito o no. En caso de falla, la aplicación puede intentar de nuevo.
- Limitaciones de red: En un sistema distribuido se da por hecho que puede haber múltiples aplicaciones intentando escribir datos en un mismo medio adjunto. Por lo tanto, no solo las aplicaciones competirán entre sí por el ancho de banda (para enviar datos al medio), sino que el propio sistema de almacenamiento competirá por este ancho de banda, distribuyendo datos a través de discos físicos. Debido a la verbosidad de POSIX, el número de llamadas de red aumenta varias veces. Por otro lado, la API de S3 proporciona una clara distinción entre las llamadas de red que van del cliente al servidor y las que ocurren dentro del servidor.
- Seguridad: El modelo de seguridad POSIX está diseñado para la participación activa del ser humano: los administradores configuran niveles de acceso específicos para cada usuario o grupo. Esta paradigma es difícil de adaptar al mundo orientado a la nube. Las aplicaciones modernas dependen de modelos de seguridad ligados a API, donde los derechos de acceso se determinan como un conjunto de políticas, se asignan cuentas de servicio, credenciales temporales, etc.
- Gestionabilidad: Los contenedores con estado conllevan ciertos costos relacionados con la gestión. Se refiere a la sincronización del acceso paralelo a los datos, a garantizar la coherencia de los datos, todo esto requiere evaluar cuidadosamente qué patrones de acceso a los datos utilizar. Es necesario instalar, controlar y configurar programas adicionales, sin mencionar los esfuerzos adicionales invertidos en el desarrollo.
Interfaz de almacenamiento de contenedores de datos
Si bien la interfaz de almacenamiento de contenedores (CSI) ha ayudado enormemente con la distribución del nivel de volúmenes de Kubernetes, transfiriendo parcialmente este nivel a proveedores externos de almacenamiento, también ha contribuido accidentalmente a la creencia de que el enfoque de contenedores con estado es el método recomendado para el almacenamiento de datos en Kubernetes.
CSI fue diseñado como un estándar para proporcionar sistemas de almacenamiento de bloques y archivos arbitrarios a aplicaciones heredadas al trabajar con Kubernetes. Y, como se demostró en este artículo, la única situación en la que el enfoque de contenedores con estado (y CSI en su forma actual) es razonable es cuando la propia aplicación es un sistema heredado en el que no es posible agregar soporte para la API de almacenamiento de objetos.
Es importante entender que, al utilizar CSI en su forma actual, es decir, montando volúmenes al trabajar con aplicaciones modernas, nos enfrentaremos a problemas similares a los que surgieron en los sistemas donde el almacenamiento de datos estaba organizado al estilo POSIX.
Enfoque de mayor calidad
En este caso, es importante entender que la mayoría de las aplicaciones no están diseñadas esencialmente para funcionar con o sin estado. Este comportamiento depende de la arquitectura general del sistema y de las específicas elecciones realizadas durante el diseño. Hablemos un poco sobre las aplicaciones que mantienen estado.
En principio, todos los datos de las aplicaciones se pueden clasificar en varios tipos amplios:
- Datos de registros
- Datos de marcas de tiempo
- Datos de transacciones
- Metadatos
- Imágenes de contenedores
- Datos de blobs (objetos binarios grandes)
Todos estos tipos de datos son muy bien soportados en las plataformas modernas de almacenamiento de datos, y existen varias plataformas orientadas a la nube diseñadas para proporcionar datos en cada uno de estos formatos específicos. Por ejemplo, los datos de transacciones y metadatos pueden estar en una base de datos moderna orientada a la nube, como CockroachDB, YugaByte, etc. Las imágenes de contenedores o los datos de blobs pueden almacenarse en un registro de docker basado en MinIO. Los datos de marcas de tiempo pueden almacenarse en una base de datos de series temporales, como InfluxDB, etc. No entraremos aquí en los detalles de cada tipo de dato y sus respectivas aplicaciones, pero la idea general es evitar el almacenamiento persistente de datos basado en el montaje local de discos.
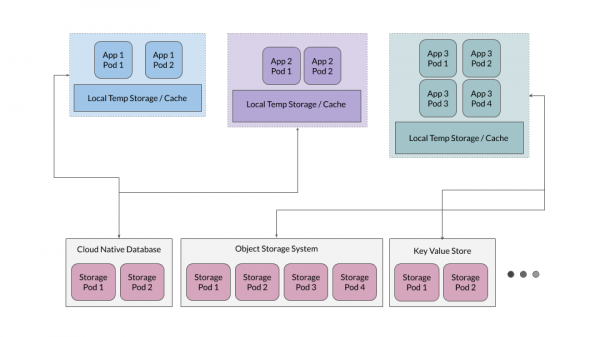
Además, a menudo resulta efectivo proporcionar un nivel de caché temporal que sirva a las aplicaciones como un almacenamiento de archivos temporales, pero las aplicaciones no deben depender de este nivel como fuente de verdad.
Almacenamiento para aplicaciones con estado
Mientras que en la mayoría de los casos es útil mantener las aplicaciones sin estado, aquellas aplicaciones que están diseñadas para almacenar datos, como bases de datos, almacenamiento de objetos, y almacenes de clave-valor, deben mantener estado. Vamos a ver por qué estas aplicaciones se implementan en Kubernetes. Tomemos como ejemplo MinIO, pero principios similares se aplican a cualquier otro sistema de almacenamiento en la nube a gran escala.
Las aplicaciones orientadas a la nube están diseñadas para aprovechar al máximo la flexibilidad inherente a los contenedores. Esto significa que no se hacen suposiciones sobre el entorno en el que se desplegarán. Por ejemplo, MinIO utiliza un mecanismo interno de codificación redundante (erasure coding) que proporciona a la sistema una resistencia suficiente para seguir operando incluso si fallan la mitad de los discos. Además, MinIO gestiona la integridad y la seguridad de los datos utilizando su propia hash y encriptación en el lado del servidor.
Para este tipo de aplicaciones orientadas a la nube, los volúmenes persistentes locales (PV) son la opción más conveniente como almacenamiento de respaldo. Un PV local ofrece la capacidad de almacenar datos sin procesar, mientras que las aplicaciones que operan sobre estos PV recopilan información que permite escalar los datos y gestionar las crecientes demandas sobre ellos.
Este enfoque es mucho más simple y escala significativamente mejor en comparación con los PV basados en CSI, que introducen sus propios niveles de gestión de datos y redundancia en el sistema; la cuestión es que estos niveles suelen entrar en conflicto con aplicaciones diseñadas para operar sin estado.
Un movimiento seguro hacia la separación de datos y cálculos
En este artículo hemos discutido cómo las aplicaciones se están reorientando para operar sin estado, o dicho de otro modo, el almacenamiento de datos se separa de los cálculos realizados sobre ellos. Para concluir, veamos algunos ejemplos reales de esta tendencia.
, una famosa plataforma para el análisis de datos, tradicionalmente se utilizaba con estado y desplegada en el sistema de archivos HDFS. Sin embargo, a medida que Spark se traslada al mundo orientado a la nube, esta plataforma se está utilizando cada vez más sin estado utilizando `s3a`. Spark utiliza s3a para transferir el estado a otros sistemas, mientras que los contenedores de Spark funcionan completamente sin estado. Otros grandes actores empresariales en el ámbito de análisis de grandes datos, en particular, , , también están adoptando la separación de almacenamiento de datos y cálculos sobre ellos.
Patrones similares también se observan en otras grandes plataformas analíticas, como Presto, Tensorflow to R y Jupyter. Al exportar el estado a sistemas de almacenamiento en la nube, es mucho más fácil gestionar su aplicación y escalarla. Además, esto facilita la portabilidad de la aplicación en diversos entornos.
Fuente: habr.com
