

Aparentemente, los desarrolladores de Terraform ofrecen prácticas recomendadas bastante convenientes para trabajar con la infraestructura de AWS. Sin embargo, hay una salvedad. Con el tiempo, el número de entornos aumenta, y en cada uno aparecen particularidades. Surge casi una copia de la pila de aplicaciones en la región vecina. Y el código de Terraform debe ser cuidadosamente copiado y editado según los nuevos requisitos o hacer una 'nieve'.
Mi charla trata sobre patrones en Terraform para combatir el caos y la rutina manual en proyectos grandes y prolongados.
Video:
Tengo 40 años, llevo 20 en TI. He trabajado durante 12 años en la empresa Ixtens. Nos dedicamos al desarrollo impulsado por el comercio electrónico. Y llevo 5 años practicando técnicas de DevOps.
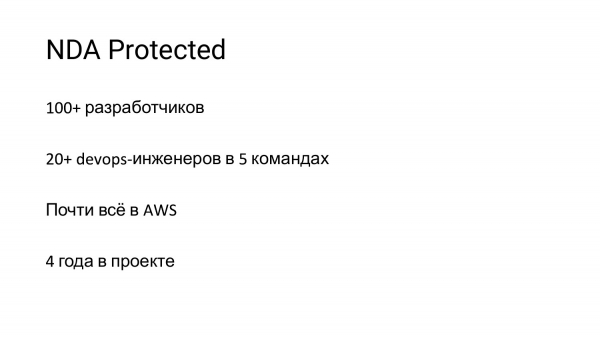
Mi historia será sobre una experiencia en un proyecto de una empresa cuyo nombre no puedo revelar, amparándome en un acuerdo de confidencialidad.
Los números en la diapositiva están indicados para entender la magnitud del proyecto. Y todo lo que voy a decir a continuación está relacionado con Amazon.
Me uní a este proyecto hace 4 años. Y en plena fase se estaba refactorizando la infraestructura, porque el proyecto había crecido. Y los patrones que se utilizaban ya no eran adecuados. Y considerando todo el crecimiento planeado del proyecto, era necesario idear algo nuevo.
Gracias a Matvey, quien ayer contó lo que les sucedió en Dodo Pizza. Eso es lo que nos ocurrió hace 4 años.
Los desarrolladores llegaron y comenzaron a crear código para la infraestructura.
Los motivos más evidentes por los que esto era necesario incluían la reducción del tiempo de lanzamiento al mercado. Era necesario asegurarse de que el equipo de DevOps no fuera un cuello de botella en el lanzamiento. Y, además de todo, en el nivel más básico se utilizaban Terraform y Puppet.
Terraform es un proyecto de código abierto de HashiCorp. Y para aquellos que no están familiarizados con eso, las siguientes diapositivas.
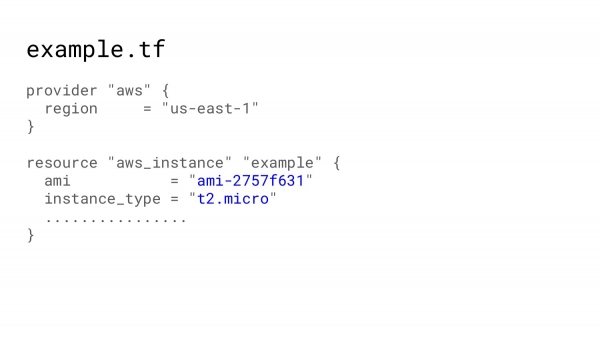
La infraestructura como código significa que podemos describir nuestra infraestructura y solicitar a ciertos robots que hagan que obtengamos los recursos que hemos descrito.
Por ejemplo, necesitamos máquina virtual. Describiremos, añadiremos algunos parámetros obligatorios.
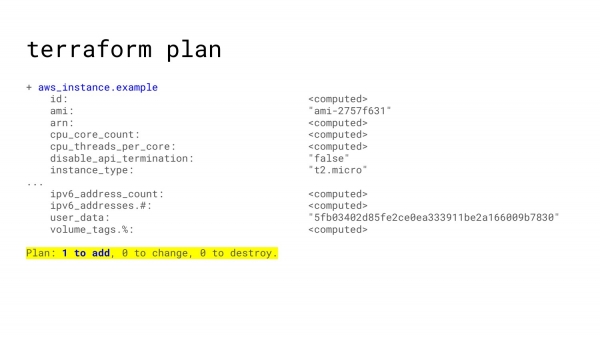
Después de eso, configuraremos el acceso a Amazon en la consola. Y pediremos a Terraform que planifique. Terraform planificará y dirá: 'Está bien, para su recurso podemos hacer las siguientes cosas'. Y, como mínimo, se añadirá un recurso. Y no se esperan cambios.
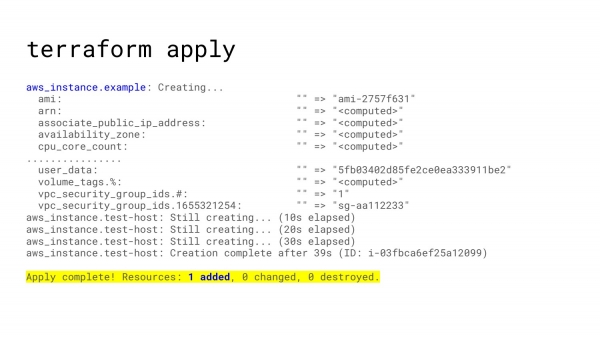
Una vez que estés satisfecho, puedes pedir a Terraform que aplique y Terraform te creará una instancia, y recibirás una máquina virtual en tu nube.
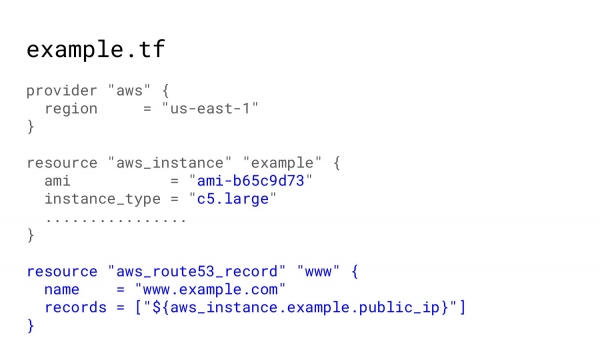
A continuación, nuestro proyecto avanza. Estamos añadiendo algunas modificaciones. Estamos solicitando más instancias, estamos agregando 53 entradas.
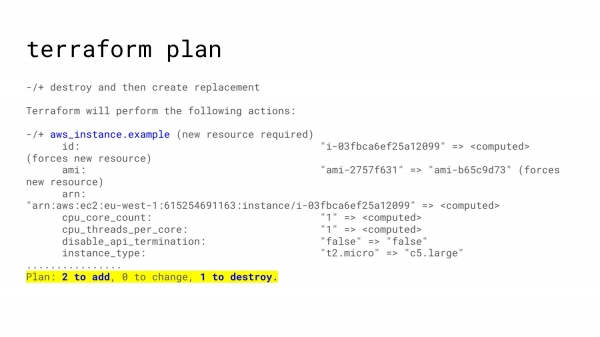
Y repetimos. Solicitamos el plan. Vemos qué cambios se están planificando. Los aplicamos. Y de esta manera, nuestra infraestructura crece.
Terraform utiliza algo llamado archivos de estado. Es decir, todos los cambios que se envían a Amazon los guarda en un archivo, donde para cada recurso que describiste, hay recursos correspondientes que se crearon en Amazon. Por lo tanto, al cambiar la descripción de algún recurso, Terraform sabe exactamente qué debe ser cambiado en Amazon.
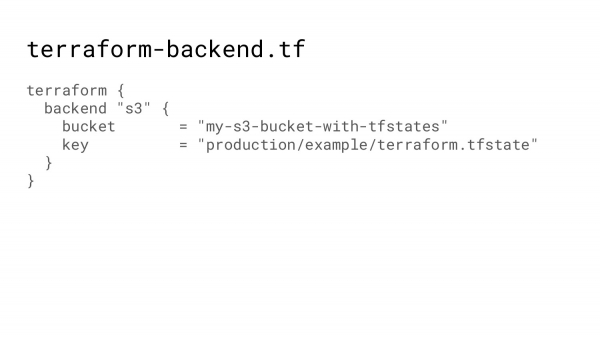
Estos archivos de estado originalmente eran simples archivos. Y los almacenábamos en Git, lo cual era muy incómodo. Constantemente alguien olvidaba hacer commit de los cambios, y surgían muchos conflictos.
Ahora hay la posibilidad de utilizar un backend, es decir, se le indica a Terraform en qué bucket y con qué clave debe guardar el archivo de estado. Y Terraform se encargará de obtener este archivo de estado, realizar toda la magia y devolver el resultado final.
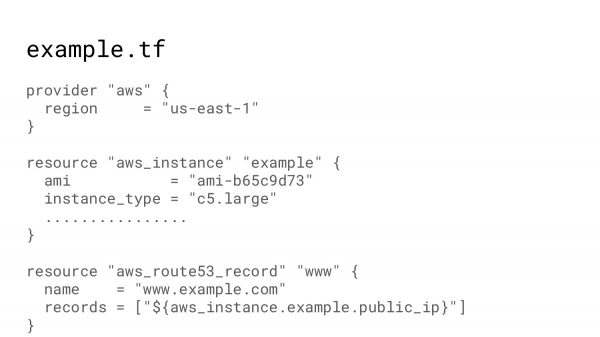
Nuestra infraestructura está creciendo. Aquí está nuestro código. Y ahora no queremos simplemente crear una máquina virtual, queremos tener un entorno de pruebas.
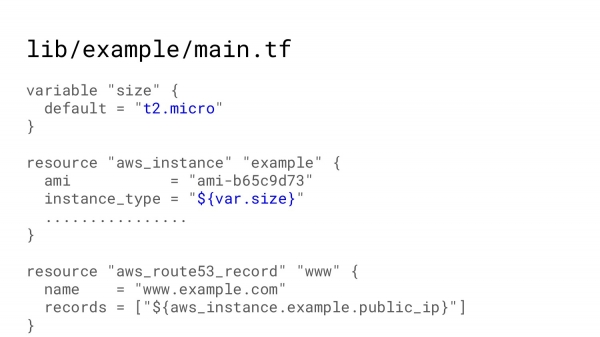
Terraform permite crear algo llamado módulo, es decir, describir lo mismo en alguna carpeta.
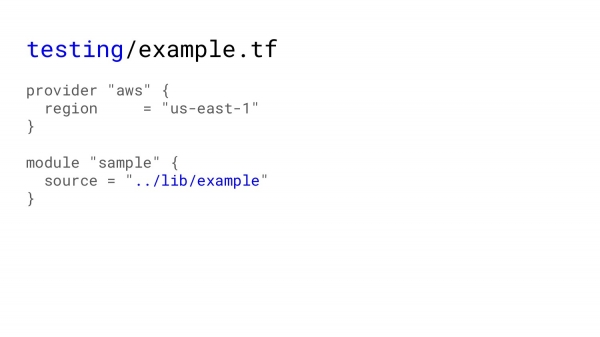
Y, por ejemplo, en las pruebas invocar este módulo y obtener lo mismo como si estuviéramos ejecutando Terraform apply en el mismo módulo. Para las pruebas, este será el código.
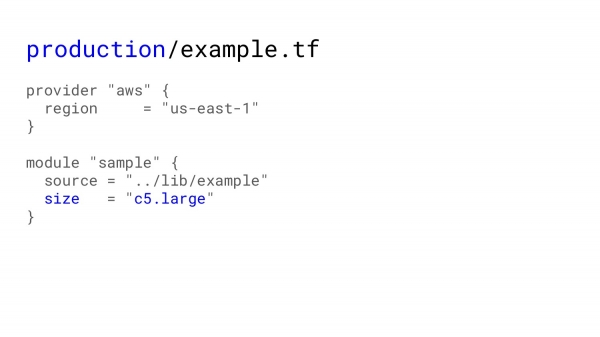
Para producción, podemos enviar algunos cambios allí, porque en las pruebas no necesitamos instancias grandes, mientras que en producción las instancias grandes son realmente útiles.
Y después volveré al proyecto. Había una tarea complicada, la infraestructura estaba planeada para ser muy grande. Y había que distribuir todo el código de tal manera que fuera cómodo para todos: tanto para aquellos que mantienen este código, como para aquellos que realizan cambios. Se planeaba que cualquier desarrollador pudiera ir y ajustar la infraestructura según lo necesario para su parte de la plataforma.
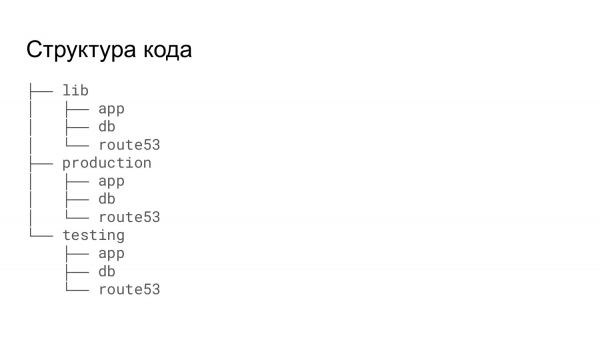
Este es el árbol de directorios que recomienda HashiCorp si tienes un gran proyecto y tiene sentido dividir toda la infraestructura en pequeños trozos, y describir cada trozo en una carpeta separada.
Teniendo una amplia biblioteca de recursos, se puede invocar prácticamente lo mismo en pruebas y en producción.
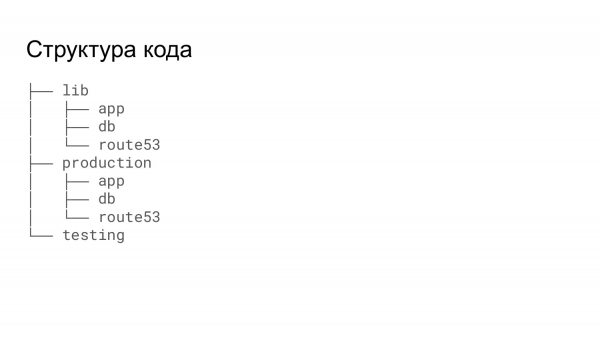
En nuestro caso, esto no era del todo adecuado, porque necesitábamos obtener la pila de pruebas para desarrolladores o para pruebas de una manera más sencilla. No queríamos ir de carpeta en carpeta, aplicando en el orden correcto y preocupándonos de que la base de datos se levantara y luego se levantara una instancia que usara esa base de datos. Así que todo el testing se lanzaba desde una sola carpeta. Allí se invocaban los mismos módulos, pero todo se realizaba en una sola ejecución.
Terraform se encarga de todas las dependencias. Y siempre crea recursos en el orden adecuado, de modo que se pueda obtener una dirección IP, por ejemplo, de una instancia recién creada, y obtener esa dirección IP en una entrada de route53.
Además, la plataforma es muy grande. Y lanzar la pila de pruebas, incluso si es por una hora, aun si es por 8 horas, resulta ser un proceso bastante costoso.
Y automatizamos este proceso. El trabajo de Jenkins permitía lanzar la pila. En él, era necesario lanzar una solicitud de extracción con los cambios que el desarrollador quería probar, especificar todas las opciones, componentes y tamaños necesarios. Si quiere realizar pruebas de rendimiento, puede utilizar más instancias. Si solo necesita verificar que se abre un formulario, puede iniciarlo en configuraciones mínimas. También se puede indicar si se necesita un clúster o no, etc.
Y luego Jenkins trasladaba un script shell que modificaba un poco el código en la carpeta de Terraform. Eliminaba archivos innecesarios y añadía los archivos necesarios. Después, con una sola ejecución de Terraform apply, se levantaba la pila.
Y luego venían otros pasos, en los que no quiero profundizar.
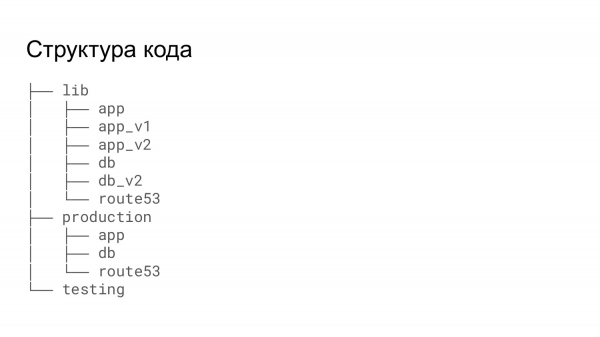
Debido a que para las pruebas necesitábamos un poco más de opciones que en producción, teníamos que hacer copias de los módulos, para que en esas copias se pudieran añadir las funciones que solo eran necesarias para el testing.
Y así sucedió que, en las pruebas, parecía que se quería probar los cambios que finalmente irían a producción. Pero en realidad se probaba una cosa, mientras que en producción se aplicaba un poco diferente. Y había una pequeña discrepancia, ya que en producción todos los cambios eran aplicados por el equipo de operaciones. A veces sucedía que los cambios que debían pasar de las pruebas a producción se quedaban en otra versión.
Además, hubo un problema en el que se añadía un nuevo servicio que era un poco diferente de uno que ya existía. Y en lugar de modificar el módulo existente, había que hacer una copia y agregar los cambios necesarios.
En esencia, Terraform no es un verdadero lenguaje. Es una declaración. Si necesitamos declarar algo, lo declaramos. Y todo esto funciona.
En algún momento, mientras discutíamos uno de mis pull requests, un colega mencionó que no debíamos producir copos de nieve. Me interesé en lo que quería decir. Hay un hecho científico que dice que no existen dos copos de nieve iguales en el mundo, todos son un poco diferentes. Y tan pronto como escuché esto, sentí todo el peso del código de Terraform. Porque cuando se requería pasar de una versión a otra, Terraform exigía cambios de ruptura de cadena, es decir, el código ya no era compatible con la siguiente versión. Y había que hacer un pull request que cubría casi la mitad de los archivos en la infraestructura para llevar la infraestructura a la siguiente versión de Terraform.
Y después de que apareció ese copo de nieve, todo el código de Terraform que teníamos se convertía en una gran montaña de nieve.
Para un desarrollador externo, que está fuera de la operación, esto no tiene mucha importancia, porque hizo un pull request, su recurso se inició. Y eso es todo, no es su preocupación después de eso. Pero para el equipo de DevOps, que se encarga de que todo esté bien, se requieren hacer todos esos cambios. Y el costo de esos cambios aumentaba enormemente con cada copo de nieve adicional.
Hay una historia sobre cómo un estudiante en un seminario dibuja con tiza en la pizarra dos círculos perfectos. Y el profesor se sorprende de cómo pudo dibujarlos tan perfectamente sin compás. El estudiante responde: "Es muy simple, estuve dos años en el ejército girando una picadora de carne."
Y de esos cuatro años en los que he participado en este proyecto, he estado trabajando con Terraform durante unos dos años. Y, por supuesto, tengo algunos trucos, algunos consejos sobre cómo simplificar el código de Terraform, tratarlo como un lenguaje de programación y reducir la carga sobre los desarrolladores que deben mantener ese código actualizado.
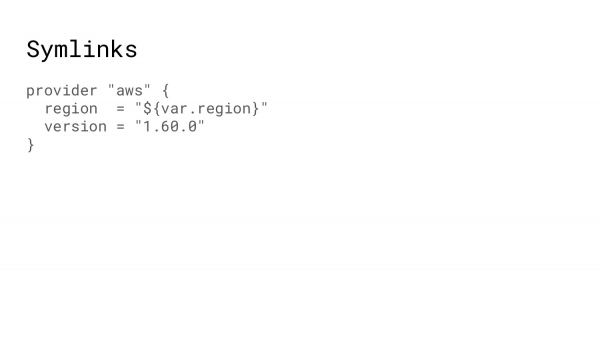
Lo primero de lo que quiero hablar es de los Symlinks. Terraform tiene mucho código repetitivo. Por ejemplo, la llamada al proveedor se repite prácticamente en cada punto donde creamos un trozo de infraestructura, es la misma. Y tiene sentido sacarlo a una carpeta separada. Y en todos los lugares donde se necesita un proveedor, hacer Symlinks a este archivo.
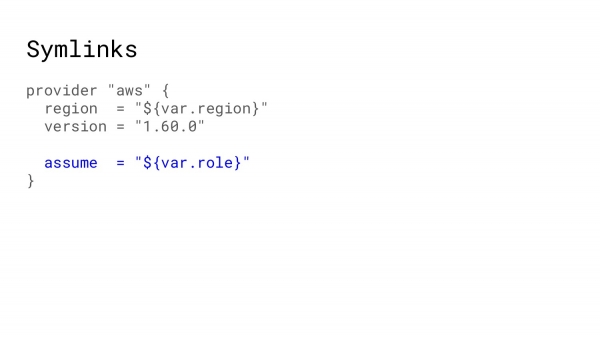
Por ejemplo, en producción utilizas assume role, que te permite obtener permisos para alguna cuenta de Amazon externa. Y al cambiar un archivo, todos los demás que estén en el árbol de recursos tendrán los permisos requeridos para que Terraform sepa a qué segmento de Amazon dirigirse.
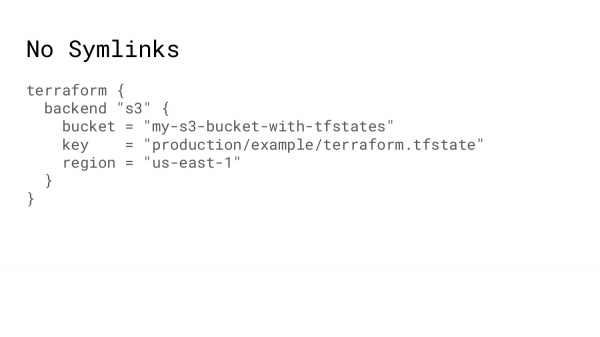
¿Dónde no funcionan los Symlinks? Como mencioné, Terraform tiene archivos de estado. Y son realmente geniales. Pero el asunto es que Terraform inicializa el backend en primer lugar. Y no puede usar en esos parámetros ninguna variable, siempre hay que escribirlas como texto.
Y como resultado, cuando alguien hace un nuevo recurso, copia parte del código de otras carpetas. Y puede equivocarse con la clave o el bucket. Por ejemplo, crea un recurso en sandbox y luego lo hace en producción. Y así puede ocurrir que el bucket en producción se utilice desde sandbox. Claro, esto se encontrará rápidamente. Se puede corregir de alguna manera, pero aun así es una pérdida de tiempo y, hasta cierto punto, de recursos.
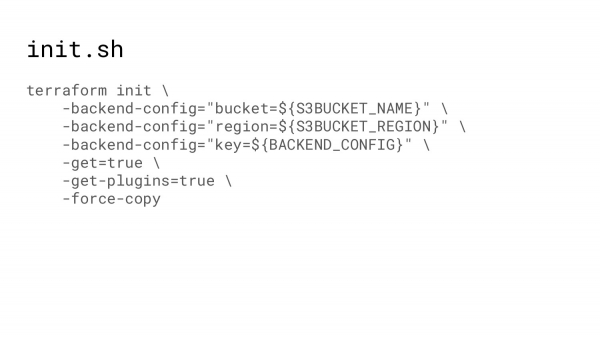
¿Qué podemos hacer a continuación? Antes de trabajar con Terraform, debe ser inicializado. En el momento de la inicialización, Terraform descarga todos los plugins. En algún momento se dividió de un monolito a una arquitectura más microservicios. Y siempre hay que hacer Terraform init, para que cargue todos los módulos, todos los plugins.
Y se puede usar un script de shell que, en primer lugar, pueda obtener todas las variables. Un script de shell no tiene restricciones. Y, en segundo lugar, las rutas. Si siempre utilizamos la ruta en el repositorio como clave para el archivo de estado, entonces, en consecuencia, se excluirán errores aquí.
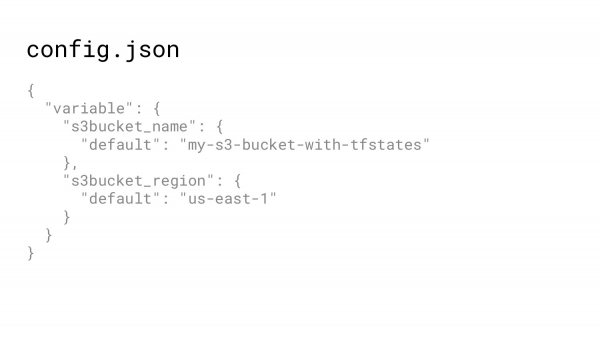
¿De dónde obtener los datos? Un archivo JSON. Terraform permite escribir infraestructura no solo en hcl (HashiCorp Configuration Language), sino también en JSON.
JSON se puede leer fácilmente desde un script de shell. Por lo tanto, se puede colocar un archivo de configuración con el bucket en alguna parte. Y usar este bucket tanto en el código de Terraform como en el script de shell para la inicialización.
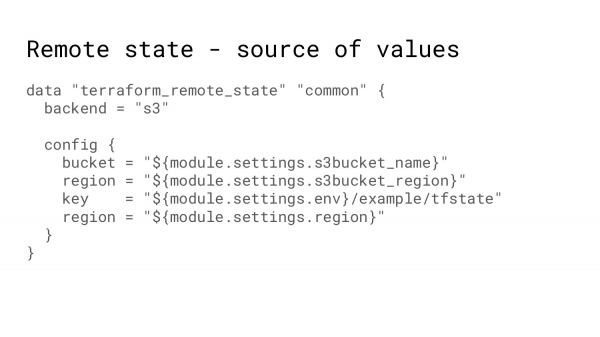
¿Por qué es importante tener un bucket para Terraform? Porque existe algo llamado archivos de estado remoto. Es decir, cuando levanto un recurso, para decirle a Amazon: «Por favor, levanta una instancia», necesito especificar una gran cantidad de parámetros obligatorios.
Y estos identificadores se almacenan en otra carpeta. Y puedo decir: «Terraform, por favor, ve al archivo de estado de ese recurso y trámeme esos identificadores». De esta forma, se genera una cierta unificación entre diferentes regiones o entornos.
No siempre es posible utilizar un archivo de estado remoto. Por ejemplo, si has creado un VPC manualmente. Y el código de Terraform que crea el VPC genera un VPC tan diferente que tendrás que ajustar uno para que se ajuste al otro, por lo que puedes usar el siguiente truco.
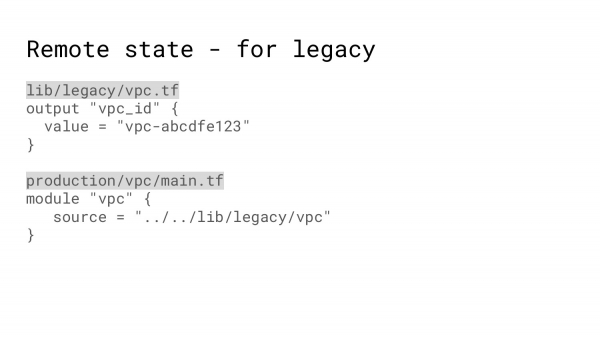
Es decir, crear un módulo que básicamente crea un VPC y te entrega los identificadores, aunque en realidad solo hay un archivo con valores codificados que se puede usar para crear la misma instancia.
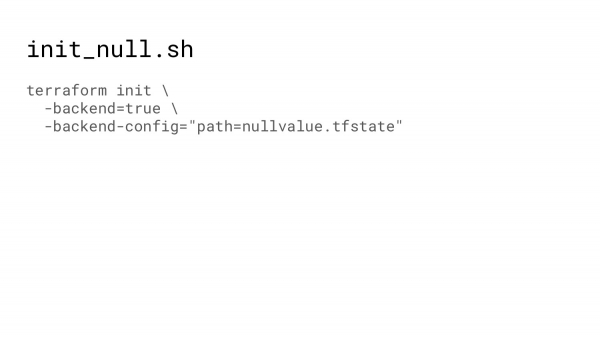
No siempre es necesario guardar el archivo de estado en la nube. Por ejemplo, al probar módulos, se puede utilizar la inicialización del backend, donde el archivo se guardará simplemente en el disco durante la prueba.
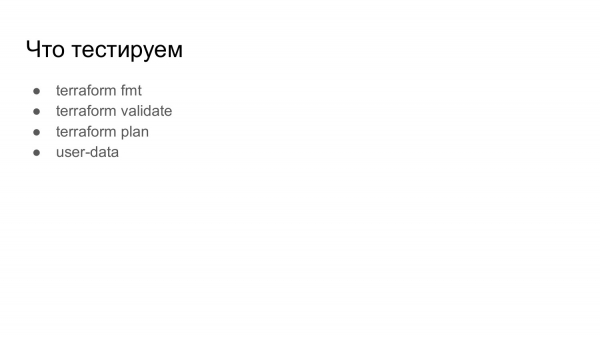
Ahora un poco sobre las pruebas. ¿Qué se puede probar en Terraform? Probablemente se puede probar muchas cosas, pero voy a hablar sobre estas 4.
HashiCorp tiene una visión sobre cómo debe formatearse el código de Terraform. Y Terraform fmt te permite formatear el código que editas de acuerdo con esa visión. Por lo tanto, las pruebas deben verificar si el formateo cumple con lo que ha legado HashiCorp, para evitar tener que cambiar la ubicación de los corchetes, etc.
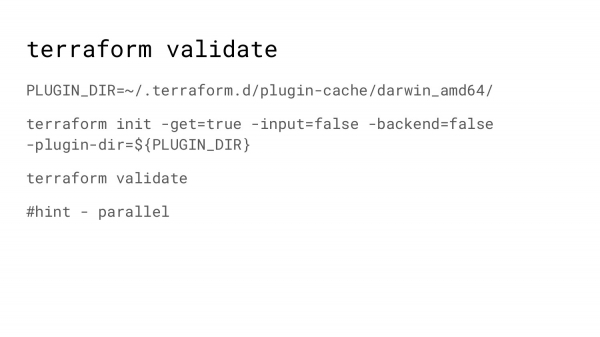
El siguiente es Terraform validate. Hace un poco más que verificar la sintaxis, como, por ejemplo, si todos los corchetes están emparejados. ¿Qué es importante aquí? Nuestra infraestructura es muy ramificada. Tiene muchas carpetas diferentes. Y en cada una de ellas hay que ejecutar Terraform validate.
Por lo tanto, para acelerar las pruebas, ejecutamos varios procesos en paralelo, usando paralelismo.
El paralelismo es una cosa muy buena, úsenlo.
Pero cada vez que se inicializa Terraform, va a HashiCorp y pregunta: "¿Cuáles son las versiones más recientes de los plugins? ¿Y el plugin que tengo en caché, es el correcto o no?". Y eso ralentiza el proceso en cada paso.
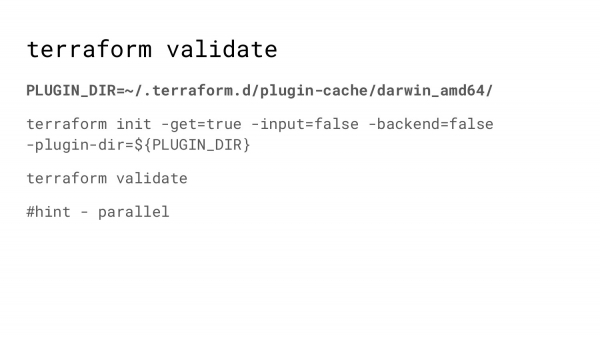
Si se le indica a Terraform dónde están los plugins, entonces Terraform dirá: "Está bien, probablemente esto es lo más reciente. No iré a ningún lado, comenzaré a validar tu código Terraform de inmediato."
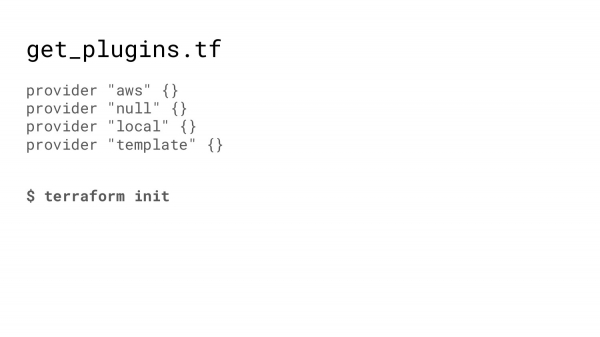
Para llenar la carpeta con los plugins necesarios, tenemos un código Terraform muy simple que solo necesita ser inicializado. Aquí, por supuesto, es necesario especificar todos los proveedores que participan de alguna manera en tu código, de lo contrario Terraform dirá: "No conozco a este proveedor porque no está en caché."
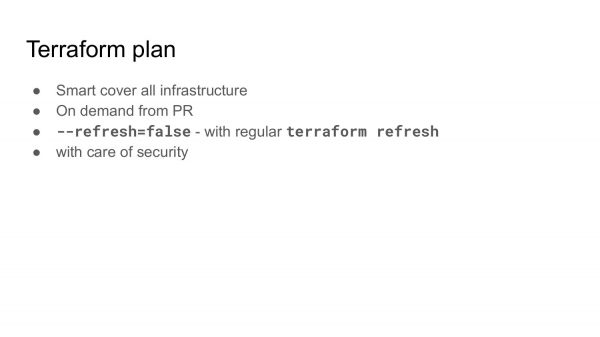
Lo siguiente es el plan de Terraform. Como mencioné, el desarrollo es cíclico. Creamos código con cambios. Y luego necesitamos saber qué cambios se planean en la infraestructura.
Y cuando la infraestructura es muy, muy grande, puede que cambies un módulo, arregles un entorno de prueba o un región específica y rompas algún componente vecino. Por lo tanto, el plan de Terraform debe hacerse para toda la infraestructura y mostrar qué cambios se planean.
Se puede hacer de manera inteligente. Por ejemplo, escribimos un script en Python que resuelve las dependencias. Y dependiendo de lo que se haya modificado: un módulo de Terraform o simplemente algún componente específico, crea planes para todas las carpetas dependientes.
El plan de Terraform debe hacerse bajo demanda. Al menos, eso es lo que hacemos nosotros.
Las pruebas, por supuesto, son buenas para cada cambio, para cada commit, pero los planes son algo bastante costoso. Y en el pull request decimos: "Por favor, dame los planes". Se activa un robot. Y envía en los comentarios o como adjunto todos los planes que se prevén a partir de tus cambios.
El plan es algo bastante costoso. Toma tiempo, porque Terraform va a Amazon y pregunta: "¿Este instancia aún existe? ¿Este autoscale tiene realmente estas configuraciones?". Y para acelerar esto, se puede usar un parámetro como refresh=false. Esto significa que Terraform descargará el estado de S3. Y creerá que el estado coincide exactamente con lo que hay en Amazon.
Este plan de Terraform se ejecuta mucho más rápido, pero el estado debe coincidir con su infraestructura, es decir, en algún lugar y en algún momento, debe ejecutarse Terraform refresh. Terraform refresh hace precisamente eso: asegura que el estado coincida con lo que está en la infraestructura real.
Y hay que hablar de seguridad. Eso era lo que debíamos haber abordado desde el principio. Donde ejecuta Terraform y donde Terraform interactúa con su infraestructura, existe una vulnerabilidad. Es decir, en esencia, está ejecutando código. Y si una solicitud de extracción contiene algún código malicioso, podría ejecutarse en una infraestructura que tiene demasiado acceso. Por lo tanto, tenga cuidado con dónde ejecuta Terraform plan.
Lo siguiente de lo que quisiera hablar es la prueba de user-data.
¿Qué es user-data? En Amazon, cuando creamos una instancia, podemos enviar un mensaje desde la instancia: metadatos. Cuando se inicia la instancia, normalmente cloud init siempre está presente en estas instancias. Cloud init lee este mensaje y dice: "Ok, hoy soy un balanceador de carga". Y de acuerdo con estas instrucciones, realiza alguna acción.
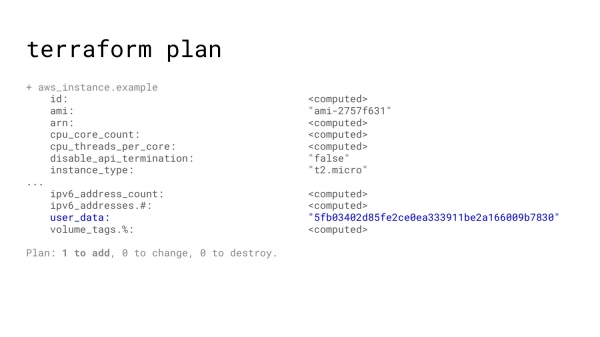
Pero, desafortunadamente, cuando hacemos Terraform plan y Terraform apply, user-data parece un batido de números. Es decir, simplemente le envía un hash. Y todo lo que puede ver en el plan es si habrá algún cambio o si el hash permanecerá igual.
Y si no se presta atención a esto, en Amazon, puede enviarse algún archivo de texto dañado a la infraestructura real.
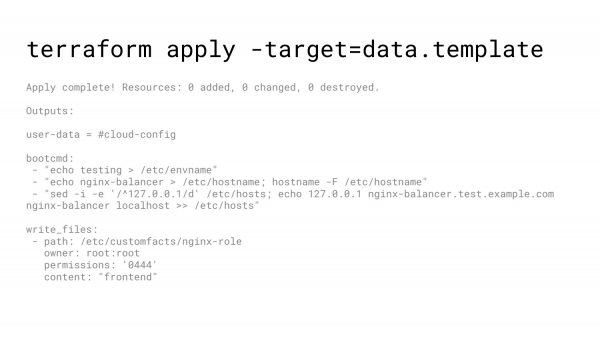
Como opción, al ejecutar, puede especificar no toda la infraestructura, sino solo el template. Y en el código decir: "Por favor, muéstrame este template en la pantalla". Y al final puede obtener una impresión de cómo se verán sus datos en Amazon.
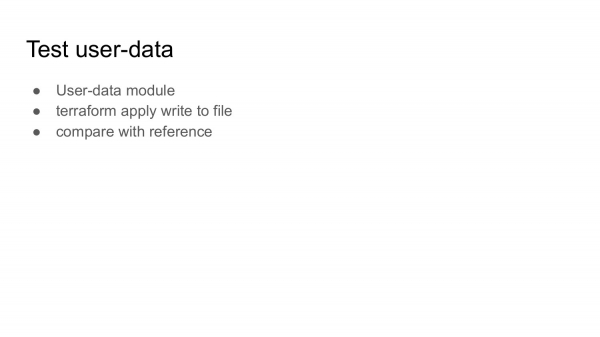
Otra opción es utilizar un módulo para generar user-data. Aplica este módulo. Obtienes un archivo en disco. Lo comparas con el de referencia. Y de esta manera, si un novato decide corregir un poco el user-data, tus pruebas dirán: "Ok, aquí y aquí hay algunos cambios – eso es normal".
Lo siguiente de lo que quisiera hablar es Automatizar Terraform apply.
Por supuesto, es bastante aterrador hacer un Terraform apply en modo automático, porque, ¿quién sabe qué cambios han llegado y cuán destructivos pueden ser para la infraestructura en vivo?
Para un entorno de prueba, esto está totalmente bien. Es decir, la tarea que crea el entorno de prueba es lo que todos los desarrolladores necesitan. Y expresiones como 'me funcionó todo' no son un meme gracioso, sino una prueba de que la persona se lo tomó en serio, levantó la pila, ejecutó algunas pruebas en esta pila y se aseguró de que todo estaba bien y dijo: 'Ok, el código que estoy lanzando ha sido probado'.
En producción, sandbox y otros entornos que son más importantes para el negocio, se pueden aplicar parcialmente algunos recursos de manera suficientemente segura, porque no resulta en que alguien muera. Esto incluye: grupos de escalado automático, grupos de seguridad, roles, route53 y la lista puede ser bastante extensa. Pero mantente atento a lo que ocurre, lee los informes sobre aplicaciones automáticas.
Donde aplicar es peligroso o intimidante, por ejemplo, si se trata de algunos recursos persistentes, de bases de datos, obtén informes sobre cambios no aplicados en alguna parte de la infraestructura. Y el ingeniero, bajo supervisión, ejecuta trabajos para aplicarlos o lo hace desde su consola.
En Amazon hay algo llamado protección contra terminación. Y puede protegerte en algunos casos de cambios no deseados. Es decir, Terraform va a Amazon y dice: 'Necesito eliminar esta instancia para hacer otra'. Y Amazon dice: 'Lo siento, no hoy. Tenemos protección contra terminación activa'.
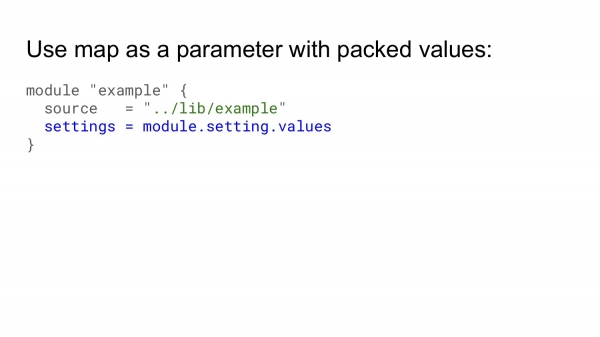
Y la guinda del pastel es la optimización del código. Cuando trabajamos con código de Terraform, debemos pasar una gran cantidad de parámetros al módulo. Son esos parámetros necesarios para crear algún recurso. Y el código se convierte en largas listas de parámetros que deben ser transmitidas de módulo a módulo, especialmente si los módulos están anidados.
Y esto es muy difícil de leer. Es complicado hacer revisiones. Y a menudo sucede que algunos parámetros pasan la revisión y no son exactamente los que se necesitan. Esto cuesta tiempo y dinero para corregir más tarde.
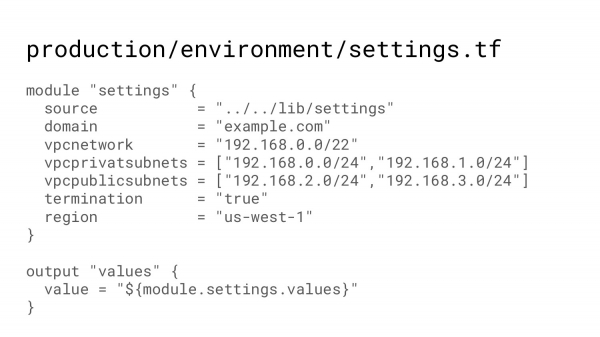
Por eso, te propongo usar algo como un parámetro complejo que incluya un árbol de valores. Es decir, necesitas alguna carpeta donde se indiquen todos los valores que te gustaría tener en algún entorno.
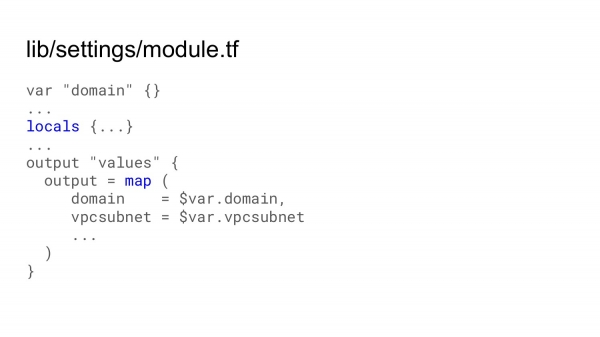
Al invocar este módulo, se puede obtener un árbol que se genera en un único módulo general, es decir, en un módulo común que funciona de la misma manera para toda la infraestructura.
En este módulo se pueden realizar cálculos utilizando una característica nueva de Terraform, llamada locals. Luego, se puede emitir un output que contenga algún parámetro complejo que puede incluir hashes, arreglos, etc.
Aquí es donde terminan mis mejores hallazgos. Y quisiera contar una anécdota sobre Colón. Cuando buscaba dinero para su expedición para encontrar la India (como pensaba), nadie le creía y pensaban que era imposible. Entonces dijo: 'Haced que el huevo no se caiga'. Todos los banqueros, personas muy ricas y probablemente inteligentes, intentaron de alguna manera poner el huevo y siempre se caía. Entonces Colón tomó el huevo, lo presionó un poco. La cáscara se dobló y el huevo se mantuvo en su lugar. Ellos dijeron: 'Oh, es demasiado simple!'. Y Colón respondió: 'Sí, es demasiado simple. Y cuando descubra la India, todos usarán esta ruta comercial'.
Y lo que acabo de contarles son, tal vez, cosas bastante simples y triviales. Y cuando te das cuenta de ellas y comienzas a usarlas, se vuelve algo normal. Así que úsenlas. Y si para ustedes son cosas bastante normales, al menos saben cómo colocar el huevo para que no se caiga.
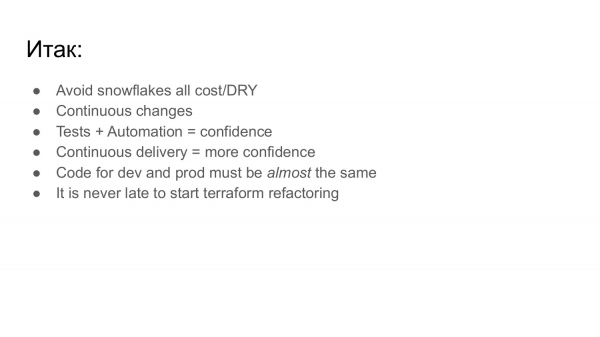
Resumiendo:
- Traten de evitar copos de nieve. Cuantos menos copos de nieve haya, menos recursos necesitarán para hacer algunos cambios en toda su gran infraestructura.
- Cambios constantes. Es decir, cuando hay cambios en el código, es necesario que su infraestructura se ajuste a esos cambios lo más rápido posible. No debe haber una situación en la que alguien venga después de dos o tres meses para revisar Elasticsearch, haga un terraform plan, y encuentre un montón de cambios que no esperaba. Y se pierde mucho tiempo para devolver todo a la normalidad.
- Pruebas y automatización. Cuanto más cubierto esté su código con pruebas y funcionalidades, más confianza tendrán de que están haciendo todo correctamente. Y la entrega automática aumentará su confianza de manera significativa.
- El código para entornos de prueba y producción debe ser prácticamente igual. Prácticamente, porque la producción es un poco diferente y siempre habrá algunos matices que se desvían del entorno de prueba. Sin embargo, se puede asegurar más o menos.
- Y si usted tiene mucho código de Terraform y mantener este código actualizado requiere mucho tiempo, nunca es tarde para refactorizarlo y llevarlo a una buena forma.
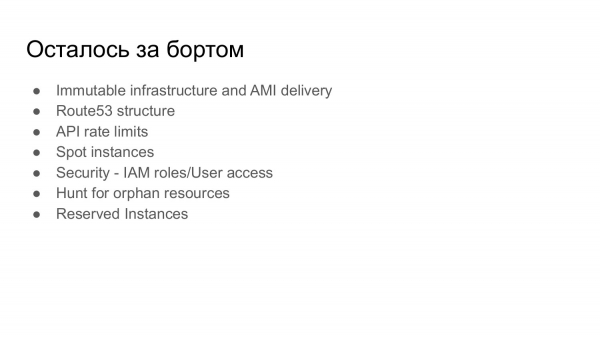
- Infraestructura inmutable. Entrega de AMI según un horario.
- Estructura para route53, cuando tiene muchas entradas y desea que estén en un orden coherente.
- Lucha contra los límites de tasa de API. Es cuando Amazon dice: "Todo, ya no puedo aceptar más solicitudes, por favor, espere". Y medio personal espera hasta que pueda iniciar su infraestructura.
- Instancias Spot. Amazon no es un evento barato y las instancias Spot permiten ahorrar bastante. Se podría dar toda una charla sobre esto.
- Seguridad y roles IAM.
- Búsqueda de recursos perdidos, cuando tiene instancias en Amazon de origen desconocido, que están consumiendo dinero. Incluso si las instancias cuestan 100-150 dólares al mes, eso son más de 1,000 al año. Encontrar tales recursos es un negocio rentable.
- Y también instancias reservadas.
Eso es todo por mi parte. Terraform es genial, úsenlo. ¡Gracias!
Preguntas
¡Gracias por la presentación! Su archivo de estado está en S3, ¿cómo resuelven el problema de que varias personas puedan acceder a ese archivo de estado e intentar desplegarse?
Primero, no tenemos prisa. En segundo lugar, hay flags, donde informamos que estamos trabajando en alguna parte del código. O sea, a pesar de que la infraestructura es muy grande, no significa que constantemente alguien esté aplicando algo. Y cuando estaba la fase activa, era un problema, teníamos archivos de estado guardados en Git. Eso era importante, de lo contrario, alguien crearía un archivo de estado y teníamos que reunirlos manualmente para que todo siguiera adelante. Ahora no hay tal problema. En general, Terraform resolvió esta tarea. Y si algo cambia constantemente, se pueden usar bloqueos que previenen lo que usted dijo.
¿Está utilizando la versión comunitaria o la empresa?
Nada de empresa, o sea, todo lo que se puede ir y descargar gratis.
Me llamo Stanislav. Quería hacer una pequeña adición. Hablaste sobre una función de Amazon que permite hacer que una instancia sea irrompible. Esto también existe en Terraform, en el bloque Life Second se puede especificar una prohibición de modificación o una prohibición de destrucción.
El tiempo fue limitado. Buena observación.
También quería preguntar dos cosas. En primer lugar, hablaste sobre las pruebas. ¿Has utilizado alguna herramienta para pruebas? Escuché sobre el complemento Test Kitchen. Quizás haya algo más. Y me gustaría preguntar sobre Local Values. ¿En qué se diferencian en principio de las Input Variables? ¿Y por qué no puedo parametrizar algo solo a través de Local Values? He intentado entender este tema, pero no he logrado esclarecerlo por completo.
Podemos hablar más en detalle de esto fuera de la sala. Las herramientas de prueba son completamente artesanales en nuestro caso. No hay nada realmente sofisticado para probar. Sin embargo, hay opciones donde las pruebas automáticas levantan infraestructura en algún lugar, verifican que esté bien y luego la destruyen con un informe de que tu infraestructura sigue en buen estado. No tenemos eso, porque los stacks de prueba se inician todos los días. Y eso es suficiente. Si algo empieza a fallar, comenzará a fallar sin necesidad de que lo verifiquemos en otro lugar.
En cuanto a Local Values, sigamos hablando de esto fuera de la sala.
¡Hola! ¡Gracias por la presentación! Muy informativa. Hablaste de que tienes mucho código repetitivo para describir la infraestructura. ¿No has considerado la opción de generar ese código?
¡Excelente pregunta, gracias! La cuestión es que, cuando usamos infraestructura como código, asumimos que estamos mirando el código y entendemos qué infraestructura está detrás de ese código. Si el código se genera, necesitamos imaginar qué código se generará para entender qué infraestructura habrá. O generamos el código, lo comiteamos y, en esencia, es lo mismo. Por eso seguimos el camino que escribimos y obtuvimos eso. Además, los generadores aparecieron un poco más tarde, cuando comenzamos a hacerlo. Y ya era tarde para cambiar.
¿Has oído algo sobre jsonnet?
No.
Mira, es una herramienta muy buena. Veo un caso concreto donde se puede aplicar y generar una estructura de datos.
Los generadores son buenos, como en el chiste sobre la máquina de afeitar. Es decir, la primera vez las caras son diferentes, pero luego todos tienen la misma cara. Los generadores son realmente atractivos. Pero, lamentablemente, nosotros tenemos caras un poco diferentes. Ese es el problema.
Solo míralo. ¡Gracias!
Me llamo Maxim, soy de Sberbank. Ustedes mencionaron que intentaron llevar Terraform a un análogo de un lenguaje de programación. ¿No sería más fácil usar Ansible?
Son cosas muy diferentes. Se pueden crear recursos tanto con Ansible como con Puppet en Amazon. Pero Terraform está específicamente diseñado para eso.
¿Solo tienen Amazon?
No se trata de que solo tengamos Amazon. Casi solo tenemos Amazon. Pero la característica clave es que Terraform recuerda. En Ansible, si dices: 'Levanta 5 instancias', las levantará, y luego dices: 'Ahora necesito 3'. Terraform dirá: 'Está bien, eliminaré 2', mientras que Ansible dirá: 'Está bien, aquí tienes 3'. En total, 8.
¡Hola! Gracias por su presentación. Fue muy interesante escuchar sobre Terraform. Solo quiero hacer un pequeño comentario sobre el hecho de que Terraform no tiene una versión estable, así que traten Terraform con gran precaución.
La cuchara es buena a la hora del almuerzo. Es decir, si necesitas una solución, a veces dejas de lado lo que es inestable, etc., pero funciona y nos ha ayudado.
Tengo una pregunta. Ustedes utilizan Remote backend, utilizan S3. ¿Por qué no utilizan el backend oficial?
¿Oficial?
Terraform Cloud.
¿Cuándo apareció?
Hace unos 4 meses.
Si hubiera aparecido hace 4 años, probablemente habría respondido su pregunta.
Allí ya hay una función incorporada y locks, y se puede almacenar el archivo de estado. Pruébenlo. Pero yo tampoco lo he probado.
Estamos viajando en un gran tren que se mueve a gran velocidad. No puedes simplemente tirar algunos vagones.
Hablaste de copos de nieve, pero ¿por qué no usaste branches? ¿Por qué no fue posible hacerlo así?
Tenemos un enfoque en el que toda la infraestructura está en un solo repositorio. Terraform, Puppet, todos los scripts que tengan alguna relación, están todos en un solo repositorio. De esta manera, podemos garantizar que los cambios incrementales sean probados uno por uno. Si hubiera un montón de branches, sería prácticamente imposible mantener tal proyecto. Pasan seis meses, y se desvían tanto que es simplemente un castigo. Es algo de lo que querrías escapar antes de la refactorización.
Es decir, ¿no funciona?
Esto no funciona en absoluto.
En branch recorté la diapositiva de la carpeta. Es decir, si haces una para cada pila de prueba, por ejemplo, el equipo A tiene su propia carpeta, el equipo B tiene su propia carpeta, entonces eso tampoco funciona. Creamos un código unificado para el entorno de prueba, que fue lo suficientemente flexible como para adaptarse a todos. Es decir, manteníamos un solo código.
¡Hola! ¡Me llamo Yura! ¡Gracias por la presentación! Tengo una pregunta sobre los módulos. Ustedes mencionan que utilizan módulos. ¿Cómo manejan el problema si en un módulo se realizan cambios que son incompatibles con los cambios de otra persona? ¿Versionan los módulos de alguna manera o intentan hacer que todo funcione para cumplir con dos requisitos?
Ese es un problema de una gran bola de nieve. Es lo que sufrimos cuando un cambio aparentemente inofensivo puede romper alguna parte de la infraestructura. Y eso solo se nota después de un tiempo prolongado.
Es decir, ¿todavía no hay una solución?
Hacen módulos universales. Eviten las variantes inusuales. Y todo funcionará. La segunda mitad de la presentación trata sobre cómo evitar eso.
¡Hola! ¡Gracias por la presentación! Quisiera aclarar. Quedó una gran cantidad de información en el aire, por la que vine. ¿Cómo están integrados Puppet y la asignación de roles?
User-data.
Es decir, ¿simplemente lanzan un archivo y lo ejecutan de alguna manera?
User-data es una nota, es decir, cuando hacemos un clon de la imagen, se inicia un Demonio y, tratando de averiguar quién es, lee la nota que indica que es un balanceador de carga.
Es decir, ¿es algún proceso separado que se asigna?
No lo inventamos nosotros. Lo estamos utilizando.
¡Hola! Tengo precisamente una pregunta sobre User-data. Ustedes mencionaron que hay problemas, que alguien puede transmitir algo erróneamente. ¿Hay alguna manera de almacenar user-data en el mismo Git, para que siempre esté claro a qué se refiere User-data?
Generamos User-data a partir de la plantilla. Es decir, hay algunas variables que se envían. Y Terraform genera el resultado final. Por eso no se puede mirar la plantilla y decir qué va a salir, porque todos los problemas están relacionados con que el desarrollador piensa que está pasando una cadena en esta variable, mientras que en realidad está llegando un arreglo. Y de repente, eso falla, y resulta que había algo más en la próxima línea, y todo se rompe. Si es un recurso nuevo y la persona lo está levantando, verá que algo no funciona, lo que se resuelve rápidamente. Pero si se actualizó un grupo de autoscaling, en algún momento las instancias en el grupo de autoscaling empezarán a cambiar. Y ¡zas!, algo deja de funcionar. Eso es frustrante.
¿Entonces, la única solución es probar?
Sí, ves el problema, y agregas pasos de prueba. Es decir, también se puede probar con los outputs. Puede que no sea tan conveniente, pero también se pueden poner algunas marcas: verifica que User-data esté bien asegurada.
Me llamo Timur. Es genial que haya presentaciones sobre cómo organizar correctamente Terraform.
Ni siquiera he empezado.
Creo que en la próxima conferencia, quizás habrá. Tengo una pregunta sencilla. ¿Por qué codificas un valor en un módulo separado en lugar de usar tfvars? Es decir, ¿qué hace mejor un módulo de valores en comparación con tfvars?
Es decir, ¿debo escribir aquí (diapositiva: Production/environment/settings.tf): domain = variable, domain vpcnetwork, variable vpcnetwork y stvars – ¿sacar lo mismo?
Lo hacemos de esa manera. Hacemos referencia al módulo setting source, por ejemplo.
En esencia, eso es como un tfvars. Tfvars es muy conveniente en el entorno de testing. Tengo tfvars para instancias grandes y para pequeñas. Y simplemente pongo un archivo en la carpeta. Y obtengo lo que quiero. Cuando estamos desarrollando la infraestructura, queremos que se pueda ver y entender todo de inmediato. Pero, de esta manera, tienes que mirar aquí y luego mirar en tfvars.
¿Entonces, para que todo esté en un solo lugar?
Sí, tfvars es cuando tienes un solo código. Y se utiliza en varios lugares diferentes con diferentes matices. Entonces lanzarías tfvars y obtendrías tus matices. Y nosotros – eso es infraestructura como código en su forma más pura. Miras y entiendes.
¡Hola! ¿Te has encontrado con situaciones en las que el proveedor de la nube interviene en lo que hiciste con Terraform? Supongamos que estamos editando metadatos. Ahí están las claves ssh. Y Google constantemente está introduciendo sus metadatos, sus claves. Y Terraform siempre dice que tiene cambios. Después de cada ejecución, incluso si no hay cambios, siempre dice que va a actualizar ese campo.
Con las claves, pero sí, parte de la infraestructura está afectada por esa situación, es decir, Terraform no puede cambiar nada. Nosotros tampoco podemos cambiar nada manualmente. Mientras tanto, vivimos con eso.
Es decir, te has encontrado con eso, pero no has encontrado solución, ¿hace lo que quiere y sigue así?
Desafortunadamente, sí.
¡Hola! Me llamo Stanislav Starkov. Mail.ru Group. ¿Cómo resuelves el problema de generar la etiqueta en …, cómo la pasas por dentro? Entiendo que a través de User — data, para especificar el nombre del host, ¿diriges Puppet? Y la segunda parte de la pregunta. ¿Cómo resuelves esto en SG, es decir, cuando generas SG, un centenar de instancias similares, cómo las nombras correctamente?
Las instancias que son muy importantes para nosotros, las nombramos de manera adecuada. Las que no son necesarias tienen un sufijo que indica que son parte del grupo autoscale. Y, en teoría, eso se puede eliminar y obtener una nueva.
En cuanto al problema con la etiqueta, no existe tal problema, sino que hay una tarea. Y las etiquetas se utilizan mucho, porque la infraestructura es grande y costosa. Necesitamos ver a dónde se va el dinero, por lo que las etiquetas permiten desglosar qué y hacia dónde se ha ido. Y, en consecuencia, buscar lo que gasta mucho dinero aquí.
¿Cuál era la otra pregunta?
Cuando SG crea un centenar de instancias, ¿hay que diferenciarlas de alguna manera?
No, no es necesario. En cada instancia hay un agente que informa que tengo un problema. Si el agente informa, entonces el agente lo sabe y, al menos, su dirección IP existe. Ya se puede ir. Además, usamos Consul para Discovery, donde no hay Kubernetes. Y Consul también muestra la dirección IP de la instancia.
Es decir, te basas en la IP, no en el nombre del host?
No se puede basar en el nombre del host, es decir, hay demasiados. Hay identificadores de instancia – AE, etc. Se puede encontrar en alguna parte, se puede buscar.
¡Hola! He entendido que Terraform es una buena herramienta, diseñada para la nube.
No solo.
Esta es precisamente la pregunta que me interesa. Si decides hacer una migración masiva a Bare Metal con todas tus instancias, ¿no habrá problemas? ¿O deberás utilizar otros productos, como Ansible, que se mencionó aquí?
Ansible trata de algo diferente. Es decir, Ansible funciona una vez que la instancia ha sido lanzada. Mientras que Terraform trabaja antes de que la instancia se inicie. La migración a Bare Metal no es posible.
Por ahora no, pero llegará un momento en que el negocio dirá: «Vamos a hacerlo».
La migración a otra nube es viable, pero aquí hay un detalle diferente. Necesitas escribir el código de Terraform de manera que la transición a otra nube sea lo más suave posible.
Al principio, se planteó la tarea de que toda nuestra infraestructura fuera agnóstica, es decir, cualquier nube debería ser viable, pero en algún momento el negocio se rindió y dijo: «Está bien, en los próximos N años no nos moveremos de aquí, podemos usar los servicios de Amazon».
Terraform permite crear trabajos en Front-End, configurar PagerDuty, data doc, etc. Tiene muchas funcionalidades. Prácticamente puede controlar todo.
¡Gracias por la presentación! Yo también he estado usando Terraform durante 4 años. En la etapa de transición a Terraform, a la infraestructura, a la descripción declarativa, enfrentamos situaciones donde alguien hacía algo manualmente y tú intentabas hacer un plan. Y obtuviste algún tipo de error. ¿Cómo manejan esos problemas? ¿Cómo encuentran recursos perdidos que estaban especificados?
Principalmente a mano y a ojo; si vemos algo extraño en el informe, analizamos qué está sucediendo, o simplemente lo eliminamos. En general, los pull requests son algo común.
Si hay un error, ¿realizan un rollback? ¿Han intentado hacerlo?
No, esa es una decisión del momento cuando la persona ve el problema.
Fuente: habr.com
