

Hace tres años, Viktor Tarnavskiy y Alexey Milovidov de Yandex subieron al escenario HighLoad++. , para hablar sobre lo bueno que es ClickHouse y cómo no presenta problemas de rendimiento. En el escenario vecino estaba Alexander Zaytsev con hablando sobre la transición a ClickHouse otra base de datos analítica y señalando que ClickHouse, por supuesto, es buena, pero no muy conveniente. Cuando en 2016 la empresa LifeStreet, donde trabajaba Alexander en ese momento, trasladó su sistema analítico de múltiples petabytes a ClickHouse, fue un fascinante viaje por el "camino de ladrillos amarillos", lleno de peligros desconocidos — ClickHouse en aquel entonces parecía un campo minado.
Tres años después ClickHouse , ha mejorado mucho: durante este tiempo, Alexander fundó la empresa Altinity, que no solo ayuda a hacer la transición a ClickHouse decenas de proyectos, sino que también mejora el producto junto con sus colegas de Yandex. Ahora ClickHouse no es una caminata despreocupada, pero ya no es un campo minado.
Alexander ha estado trabajando con sistemas distribuidos desde 2003, desarrollando grandes proyectos en MySQL, Oracle y Vertica. En la reciente HighLoad++ 2019 , Alexander, uno de los pioneros en el uso de ClickHouse, habló sobre lo que es este sistema de gestión en la actualidad. Hablaremos sobre sus características principales ClickHouse: en qué se diferencia de otros sistemas y en qué casos es más eficiente usarlo. A través de ejemplos, exploraremos prácticas recientes y comprobadas en proyectos de construcción de sistemas sobre ClickHouse.
Retrospectiva: qué sucedió hace 3 años
Hace tres años, trasladamos la empresa LifeStreet en ClickHouse de otra base de datos analítica, y la migración de la analítica de la red publicitaria se veía así:
- Junio de 2016. En OpenSource se introdujo ClickHouse y comenzó nuestro proyecto;
- Agosto. Prueba de Concepto: una gran red publicitaria, infraestructura y de 200 a 300 terabytes de datos;
- Octubre. Los primeros datos de producción;
- Diciembre. Carga productiva completa — de 10 a 50 mil millones de eventos al día.
- Junio de 2017. Exitosa migración de usuarios a ClickHouse, 2,5 petabytes de datos en un clúster de 60 servidores.
Durante el proceso de migración, creció el entendimiento de que ClickHouse era un buen sistema, con el que es agradable trabajar, pero es un proyecto interno de Yandex. Así que hay matices: Yandex se ocuparía primero de sus propios clientes internos y solo después de la comunidad y las necesidades de los usuarios externos, y ClickHouse no alcanzaba en aquel entonces el nivel empresarial en muchas áreas funcionales. Por eso, en marzo de 2017 fundamos la empresa Altinity, para hacer ClickHouse aún más rápido y cómodo, no solo para Yandex, sino también para otros usuarios. Y ahora nosotros:
- Entrenamos y ayudamos a construir soluciones en ClickHouse de manera que los clientes no cometan errores y la solución funcione al final;
- Proporcionamos soporte 24/7 ClickHouse-instalaciones;
- Desarrollamos nuestros propios proyectos ecosistémicos;
- Commitimos activamente en el mismo ClickHouse, respondiendo a las solicitudes de usuarios que desean ver ciertas características.
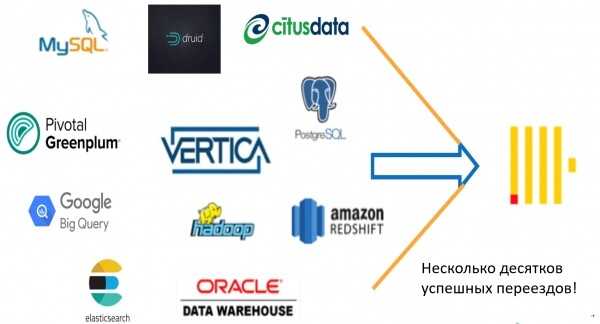
Y, por supuesto, ayudamos con la migración a ClickHouse con MySQL, Vertica, Oracle, Greenplum, Redshift y otros sistemas. Hemos participado en diversas migraciones, todas ellas exitosas.
¿Por qué migrar a ClickHouse
¡No se ralentiza! Esta es la razón principal. ClickHouse — una base de datos muy rápida para diferentes escenarios:
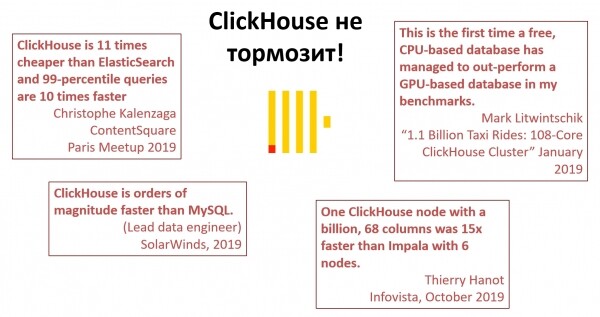
Citas aleatorias de personas que han trabajado mucho tiempo con ClickHouse.
Escalabilidad. Con otra base de datos se puede lograr un buen rendimiento en una sola máquina, pero ClickHouse se puede escalar no solo verticalmente, sino también horizontalmente, simplemente agregando servidores. No todo funciona tan bien como se desearía, pero funciona. Se puede aumentar el sistema junto con el crecimiento del negocio. Es importante que no estamos limitados por la solución actual y siempre hay potencial para el desarrollo.
Portabilidad. No hay ataduras a algo específico. Por ejemplo, con Amazon Redshift es difícil migrar a otro lugar. Pero ClickHouse se puede instalar en una laptop, un servidor, desplegar en la nube, salir en Kubernetes — no hay limitaciones en la explotación de la infraestructura. Esto es conveniente para todos, y es una gran ventaja que muchas otras bases de datos similares no pueden presumir.
Flexibilidad. ClickHouse no se detiene en algo específico, como Yandex.Metrica, sino que se desarrolla y se utiliza en un número cada vez mayor de proyectos e industrias. Se puede ampliar, añadiendo nuevas funcionalidades para resolver nuevos problemas. Por ejemplo, se considera que almacenar logs en una base de datos es obsoleto, por eso se inventó Elasticsearch. Sin embargo, gracias a la flexibilidad de ClickHouse, también se pueden almacenar logs en él, y a menudo es incluso mejor que en Elasticsearch — en ClickHouse para esto se necesita 10 veces menos hardware.
Gratis Open Source. No hay que pagar nada. No hay necesidad de negociar el permiso para instalar el sistema en una laptop o servidor. No hay pagos ocultos. Al mismo tiempo, ninguna otra tecnología de base de datos de código abierto puede competir en velocidad con ClickHouse. MySQL, MariaDB, Greenplum — todos son mucho más lentos.
La comunidad, el impulso y fun. Tienen una excelente comunidad: meetups, chats y Alexey Milovidov, que nos llena de energía y optimismo. ClickHouse una excelente comunidad: reuniones, chats y Alexei Milovidov, quien nos inspira a todos con su energía y optimismo.
Migración a ClickHouse
Para transitar desde ClickHouse algo, solo se necesitan tres cosas:
- Entender las limitaciones ClickHouse y para qué no es adecuado.
- Explotar las ventajas de la tecnología y sus fortalezas más destacadas.
- Experimentar. Incluso entendiendo cómo funciona ClickHouse, no siempre es posible predecir cuándo será más rápido, cuándo más lento, cuándo mejor y cuándo peor. Por lo tanto, inténtalo.
El problema de la migración
Solo hay un "pero": si te mudas desde ClickHouse algo diferente, generalmente algo no va bien. Estamos acostumbrados a ciertas prácticas y cosas que funcionan en our base de datos favorita. Por ejemplo, cualquier persona que trabaje con bases de datos SQLconsidera obligatorio un conjunto de funciones:
- transacciones;
- constreintes;
- consistencia;
- índices;
- UPDATE/DELETE;
- NULLs;
- milisegundos;
- conversión automática de tipos;
- uniones múltiples;
- particiones arbitrarias;
- herramientas de gestión de clústeres.
El conjunto es obligatorio, pero hace tres años en ClickHouse no había ninguna de estas funciones. Ahora de lo no implementado queda menos de la mitad: transacciones, constreintes, consistencia, milisegundos y conversión de tipos.
Y lo más importante: en ClickHouse algunas prácticas y enfoques estándar no funcionan o no operan como estamos acostumbrados. Todo lo que aparece en ClickHouse, corresponde a "ClickHouse way", es decir, las funciones son diferentes a las de otras bases de datos. Por ejemplo:
- Los índices no seleccionan, sino que omiten.
- UPDATE/DELETE no son síncronos, sino asíncronos.
- Hay uniones múltiples, pero no hay planificador de consultas. Cómo se ejecutan entonces no es muy claro para las personas del mundo de las bases de datos.
Escenarios de ClickHouse
En 1960, el matemático estadounidense de origen húngaro Wigner E. P. escribió un artículo titulado "La eficacia irrazonable de las matemáticas en las ciencias naturales" sobre el hecho de que el mundo que nos rodea, por alguna razón, está bien descrito por leyes matemáticas. Las matemáticas son una ciencia abstracta, y las leyes físicas expresadas en forma matemática no son triviales, y Wigner E. P. subrayó que esto es muy extraño.
Desde mi punto de vista, ClickHouse es una extrañeza similar. Reformulando a Wigner, se puede decir: sorprendentemente, la eficacia incomprensible ClickHouse en una variedad de aplicaciones analíticas es asombrosa.
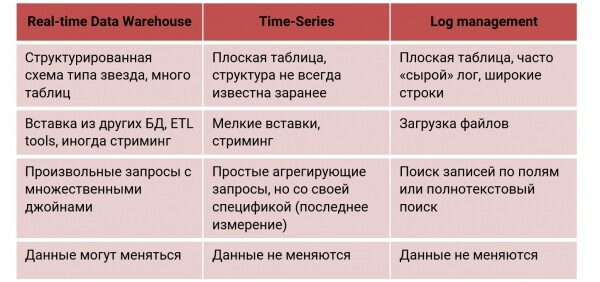
Por ejemplo, tomemos un Almacén de Datos en Tiempo Real, donde los datos se cargan casi de manera continua. Queremos recibir consultas con un retraso de un segundo. Por favor: utilizamos ClickHouse, porque este escenario fue diseñado para ello. ClickHouse es utilizado no solo en la web, sino también en análisis de marketing y financiero, AdTech, así como en detectar fraudes. En Data Warehouse en tiempo real se utiliza un esquema estructurado complejo de tipo "estrella" o "copos de nieve", con muchas tablas que JOIN (a veces múltiples), y los datos generalmente se almacenan y cambian en ciertos sistemas.
Tomemos otro escenario — Series temporales: monitoreo de dispositivos, redes, estadísticas de uso, Internet de las cosas. Aquí nos encontramos con eventos bastante simples ordenados por tiempo. ClickHouse no fue diseñado inicialmente para ello, pero ha demostrado ser eficaz, por lo que grandes empresas lo utilizan ClickHouse como almacén para información de monitoreo. Para estudiar si ClickHouse es adecuado para series temporales, realizamos un benchmark basado en el enfoque y los resultados InfluxDB y TimescaleDB — bases de datos especializadas en series temporales . , que ClickHouse, incluso sin optimización para tales tareas, destaca incluso en un campo ajeno:
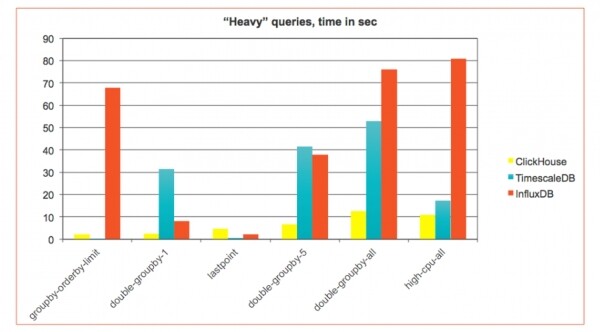
En series temporales generalmente se utiliza una tabla estrecha — con unas pocas columnas pequeñas. Desde el monitoreo puede llegar una gran cantidad de datos, — millones de registros por segundo, — y generalmente llegan en pequeñas inserciones (tiempo real streaming). Por ello se necesita otro escenario de inserción, y las propias consultas — con su propia especificidad.
Gestión de registros. La recopilación de registros en la base de datos — esto suele ser malo, pero en ClickHouse se puede hacer con algunos comentarios, como se describió anteriormente. Muchas empresas utilizan ClickHouse precisamente para ello. En este caso, se utiliza una tabla plana y amplia, donde almacenamos los registros en su totalidad (por ejemplo, en forma de JSON), o los dividimos en partes. Los datos generalmente se cargan en grandes lotes (archivos), y buscamos por algún campo.
Para cada una de estas funciones, generalmente se utilizan bases de datos especializadas. ClickHouse una puede hacerlo todo y tan bien, que supera a las demás en rendimiento. Ahora, examinemos con detalle series temporales el escenario, y cómo "preparar" correctamente ClickHouse para este escenario.
Series temporales
En este momento, este es el escenario principal para el cual ClickHouse se considera una solución estándar. Series temporales es un conjunto de eventos ordenados en el tiempo que representan cambios en algún proceso a lo largo del tiempo. Por ejemplo, esto puede ser la frecuencia cardíaca a lo largo del día o el número de procesos en el sistema. Todo lo que proporciona ticks temporales con alguna medida – es series temporales:
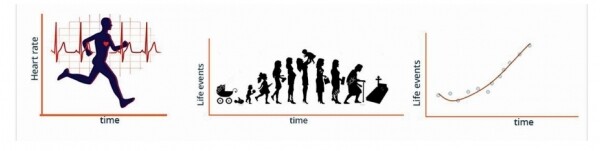
La mayoría de este tipo de eventos proviene de la monitorización. Esto puede ser no solo la monitorización web, sino también de dispositivos reales: coches, sistemas industriales, IoT, fábricas o taxis autónomos, en cuyos maleteros Yandex ya coloca ClickHouse-servidores.
Por ejemplo, hay empresas que recogen datos de barcos. Cada pocos segundos, los sensores de un portacontenedores envían cientos de diferentes mediciones. Los ingenieros las estudian, construyen modelos y tratan de entender cuán eficientemente se utiliza el barco, porque el portacontenedores no debe estar parado ni un segundo. Cualquier inactividad es una pérdida de dinero, por lo que es importante prever la ruta de forma que las paradas sean mínimas.
Actualmente, se observa un crecimiento de bases de datos especializadas que miden series temporales. En el sitio DB-Engines de alguna manera clasifican diferentes bases de datos, que se pueden consultar por tipo:
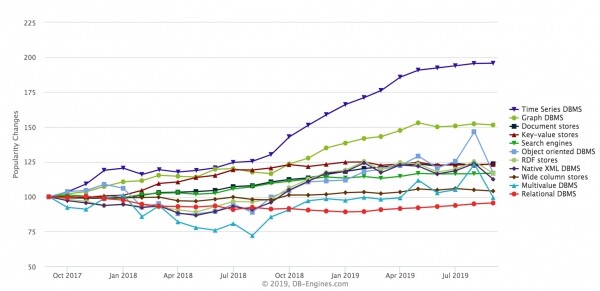
El tipo de más rápido crecimiento es el time-seriess. También están creciendo las bases de datos gráficas, pero time-seriess han crecido más rápidamente en los últimos años. Representantes típicos de este tipo de base de datos son InfluxDB, Prometheus, KDB, TimescaleDB (basada en PostgreSQL), soluciones de Amazon. ClickHouse también se puede utilizar aquí, y se utiliza. Daré algunos ejemplos públicos.
Uno de los pioneros es la empresa CloudFlare (CDN-proveedor). Ellos monitorizan sus CDN a través de ClickHouse (DNS-consultas, . La mejora del rendimiento de nginx se debe al uso de una arquitectura asíncrona basada en eventos, a diferencia del modelo multihilo. Esto, junto con un alto paralelismo, permite a nginx manejar solicitudes con un bajo consumo de memoria. Esto hace que Nginx sea una excelente solución para servidores web, tanto para grandes como para pequeños volúmenes de tráfico. nginx es una solución madura y completamente documentada, que permite configurar fácilmente la configuración según tus necesidades. Los desarrolladores también utilizan nginx como proxy inverso para-consultas) con una carga enorme: 6 millones de eventos por segundo. Todo pasa a través de Kafka, se envía a ClickHouse, que permite ver en tiempo real los tableros de eventos del sistema.
Comcast es uno de los líderes de telecomunicaciones en EE.UU.: internet, televisión digital, telefonía. Crearon un sistema de gestión similar CDN en el marco de Open Source el proyecto Apache Traffic Control para trabajar con sus enormes datos. ClickHouse se utiliza como backend para análisis.
Percona integraron ClickHouse dentro de su PMM, para almacenar la monitorización de varios MySQL.
Requisitos específicos
Las bases de datos time-series tienen sus propios requisitos específicos.
- Inserción rápida desde muchos agentes. Debemos insertar los datos muy rápidamente desde muchos flujos. ClickHouse lo hace bien, porque tiene todas las inserciones no bloqueantes. Cualquier insert es un nuevo archivo en disco, y las inserciones pequeñas pueden ser almacenadas en búfer de alguna manera. En ClickHouse es mejor insertar datos en grandes lotes, no línea por línea.
- Esquema flexible. Hay series temporales Generalmente, no conocemos la estructura de los datos hasta el final. Se puede construir un sistema de monitoreo para una aplicación específica, pero luego es difícil usarlo para otra aplicación. Se necesita un esquema más flexible para esto. ClickHousepermite hacer esto, incluso a pesar de que es una base estrictamente tipada.
- Almacenamiento eficiente y "olvido" de datos. Generalmente en series temporales un volumen gigante de datos, por lo que se deben almacenar de la manera más eficiente posible. Por ejemplo, la InfluxDB buena compresión es su característica principal. Pero además del almacenamiento, también se debe saber cómo "olvidar" datos antiguos y hacer algún tipo de downsampling — el cálculo automático de agregados.
- Consultas rápidas de datos agregados. A veces es interesante ver los últimos 5 minutos con una precisión de milisegundos, pero en datos mensuales, una granularidad de minutos o segundos puede no ser necesaria; con datos generales es suficiente. Este tipo de soporte es necesario, de lo contrario, una consulta de 3 meses tomará mucho tiempo, incluso en ClickHouse.
- Consultas tipo "último punto, a partir de». Estas son consultas típicas para series temporales ver el último medido o el estado del sistema en un momento dado t. Para las bases de datos, estas no son consultas muy agradables, pero también se deben poder ejecutar.
- "Uniendo" series temporales. Series temporales — es una serie temporal. Si hay dos series temporales, a menudo es necesario conectarlas y correlacionarlas. No en todas las bases de datos es conveniente hacerlo, especialmente con series temporales desiguales: aquí hay unos timestamps, allí hay otros. Se puede calcular un promedio, pero aún así podría haber un hueco, por lo que no es claro.
Veamos cómo se cumplen estos requisitos en ClickHouse.
Esquema
En ClickHouse esquema para series temporales se puede hacer de diferentes maneras, dependiendo del grado de regularidad de los datos. Se puede construir un sistema con datos regulares, cuando sabemos todas las métricas de antemano. Por ejemplo, así lo hizo CloudFlare con el monitoreo CDN — es un sistema bien optimizado. Se puede construir un sistema más general que monitorea toda la infraestructura, diversos servicios. En caso de datos irregulares, no sabemos de antemano qué estamos monitoreando, y probablemente este sea el caso más general.
Datos regulares. Columnas. El esquema es simple: columnas con los tipos necesarios:
CREAR TABLA cpu (
  created_date Fecha DEFAULT today(),
  created_at FechaHora DEFAULT now(),
  time Cadena,
  tags_id UInt32,
  /* unirse a dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Esta es una tabla común que monitorea alguna actividad de carga del sistema (usuario, system, inactivo, nice). Simple y conveniente, pero no flexible. Si deseamos un esquema más flexible, podemos utilizar matrices.
Datos no regulares. Matrices:
CREAR TABLA cpu_alc (
  created_date Fecha,
  created_at FechaHora,
  time Cadena,
  tags_id UInt32,
  metrics Anidado(
    name LowCardinality(Cadena),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Estructura Anidado — son dos matrices: metrics.name y metrics.value. Aquí se pueden almacenar datos de monitoreo arbitrarios, como una matriz de nombres y una matriz de medidas en cada evento. Para una mayor optimización, en lugar de una sola estructura, se pueden crear varias. Por ejemplo, una para flotante-valor, otra para int-valor, porque int se quiere almacenar de manera más eficiente.
Pero esta estructura es más difícil de manejar. Tendremos que usar una construcción especial, extrayendo los valores primero del índice y luego de la matriz:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...Pero aun así, funciona bastante rápido. Otra forma de almacenar datos no regulares es en filas.
Datos no regulares. Filas. En este enfoque tradicional, sin matrices, se almacenan instantáneamente los nombres y valores. Si de un dispositivo llegan 5,000 mediciones a la vez, se generan 5,000 filas en la base de datos:
CREAR TABLA cpu_rlc (
  created_date Fecha,
  created_at FechaHora,
  time Cadena,
  tags_id UInt32,
  metric_name LowCardinality(Cadena),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FROM cpu_r
WHERE metric_name IN ('usage_user', ...)
ClickHouse esto se maneja — tiene extensiones especiales ClickHouse SQL. Por ejemplo, maxIf — es una función especial que calcula el máximo de la métrica cuando se cumple alguna condición. Se pueden escribir varias de estas expresiones en una sola consulta y calcular inmediatamente el valor para varias métricas.
Compararemos tres enfoques:
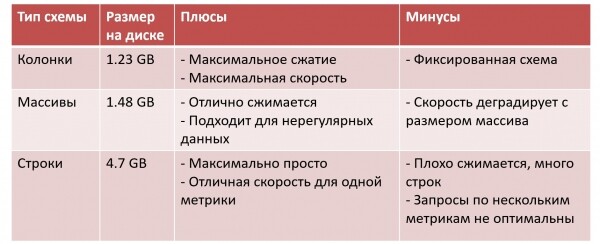
Aquí añadí "Tamaño de datos en disco" para un conjunto de datos de prueba. En el caso de las columnas, tenemos el tamaño de datos más pequeño: máxima compresión, máxima velocidad de consultas, pero pagamos por ello porque debemos fijar todo de inmediato.
En el caso de los arreglos, la situación es un poco peor. Los datos aún se comprimen bien y se puede almacenar un esquema irregular. Pero ClickHouse — una base de datos en columnas, y cuando comenzamos a almacenar todo en un arreglo, se convierte en una base de datos en filas, y pagamos por la flexibilidad con eficiencia. Para cualquier operación, hay que leer todo el arreglo en memoria, luego encontrar el elemento requerido, y si el arreglo crece, la velocidad se degrada.
En una de las empresas que utiliza este enfoque (por ejemplo, ), los arreglos se dividen en fragmentos de 128 elementos. Datos de miles de métricas con un volumen de 200 TB de datos/día no se almacenan en un solo arreglo, sino en 10 o 30 arreglos con lógica especial de almacenamiento.
El enfoque más simple es con filas. Pero los datos se comprimen mal, el tamaño de la tabla resulta grande, y cuando las consultas se realizan sobre varias métricas, ClickHouse trabaja de manera subóptima.
Esquema híbrido
Supongamos que elegimos un esquema basado en arreglos. Pero si sabemos que la mayoría de nuestros dashboards solo muestran métricas de usuario y sistema, podemos adicionalmente materializar estas métricas en columnas a nivel de tabla de esta manera:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Al insertar ClickHouse se calcularán automáticamente. Así se puede conciliar lo agradable con lo útil: el esquema es flexible y general, pero hemos extraído las columnas más utilizadas. Cabe señalar que esto no requirió cambiar la inserción y ETL, que sigue insertando en la tabla arreglos. Simplemente hicimos ALTER TABLE, añadimos un par de columnas y se obtuvo un esquema híbrido y más rápido, que se puede empezar a utilizar de inmediato.
Codecs y compresión
Para series temporales importa cuán bien empaquetas los datos, porque el arreglo de información puede ser muy grande. En ClickHouse existe un conjunto de herramientas para lograr un efecto de compresión de 1:10, 1:20, y a veces más. Esto significa que los datos sin comprimir de 1 TB ocupan entre 50 y 100 GB en disco. Un tamaño menor es beneficioso, ya que los datos se pueden leer y procesar más rápidamente.
Para lograr un alto nivel de compresión, ClickHouse admite los siguientes códecs:
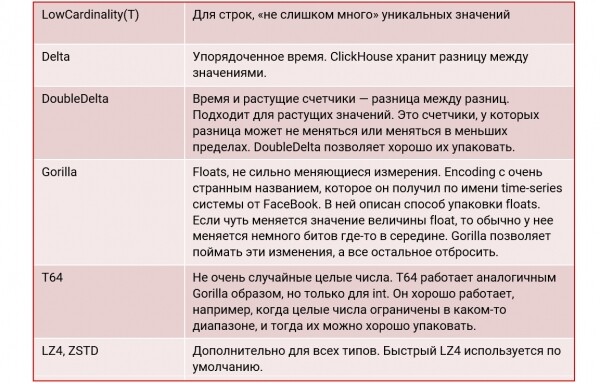
Ejemplo de tabla:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Aquí definimos el códec DoubleDelta en un caso, en el segundo — Gorilla, y además añadimos otra LZ4 compresión. Como resultado, el tamaño de los datos en disco se reduce considerablemente:
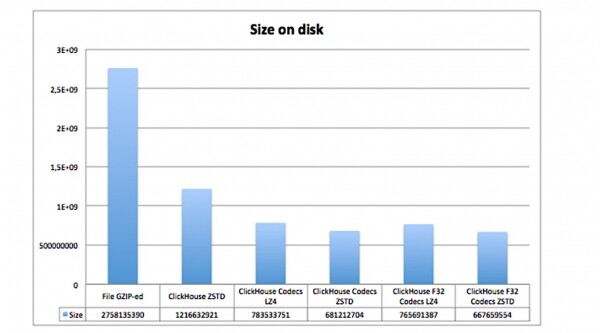
Aquí se muestra cuánto espacio ocupan los mismos datos, pero utilizando diferentes códecs y compresiones:
- en un archivo comprimido con GZIP en disco;
- en ClickHouse sin códecs, pero con compresión ZSTD;
- en ClickHouse con códecs y compresión LZ4 y ZSTD.
Es evidente que las tablas con códecs ocupan mucho menos espacio.
El tamaño importa
No menos importante es el tipo de dato correcto:
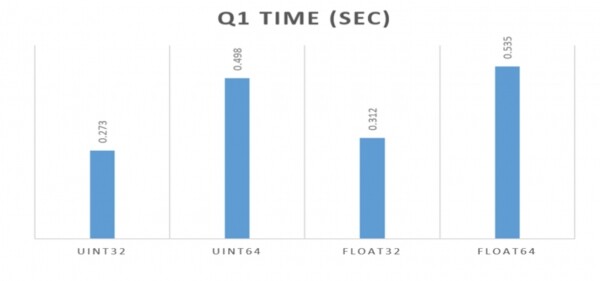
En todos los ejemplos anteriores utilicé Float64. Pero si hubiéramos elegido Float32, eso sería incluso mejor. Esto lo demostraron muy bien los chicos de Percona en el artículo del enlace anterior. Es importante usar el tipo más compacto adecuado para la tarea: más que para el tamaño en disco, para la velocidad de las consultas. ClickHouse es muy sensible a esto.
Si puedes usar int32 en lugar de int64, espera un aumento casi doble en el rendimiento. Los datos ocupan menos memoria y toda la "aritmética" funciona mucho más rápido. ClickHouse dentro de sí mismo — es un sistema muy estrictamente tipado, aprovecha al máximo todas las capacidades que ofrecen los sistemas modernos.
Agregación y Vistas Materializadas
La agregación y las vistas materializadas permiten realizar agregados para diversas situaciones:
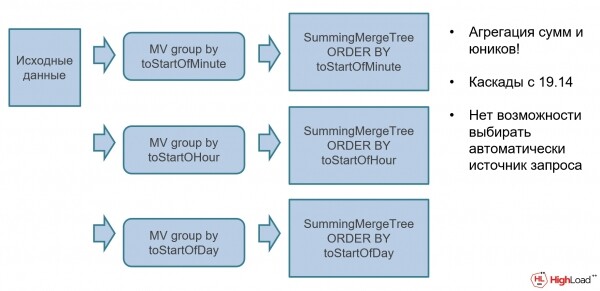
Por ejemplo, puedes tener datos originales no agregados, y sobre ellos se pueden adjuntar diversas vistas materializadas con sumas automáticas a través de un motor especializado SummingMergeTree (SMT). SMT es una estructura de datos agregadora especial que cuenta los agregados automáticamente. Los datos crudos se insertan en la base de datos, se agregan automáticamente y se pueden usar inmediatamente en los paneles de control.
TTL «olvidamos» los datos antiguos
¿Cómo «olvidar» datos que ya no son necesarios? ClickHouse lo sabe hacer. Al crear tablas, se puede indicar TTL expresiones: por ejemplo, que los datos por minutos se almacenan un día, los diarios — 30 días, y los semanales o mensuales nunca se tocan:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Multi-tier separar los datos por discos
Desarrollando esta idea, los datos se pueden almacenar en ClickHouse diferentes lugares. Supongamos que queremos almacenar los datos calientes de la última semana en un almacenamiento local muy rápido SSD, mientras que los datos más históricos se almacenan en otro lugar. En ClickHouse actualmente esto es posible:
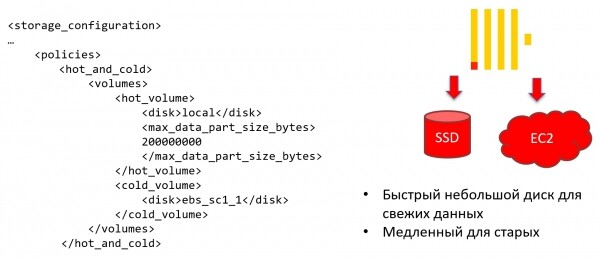
Se puede configurar la política de almacenamiento (storage policy) de tal manera que ClickHouse moverá automáticamente los datos al alcanzar ciertas condiciones a otro almacenamiento.
Pero esto no es todo. A nivel de una tabla concreta, se pueden definir reglas sobre cuándo exactamente los datos pasan a almacenamiento frío según el tiempo. Por ejemplo, los datos permanecen en un disco muy rápido durante 7 días, y todo lo que sea más antiguo se traslada a uno lento. Esto es beneficioso ya que permite mantener el sistema en máximo rendimiento, controlando al mismo tiempo los gastos y sin gastar recursos en datos fríos:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Características únicas ClickHouse
Casi en todo en ClickHouse hay tales «particularidades», pero se ven atenuadas por la exclusividad — aquello que no existe en otras bases de datos. Por ejemplo, aquí hay algunas de las funciones únicas ClickHouse:
- Arrays. Hay ClickHouse muy buen soporte para arreglos, así como la posibilidad de realizar cálculos complejos sobre ellos.
- Estructuras de datos agregadoras. Esta es una de las «killer features» ClickHouse. A pesar de que los chicos de Yandex dicen que no quieren agregar datos, todos lo hacen en ClickHouse, porque es rápido y conveniente.
- Vistas materializadas. Junto con las estructuras de datos agregadoras, las vistas materializadas permiten realizar una conveniente tiempo real agregación.
- ClickHouse SQL. Esta es una extensión del lenguaje SQL con algunas funciones adicionales y exclusivas que solo existen en ClickHouseAntes era una especie de expansión por un lado y una desventaja por el otro. Ahora hemos eliminado casi todas las desventajas en comparación con SQL 92 , ahora es solo una expansión.
- Lambda–expresiones. ¿Existen en alguna otra base de datos?
- ML-soporte. Esto está presente en diferentes BD, en algunas mejor y en otras peor.
- Código abierto. Podemos expandir ClickHouse juntos. Actualmente hay ClickHouse alrededor de 500 contribuyentes, y este número sigue creciendo.
Consultas complejas
En ClickHouse hay muchas formas diferentes de hacer lo mismo. Por ejemplo, se puede obtener el último valor de la tabla de tres maneras diferentes para CPU (hay una cuarta, pero es aún más exótica).
La primera muestra lo conveniente que es hacer en ClickHouse consultas cuando quieres verificar qué tupla se encuentra en una subconsulta. Esto es algo que personalmente me faltaba mucho en otras BD. Si quiero comparar algo con una subconsulta, en otras BD solo se puede comparar un escalar, y para varias columnas hay que escribir JOIN. Hay ClickHouse se puede usar tupla:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
La segunda forma hace lo mismo, pero utiliza la función de agregación argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
En ClickHouse hay varias decenas de funciones de agregación, y si se utilizan combinadores, por las leyes de la combinatoria se obtienen alrededor de mil. ArgMax es una de las funciones que calcula el valor máximo: la consulta devuelve el valor usage_user, en el que se alcanza el valor máximo created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
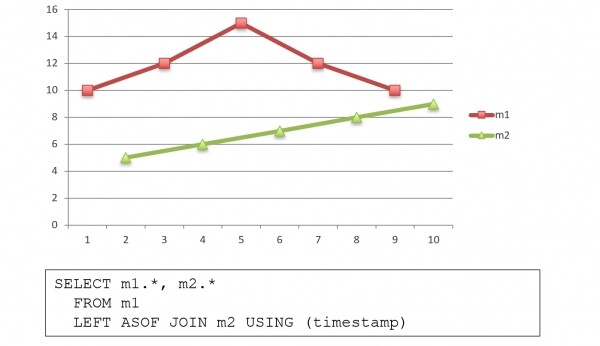
ASOF JOIN es la 'combinación' de filas con diferentes tiempos. Es una función única para bases de datos, que solo existe en kdb+. Si hay dos series temporales con diferentes tiempos, ASOF JOIN permite desplazarlas y combinarlas en una sola consulta. Para cada valor en una serie temporal se encuentra el valor más cercano en la otra, y se devuelven en una sola línea:
Funciones analíticas
En el estándar SQL-2003 se puede escribir así:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
En ClickHouse no se puede hacer así — no soporta el estándar SQL-2003 y probablemente nunca lo hará. En su lugar, ClickHouse se acostumbra escribir así:
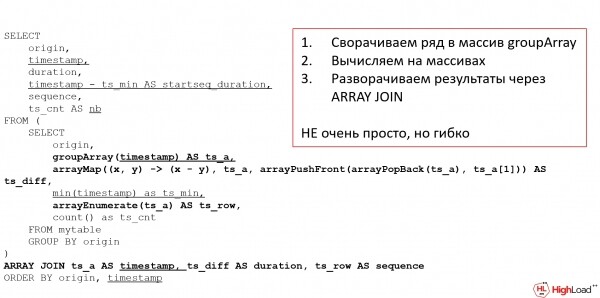
¡Prometí lambdas, aquí están!
Esto es análogo a una consulta analítica en el estándar SQL-2003: calcula la diferencia entre dos timestamp, duración, número de serie: todo lo que normalmente consideramos funciones analíticas. En ClickHouse las consideramos a través de arreglos: primero agrupamos los datos en un arreglo, luego hacemos todo lo que queremos en el arreglo y, después, lo desagrupamos. No es muy conveniente, requiere una afinidad por la programación funcional, al menos, pero es muy flexible.
Funciones especiales
Además, en ClickHouse hay muchas funciones especializadas. Por ejemplo, ¿cómo determinar cuántas sesiones están ocurriendo simultáneamente? Una tarea típica para monitoreo es determinar la carga máxima con una sola consulta. En ClickHouse hay una función especial para este propósito:
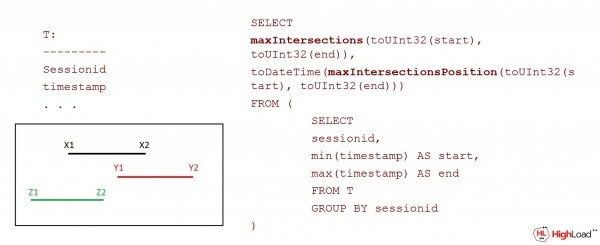
En general, para muchos propósitos en ClickHouse hay funciones especiales:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
No es una lista completa de funciones, hay alrededor de 500-600. Pista: todas las funciones en ClickHouse están en la tabla del sistema (no todas están documentadas, pero todas son interesantes):
select * from system.functions order by nameClickHouse él mismo guarda mucha información sobre sí mismo, incluyendo tablas de log, query_log, log de trazas, log de operaciones con bloques de datos (part_log), log de métricas, y un log del sistema, que normalmente escribe en disco. El log de métricas es series temporales en ClickHouse en sí mismo: ClickHouseLa base de datos puede actuar como series temporales base de datos, devorándose a sí misma.
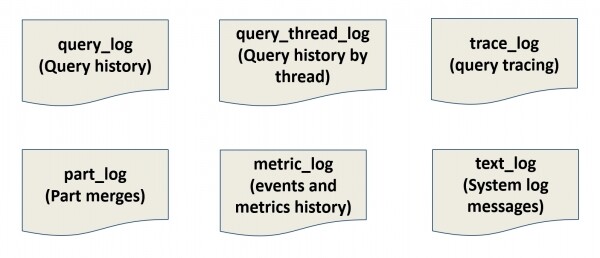
Esto también es único: dado que hacemos bien el trabajo para series temporales, ¿por qué no podemos almacenar todo lo que necesitamos en nosotros mismos? No necesitamos Prometheus, lo almacenamos todo en nosotros. Conectamos Grafana y nos monitoreamos a nosotros mismos. Sin embargo, si ClickHouse se cae, no lo veremos, — ¿por qué?, — por lo tanto, generalmente no se hace así.
¿Un gran clúster o muchos pequeños? ClickHouse
¿Qué es mejor, un gran clúster o muchos pequeños ClickHouse? El enfoque tradicional para DWH es un gran clúster, en el que se asignan esquemas para cada aplicación. Fuimos al administrador de bases de datos — danos un esquema, y nos lo dieron:
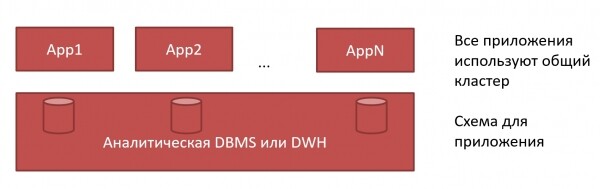
En ClickHouse se puede hacer de otra manera. Se le puede dar a cada aplicación su propio ClickHouse:
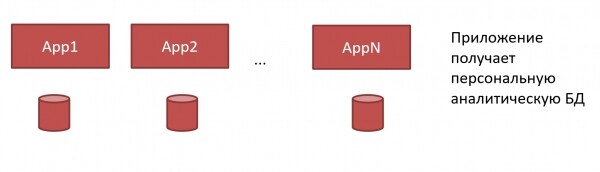
No necesitamos un gran monstruoso DWH y administradores inflexibles. Podemos darle a cada aplicación su propio ClickHouse, y el desarrollador puede hacerlo él mismo, ya que ClickHouse muy fácil de instalar y no requiere una administración complicada:
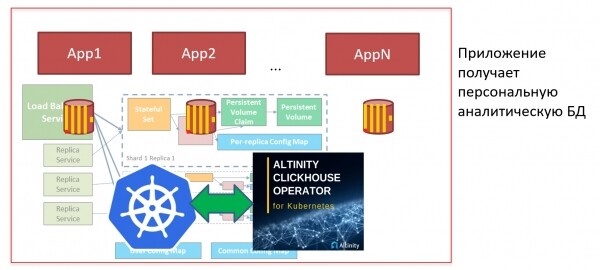
Pero si tenemos muchos ClickHouse, y hay que instalarlo con frecuencia, entonces queremos automatizar este proceso. Para eso, podemos usar Kubernetes y clickhouse-operador. En Kubernetes ClickHouse se puede instalar "con un clic": puedo presionar un botón, lanzar el manifiesto y la base de datos está lista. Puedo crear el esquema de inmediato, empezar a cargar métricas y en 5 minutos ya tengo un tablero Grafana. ¡Es así de sencillo!
¿Cuál es el resultado?
Así que, ClickHouse — es:
- Rápido. Es algo conocido por todos.
- Simplemente. Algo discutible, pero creo que lo que se aprende con dificultad, se hace fácil en la práctica. Si se entiende cómo ClickHouse funciona, todo es muy simple.
- Universalmente. Es adecuado para diferentes escenarios: DWH, Series Temporales, Almacenamiento de Registros. Pero no es una base de datos OLTP, así que no intenten hacer inserciones y lecturas cortas ahí. Interesante
- . Probablemente, quien trabaja con, ha vivido muchos momentos interesantes, en el buen y en el mal sentido. Por ejemplo, salió una nueva edición, todo dejó de funcionar. O cuando has estado trabajando en un problema durante dos días, pero después de hacer una pregunta en el chat de Telegram, se resolvió en dos minutos. O como en la conferencia, cuando en la presentación de Alexey Milovidov, una captura de pantalla de ClickHouserompió la transmisión ClickHouse . Este tipo de cosas ocurren constantemente y hacen que nuestra vida con HighLoad++.sea vibrante e interesante. ClickHouse La presentación se puede ver
La tan esperada reunión de desarrolladores de sistemas de alta carga en .
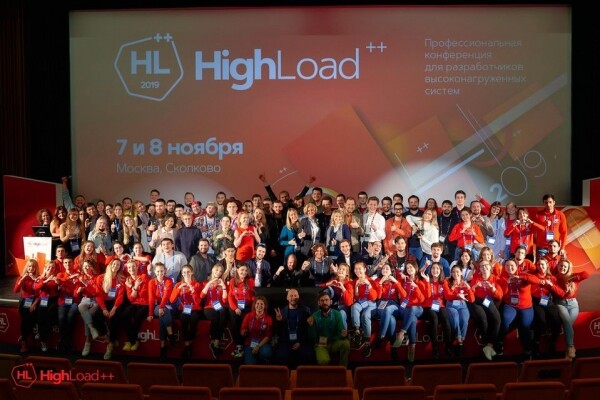
se llevará a cabo el 9 y 10 de noviembre en Skolkovo. Finalmente será una conferencia presencial (aunque con todas las medidas de seguridad), ya que la energía de HighLoad++ no se puede empaquetar en línea. Para la conferencia, encontramos y te mostramos casos sobre las posibilidades máximas de las tecnologías: HighLoad++ ha sido, es y será el único lugar donde en dos días se puede aprender cómo funcionan Facebook, Yandex, VKontakte, Google y Amazon.
Hemos llevado a cabo nuestras reuniones sin interrupciones desde 2007, y este año nos encontraremos por 14ª vez. Durante este tiempo, la conferencia ha crecido 10 veces, el año pasado el evento clave de la industria reunió a 3339 participantes, 165 oradores de charlas y meetups, y simultáneamente hubo 16 pistas.
El año pasado tuvimos 20 autobuses, 5280 litros de té y café, 1650 litros de compota y 10200 botellas de agua. Además, 2640 kilogramos de comida, 16000 platos y 25000 vasos. Por cierto, con el dinero recaudado de papel reciclado, plantamos 100 plántulas de roble 🙂
Las entradas se pueden comprar, recibir noticias sobre la conferencia — , recibir noticias sobre la conferencia — , y hablar — en todas las redes sociales: , , y .
Fuente: habr.com
