

En los días en que Kubernetes estaba aún en la versión v1.0.0, existían complementos para volúmenes (volume plugins). Estos eran necesarios para conectar sistemas de almacenamiento a Kubernetes para datos persistentes de contenedores. Su número era limitado, y entre los primeros se encontraban proveedores de almacenamiento como GCE PD, Ceph, AWS EBS, entre otros.
Los complementos venían incluidos con Kubernetes, de ahí su nombre: in-tree. Sin embargo, a muchos les parecía insuficiente el conjunto existente de estos complementos. Los ingenieros añadían complementos simples al núcleo de Kubernetes mediante parches, luego compilaban su propia versión de Kubernetes y la instalaban en sus servidores. Pero con el tiempo, los desarrolladores de Kubernetes se dieron cuenta de que no se podría resolver el problema. La gente necesitaba una herramienta mejor . Y en la versión Kubernetes v1.2.0, esta herramienta apareció...Complemento Flexvolume: una herramienta básica
Los desarrolladores de Kubernetes crearon el complemento FlexVolume, que era una envoltura lógica de variables y métodos para trabajar con los controladores de Flexvolume desarrollados por terceros.
Detengámonos y veamos más de cerca qué es un controlador FlexVolume. Es un
archivo ejecutable (archivo binario, script de Python, script de Bash, etc.), que al ejecutarse acepta argumentos de línea de comandos y devuelve un mensaje con campos conocidos en formato JSON. El primer argumento de la línea de comandos, por convención, siempre es el método, y los argumentos restantes son sus parámetros. Esquema de conexión de CIFS Shares en OpenShift. Controlador Flexvolume — justo en el centro
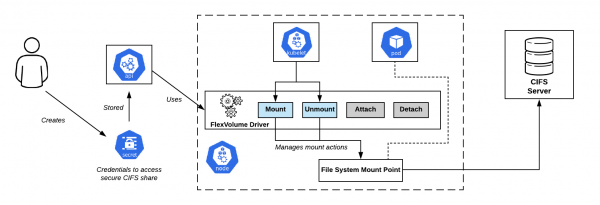
Conjunto mínimo de métodos
flexvolume_driver mount # se encarga de unir el volumen al pod # Formato del mensaje devuelto: { "status": "Success"/"Failure"/"Not supported", "message": "La razón por la cual se devolvió este estado", }flexvolume_driver unmount # se encarga de desasociar el volumen del pod # Formato del mensaje devuelto: { "status": "Success"/"Failure"/"Not supported", "message": "La razón por la cual se devolvió este estado", }flexvolume_driver init # se encarga de inicializar el complemento # Formato del mensaje devuelto: { "status": "Success"/"Failure"/"Not supported", "message": "La razón por la cual se devolvió este estado", // Indica si el controlador utiliza los métodos attach/detach "capabilities":{"attach": True/False} } se ve así:
El uso de los métodos attach detach y determinará el escenario que kubelet seguirá al invocar al controlador en el futuro. También existen métodos especiales expandvolume expandfs y expandfs, que son responsables del cambio dinámico del tamaño del volumen.
Como ejemplo de los cambios que añade el método expandfs, y junto con esto, la capacidad de realizar cambios de tamaño de volúmenes en tiempo real, se puede consultar nuestro en Rook Ceph Operator.
Aquí hay un ejemplo de implementación de un controlador Flexvolume para trabajar con NFS:
usage() {
    err "Uso inválido. Uso: "
    err "t$0 init"
    err "t$0 mount  "
    err "t$0 unmount "
    exit 1
}

err() {
    echo -ne $* 1>&2
}

log() {
    echo -ne $* >&1
}

ismounted() {
    MOUNT=`findmnt -n ${MNTPATH} 2>/dev/null | cut -d' ' -f1`
    if [ "${MOUNT}" == "${MNTPATH}" ]; then
        echo "1"
    else
        echo "0"
    fi
}

domount() {
    MNTPATH=$1

    NFS_SERVER=$(echo $2 | jq -r '.server')
    SHARE=$(echo $2 | jq -r '.share')

    if [ $(ismounted) -eq 1 ] ; then
        log '{"status": "Exito"}'
        exit 0
    fi

    mkdir -p ${MNTPATH} &>/dev/null

    mount -t nfs ${NFS_SERVER}:${SHARE} ${MNTPATH} &>/dev/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Fallo", "message": "Error al montar ${NFS_SERVER}:${SHARE} en ${MNTPATH}"}"
        exit 1
    fi
    log '{"status": "Exito"}'
    exit 0
}

unmount() {
    MNTPATH=$1
    if [ $(ismounted) -eq 0 ] ; then
        log '{"status": "Exito"}'
        exit 0
    fi

    umount ${MNTPATH} &>/dev/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Fallo", "message": "Error al desmontar volumen en ${MNTPATH}"}"
        exit 1
    fi

    log '{"status": "Exito"}'
    exit 0
}

op=$1

if [ "$op" = "init" ]; then
    log '{"status": "Exito", "capacidades": {"adjunto": false}}'
    exit 0
fi

if [ $# -lt 2 ]; then
    usage
fi

shift

case "$op" in
    mount)
        domount $*
        ;;
    unmount)
        unmount $*
        ;;
    *)
        log '{"status": "No soportado"}'
        exit 0
esac

exit 1
Así que, después de preparar el archivo ejecutable en sí, es necesario desplegar el controlador en el clúster de Kubernetes. El controlador debe estar en cada nodo del clúster según la ruta acordada previamente. Por defecto, se eligió:
/usr/libexec/kubernetes/kubelet-plugins/volume/exec/имя_поставщика_хранилища~имя_драйвера/
… pero al usar diferentes distribuciones de Kubernetes (OpenShift, Rancher…) la ruta puede ser diferente.
Problemas con Flexvolume: ¿cómo lanzar la caña correctamente?
Desplegar el controlador Flexvolume en los nodos del clúster resultó ser una tarea no trivial. Después de realizar la operación una vez manualmente, es fácil encontrarse en una situación en la que haya nuevos nodos en el clúster: debido a la adición de un nuevo nodo, escalado horizontal automático o — lo que es peor — reemplazo de un nodo debido a una falla. En este caso, trabajar con el almacenamiento en esos nodos es no es posible, hasta que usted manualmente añada el controlador Flexvolume en ellos.
La solución a este problema fue uno de los primitivas de Kubernetes — DaemonSet. Cuando se añade un nuevo nodo en el clúster, automáticamente se despliega un pod de nuestro DaemonSet, al que se conecta un volumen local en la ruta para encontrar los controladores de Flexvolume. Al crear con éxito el pod, se copian los archivos necesarios para que el controlador funcione en el disco.
Aquí hay un ejemplo de tal DaemonSet para implementar el plugin de Flexvolume:
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: flex-set
spec:
  template:
    metadata:
      name: flex-deploy
      labels:
        app: flex-deploy
    spec:
      containers:
        - image:
          name: flex-deploy
          securityContext:
              privileged: true
          volumeMounts:
            - mountPath: /flexmnt
              name: flexvolume-mount
      volumes:
        - name: flexvolume-mount
          hostPath:
            path:
… y un ejemplo de script Bash para implementar el controlador de Flexvolume:
#!/bin/sh

set -o errexit
set -o pipefail

VENDOR=k8s.io
DRIVER=nfs

driver_dir=$VENDOR${VENDOR:+"~"}${DRIVER}
if [ ! -d "/flexmnt/$driver_dir" ]; then
  mkdir "/flexmnt/$driver_dir"
fi

cp "/$DRIVER" "/flexmnt/$driver_dir/.$DRIVER"
mv -f "/flexmnt/$driver_dir/.$DRIVER" "/flexmnt/$driver_dir/$DRIVER"

while : ; do
  sleep 3600
done
Es importante no olvidar que la operación de copia no es atómica. Hay una alta probabilidad de que kubelet comience a usar el controlador antes de que el proceso de preparación se haya completado, lo que causaría un error en el funcionamiento del sistema. El enfoque correcto sería primero copiar los archivos del controlador con otro nombre, y luego utilizar una operación atómica para renombrarlos.
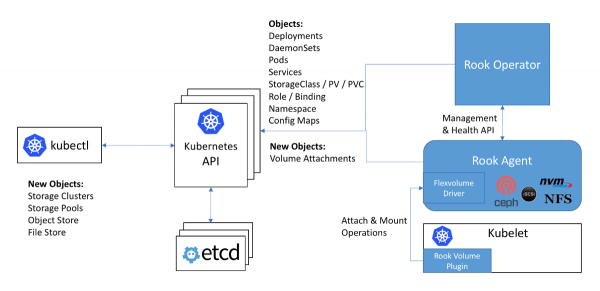
Esquema de trabajo con Ceph en el operador Rook: el controlador Flexvolume en el esquema se encuentra dentro del agente Rook
El siguiente problema al usar controladores de Flexvolume es que para la mayoría de los almacenamientos en el nodo del clúster se debe tener instalado el software necesario (por ejemplo, el paquete ceph-common para Ceph). Inicialmente, el plugin de Flexvolume no fue concebido para implementar sistemas tan complejos.
La solución original a este problema se puede ver en la implementación del controlador de Flexvolume del operador Rook:
El propio controlador está diseñado como un cliente RPC. El socket IPC para la comunicación se encuentra en el mismo directorio que el propio controlador. Recordemos que para copiar los archivos del controlador, sería conveniente usar DaemonSet, que conecta como volumen un directorio con el controlador. Después de copiar los archivos necesarios del controlador, este pod no se termina, sino que se conecta al socket IPC a través del volumen adjunto como un servidor RPC completo. El paquete ceph-common ya está instalado dentro del contenedor del pod. El socket IPC asegura que kubelet se comunique precisamente con el pod que está en el mismo nodo. ¡Todo lo genial es simple!...
¡Adiós, nuestros queridos… plugins in-tree!
Los desarrolladores de Kubernetes han descubierto que el número de plugins para almacenamiento dentro del núcleo es de veinte. Y los cambios en cada uno de ellos pasan de alguna manera por todo el ciclo de lanzamiento de Kubernetes.
Resulta que, para utilizar la nueva versión del plugin de almacenamiento, es necesario actualizar todo el clúster. Además, puedes sorprenderte al darte cuenta de que la nueva versión de Kubernetes de repente se vuelve incompatible con el núcleo de Linux que estás utilizando... Así que te secas las lágrimas y, a regañadientes, coordinas con la dirección y los usuarios el momento de la actualización del núcleo de Linux y del clúster de Kubernetes. Con la posibilidad de un tiempo de inactividad en la prestación de servicios.
La situación es más que cómica, ¿no crees? A toda la comunidad le quedó claro que este enfoque no funciona. Mediante una decisión unilateral, los desarrolladores de Kubernetes anunciaron que no se aceptarán nuevos plugins para trabajar con almacenamiento en el núcleo. Además, como ya sabemos, se han identificado una serie de fallos en la implementación del plugin Flexvolume...
El último plugin para volúmenes en Kubernetes fue llamado a resolver de una vez por todas el problema de los almacenamiento persistente: el plugin CSI. Su versión alfa, más completa, llamada Plugins de Volumen CSI Fuera de Árbol, fue anunciada en el lanzamiento .
¡Interfaz de Almacenamiento de Contenedores, o girando CSI 3000!
Primero que nada, me gustaría señalar que CSI no es solo un plugin de volumen, sino un auténtico en la creación de componentes personalizados para trabajar con almacenamiento de datos.Se suponía que los sistemas de orquestación de contenedores, como Kubernetes y Mesos, debían 'aprender' a trabajar con componentes implementados bajo este estándar. Y ahora Kubernetes ya ha aprendido.
¿Cómo está construido el plugin CSI en Kubernetes? El plugin CSI trabaja con controladores especiales (controladores CSI), escritos por desarrolladores externos. Un controlador CSI en Kubernetes debe constar mínimamente de dos componentes (pods):
- Controlador — gestiona los almacenamiento persistente externos. Se libera en forma de un servidor gRPC, para el cual se utiliza el primitivo
StatefulSet. - Nodo — se encarga de montar los almacenamiento persistente en los nodos del clúster. También se implementa en forma de un servidor gRPC, pero para el que se utiliza el primitivo
DaemonSet.
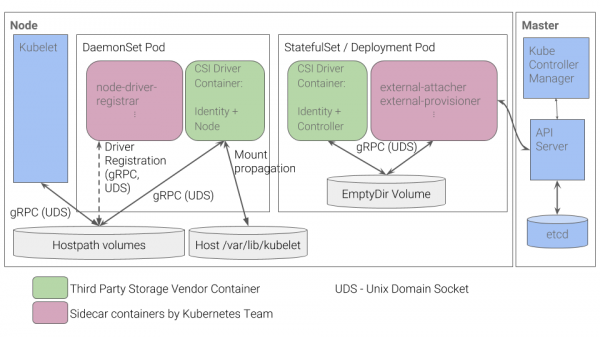
Esquema de funcionamiento del plugin CSI en Kubernetes
Sobre algunos otros detalles del funcionamiento de CSI puedes informarte, por ejemplo, en el artículo '», traducción
publicamos hace un año. Los beneficios de tal implementación.
- Para cosas básicas, como registrar un controlador para un nodo, los desarrolladores de Kubernetes implementaron un conjunto de contenedores. Ya no es necesario generar manualmente una respuesta JSON con capacidades, como se hacía para el plugin Flexvolume.
- En lugar de "inyectar" archivos ejecutables en los nodos, ahora desplegamos pods en el clúster. Esto es precisamente lo que esperamos de Kubernetes: todos los procesos ocurren dentro de contenedores desplegados mediante los primitivas de Kubernetes.
- Para implementar controladores complejos, ya no es necesario desarrollar un servidor RPC y un cliente RPC. Los desarrolladores de Kubernetes ya implementaron el cliente por nosotros.
- La transmisión de argumentos para trabajar con el protocolo gRPC es mucho más conveniente, flexible y segura que pasarlos a través de argumentos de línea de comandos. Para entender cómo agregar soporte de métricas de uso de volumen en CSI mediante la adición de un método gRPC estandarizado, se puede consultar para el controlador vsphere-csi.
- La comunicación ocurre a través de sockets IPC, para no confundir a qué pod kubelet envió la solicitud.
¿Esta lista te recuerda algo? Las ventajas de CSI son la solución a esos problemas, que no se tomaron en cuenta durante el desarrollo del plugin Flexvolume.
Conclusiones
CSI, como estándar para la implementación de plugins personalizados para interactuar con almacenes de datos, fue recibido con mucho entusiasmo por la comunidad. Además, gracias a sus ventajas y versatilidad, los controladores CSI se crean incluso para almacenes como Ceph o AWS EBS, cuyos plugins se añadieron desde la primera versión de Kubernetes.
A principios de 2019, los plugins incrustados Se planea continuar el soporte del plugin Flexvolume, pero no habrá desarrollos de nuevas funcionalidades para él.
Ya tenemos experiencia usando ceph-csi, vsphere-csi y estamos listos para añadir a esta lista. Por ahora, CSI está cumpliendo perfectamente sus tareas, y ya veremos qué nos depara el futuro.
¡No olvides que todo lo nuevo es bien pensado antiguo!
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
