

¡Hola, Habr! Les presento la traducción del artículo de los autores Burak Yavuz, Brenner Heintz y Denny Lee, que fue preparado en anticipación al inicio del curso de OTUS.
Los datos, al igual que nuestra experiencia, se acumulan y evolucionan constantemente. Para no quedarnos atrás, nuestros modelos mentales del mundo deben adaptarse a nuevos datos, algunos de los cuales contienen nuevas dimensiones: nuevas formas de observar cosas que antes no comprendíamos. Estos modelos mentales son poco diferentes de los esquemas de tablas que determinan cómo clasificamos y procesamos nueva información.
Esto nos lleva a la cuestión de la gestión de esquemas. A medida que las tareas y requisitos empresariales cambian con el tiempo, también lo hace la estructura de sus datos. Delta Lake permite implementar nuevas dimensiones a medida que los datos cambian. Los usuarios tienen acceso a una semántica sencilla para gestionar los esquemas de sus tablas. Estas herramientas incluyen la aplicación forzada de esquemas (Schema Enforcement), que protege a los usuarios de la contaminación involuntaria de sus tablas con errores o datos innecesarios, así como la evolución de esquemas (Schema Evolution), que permite agregar automáticamente nuevas columnas con datos valiosos en los lugares correspondientes. En este artículo, profundizaremos en el uso de estas herramientas.
Comprendiendo los esquemas de tablas
Cada DataFrame en Apache Spark contiene un esquema que define la forma de los datos, como los tipos de datos, las columnas y los metadatos. Con Delta Lake, el esquema de la tabla se almacena en formato JSON dentro del registro de transacciones.
¿Qué es la aplicación forzada de esquemas?
La aplicación forzada de esquemas (Schema Enforcement), también conocida como validación de esquema (Schema Validation), es un mecanismo de protección en Delta Lake que garantiza la calidad de los datos al rechazar registros que no cumplen con el esquema de la tabla. Al igual que una anfitriona en el mostrador de un restaurante popular que solo acepta reservas, verifica si cada columna de datos ingresados en la tabla está en la lista correspondiente de columnas esperadas (en otras palabras, si cada una tiene «reserva»), y rechaza cualquier registro con columnas que no están en la lista.
¿Cómo funciona la aplicación forzada de esquemas?
Delta Lake utiliza la validación de esquemas al escribir, lo que significa que todas las nuevas entradas en la tabla se comprueban para garantizar su compatibilidad con el esquema de la tabla de destino en el momento de la escritura. Si el esquema no es compatible, Delta Lake revierte completamente la transacción (los datos no se escriben) y genera una excepción para informar al usuario sobre la discrepancia.
Para determinar la compatibilidad de la escritura con la tabla, Delta Lake utiliza las siguientes reglas. DataFrame a escribir:
- no puede contener columnas adicionales que no existan en el esquema de la tabla de destino. Y viceversa, está bien si los datos entrantes no contienen todas las columnas de la tabla; estas columnas simplemente se establecerán en valores nulos.
- no puede tener tipos de datos de columnas que difieran de los tipos de datos de las columnas en la tabla de destino. Si una columna de la tabla de destino contiene datos de tipo StringType, pero la columna correspondiente en el DataFrame contiene datos de tipo IntegerType, la aplicación forzada del esquema generará una excepción y evitará que se realice la operación de escritura.
- no puede contener nombres de columnas que differencien solo en el caso. Esto significa que no puedes tener columnas con los nombres ‘Foo’ y ‘foo’ definidas en una misma tabla. Aunque Spark puede operar en modo sensible o insensible (por defecto) a mayúsculas, Delta Lake mantiene el caso, pero es insensible en el almacenamiento del esquema. Parquet es sensible al caso al almacenar y devolver la información de la columna. Para evitar posibles errores, corrupción de datos o pérdida de los mismos (lo cual hemos experimentado en Databricks), decidimos añadir esta restricción.
Para ilustrar esto, observemos lo que sucede en el siguiente código al intentar agregar algunas columnas generadas recientemente a una tabla Delta Lake que aún no ha sido configurada para aceptarlas.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
En lugar de agregar automáticamente nuevas columnas, Delta Lake impone el esquema y detiene la escritura. Para ayudar a determinar qué columna (o columnas) está causando la discrepancia, Spark imprime ambos esquemas de la traza de pila para su comparación.
¿Cuál es el beneficio de la aplicación forzada del esquema?
Dado que la aplicación forzada del esquema implica un control bastante estricto, se convierte en una excelente herramienta para servir como guardián de un conjunto de datos limpio y completamente transformado, listo para la producción o el consumo. Por lo general, se aplica a tablas que presentan datos directamente:
- Algoritmos de aprendizaje automático
- Tableros de BI
- Análisis de datos y herramientas de visualización
- Cualquier sistema de producción que requiera esquemas semánticos rigurosamente estructurados y tipados.
Para preparar sus datos para esta barrera final, muchos usuarios utilizan una arquitectura de 'multi-hop' simple, que gradualmente imprime estructura a sus tablas. Para saber más sobre esto, puede consultar el artículo
Por supuesto, la aplicación forzada del esquema se puede usar en cualquier parte de su pipeline, pero tenga en cuenta que la escritura fluida en la tabla en ese caso puede ser frustrante, debido a que, por ejemplo, olvidó que agregó otra columna a los datos de entrada.
Prevención de la dilución de datos
En este punto, puede que se pregunte, ¿cuál es todo este alboroto? Después de todo, a veces, un error inesperado de 'no coincidencia de esquema' puede poner un tropiezo en su flujo de trabajo, especialmente si es nuevo en Delta Lake. ¿Por qué simplemente no permitir que el esquema cambie como sea necesario para que pueda escribir mi DataFrame, sin importar qué?
Como dice un viejo refrán, 'una onza de prevención vale una libra de cura'. En algún momento, si no se ocupa de la aplicación de su esquema, surgirán problemas de compatibilidad de tipos de datos — fuentes de datos en bruto que parecen homogéneas pueden contener casos límite, columnas corruptas, mapeos mal formados u otras cosas horrorosas que asustan en las pesadillas. El mejor enfoque es detener a estos enemigos en la puerta — mediante la aplicación forzada del esquema — y enfrentarlos a la luz del día, y no más tarde, cuando comiencen a merodear en las oscuras profundidades de su código de trabajo.
La aplicación forzada del esquema garantiza que el esquema de su tabla no cambiará a menos que usted mismo confirme una variación. Esto previene la "dilución" de los datos, que puede ocurrir cuando se añaden columnas nuevas tan a menudo que tablas previamente valiosas y compactas pierden su significado y utilidad debido a la sobrecarga de datos. Alentarle a ser intencional, establecer altos estándares y esperar alta calidad, la aplicación forzada del esquema hace exactamente lo que fue diseñado para hacer: ayudarle a mantenerse diligente y a sus tablas a estar limpias.
Si tras reconsiderarlo usted decide que realmente necesitan desea añadir una nueva columna, no hay problema, a continuación se presenta una solución de una sola línea. ¡La solución es la evolución del esquema!
¿Qué es la evolución del esquema?
La evolución del esquema es una función que permite a los usuarios modificar fácilmente el esquema actual de la tabla conforme los datos cambian con el tiempo. Se utiliza con mayor frecuencia al ejecutar operaciones de adición o sobrescritura para adaptar automáticamente el esquema para incluir una o varias columnas nuevas.
¿Cómo funciona la evolución del esquema?
Siguiendo el ejemplo de la sección anterior, los desarrolladores pueden usar fácilmente la evolución del esquema para agregar nuevas columnas que anteriormente fueron rechazadas por no coincidir con el esquema. La evolución del esquema se activa añadiendo .option('mergeSchema', 'true') a su comando de Spark .write o .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Para ver el esquema, ejecute la siguiente consulta de Spark SQL
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 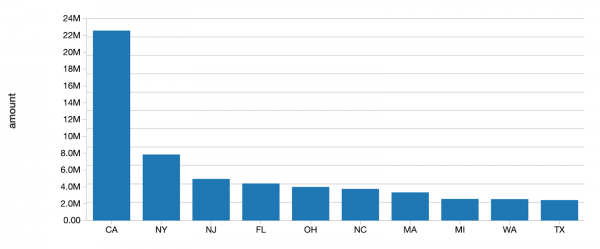
Alternativamente, puede establecer esta opción para toda la sesión de Spark añadiendo spark.databricks.delta.schema.autoMerge = True a la configuración de Spark. Pero tenga cuidado, ya que la aplicación forzada del esquema ya no le advertirá sobre discrepancias inesperadas con el esquema.
Al incluir el parámetro en la consulta mergeSchema, todas las columnas presentes en el DataFrame pero que faltan en la tabla objetivo se añadirán automáticamente al final del esquema dentro de la transacción de escritura. También se pueden añadir campos anidados, y estos también se añadirán al final de las columnas correspondientes de la estructura.
Las fechas que los ingenieros y científicos pueden utilizar esta opción para agregar nuevas columnas (posiblemente una métrica recientemente rastreada o una columna de indicadores de ventas de este mes) a sus tablas de producción de aprendizaje automático existentes, sin alterar los modelos existentes basados en columnas antiguas.
Los siguientes tipos de cambios de esquema son permitidos dentro de la evolución del esquema al agregar o sobrescribir tablas:
- Agregar nuevas columnas (este es el escenario más común)
- Cambiar tipos de datos de NullType -> cualquier otro tipo o elevar de ByteType -> ShortType -> IntegerType
Otros cambios no permitidos dentro de la evolución del esquema requieren que el esquema y los datos sean sobrescritos mediante adición .option("overwriteSchema", "true"). Por ejemplo, en el caso de que la columna 'Foo' originalmente fuera un entero, y el nuevo esquema fuera un tipo de dato de cadena, entonces todos los archivos Parquet (datos) tendrían que ser sobrescritos. Estos cambios incluyen:
- eliminar una columna
- cambiar el tipo de dato de una columna existente (en el lugar)
- renombrar columnas que solo difieren en mayúsculas y minúsculas (por ejemplo, 'Foo' y 'foo')
Finalmente, con la próxima versión de Spark 3.0 se admitirá completamente el DDL explícito (utilizando ALTER TABLE), lo que permitirá a los usuarios realizar las siguientes acciones sobre los esquemas de las tablas:
- agregar columnas
- cambiar comentarios en las columnas
- ajustar propiedades de la tabla que determinan el comportamiento de la tabla, como establecer la duración de almacenamiento del registro de transacciones.
¿Cuál es el beneficio de la evolución del esquema?
La evolución del esquema se puede utilizar siempre que usted tiene la intención de cambiar el esquema de su tabla (en contraste con los casos en que accidentalmente agregó columnas a su DataFrame que no deberían estar allí). Esta es la forma más sencilla de migrar su esquema, ya que agrega automáticamente los nombres de columnas y tipos de datos correctos sin necesidad de declararlos explícitamente.
Conclusión
La aplicación forzada del esquema rechaza cualquier nueva columna u otro cambio en el esquema que no sea compatible con su tabla. Al establecer y mantener estos altos estándares, los analistas e ingenieros pueden confiar en que sus datos tienen el más alto nivel de integridad, razonando esto de forma clara y precisa, lo que les permite tomar decisiones empresariales más efectivas.
Por otro lado, la evolución del esquema complementa la aplicación forzada, simplificando los cambios automáticos del esquema. Al final, no debería ser complicado: agregar una columna.
La aplicación forzada del esquema es el yin, mientras que la evolución del esquema es el yang. Cuando se utilizan juntas, estas funciones simplifican más que nunca la supresión de ruido y la sintonización de señales.
También nos gustaría agradecer a Mukul Murti y Pranav Anand por su contribución a este artículo.
Otros artículos de esta serie:
Artículos relacionados
Fuente: habr.com
