

TL;DR: Hace cuatro años dejé Google con la idea de una nueva herramienta para el monitoreo de servidores. La idea era combinar en un solo servicio las funciones comúnmente aisladas. y análisis de logs, recolección de métricas, y un panel de monitoreo. Uno de los principios es que el servicio debe ser verdaderamente rápido, proporcionando a los DevOps un trabajo fácil, interactivo y placentero. Esto requiere procesar conjuntos de datos de varios gigabytes en fracciones de segundo, sin exceder el presupuesto. Las herramientas existentes para trabajar con logs a menudo son lentas y torpes, por lo que nos enfrentamos a un buen desafío: diseñar correctamente una herramienta que ofrezca a los usuarios una nueva experiencia de trabajo.
En este artículo se describe cómo nosotros en Scalyr abordamos este problema, aplicando métodos de la vieja escuela, un enfoque de fuerza bruta, eliminando capas innecesarias y evitando estructuras de datos complejas. Estas lecciones pueden aplicarse a tus propios desafíos de ingeniería.
La fuerza de la vieja escuela
El análisis de logs generalmente comienza con la búsqueda: encontrar todos los mensajes que coincidan con un determinado patrón. En Scalyr esto significa decenas o cientos de gigabytes de logs de muchos servidores. Los enfoques modernos suelen implicar la construcción de una estructura de datos compleja, optimizada para la búsqueda. Por supuesto, he visto esto en Google, donde son bastante buenos en estas cosas. Pero nosotros optamos por un enfoque mucho más sencillo: el escaneo lineal de logs. Y eso funcionó: ofrecemos una interfaz de búsqueda que es orden de magnitud más rápida que la de nuestros competidores (ver animación al final).
La clave fue darse cuenta de que los procesadores modernos son realmente muy rápidos en operaciones simples y directas. Esto es fácil de pasar por alto en sistemas complejos y multicapa que dependen de la velocidad de las operaciones de I/O y de red, y esos sistemas son muy comunes hoy en día. Por lo tanto, diseñamos un enfoque que minimiza el número de capas y el desorden innecesario. Con varios procesadores y servidores en paralelo, la velocidad de búsqueda alcanza 1 TB por segundo.
Las conclusiones clave de este artículo son:
- La búsqueda brute-force es un enfoque viable para resolver problemas reales y a gran escala.
- La fuerza bruta es una técnica de diseño, no una liberación del trabajo. Al igual que cualquier técnica, se adapta mejor a algunos problemas que a otros, y puede implementarse de manera deficiente o efectiva.
- La fuerza bruta es especialmente buena para alcanzar en estado el rendimiento.
- El uso efectivo de la fuerza bruta requiere optimización del código y la aplicación oportuna de suficientes recursos. Es adecuada si tus servidores están bajo una gran carga, no relacionada con los usuarios, mientras que las operaciones de los usuarios permanecen como prioridad.
- El rendimiento depende del diseño de todo el sistema, no solo del algoritmo del ciclo interno.
(Este artículo describe la búsqueda de datos en memoria. En la mayoría de los casos, cuando un usuario realiza una búsqueda en los registros, los servidores de Scalyr ya los han almacenado en caché. En el siguiente artículo discutiremos la búsqueda en registros no almacenados en caché. Se aplican los mismos principios: código eficiente, método de fuerza bruta con grandes recursos computacionales).
Método de fuerza bruta
Tradicionalmente, la búsqueda en un gran conjunto de datos se realiza a través de un índice de palabras clave. En el caso de los registros del servidor, esto significa buscar cada palabra única en el log. Para cada palabra, se debe crear una lista de todas las apariciones. Esto permite encontrar fácilmente todos los mensajes con esa palabra, por ejemplo, ‘error’, ‘firefox’ o «transaction_16851951» — simplemente lo miramos en el índice.
Usé este enfoque en Google, y funcionó bien. Pero en Scalyr buscamos en los logs byte por byte.
¿Por qué? Desde un punto de vista algorítmico abstracto, los índices de palabras clave son mucho más eficientes que la búsqueda por fuerza bruta. Sin embargo, no vendemos algoritmos, vendemos rendimiento. Y el rendimiento no es solo algoritmos, sino también ingeniería de sistemas. Debemos tener en cuenta todo: el volumen de datos, el tipo de búsqueda, el hardware disponible y el contexto programático. Decidimos que para nuestro problema específico, una opción como 'grep' es mejor que un índice.
Los índices son excelentes, pero tienen limitaciones. Una palabra se encuentra fácilmente. Pero buscar mensajes con varias palabras, como ‘googlebot’ y ‘404’ es mucho más complicado. Buscar una frase como ‘uncaught exception’ requiere un índice más pesado, que registre no solo todos los mensajes con esa palabra, sino también la ubicación específica de la palabra.
La dificultad real surge cuando busca no palabras. Supongamos que desea ver cuánto tráfico proviene de los bots. El primer pensamiento es buscar en los registros la palabra ‘bot’. Así encontrará algunos bots: Googlebot, Bingbot y muchos otros. Pero aquí ‘bot’ no es una palabra, sino una parte de ella. Si busca ‘bot’ en el índice, no encontraremos mensajes con la palabra ‘Googlebot’. Si revisamos cada palabra en el índice y luego escaneamos el índice por las palabras clave encontradas, la búsqueda se ralentizará considerablemente. Como resultado, algunos programas para trabajar con registros no permiten buscar por partes de palabras o (en el mejor de los casos) permiten usar una sintaxis especial con un rendimiento más bajo. Queremos evitar esto.
Otro problema es la puntuación. ¿Quiere encontrar todas las consultas de 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Finalmente, los ingenieros aman las herramientas poderosas, y a veces el problema solo se puede resolver con expresiones regulares. El índice de palabras clave no es muy adecuado para esto.
Además, los índices son complejos. Cada mensaje debe agregarse a varias listas de palabras clave. Estas listas deben mantenerse constantemente en un formato fácil de buscar. Las consultas con frases, fragmentos de palabras o expresiones regulares deben traducirse en operaciones con múltiples listas, y los resultados deben escanearse y combinarse para obtener un conjunto resultante. En el contexto de un servicio multiusuario a gran escala, tal complejidad genera problemas de rendimiento que no son evidentes al analizar algoritmos.
Los índices de palabras clave también ocupan mucho espacio, y el almacenamiento es el principal costo en el sistema de gestión de registros.
Por otro lado, se puede gastar mucha potencia de cálculo en cada búsqueda. Nuestros usuarios valoran la búsqueda de alta velocidad para consultas únicas, pero tales consultas se realizan relativamente raramente. Para consultas típicas, como las del panel de control, aplicamos técnicas especiales (las describiremos en el próximo artículo). Otras consultas son lo suficientemente raras como para que rara vez se procese más de una a la vez. Pero eso no significa que nuestros servidores no estén ocupados: están sobrecargados con el trabajo de recibir, analizar y comprimir nuevos mensajes, evaluar alertas, comprimir datos antiguos, entre otros. Así, tenemos un margen considerable de procesadores que se pueden utilizar para realizar consultas.
La fuerza bruta funciona si tienes un problema grosero (y mucha fuerza).
La fuerza bruta funciona mejor en tareas simples con bucles internos pequeños. A menudo puedes optimizar el bucle interno para que funcione a velocidades muy altas. Si el código es complejo, es mucho más difícil de optimizar.
Inicialmente, nuestro código de búsqueda tenía un bucle interno bastante grande. Almacenamos mensajes en páginas de 4K; cada página contiene algunos mensajes (en UTF-8) y metadatos para cada mensaje. Los metadatos son una estructura en la que se codifican la longitud del valor, el ID interno del mensaje y otros campos. El bucle de búsqueda se veía así:
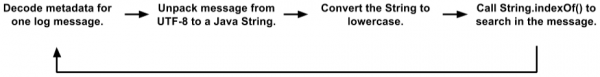
Esta es una versión simplificada en comparación con el código real. Pero incluso aquí se pueden ver varias asignaciones de objetos, copias de datos y llamadas a funciones. La JVM optimiza bastante bien las llamadas a funciones y la asignación de objetos efímeros, por lo que este código funcionó mejor de lo que merecíamos. Durante las pruebas, los clientes lo utilizaron con bastante éxito. Pero al final, pasamos a un nuevo nivel.
(Puede que se pregunte por qué almacenamos los mensajes en este formato de páginas de 4K, con texto y metadatos, en lugar de trabajar directamente con los registros. Hay muchas razones que se reducen a que internamente el motor de Scalyr se asemeja más a una base de datos distribuida que a un sistema de archivos. La búsqueda de texto a menudo se combina con filtros tipo SQL en campos después de analizar los registros. Podemos buscar simultáneamente en miles de registros a la vez, y los archivos de texto simples no son adecuados para nuestra gestión transaccional, replicada y distribuida de datos).
Inicialmente, parecía que ese código no era muy adecuado para la optimización mediante el método de fuerza bruta. "El verdadero trabajo" en String.indexOf() ni siquiera dominaba el perfil de CPU. Es decir, optimizar solo este método no habría tenido un efecto significativo.
Resultó que almacenamos los metadatos al principio de cada página, y el texto de todos los mensajes en UTF-8 está empaquetado en el otro extremo. Aprovechando eso, reescribimos el bucle para buscar en toda la página de inmediato:
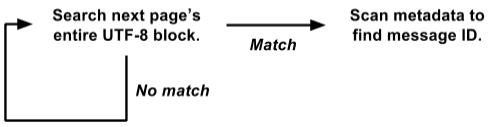
Esta versión trabaja directamente sobre la representación raw byte[] y busca todos los mensajes a la vez en toda la página de 4K.
Es mucho más fácil optimizar para el método de fuerza bruta. El bucle interno de búsqueda se llama simultáneamente para toda la página de 4K, y no por separado para cada mensaje. No hay copias de datos ni asignación de objetos. Y las operaciones más complejas con los metadatos solo se invocan cuando hay un resultado positivo, no para cada mensaje. De esta forma, eliminamos una tonelada de sobrecarga, y el resto de la carga se concentra en un pequeño bucle interno de búsqueda que es adecuado para una optimización posterior.
Nuestro algoritmo de búsqueda real se basa en . Es similar al algoritmo de Boyer-Moore con un salto aproximadamente igual a la longitud de la cadena de búsqueda en cada paso. La principal diferencia es que verifica dos bytes a la vez para minimizar las coincidencias falsas.
Nuestra implementación requiere crear una tabla de búsqueda de 64K para cada búsqueda, pero eso es trivial en comparación con los gigabytes de datos que estamos buscando. El ciclo interno procesa varios gigabytes por segundo en un solo núcleo. En la práctica, el rendimiento estable es de alrededor de 1,25 GB por segundo en cada núcleo, y hay potencial para mejorar. Se pueden eliminar algunos gastos generales fuera del ciclo interno, y planeamos experimentar con el ciclo interno en C en lugar de Java.
Aplicamos la fuerza
Discutimos que la búsqueda en los registros se puede implementar de manera "bruta", pero ¿cuánta "fuerza" tenemos? No es poco.
1 núcleo: cuando se utiliza correctamente, un núcleo moderno de procesador es bastante potente por sí mismo.
8 núcleos: actualmente estamos trabajando en servidores Amazon hi1.4xlarge y i2.4xlarge SSD, cada uno con 8 núcleos (16 hilos). Como se mencionó anteriormente, normalmente estos núcleos están ocupados con operaciones en segundo plano. Cuando un usuario realiza una búsqueda, las operaciones en segundo plano se suspenden, liberando todos los 8 núcleos para la búsqueda. La búsqueda generalmente se completa en una fracción de segundo, después de lo cual el trabajo en segundo plano se reanuda (un regulador asegura que un torrente de solicitudes de búsqueda no interrumpa las importantes tareas en segundo plano).
16 núcleos: para mayor fiabilidad organizamos los servidores en grupos master/slave. Cada maestro tiene bajo su mando un servidor SSD y uno EBS. Si el servidor principal falla, el servidor SSD asume inmediatamente su lugar. Casi todo el tiempo, el master y el slave funcionan correctamente, por lo que cada bloque de datos está disponible para búsqueda en dos servidores diferentes (el servidor subordinate EBS tiene un procesador débil, por lo que no lo consideramos). Dividimos la tarea entre ellos, por lo que tenemos disponibles un total de 16 núcleos.
Muchos núcleos: en un futuro cercano, distribuiremos los datos en los servidores de tal manera que todos participen en el procesamiento de cada solicitud no trivial. Se activará cada núcleo. [Nota: hemos implementado el plan y aumentado la velocidad de búsqueda a 1 TB/s, consulte la nota al final del artículo.].
La simplicidad asegura fiabilidad
Otra ventaja del método de fuerza bruta es el rendimiento bastante estable. Por lo general, la búsqueda no es muy sensible a los detalles de la tarea y del conjunto de datos (creo que por eso se le llama "bruta").
El índice de palabras clave a veces ofrece resultados increíblemente rápidos, pero en otros casos no. Supongamos que tiene 50 GB de registros donde el término 'customer_5987235982' aparece exactamente tres veces. La búsqueda de este término cuenta directamente desde el índice tres ubicaciones y se completa al instante. Pero una búsqueda compleja con comodines puede escanear miles de palabras clave y tomar mucho tiempo.
Por otro lado, la búsqueda por fuerza bruta para cualquier consulta se realiza con una velocidad más o menos constante. La búsqueda de palabras largas es mejor, pero incluso la búsqueda de un solo carácter ocurre con bastante rapidez.
La simplicidad del método de fuerza bruta significa que su desempeño se acerca al máximo teórico. Aquí hay menos posibilidades de sobrecargar los discos inesperadamente, conflictos de bloqueo, persecución de punteros y miles de otras causas de fallos. Simplemente miré las consultas realizadas por los usuarios de Scalyr la semana pasada en nuestro servidor más ocupado. Hubo 14,000 consultas. Exactamente ocho de ellas tardaron más de un segundo; el 99% se completó en un máximo de 111 milisegundos (si no has utilizado herramientas de análisis de registros, créeme: es rápido).
Un rendimiento estable y confiable es crucial para la usabilidad del servicio. Si se ralentiza ocasionalmente, los usuarios lo percibirán como poco fiable y lo usarán con reluctancia.
Búsqueda en los registros en acción
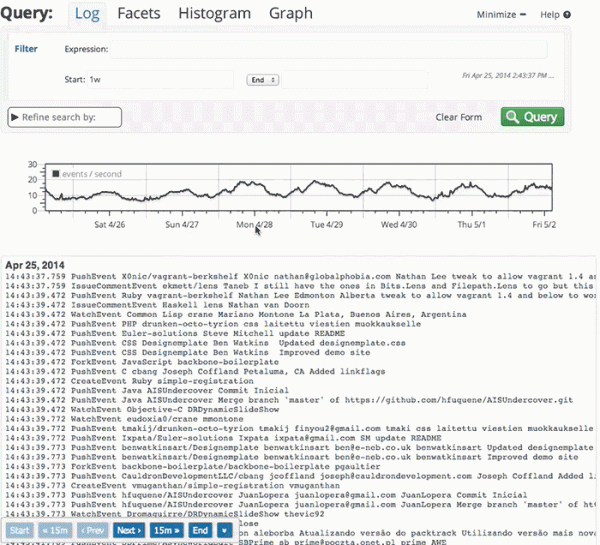
Aquí hay una pequeña animación que muestra la búsqueda de Scalyr en acción. Tenemos una cuenta de demostración donde importamos cada evento en cada repositorio público de Github. En esta demostración, reviso los datos de la semana: aproximadamente 600 MB de registros sin procesar.
El video fue grabado en vivo, sin preparación especial, en mi escritorio (a unos 5000 kilómetros del servidor). El rendimiento que verás se debe en gran parte a , así como a un backend rápido y confiable. Cada vez que hay una pausa sin un indicador de 'cargando', soy yo quien se detiene para que puedas leer lo que estoy a punto de presionar.
En conclusión
Al manejar grandes volúmenes de datos, es importante elegir un buen algoritmo, pero «bueno» no significa «extravagante». Piensa en cómo funcionará tu código en la práctica. Algunos factores que pueden ser cruciales en el mundo real se omiten del análisis teórico de algoritmos. Los algoritmos más simples son más fáciles de optimizar y son más estables en situaciones límite.
También considera el contexto en el que se ejecutará el código. En nuestro caso, se requieren servidores lo suficientemente potentes para gestionar tareas en segundo plano. Los usuarios inician búsquedas relativamente pocas veces, por lo que podemos utilizar un grupo completo de servidores durante el breve periodo necesario para cada búsqueda.
Con el método de fuerza bruta, implementamos una búsqueda rápida, confiable y flexible a través de un conjunto de registros. Esperamos que estas ideas sean útiles para tus proyectos.
Corrección: el título y el texto cambiaron de «Búsqueda a una velocidad de 20 GB por segundo» a «Búsqueda a una velocidad de 1 TB por segundo» para reflejar el aumento en el rendimiento en los últimos años. Este aumento en la velocidad se debe principalmente a la modificación del tipo y la cantidad de servidores EC2 que estamos desplegando hoy para atender a nuestra creciente base de clientes. Se esperan cambios en breve que proporcionarán otro aumento drástico en la eficiencia, y esperamos con interés poder contar más sobre ello.
Fuente: habr.com
