

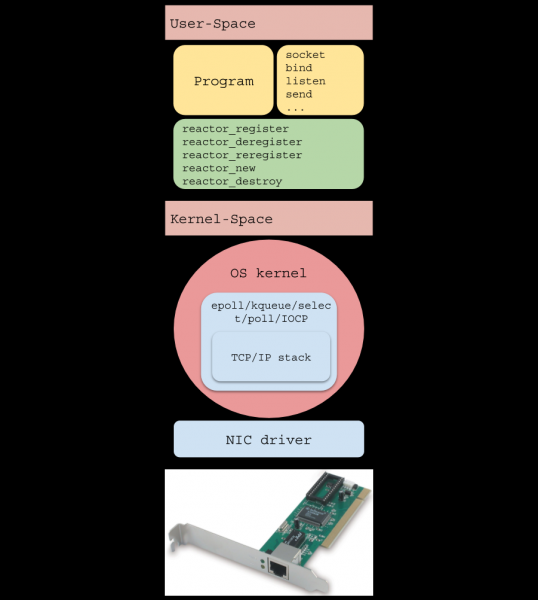
Introducción
(monohilo ) — es un patrón para escribir software de alta carga, utilizado en muchas soluciones populares:
- …
En este artículo, analizaremos los entresijos del reactor de I/O y su principio de funcionamiento, escribiremos una implementación en menos de 200 líneas de código y haremos que un simple servidor HTTP maneje más de 40 millones de solicitudes por minuto.
Prólogo
- El artículo está escrito con el propósito de ayudar a comprender el funcionamiento del reactor de I/O, lo que también implica reconocer los riesgos de su uso.
- Para entender el artículo, se requiere conocimiento básico y algo de experiencia en el desarrollo de aplicaciones de red.
- Todo el código está escrito en C estrictamente de acuerdo con (cuidado: PDF largo) para Linux y está disponible en .
¿Por qué es necesario?
Con el aumento de la popularidad de Internet, los servidores web necesitaban manejar una gran cantidad de conexiones simultáneamente, lo que llevó a probar dos enfoques: I/O bloqueante con un gran número de hilos del sistema operativo y I/O no bloqueante en combinación con un sistema de notificación de eventos, también conocido como 'selector de sistema' (///etc).
El primer enfoque implicó crear un nuevo hilo de sistema operativo para cada conexión entrante. Su desventaja es la mala escalabilidad: el sistema operativo tendrá que realizar numerosas y . Estas son operaciones costosas y pueden llevar a una falta de memoria RAM disponible con un número significativo de conexiones.
La versión modificada asigna (pool de hilos), evitando así que el sistema se detenga inesperadamente, pero al mismo tiempo introduce un nuevo problema: si en ese momento el pool de hilos está bloqueado por operaciones largas de lectura, otros sockets que ya están listos para recibir datos no podrán hacerlo.
El segundo enfoque utiliza (selector de sistema), proporcionado por el sistema operativo. Este artículo examina el tipo de selector de sistema más común, basado en notificaciones (eventos, avisos) de preparación para operaciones de I/O, en lugar de . Un ejemplo simplificado de su uso se puede representar con el siguiente diagrama de flujo:
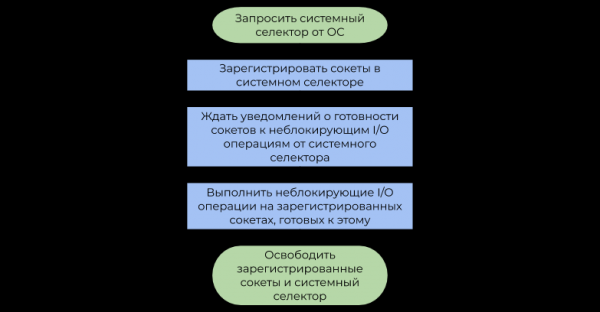
La diferencia entre estos enfoques radica en lo siguiente:
- Operaciones de E/S bloqueantes suspender el flujo del usuario hasta queel SO defragmente adecuadamente paquetes IP , recepción de datos) o no haya suficiente espacio en los búferes de escritura internos para el envío posterior a través deNIC El selector del sistema
- notificará al programa después de un tiempo que el SO ya ha defragmentado los paquetes IP (TCP, recepción de datos) o que hay suficiente espacio en los búferes de escritura internos (envío de datos). En resumen, reservar el flujo del SO para cada operación de E/S es un desperdicio de potencia de cálculo, ya que en realidad, los flujos no están ocupados en trabajo útil (de ahí proviene el término (envío de datos). «interrupción por software»
). El selector del sistema resuelve este problema, permitiendo que el programa del usuario utilice los recursos de la CPU de manera mucho más eficiente. El reactor de E/S actúa como una capa entre el selector del sistema y el código del usuario. El principio de su funcionamiento está descrito en el siguiente diagrama de flujo:
Recuerde que un evento es una notificación de que un socket específico está en condiciones de realizar una operación de E/S no bloqueante.
El manejador de eventos es una función que es invocada por el reactor de E/S al recibir un evento, que luego lleva a cabo la operación de E/S no bloqueante.
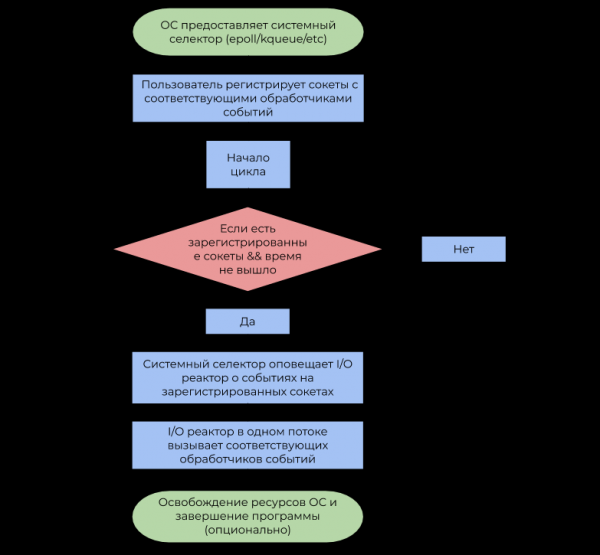
- Es importante señalar que el reactor de E/S es por definición de un solo hilo, pero no hay nada que impida usar el concepto en un entorno multihilo respecto a 1 hilo: 1 reactor, utilizando así todos los núcleos de la CPU.
- Colocaremos la interfaz pública en el archivo
reactor.h
Implementación
, y la implementación en constará de las siguientes declaraciones: . reactor.c consistirá en los siguientes anuncios:
Mostrar anuncios en reactor.h
typedef struct reactor Reactor;

/*
 * Puntero a la función que será llamada por el reactor de I/O cuando
 * ocurra un evento del selector del sistema.
 */
typedef void (*Callback)(void *arg, int fd, uint32_t events);

/*
 * Devuelve `NULL` en caso de error, un puntero `Reactor` no-`NULL` en
 * caso contrario.
 */
Reactor *reactor_new(void);

/*
 * Libera el selector del sistema, todos los sockets registrados en este momento
 * y el propio reactor de I/O.
 *
 * Las siguientes funciones devuelven -1 en caso de error, 0 en caso de éxito.
 */
int reactor_destroy(Reactor *reactor);

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg);
int reactor_deregister(const Reactor *reactor, int fd);
int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg);

/*
 * Inicia un ciclo de eventos con un tiempo de espera `timeout`.
 *
 * Esta función pasará el control al código llamador si se ha agotado
 * el tiempo asignado o/y en ausencia de sockets registrados.
 */
int reactor_run(const Reactor *reactor, time_t timeout);
La estructura del reactor de I/O consiste en un selector y , que asocia cada socket con CallbackData (estructura del manejador de eventos y argumento de usuario para él).
Mostrar Reactor y CallbackData
struct reactor {
    int epoll_fd;
    GHashTable *table; // (int, CallbackData)
};

typedef struct {
    Callback callback;
    void *arg;
} CallbackData;
Tenga en cuenta que hemos involucrado la posibilidad de tratar con a través de un puntero. En reactor.c declaramos la estructura reactor, mientras que en Mostrar declaraciones en reactor.h la definimos, impidiendo así que el usuario modifique explícitamente sus campos. Este es uno de los patrones , que se integra elegantemente en la semántica de C.
Funciones reactor_register, reactor_deregister y reactor_reregister actualizan la lista de sockets de interés y los manejadores de eventos correspondientes en el selector del sistema y en la tabla hash.
Mostrar funciones de registro
#define REACTOR_CTL(reactor, op, fd, interest)
    if (epoll_ctl(reactor->epoll_fd, op, fd,
                  &(struct epoll_event){.events = interest,
                                        .data = {.fd = fd}}) == -1) {
        perror("epoll_ctl");
        return -1;
    }

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_ADD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}

int reactor_deregister(const Reactor *reactor, int fd) {
    REACTOR_CTL(reactor, EPOLL_CTL_DEL, fd, 0)
    g_hash_table_remove(reactor->table, &fd);
    return 0;
}

int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_MOD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}
Después de que el reactor de I/O haya interceptado un evento con el descriptor fd, llama al manejador de eventos correspondiente, al que pasa fd, de eventos generados y un puntero de usuario a void.
Mostrar función reactor_run()
int reactor_run(const Reactor *reactor, time_t timeout) {
    int result;
    struct epoll_event *events;
    if ((events = calloc(MAX_EVENTS, sizeof(*events))) == NULL)
        abort();

    time_t start = time(NULL);

    while (true) {
        time_t passed = time(NULL) - start;
        int nfds =
            epoll_wait(reactor->epoll_fd, events, MAX_EVENTS, timeout - passed);

        switch (nfds) {
        // Error
        case -1:
            perror("epoll_wait");
            result = -1;
            goto cleanup;
        // Time out
        case 0:
            result = 0;
            goto cleanup;
        // Successful operation
        default:
            // Call event handlers
            for (int i = 0; i table, &fd);
                callback->callback(callback->arg, fd, events[i].events);
            }
        }
    }

cleanup:
    free(events);
    return result;
}
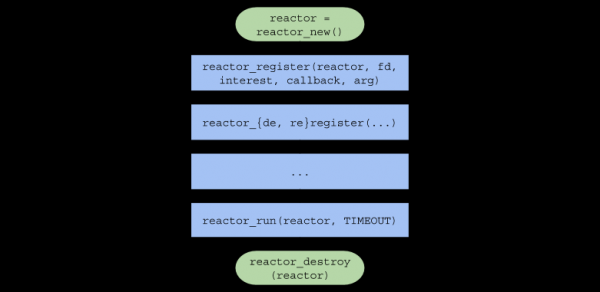
En resumen, la cadena de llamadas de funciones en el código del usuario tendrá el siguiente aspecto:
Servidor de un solo hilo
Para probar el reactor de I/O bajo alta carga, escribiremos un simple servidor web HTTP que responda con una imagen a cualquier solicitud.
Breve referencia sobre el protocolo HTTP
— es un protocolo , que se utiliza principalmente para la interacción entre el servidor y el navegador.
HTTP se puede utilizar fácilmente sobre de transporte , enviando y recibiendo mensajes en el formato definido por .
Formato de la solicitud
CRLF
CRLF
CRLF
CRLF CRLFCRLF— es una secuencia de dos caracteres:ryn, que separa la primera línea de la solicitud, los encabezados y los datos.<КОМАНДА>— uno deCONNECT,ELIMINAR,GET,HEAD,OPTIONS,PATCH,POST,PUT,TRACE. El navegador enviará a nuestro servidor el comandoGET, que significa "envíame el contenido del archivo".<URI>— . Por ejemplo, si URI =/index.html, el cliente solicita la página principal del sitio.<ВЕРСИЯ HTTP>— la versión del protocolo HTTP en formatoHTTP/X.Y. La versión más utilizada hoy en día esHTTP/1.1.<ЗАГОЛОВОК N>— es un par clave-valor en el formato:, enviado al servidor para un análisis posterior.<ДАННЫЕ>— son los datos requeridos por el servidor para llevar a cabo la operación. Frecuentemente es simplemente o cualquier otro formato.
Formato de la respuesta
CRLF
CRLF
CRLF
CRLF CRLF
<КОД СТАТУСА>— este número representa el resultado de la operación. Nuestro servidor siempre devolverá el estado 200 (operación exitosa).<ОПИСАНИЕ СТАТУСА>— una representación en cadena del código de estado. Para el código de estado 200, esOK.<ЗАГОЛОВОК N>— un encabezado del mismo formato que en la solicitud. Devolveremos encabezadosContent-Length(tamaño del archivo) yContent-Type: text/html(tipo de datos devueltos).<ДАННЫЕ>— los datos solicitados por el usuario. En nuestro caso, es la ruta a la imagen en .
Archivo (servidor de un solo hilo) incluye el archivo , que contiene los siguientes prototipos de funciones:
Mostrar prototipos de funciones en common.h
/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять новое соединение.
 */
static void on_accept(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов отправить HTTP ответ.
 */
static void on_send(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять часть HTTP запроса.
 */
static void on_recv(void *arg, int fd, uint32_t events);

/*
 * Переводит входящее соединение в неблокирующий режим.
 */
static void set_nonblocking(int fd);

/*
 * Печатает переданные аргументы в stderr и выходит из процесса с
 * кодом `EXIT_FAILURE`.
 */
static noreturn void fail(const char *format, ...);

/*
 * Возвращает файловый дескриптор сокета, способного принимать новые
 * TCP соединения.
 */
static int new_server(bool reuse_port);
También se describe el macro funcional SAFE_CALL() y se define la función fail(). El macro compara el valor de la expresión con un error, y si se cumple la condición, llama a la función fail():
#define SAFE_CALL(call, error)
    do {
        if ((call) == error) {
            fail("%s", #call);
        }
    } while (false)
La función fail() imprime los argumentos pasados en la terminal (como ) y termina el programa con el código EXIT_FAILURE:
static noreturn void fail(const char *format, ...) {
    va_list args;
    va_start(args, format);
    vfprintf(stderr, format, args);
    va_end(args);
    fprintf(stderr, ": %sn", strerror(errno));
    exit(EXIT_FAILURE);
}
La función new_server() devuelve el descriptor de archivo del socket 'servidor' creado por llamadas al sistema , y y capaz de aceptar conexiones entrantes en modo no bloqueante.
Mostrar la función new_server()
static int new_server(bool reuse_port) {
    int fd;
    SAFE_CALL((fd = socket(AF_INET, SOCK_STREAM | SOCK_NONBLOCK, IPPROTO_TCP)),
              -1);

    if (reuse_port) {
        SAFE_CALL(
            setsockopt(fd, SOL_SOCKET, SO_REUSEPORT, &(int){1}, sizeof(int)),
            -1);
    }

    struct sockaddr_in addr = {.sin_family = AF_INET,
                               .sin_port = htons(SERVER_PORT),
                               .sin_addr = {.s_addr = inet_addr(SERVER_IPV4)},
                               .sin_zero = {0}};

    SAFE_CALL(bind(fd, (struct sockaddr *)&addr, sizeof(addr)), -1);
    SAFE_CALL(listen(fd, SERVER_BACKLOG), -1);
    return fd;
}- Tenga en cuenta que el socket se crea inicialmente en modo no bloqueante utilizando la bandera
SOCK_NONBLOCK, para que en la funciónon_accept()(continuar leyendo) la llamada al sistemaaccept()no detenga la ejecución del hilo. - Si
reuse_portes igual atrue, entonces esta función configurará el socket con la opción a través de , para usar el mismo puerto en un entorno multihilo (ver sección 'Servidor multihilo').
El manejador de eventos on_accept() se llama después de que el sistema operativo genera un evento EPOLLIN, que en este caso significa que se puede aceptar una nueva conexión. on_accept() acepta una nueva conexión, la cambia a modo no bloqueante y la registra con el manejador de eventos on_recv() en el reactor de I/O.
Mostrar función on_accept()
static void on_accept(void *arg, int fd, uint32_t events) {
    int incoming_conn;
    SAFE_CALL((incoming_conn = accept(fd, NULL, NULL)), -1);
    set_nonblocking(incoming_conn);
    SAFE_CALL(reactor_register(reactor, incoming_conn, EPOLLIN, on_recv,
                               request_buffer_new()),
              -1);
}
El manejador de eventos on_recv() se llama después de que el sistema operativo genera un evento EPOLLIN, lo que significa que la conexión registrada on_accept(), está lista para aceptar datos.
on_recv() lee datos de la conexión hasta que se recibe completamente la solicitud HTTP, luego registra el manejador on_send() para enviar la respuesta HTTP. Si el cliente cierra la conexión, el socket se desregistra y se cierra mediante .
Mostrar función on_recv()
static void on_recv(void *arg, int fd, uint32_t events) {
    RequestBuffer *buffer = arg;

    // Recibiendo datos hasta que recv devuelva 0 o un error
    ssize_t nread;
    while ((nread = recv(fd, buffer->data + buffer->size,
                         REQUEST_BUFFER_CAPACITY - buffer->size, 0)) > 0)
        buffer->size += nread;

    // El cliente cerró la conexión
    if (nread == 0) {
        SAFE_CALL(reactor_deregister(reactor, fd), -1);
        SAFE_CALL(close(fd), -1);
        request_buffer_destroy(buffer);
        return;
    }

    // read devolvió un error distinto al error que bloquearía
    // el hilo
    if (errno != EAGAIN && errno != EWOULDBLOCK) {
        request_buffer_destroy(buffer);
        fail("read");
    }

    // Se recibió una solicitud HTTP completa del cliente. Ahora registramos el manejador
    // de eventos para enviar datos
    if (request_buffer_is_complete(buffer)) {
        request_buffer_clear(buffer);
        SAFE_CALL(reactor_reregister(reactor, fd, EPOLLOUT, on_send, buffer),
                  -1);
    }
}
El manejador de eventos on_send() se llama después de que el sistema operativo genera un evento EPOLLOUT, lo que significa que la conexión registrada on_recv(), está lista para enviar datos. Esta función envía la respuesta HTTP, que contiene HTML con una imagen, al cliente y cambia nuevamente el manejador de eventos a on_recv().
Mostrar función on_send()
static void on_send(void *arg, int fd, uint32_t events) {
    const char *content = "<img "
 "src="https://habrastorage.org/webt/oh/wl/23/"
                          "ohwl23va3b-dioerobq_mbx4xaw.jpeg">";
    char response[1024];
    sprintf(response,
            "HTTP/1.1 200 OK" CRLF "Content-Length: %zd" CRLF "Content-Type: "
            "text/html" DOUBLE_CRLF "%s",
            strlen(content), content);

    SAFE_CALL(send(fd, response, strlen(response), 0), -1);
    SAFE_CALL(reactor_reregister(reactor, fd, EPOLLIN, on_recv, arg), -1);
}
Y finalmente, en el archivo http_server.c, en la función main() creamos un reactor de I/O mediante reactor_new(), creamos un socket de servidor y lo registramos, iniciamos el reactor con reactor_run() exactamente por un minuto, y luego liberamos los recursos y salimos del programa.
Mostrar http_server.c
#include "reactor.h"

static Reactor *reactor;

#include "common.h"

int main(void) {
    SAFE_CALL((reactor = reactor_new()), NULL);
    SAFE_CALL(
        reactor_register(reactor, new_server(false), EPOLLIN, on_accept, NULL),
        -1);
    SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
    SAFE_CALL(reactor_destroy(reactor), -1);
}
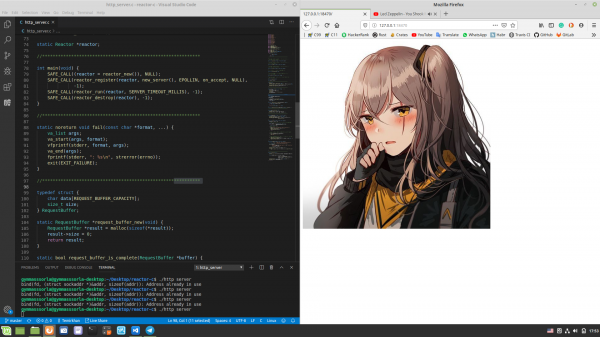
Verificamos que todo funcione correctamente. Compilamos (chmod a+x compile.sh && ./compile.sh en la raíz del proyecto) y ejecutamos el servidor casero, abrimos en el navegador y observamos lo que esperábamos:
Medición de rendimiento
Mostrar características de mi máquina
$ screenfetch
 MMMMMMMMMMMMMMMMMMMMMMMMMmds+.        OS: Mint 19.1 tessa
 MMm----::-:///////////////oymNMd+`     Kernel: x86_64 Linux 4.15.0-20-generic
 MMd      /++                -sNMd:    Uptime: 2h 34m
 MMNso/`  dMM    `.::-. .-::.` .hMN:   Packages: 2217
 ddddMMh  dMM   :hNMNMNhNMNMNh: `NMm   Shell: bash 4.4.20
     NMm  dMM  .NMN/-+MMM+-/NMN` dMM   Resolution: 1920x1080
     NMm  dMM  -MMm  `MMM   dMM. dMM   DE: Cinnamon 4.0.10
     NMm  dMM  -MMm  `MMM   dMM. dMM   WM: Muffin
     NMm  dMM  .mmd  `mmm   yMM. dMM   WM Theme: Mint-Y-Dark (Mint-Y)
     NMm  dMM`  ..`   ...   ydm. dMM   GTK Theme: Mint-Y [GTK2/3]
     hMM- +MMd/-------...-:sdds  dMM   Icon Theme: Mint-Y
     -NMm- :hNMNNNmdddddddddy/`  dMM   Font: Noto Sans 9
      -dMNs-``-::::-------.``    dMM   CPU: Intel Core i7-6700 @ 8x 4GHz [52.0°C]
       `./dMNmy+/:-------------:/yMMM   GPU: NV136
          ./ydNMMMMMMMMMMMMMMMMMMMMM   RAM: 2544MiB / 7926MiB
             .MMMMMMMMMMMMMMMMMMM
Mediremos el rendimiento de un servidor de un solo hilo. Abriremos dos terminales: en uno iniciaremos ./http_server, en el otro — . Después de un minuto, en el segundo terminal se mostrará la siguiente estadística:
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Ejecutando prueba de 1m @ http://127.0.0.1:18470
  8 hilos y 100 conexiones
  Estadísticas de Hilos   Promedio      Desviación   Máx   +/- Desviación
    Latencia   493.52us   76.70us  17.31ms   89.57%
    Req/Sec    24.37k     1.81k   29.34k    68.13%
  11657769 solicitudes en 1.00m, 1.60GB leídos
Solicitudes/seg: 193974.70
Transferencia/seg:     27.19MB
Nuestro servidor de un solo hilo pudo procesar más de 11 millones de solicitudes por minuto, provenientes de 100 conexiones. Un buen resultado, pero ¿se puede mejorar?
Servidor multihilo
Como se mencionó anteriormente, un reactor de I/O se puede crear en hilos separados, aprovechando así todos los núcleos de la CPU. Apliquemos este enfoque en la práctica:
Mostrar http_server_multithreaded.c
#include "reactor.h"

static Reactor *reactor;
#pragma omp threadprivate(reactor)

#include "common.h"

int main(void) {
#pragma omp parallel
    {
        SAFE_CALL((reactor = reactor_new()), NULL);
        SAFE_CALL(reactor_register(reactor, new_server(true), EPOLLIN,
                                   on_accept, NULL),
                  -1);
        SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
        SAFE_CALL(reactor_destroy(reactor), -1);
    }
}
Ahora cada hilo reactor:
static Reactor *reactor;
#pragma omp threadprivate(reactor)
Tenga en cuenta que el argumento de la función new_server() es true. Esto significa que asignamos al socket del servidor la opción , para utilizarlo en un entorno multihilo. Puede leer más sobre esto .
Segunda ronda
Ahora mediremos el rendimiento del servidor multihilo:
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Ejecutando prueba de 1m @ http://127.0.0.1:18470
  8 hilos y 100 conexiones
  Estadísticas de Hilos   Promedio      Desviación   Máx   +/- Desviación
    Latencia     1.14ms    2.53ms  40.73ms   89.98%
    Req/Sec    79.98k    18.07k  154.64k    78.65%
  38208400 solicitudes en 1.00m, 5.23GB leídos
Solicitudes/seg: 635876.41
Transferencia/seg:     89.14MB
La cantidad de solicitudes procesadas por minuto ha aumentado en ~3.28 veces. ¡Pero nos faltaron solo ~dos millones para llegar a un número redondo, intentemos solucionarlo!
Primero, veamos las estadísticas generadas :
$ sudo perf stat -B -e task-clock,context-switches,cpu-migrations,page-faults,cycles,instructions,branches,branch-misses,cache-misses . /http_server_multithreaded

 Estadísticas de contadores de rendimiento para '. /http_server_multithreaded':

     242446,314933      task-clock (msec)         #    4,000 CPUs utilizados
         1 813 074      context-switches          #    0,007 M/sec
             4 689      cpu-migrations            #    0,019 K/sec
               254      page-faults               #    0,001 K/sec
   895 324 830 170      cycles                    #    3,693 GHz
   621 378 066 808      instructions              #    0,69  insn por ciclo
   119 926 709 370      branches                  #  494,653 M/sec
     3 227 095 669      branch-misses             #    2,69% de todas las ramas
           808 664      cache-misses

60,604330670 segundos transcurridos, compilación con -march=native, , incremento en el número de aciertos en , aumento de MAX_EVENTS y uso de EPOLLET no ha proporcionado un aumento significativo en el rendimiento. Pero, ¿qué pasará si aumentamos la cantidad de conexiones simultáneas?
Estadísticas con 352 conexiones simultáneas:
$ wrk -c352 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Ejecutando prueba de 1m @ http://127.0.0.1:18470
  8 threads y 352 conexiones
  Estadísticas del hilo   Promedio      Desviación     Máx   + / - Desviación
    Latencia     2.12ms    3.79ms  68.23ms   87.49%
    Req/Sec    83.78k    12.69k  169.81k    83.59%
  40006142 solicitudes en 1.00m, 5.48GB leídos
Solicitudes/sec: 665789.26
Transferencia/sec:     93.34MB
Se ha obtenido el resultado deseado, junto con un gráfico interesante que muestra la dependencia del número de solicitudes procesadas por minuto con respecto a la cantidad de conexiones:
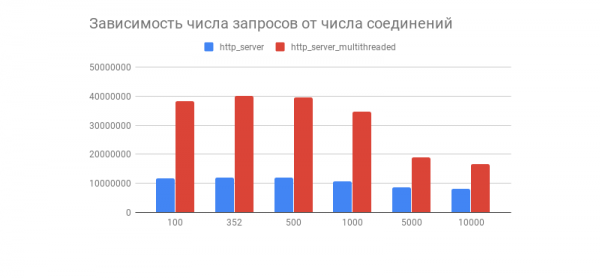
Vemos que después de un par de centenas de conexiones, el número de solicitudes procesadas por ambos servidores cae drásticamente (en el caso de la variante multihilo esto es más notorio). ¿Está esto relacionado con la implementación del stack TCP/IP de Linux? No dudes en dejar tus suposiciones sobre el comportamiento de este gráfico y las optimizaciones de las variantes multihilo y monolito en los comentarios.
¿Cómo en los comentarios, esta prueba de rendimiento no muestra el comportamiento del reactor I/O bajo cargas reales, ya que casi siempre el servidor interactúa con la base de datos, genera registros, utiliza criptografía con etc., lo que hace que la carga sea heterogénea (dinámica). Las pruebas junto con componentes de terceros se llevarán a cabo en un artículo sobre el reactor I/O.
Desventajas del reactor I/O
Es necesario entender que el reactor I/O no está exento de desventajas, a saber:
- Usar el reactor I/O en un entorno multihilo es algo más complicado, ya que se deberá gestionar manualmente los hilos.
- La práctica demuestra que, en la mayoría de los casos, la carga no es homogénea, lo que puede llevar a que un hilo esté ocupado mientras otro esté cargado de trabajo.
- Si un manejador de eventos bloquea un hilo, también se bloqueará el selector del sistema, lo que puede resultar en errores difíciles de detectar.
Estos problemas los resuelve , que a menudo tiene un planificador que distribuye uniformemente la carga en un grupo de hilos, y también cuenta con una API más conveniente. De esto se hablará más adelante en otro de mis artículos.
Conclusión
Con esto, nuestro viaje de la teoría directamente al perfilador ha llegado a su fin.
No debemos detenernos aquí, ya que existen muchos otros enfoques igualmente interesantes para escribir software de red con diferentes niveles de comodidad y velocidad. A continuación, presento enlaces interesantes, en mi opinión.
¡Hasta la próxima!
Proyectos interesantes
- C
¿Qué más leer?
Fuente: habr.com
