

El efecto de hinchamiento de tablas e índices (bloat) es bien conocido y no solo está presente en Postgres. Existen formas de lidiar con esto “de fábrica”, como VACUUM FULL o CLUSTER, pero bloquean las tablas durante su funcionamiento y por lo tanto no siempre pueden ser utilizados.
En este artículo habrá un poco de teoría sobre cómo surge el bloat, cómo se puede combatir, sobre restricciones diferidas y sobre los problemas que ellas traen al uso de la extensión pg_repack.
Este artículo está basado en PgConf.Russia 2020.
Por qué ocurre el bloat
La base de Postgres se fundamenta en un modelo de múltiples versiones (). Su esencia es que cada fila en la tabla puede tener varias versiones, mientras que las transacciones ven no más de una de estas versiones, pero no necesariamente la misma. Esto permite que varias transacciones funcionen al mismo tiempo y prácticamente no se influyan entre sí.
Es obvio que todas estas versiones deben ser almacenadas. Postgres trabaja con la memoria por páginas y una página es el volumen mínimo de datos que se puede leer del disco o escribir. Veamos un pequeño ejemplo para entender cómo sucede esto.
Supongamos que tenemos una tabla a la que hemos añadido varias entradas. En la primera página del archivo donde se almacena la tabla, han aparecido nuevos datos. Estas son las versiones activas de las filas, que están disponibles para otras transacciones tras el commit (para simplificar, supongamos que el nivel de aislamiento es Read Committed).
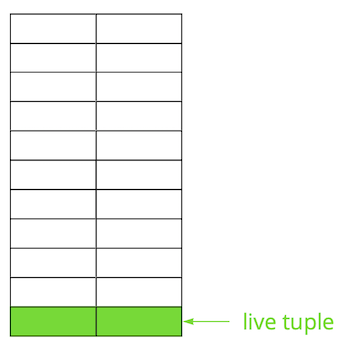
Luego actualizamos una de las entradas, marcando así la versión antigua como no válida.
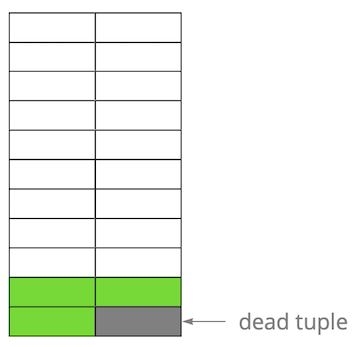
Paso a paso, al actualizar y eliminar versiones de filas, obtenemos una página en la que aproximadamente la mitad de los datos son “basura”. Estos datos no son visibles para ninguna transacción.
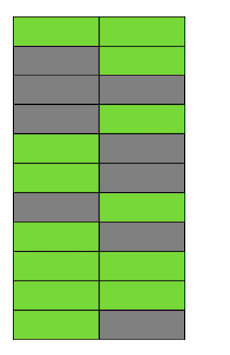
En Postgres existe un mecanismo , que elimina las versiones no válidas y libera espacio para nuevos datos. Sin embargo, si no está configurado lo suficientemente agresivamente o está ocupado realizando trabajos en otras tablas, los “datos basura” permanecen, y tenemos que utilizar páginas adicionales para nuevos datos.
Así, en nuestro ejemplo, en algún momento la tabla consistirá en cuatro páginas, pero solo la mitad de los datos serán válidos. Como resultado, al acceder a la tabla, estaríamos leyendo muchos más datos de los necesarios.
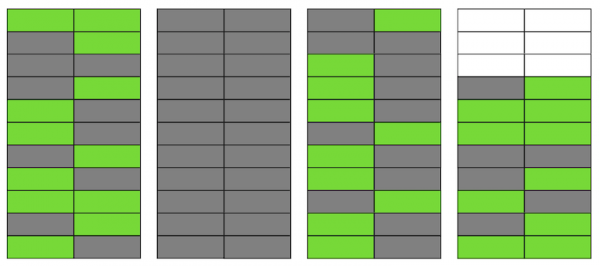
Incluso si VACUUM elimina todas las versiones obsoletas de las filas ahora, la situación no mejorará drásticamente. Tendremos espacio libre en las páginas o incluso páginas enteras para nuevas filas, pero aún así estaremos leyendo más datos de los necesarios.
Por cierto, si una página completamente vacía (la segunda en nuestro ejemplo) estuviera al final del archivo, VACUUM podría cortarla. Pero ahora está en medio, por lo que no se puede hacer nada con ella.
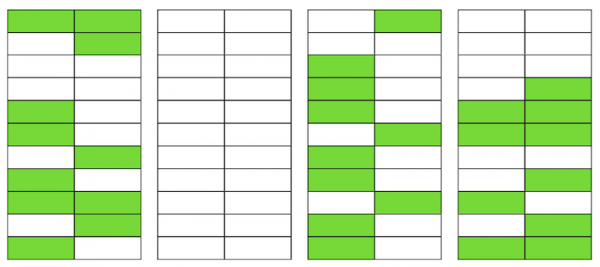
Cuando la cantidad de páginas vacías o muy dispersas se vuelve grande, lo que se llama bloat, esto comienza a afectar el rendimiento.
La mecánica del bloat en las tablas es como se describió anteriormente. En los índices sucede de manera similar.
¿Tengo bloat?
Hay varias formas de determinar si tienes bloat. La idea del primero es usar las estadísticas internas de Postgres, que contienen información aproximada sobre la cantidad de filas en las tablas, el número de filas 'vivas', etc. En internet se pueden encontrar muchas variaciones de scripts ya listos. Nosotros tomamos como base de PostgreSQL Experts, que puede evaluar el bloat de las tablas junto con toast y el bloat de los índices btree. Según nuestra experiencia, su margen de error es del 10-20%.
Otra forma es usar la extensión , que permite mirar dentro de las páginas y obtener tanto una estimación como un valor exacto del bloat. Pero en el segundo caso, será necesario escanear toda la tabla.
Un pequeño valor de bloat, hasta el 20%, lo consideramos aceptable. Se puede considerar como un análogo del fillfactor para y . Con un 50% o más, pueden comenzar a aparecer problemas de rendimiento.
Métodos para combatir el bloat
En Postgres hay varias formas de combatir el bloat 'de serie', sin embargo, no siempre son adecuadas para todos.
Configurar AUTOVACUUM para que no se produzca bloat. Y si se quiere ser más preciso, para que se mantenga a un nivel aceptable para usted. Parece un consejo “de capitán”, pero en realidad no siempre es fácil de lograr. Por ejemplo, si está realizando un desarrollo activo con cambios regulares en el esquema de datos o si está llevando a cabo alguna migración de datos. Como consecuencia, su perfil de carga puede cambiar con frecuencia y, por lo general, varía para diferentes tablas. Esto significa que necesita trabajar constantemente un poco por adelantado y ajustar AUTOVACUUM al perfil cambiante de cada tabla. Pero es evidente que hacerlo no es sencillo.
Otra causa común de que AUTOVACUUM no pueda procesar las tablas es la presencia de transacciones prolongadas que le impiden limpiar los datos debido a que están disponibles para estas transacciones. La recomendación aquí también es evidente: deshacerse de las transacciones “pendientes” y minimizar el tiempo de las transacciones activas. Sin embargo, si la carga de su aplicación es un híbrido de OLAP y OLTP, entonces puede tener al mismo tiempo muchas actualizaciones frecuentes y consultas cortas, así como operaciones prolongadas, como la elaboración de un informe. En tal situación, vale la pena considerar distribuir la carga en diferentes bases de datos, lo que permitirá una configuración más detallada de cada una.
Otro ejemplo: incluso si el perfil es homogéneo, pero la base de datos está bajo una carga muy alta, incluso el AUTOVACUUM más agresivo puede no ser suficiente, y seguirá ocurriendo el bloat. La escalabilidad (ya sea vertical u horizontal) es la única solución.
¿Qué hacer en una situación en la que ha configurado AUTOVACUUM, pero el bloat sigue creciendo?
Comando VACUUM FULL reconstruye el contenido de las tablas e índices y deja solo los datos actuales. Funciona a la perfección para eliminar el bloat, pero durante su ejecución se requiere de un bloqueo exclusivo en la tabla (AccessExclusiveLock), lo que impide realizar consultas en esta tabla, incluso selects. Si puede permitirse detener su servicio o parte de él por un tiempo (de decenas de minutos a varias horas, dependiendo del tamaño de la base de datos y su hardware), entonces esta opción es la mejor. Lamentablemente, no podemos ejecutar VACUUM FULL en el tiempo planificado de mantenimiento, por lo que este método no es adecuado para nosotros.
Comando CLUSTER también reorganiza el contenido de las tablas, al igual que VACUUM FULL, permitiendo especificar un índice según el cual los datos se ordenarán físicamente en el disco (pero en el futuro el orden no está garantizado para nuevas filas). En ciertas situaciones, esto es una buena optimización para una serie de consultas, particularmente con la lectura de varios registros a través del índice. La desventaja del comando es la misma que la de VACUUM FULL: bloquea la tabla durante su ejecución.
Comando REINDEX es similar a las dos anteriores, pero lleva a cabo la reconstrucción de un índice específico o de todos los índices de la tabla. Los bloqueos son un poco más leves: ShareLock en la tabla (impide modificaciones, pero permite realizar select) y AccessExclusiveLock en el índice que se está reconstruyendo (bloquea las consultas que utilizan este índice). Sin embargo, en la versión 12 de Postgres se introdujo un parámetro , que permite reconstruir el índice sin bloquear la adición, modificación o eliminación de registros en paralelo.
En versiones anteriores de Postgres, se puede lograr un resultado similar a REINDEX CONCURRENTLY mediante . Permite crear un índice sin bloqueos estrictos (ShareUpdateExclusiveLock, que no interfiere con las consultas paralelas), luego reemplazar el índice antiguo por el nuevo y eliminar el índice antiguo. Esto ayuda a eliminar el bloat de los índices sin interrumpir el funcionamiento de su aplicación. Es importante tener en cuenta que, al reconstruir índices, habrá una carga adicional en el subsistema de disco.
Así, si hay formas de eliminar el bloat de los índices 'en caliente', no existe tal manera para las tablas. Aquí es donde entran en juego varias extensiones externas: (anteriormente pg_reorg), , y otras. En este artículo no las compararé y solo hablaré sobre pg_repack, que, después de algunos ajustes, estamos utilizando.
Cómo funciona pg_repack
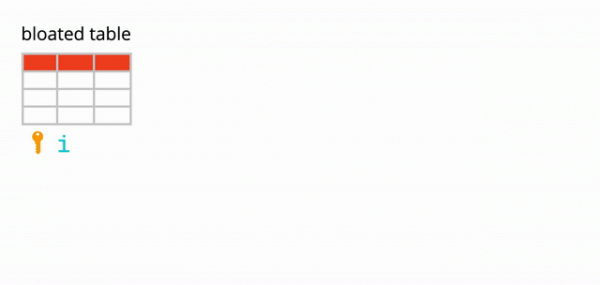
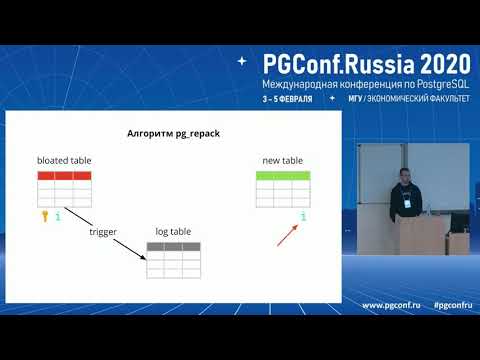
Supongamos que tenemos una tabla bastante normal, con índices, restricciones y, desafortunadamente, con bloat. El primer paso de pg_repack es crear una tabla de registro para almacenar datos sobre todos los cambios durante su funcionamiento. Un trigger replicará estos cambios en cada inserción, actualización y eliminación. Luego, se crea una tabla que es similar a la original en cuanto a estructura, pero sin índices ni restricciones, para no ralentizar el proceso de inserción de datos.
Luego, pg_repack transfiere los datos de la tabla antigua a una nueva, filtrando automáticamente todas las filas obsoletas y luego crea índices para la nueva tabla. Durante la ejecución de todas estas operaciones, los cambios se acumulan en la tabla de registros.
El siguiente paso es transferir los cambios a la nueva tabla. La transferencia se realiza en varias iteraciones y, cuando quedan menos de 20 registros en la tabla de registros, pg_repack toma un bloqueo estricto, transfiere los últimos datos y reemplaza la tabla antigua por la nueva en las tablas del sistema de Postgres. Este es el único y muy breve momento en el que no podrás trabajar con la tabla. Después de esto, la tabla antigua y la tabla de registros se eliminan y se libera espacio en el sistema de archivos. El proceso ha finalizado.
En teoría, todo parece excelente, ¿pero qué hay de la práctica? Probamos pg_repack sin carga y con carga, verificamos su funcionamiento en caso de interrupción prematura (en otras palabras, presionando Ctrl+C). Todas las pruebas fueron positivas.
Nos dirigimos al entorno de producción, y aquí todo salió diferente a lo esperado.
El primer tropiezo en producción
En el primer clúster, obtuvimos un error de violación de restricción única:
$ ./pg_repack -t tablename -o id
INFO: reempaquetando tabla "tablename"
ERROR: la consulta falló:
    ERROR: el valor de clave duplicado viola la restricción única "index_16508"
DETALLE: La clave (id, index)=(100500, 42) ya existe.
Esta restricción tenía un nombre autogenerado index_16508, creado por pg_repack. Por los atributos que la componen, identificamos la restricción que corresponde. El problema resultó ser que no era una restricción común, sino diferida (), es decir, su verificación se realiza más tarde que el comando SQL, lo que conduce a consecuencias inesperadas.
Restricciones diferidas: para qué sirven y cómo funcionan
Un poco de teoría sobre las restricciones diferidas.
Consideremos un ejemplo simple: tenemos una tabla de referencia de automóviles con dos atributos: nombre y orden del automóvil en la referencia.
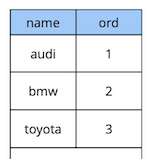
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Supongamos que necesitamos intercambiar el primer y el segundo automóvil. La solución "directa" es actualizar el primer valor al segundo y el segundo al primero:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Pero al ejecutar este código, predeciblemente obtendremos una violación de la restricción, porque el orden de los valores en la tabla es único:
[23305] ERROR: el valor de la clave duplicada viola la restricción única “uk_cars”
Detalle: La clave (ord)=(2) ya existe.
¿Cómo hacerlo de otra manera? Opción uno: añadir un valor de orden adicional que definitivamente no exista en la tabla, por ejemplo “-1”. En programación, esto se llama “intercambiar los valores de dos variables a través de una tercera”. La única desventaja de este método es la actualización adicional.
Opción dos: rediseñar la tabla para utilizar un tipo de dato de punto flotante para el valor del orden en lugar de enteros. Entonces, al actualizar un valor de 1, por ejemplo, a 2.5, el primer registro automáticamente ocupará la posición entre el segundo y el tercero. Esta solución es efectiva, pero hay dos limitaciones. En primer lugar, no será adecuada si el valor se utiliza en alguna parte de la interfaz. En segundo lugar, dependiendo de la precisión del tipo de dato, tendrás un número limitado de inserciones posibles antes de tener que recalcular los valores de todos los registros.
Opción tres: hacer la restricción aplazada, para que solo se verifique en el momento del commit:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Dado que la lógica de nuestra consulta inicial garantiza que para el momento del commit todos los valores son únicos, se ejecutará correctamente.
El ejemplo discutido anteriormente, por supuesto, es muy sintético, pero revela la idea. En nuestra aplicación, utilizamos restricciones retrasadas para implementar la lógica responsable de resolver conflictos cuando múltiples usuarios trabajan simultáneamente con objetos-widget compartidos en el tablero. El uso de estas restricciones nos permite simplificar un poco el código de la aplicación.
En general, dependiendo del tipo de restricción en Postgres, existen tres niveles de granularidad en su verificación: nivel de fila, de transacción y de expresión.
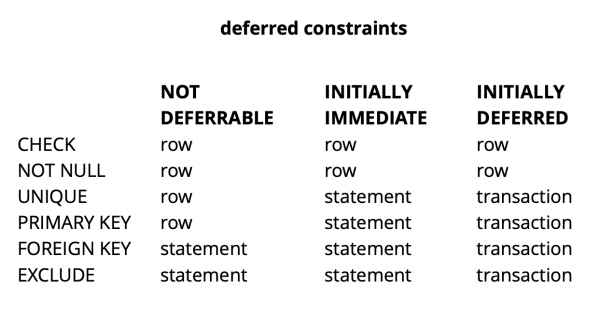
Fuente:
CHECK y NOT NULL siempre se verifican a nivel de fila; para las demás restricciones, como se puede ver en la tabla, hay diferentes opciones. Se puede leer más al respecto. .
En resumen, las restricciones diferidas en ciertas situaciones permiten un código más legible y un menor número de comandos. Sin embargo, esto conlleva una complicación en el proceso de depuración, ya que el momento en que ocurre un error y el momento en que te enteras de él están separados en el tiempo. Otro posible problema es que el planificador no siempre puede construir un plan óptimo si hay una restricción diferida en la consulta.
Mejora de pg_repack
Hemos comprendido qué son las restricciones diferidas, pero, ¿cómo están relacionadas con nuestro problema? Recordemos el error que recibimos anteriormente:
$ ./pg_repack -t tablename -o id
INFO: reempaquetando tabla "tablename"
ERROR: la consulta falló:
    ERROR: el valor de clave duplicado viola la restricción única "index_16508"
DETALLE: La clave (id, index)=(100500, 42) ya existe.
Ocurre en el momento de copiar datos de la tabla de registro a una nueva tabla. Esto parece extraño, ya que los datos en la tabla de registro se confirman junto con los datos de la tabla original. Si cumplen con las restricciones de la tabla original, ¿cómo pueden violar las mismas restricciones en la nueva?
Resulta que la raíz del problema se encuentra en el paso anterior del funcionamiento de pg_repack, donde solo se crean índices, pero no restricciones: en la tabla antigua había una restricción única, y en la nueva en su lugar se creó un índice único.
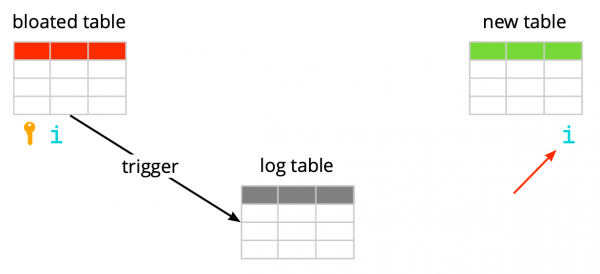
Es importante notar que si la restricción es normal y no diferida, entonces el índice único creado en su lugar es equivalente a esa restricción, ya que las restricciones únicas en Postgres se implementan mediante la creación de un índice único. Pero en el caso de una restricción diferida, el comportamiento no es el mismo, porque el índice no puede ser diferido y siempre se verifica en el momento de la ejecución del comando SQL.
Así, la esencia del problema radica en la 'diferibilidad' de la verificación: en la tabla original ocurre en el momento del commit, mientras que en la nueva ocurre en el momento de la ejecución del comando SQL. Por lo tanto, necesitamos hacer que las verificaciones se realicen de manera idéntica en ambos casos: ya sea siempre diferidas o siempre de inmediato.
Entonces, ¿qué ideas tenemos?
Crear un índice similar al diferido
La primera idea es realizar ambas verificaciones en modo inmediato. Esto puede generar algunos falsos positivos en la restricción, pero si son pocos, no debería afectar la experiencia de los usuarios, ya que para ellos esos conflictos son situaciones normales. Ocurren, por ejemplo, cuando dos usuarios comienzan a editar el mismo widget al mismo tiempo, y el cliente del segundo usuario no llega a recibir la información de que el widget ya está bloqueado para ser editado por el primer usuario. En tal situación, el servidor responde al segundo usuario con un rechazo, y su cliente revierte los cambios y bloquea el widget. Un poco más tarde, cuando el primer usuario termine la edición, el segundo recibirá información de que el widget ya no está bloqueado y podrá repetir su acción.
Para que las verificaciones estén siempre en modo urgente, creamos un nuevo índice, similar al original de restricción diferida:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- ejecutar pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
En el entorno de pruebas obtuvimos solo unos pocos errores esperados. ¡Éxito! Volvimos a ejecutar pg_repack en producción y obtuvimos 5 errores en el primer clúster durante una hora de trabajo. Este es un resultado aceptable. Sin embargo, ya en el segundo clúster, la cantidad de errores aumentó drásticamente y tuvimos que detener pg_repack.
¿Por qué sucedió esto? La probabilidad de error depende de cuántos usuarios estén trabajando al mismo tiempo con los mismos widgets. Al parecer, en ese momento había muchos menos cambios competitivos en los datos almacenados en el primer clúster que en los demás, es decir, simplemente tuvimos “suerte”.
La idea no funcionó. En ese momento, vimos otras dos opciones de solución: reescribir nuestro código de aplicación para eliminar las restricciones diferidas, o “enseñar” a pg_repack a trabajar con ellas. Elegimos la segunda.
Reemplazar los índices en la nueva tabla por las restricciones diferidas de la tabla original.
El objetivo de la modificación era evidente: si la tabla original tiene una restricción diferida, entonces la nueva debe crear tal restricción y no un índice.
Para verificar nuestros cambios, escribimos una prueba simple:
- una tabla con una restricción diferida y un registro;
- insertamos en un bucle datos que entran en conflicto con el registro existente;
- realizamos una actualización – los datos ya no entran en conflicto;
- confirmamos los cambios.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
La versión original de pg_repack siempre fallaba en la primera inserción, la versión revisada funcionó sin errores. Excelente.
Vamos a producción y nuevamente recibimos un error en la misma fase de copia de datos de la tabla de logs a la nueva:
$ ./pg_repack -t tablename -o id
INFO: reempaquetando tabla "tablename"
ERROR: la consulta falló:
    ERROR: el valor de clave duplicado viola la restricción única "index_16508"
DETALLE: La clave (id, index)=(100500, 42) ya existe.
Situación clásica: en los entornos de prueba todo funciona, ¡pero en producción no?!
APPLY_COUNT y el cruce de dos lotes
Comenzamos a analizar el código línea por línea y descubrimos un aspecto importante: la transferencia de datos de la tabla de logs a la nueva se realiza en lotes, la constante APPLY_COUNT indicaba el tamaño del lote:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* puede que todavía haya algunas tuplas, repetimos. */
...
}
El problema es que los datos de la transacción original, donde varias operaciones pueden potencialmente violar la restricción, al transferirse pueden caer en el cruce de dos lotes: la mitad de los comandos se confirmarán en el primer lote, y la otra mitad en el segundo. Y aquí depende de la suerte: si los comandos en el primer lote no violan nada, todo está bien, pero si violan, ocurre un error.
APPLY_COUNT es igual a 1000 registros, lo que explica por qué nuestras pruebas pasaron con éxito: no cubrieron el caso de "cruce de lotes". Utilizamos dos comandos: insert y update, por lo que exactamente 500 transacciones de dos comandos siempre se colocaban en el lote y no tuvimos problemas. Tras añadir el segundo update, nuestra modificación dejó de funcionar:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- una actualización más
    COMMIT;
  END;
END LOOP;
Por lo tanto, el siguiente objetivo es asegurarnos de que los datos de la tabla original, que se modificaban en una transacción, también se transfieran a la nueva tabla dentro de una sola transacción.
Abandono del batch
Y una vez más teníamos dos opciones para la solución. La primera: abandonemos por completo la división en lotes y hagamos la transferencia de datos en una sola transacción. La simplicidad de esta solución era su ventaja: los cambios de código requeridos son mínimos (por cierto, en versiones más antiguas, pg_reorg funcionaba precisamente así). Pero hay un problema: creamos una transacción prolongada, y esto, como se mencionó anteriormente, representa una amenaza para la aparición de nuevo bloat.
La segunda solución es más complicada, pero probablemente más correcta: crear en la tabla de registro una columna con el identificador de la transacción que agregó los datos a la tabla. Entonces, al copiar los datos, podremos agruparlos según este atributo y garantizar que los cambios relacionados se transfieran juntos. El lote se formará a partir de varias transacciones (o una grande) y su tamaño variará dependiendo de cuántos datos se modificaron en esas transacciones. Es importante señalar que, dado que los datos de diferentes transacciones llegan a la tabla de registro en un orden aleatorio, ya no será posible leerla secuencialmente, como antes. seqscan en cada consulta con filtrado por tx_id – es demasiado costoso, se necesita un índice, pero eso también ralentizará el método debido a los costos de actualización. En resumen, como siempre, hay que sacrificar algo.
Así que decidimos comenzar con la primera opción, que es la más simple. Primero, teníamos que entender si la transacción prolongada sería realmente un problema. Dado que la transferencia principal de datos de la tabla antigua a la nueva también se lleva a cabo en una sola transacción prolongada, la cuestión se transformó en "¿cuánto aumentaremos esta transacción?" La duración de la primera transacción depende en gran medida del tamaño de la tabla. La duración de la nueva dependerá de cuántos cambios se acumulen en la tabla durante la transferencia de datos, es decir, de la intensidad de la carga. La ejecución de pg_repack se realizó durante la mínima carga en el servicio, y el volumen de cambios fue insignificante en comparación con el volumen original de la tabla. Decidimos que podríamos ignorar el tiempo de la nueva transacción (para comparación, en promedio son 1 hora y 2-3 minutos).
Los experimentos fueron positivos. El lanzamiento en producción también. Para ilustrar, aquí hay una imagen con el tamaño de una de las bases después de la ejecución:
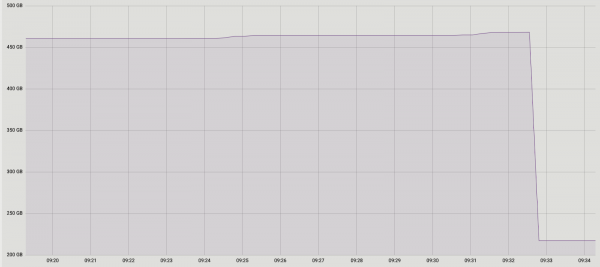
Dado que esta solución nos satisface completamente, no intentamos implementar una segunda, pero consideramos la posibilidad de discutirla con los desarrolladores de la extensión. Nuestra mejora actual, lamentablemente, aún no está lista para su publicación, ya que solo resolvimos el problema con las restricciones diferidas únicas, y para un parche completo es necesario soportar otros tipos. Esperamos poder hacerlo en el futuro.
Es posible que te estés preguntando por qué nos involucramos en esta historia de mejora de pg_repack, en lugar de utilizar sus alternativas. En algún momento también pensamos en esto, pero la experiencia positiva de su uso anterior, en tablas sin restricciones diferidas, nos motivó a intentar comprender la raíz del problema y solucionarlo. Además, el uso de otras soluciones también requiere tiempo para realizar pruebas, por lo que decidimos que primero intentaríamos resolver el problema en este, y si entendemos que no podemos hacerlo en un tiempo razonable, entonces empezaremos a considerar alternativas.
Conclusiones
Lo que podemos recomendar basado en nuestra experiencia:
- Monitorea tu bloat. Con los datos de monitoreo, podrás entender qué tan bien está configurado el autovacuum.
- Configura AUTOVACUUM para mantener el bloat en un nivel aceptable.
- Si el bloat sigue creciendo y no puedes solucionarlo con herramientas 'listas para usar', no dudes en utilizar extensiones externas. Lo principal es probar todo bien.
- No temas personalizar soluciones externas para tus necesidades; a veces puede ser más eficiente e incluso más fácil que modificar tu propio código.
Fuente: habr.com
