

¡Feliz viernes a todos! Cada vez queda menos tiempo para el lanzamiento del curso , por lo que hoy compartimos la traducción de otro material útil sobre el tema.
En el proceso de desarrollo se ha realizado un trabajo impresionante para mejorar la partición de tablas. Particionamiento de tablas — es una función que ha existido en PostgreSQL durante bastante tiempo, pero que, por así decirlo, prácticamente no existía hasta la versión 10, en la que se convirtió en una función muy útil. Antes afirmamos que la herencia de tablas era nuestra implementación de partición, y eso es cierto. Solo que este método te obligaba a hacer gran parte del trabajo manualmente. Por ejemplo, si querías que los tuplas se insertaran en secciones durante los INSERT, tenías que configurar disparadores para que lo hicieran por ti. La partición mediante herencia era muy lenta y complicada para desarrollar funciones adicionales sobre ella.
En PostgreSQL 10 vimos el nacimiento de la «partición declarativa» — una función diseñada para resolver muchos problemas que eran insolucionables utilizando el antiguo método de herencia. Esto dio lugar a una herramienta mucho más poderosa, permitiéndonos dividir datos de manera horizontal.
Comparación de características
En PostgreSQL 11 se presentó un impresionante conjunto de nuevas características que ayudan a mejorar el rendimiento y hacen que las tablas particionadas sean más transparentes para las aplicaciones.
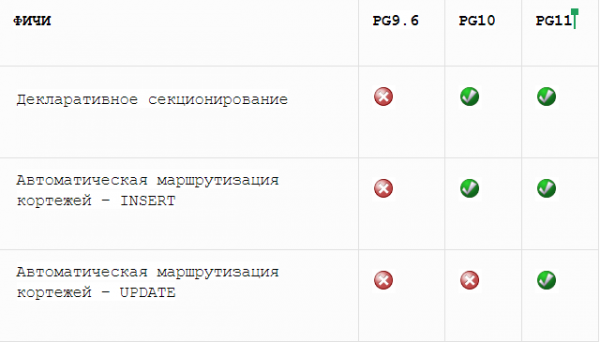
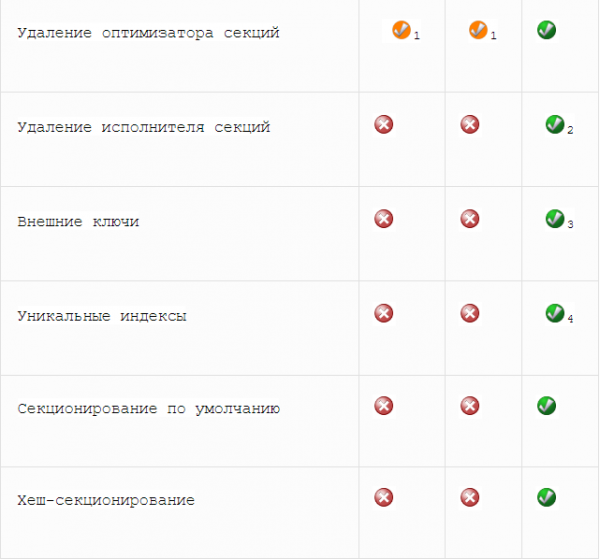
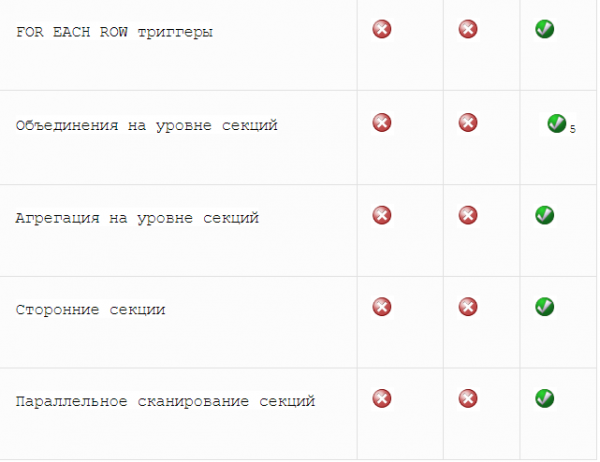
1. Usando restricciones de exclusión
2. Agrega solo nodos
3. Solo para tablas particionadas que hacen referencia a tablas no particionadas
4. Los índices deben contener todas las columnas clave de la sección
5. Las restricciones sobre la sección deben coincidir por ambos lados
Rendimiento
¡Aquí también tenemos buenas noticias! Se ha agregado un nuevo método . Este nuevo algoritmo puede identificar secciones adecuadas examinando la condición de la consulta WHERE. El algoritmo anterior, por su parte, comprobaba cada sección para determinar si podía cumplir con la condición WHERE. Esto llevaba a un aumento adicional en el tiempo de planificación a medida que crecía el número de secciones.
En 9.6, con la partición mediante herencia, la ruta de las tuplas en la sección se realizaba generalmente escribiendo una función de disparador que contenía una serie de operadores IF para insertar la tupla en la sección correcta. Estas funciones podían ser muy lentas en su ejecución. Con la partición declarativa, añadida en la versión 10, esto se volvió mucho más rápido.
Utilizando una tabla particionada con 100 secciones, podemos evaluar el rendimiento de la carga de 10 millones de filas en una tabla de 1 columna BIGINT y 5 columnas INT.
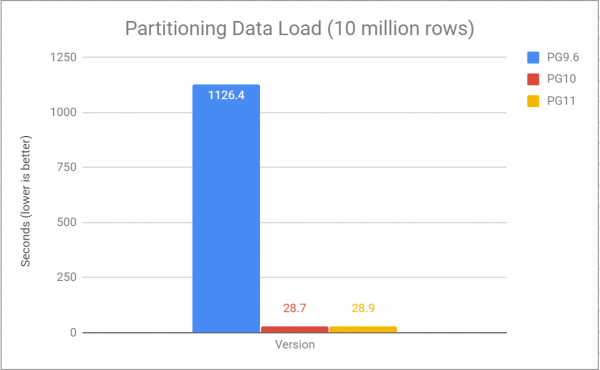
El rendimiento de la consulta a esta tabla para buscar un solo registro indexado y realizar DML para manipular un registro (utilizando solo 1 procesador):
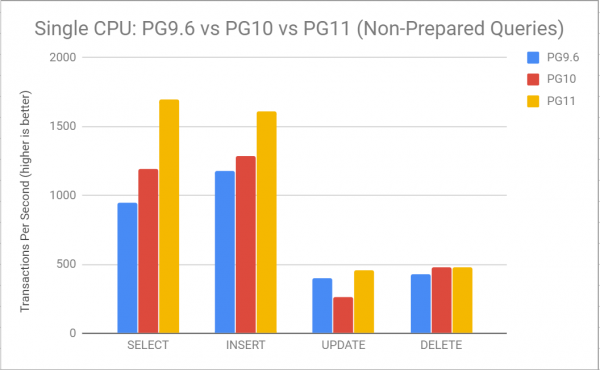
Aquí vemos que el rendimiento de cada operación ha aumentado significativamente después de PG 9.6. Las consultas SELECCIONAR se ven mucho mejor, especialmente aquellas que pueden excluir múltiples secciones durante la planificación de consultas. Esto significa que el planificador puede omitir gran parte del trabajo que tenía que hacer antes. Por ejemplo, ya no se construyen rutas para secciones innecesarias.
Conclusión
La partición de tablas comienza a convertirse en una función muy poderosa en PostgreSQL. Permite entregar datos rápidamente en línea y moverlos a fuera de línea, sin esperar a que finalicen las lentas operaciones DML masivas.Esto también significa que los datos relacionados pueden almacenarse juntos, es decir, se puede acceder a los datos requeridos de manera mucho más eficiente. Las mejoras realizadas en esta versión no habrían sido posibles sin los desarrolladores, revisores y committers que trabajaron incansablemente en todas estas características.
¡Gracias a todos ellos! ¡PostgreSQL 11 se ve simplemente fantástico!
Aquí hay un artículo corto, pero bastante interesante. Compartan comentarios y no olviden inscribirse en , donde se explicará en detalle el programa del curso.
Fuente: habr.com
