

— es un mecanismo muy potente y conveniente, si se realizan las mismas acciones "en profundidad" sobre datos relacionados. Pero la recursión incontrolada es un mal que puede llevar a una ejecución infinita del proceso, o (lo que sucede con más frecuencia) a «consumir» toda la memoria disponible.
Las bases de datos funcionan en este sentido de acuerdo con los mismos principios — "dijeron que cavara, y yo estoy cavando". Su consulta puede no solo ralentizar los procesos vecinos, ocupando constantemente los recursos del procesador, sino también «caer» toda la base por completo, «consumiendo» toda la memoria disponible. Por lo tanto, la protección contra la recursión infinita es responsabilidad del propio desarrollador.
En PostgreSQL la posibilidad de utilizar consultas recursivas a través de apareció hace mucho tiempo en la versión 8.4, pero aún se pueden encontrar regularmente consultas "desprotegidas" potencialmente vulnerables. ¿Cómo liberarse de problemas de este tipo?
No escribir consultas recursivas
Sino escribir consultas no recursivas. Atentamente, su K.O.
De hecho, PostgreSQL proporciona una cantidad bastante grande de funcionalidad que se puede utilizar para no aplicar recursión.
Utilizar un enfoque fundamentalmente diferente para el problema
A veces, se puede simplemente mirar el problema "desde otro ángulo". Un ejemplo de tal situación lo mencioné en el artículo — multiplicación de un conjunto de números sin utilizar funciones de agregación personalizadas:
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- selección del resultado final
  i DESC
LIMIT 1;
Dicha consulta se puede reemplazar por una opción de matemáticos expertos:
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Utilizar generate_series en lugar de ciclos
Supongamos que tenemos el problema de generar todos los posibles prefijos para la cadena 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
¿Realmente se necesita recursión aquí?.. Si se utiliza LATERAL y generate_series, entonces ni siquiera se necesitarán CTE:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
Modificar la estructura de la base de datos
Por ejemplo, tiene una tabla de mensajes de foro con relaciones de quién respondió a quién o hilo en :
CREAR TABLA message(
  message_id
    uuid
      CLAVE PRIMARIA
, reply_to
    uuid
      REFERENCIAS message
, body
    texto
);
CREAR ÍNDICE EN message(reply_to); 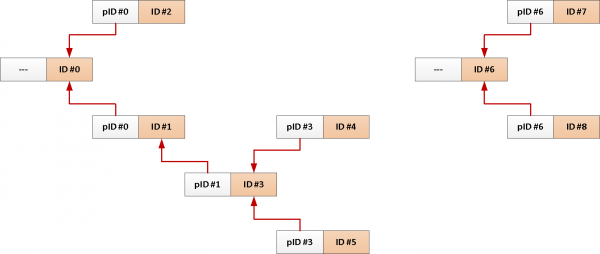
Un ejemplo típico de consulta para cargar todos los mensajes sobre un mismo tema se vería así:
CON RECURSIVO T COMO (
  SELECCIONAR
    *
  DE
    message
  DONDE
    message_id = $1
UNIÓN TODO
  SELECCIONAR
    m.*
  DE
    T
  UNIR
    message m
      EN m.reply_to = T.message_id
)
TABLA T;
Pero dado que siempre necesitamos todo el tema desde el mensaje raíz, ¿por qué no agregar su identificador en cada registro automáticamente?
-- añadamos un campo con el identificador general del tema y un índice sobre él
ALTERAR TABLA message
  AÑADIR COLUMNA theme_id uuid;
CREAR ÍNDICE EN message(theme_id);

-- inicializamos el identificador del tema en un activador al insertar
CREAR O REEMPLAZAR FUNCIÓN ins() RETORNA DISPARADOR AS $$
COMIENZO
  NUEVO.theme_id = CASO
    CUANDO NUEVO.reply_to ES NULO ENTONCES NUEVO.message_id -- tomamos del evento inicial
    SINO ( -- o del mensaje al que estamos respondiendo
      SELECCIONAR
        theme_id
      DE
        message
      DONDE
        message_id = NUEVO.reply_to
    )
  FIN;
  RETORNAR NUEVO;
FIN;
$$ LENGUAJE plpgsql;

CREAR DISPARADOR ins ANTES DE INSERTAR
  EN message
    POR CADA FILA
EJECUTAR PROCEDIMIENTO ins(); 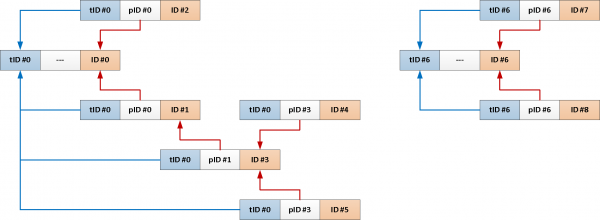
Ahora nuestra consulta recursiva puede reducirse a solo esto:
SELECCIONAR
  *
DE
  message
DONDE
  theme_id = $1;
Utilizar "limitadores" aplicados
Si no podemos cambiar la estructura de la base de datos por alguna razón, veamos en qué podemos apoyarnos, para que incluso la presencia de un error en los datos no conduzca a una ejecución recursiva infinita.
Contador de "profundidad" recursiva
Simplemente aumentamos el contador en uno en cada paso de la recursión hasta alcanzar un límite que consideramos evidentemente inadecuado:
CON RECURSIVO T COMO (
  SELECCIONAR
    0 i
  ...
UNIÓN TODO
  SELECCIONAR
    i + 1
  ...
  DONDE
    T.i < 64 -- límite
)
Pro: Al intentar un ciclo, no haremos más de lo indicado como límite de iteraciones "hacia adentro".
Contra: No hay garantía de que no procesemos el mismo registro nuevamente, por ejemplo, en profundidad 15 y 25, y así sucesivamente cada +10. Además, no hay ninguna promesa sobre "hacia afuera".
Formalmente, esta recursión no será infinita, pero si en cada paso el número de registros aumenta exponencialmente, todos sabemos cómo termina esto...
Guardador del "camino"
Por orden, vamos anotando todos los identificadores que encontramos en nuestro camino de recursión en un arreglo, que es un "camino" único hasta él:
CON RECURSIVO T COMO (
  SELECCIONAR
    ARRAY[id] path
  ...
UNIÓN TODO
  SELECCIONAR
    path || id
  ...
  DONDE
    id  TODOS(T.path) -- no coincide con ninguno de
)
Pro: Si hay un ciclo en los datos, no procesaremos absolutamente la misma entrada de nuevo en el mismo camino.
Contra: Pero podemos recorrer, literalmente, todas las entradas sin repetirnos.
Restricción de la longitud del camino
Para evitar la situación de 'errante' en una profundidad de recursión incierta, podemos combinar los dos métodos anteriores. O, si no queremos mantener campos adicionales, complementar la condición de continuación de la recursión con la evaluación de la longitud del camino:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) AND
    array_length(T.path, 1) < 10
)
¡Elija el método que prefiera!
Fuente: habr.com
