

En el ejercicio de nuestra actividad, a veces nos encontramos en situaciones en las que el desarrollador formula una consulta y piensa: "¡la base es inteligente, puede manejarlo todo por sí misma!"«
En algunos casos (en parte por desconocimiento de las capacidades de la base de datos, en parte por optimizaciones prematuras), este enfoque conduce a la creación de "frankenstein".
Primero, daré un ejemplo de tal consulta:
-- para cada par clave, buscamos los valores asociados de los campos
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- encontramos los valores min/max para cada primera clave
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- vinculamos pares clave por la primera clave y los valores min/max
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Para evaluar de manera concreta la calidad de la consulta, creemos un conjunto de datos arbitrario:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
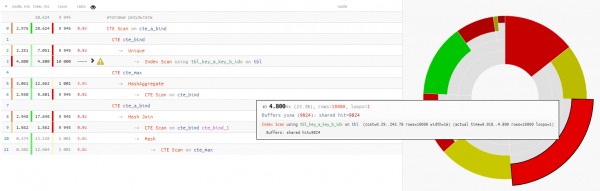
Resulta que la propia lectura de datos ocupó menos de una cuarta parte de todo el tiempo de ejecución de la consulta:
Desglosamos cada elemento
Analicemos detenidamente la consulta y nos surge la pregunta:
- ¿Por qué aquí WITH RECURSIVE si no hay CTE recursivos?
- ¿Por qué agrupar los valores min/max en un CTE separado si luego se vinculan a la selección original?
+25% de tiempo - ¿Por qué usar al final una reiteración de la CTE anterior a través de un 'SELECT * FROM' incondicional?
+14% de tiempo
En este caso, tuvimos suerte de que se eligió un Hash Join para la unión, y no un Nested Loop, ya que de lo contrario hubiéramos tenido no una, sino 10K pasadas del CTE Scan.
un poco sobre el CTE ScanAquí debe recordarse que el CTE Scan es el equivalente de Seq Scan es decir, sin indexación, solo una búsqueda completa, que requeriría 10K x 0.3ms = 3000ms en ciclos por cte_max o 1K x 1.5ms = 1500ms en ciclos por cte_bind!
Entonces, ¿qué queríamos obtener como resultado? Ajá, normalmente este tipo de pregunta surge alrededor del quinto minuto al analizar consultas "de tres niveles".
Queríamos mostrar para cada par clave único min/max del grupo por key_a.
Así que utilicemos :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 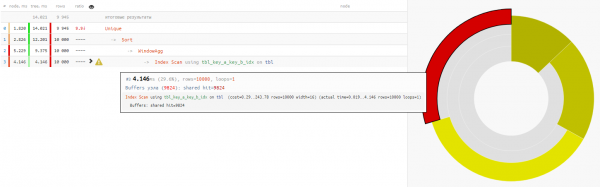
Dado que la lectura de datos en ambas variantes toma aproximadamente 4-5 ms, nuestra ganancia total en tiempo -32% es pura carga, retirada de la CPU de la base, si tal solicitud se realiza con suficiente frecuencia.
En general, no deberíamos obligar a la base a "cargar lo redondo y arrastrar lo cuadrado".
Fuente: habr.com
