

En SQL describes «qué» quieres obtener, y no «cómo» debe ejecutarse. Por lo tanto, el problema de desarrollar consultas SQL al estilo de «como suena, así se escribe» ocupa un lugar destacado, junto con .
Hoy, a través de ejemplos muy simples, veremos a qué puede llevar esto en el contexto de uso de GROUP/DISTINCT y LIMIT junto con ellos.
Si has escrito en la consulta «primero une estas tablas, y luego elimina todos los duplicados, debe quedar sólo una instancia por cada clave» — así es como funcionará, incluso si la unión no era necesaria en absoluto.
Y a veces tienes suerte y simplemente «funciona», a veces afecta negativamente el rendimiento, y a veces da efectos absolutamente inesperados desde la perspectiva del desarrollador.
Bueno, tal vez no tan espectaculares, pero…
«Dulce pareja»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Es claro que se deseaba filtrar esos registros X para los que en Y hay relacionados con la condición en ejecución. Se escribió la consulta a través de JOIN — se obtuvieron algunos valores pk varias veces (justo cuántos registros coincidentes había en Y). ¿Cómo eliminar? Claro DISTINCT!
Es especialmente «desagradable» cuando para cada registro X se encuentran cientos de registros Y relacionados, y luego se eliminan los duplicados de forma heroica…
¿Cómo corregir? Primero, darse cuenta de que se puede modificar la tarea a «filtrar esos registros X para los que en Y hay AL MENOS UN registro relacionado con la condición en ejecución» — ya que de la propia Y no necesitamos nada.
EXISTS anidado
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Algunas versiones de PostgreSQL comprenden que en EXISTS es suficiente encontrar el primer registro que aparece, las versiones más antiguas no. Por eso prefiero siempre especificar LIMIT 1 dentro EXISTS.
JOIN LATERAL
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Esta variante también permite devolver inmediatamente algunos datos del registro Y relacionado encontrado, si es necesario. Se consideró una variante similar en el artículo .
«¿Por qué pagar más?»: DISTINCT [ON] + LIMIT 1
Una ventaja adicional de tales transformaciones de consulta es la posibilidad de limitar fácilmente la selección de registros si solo se necesita uno/múltiples de ellos, como en el siguiente caso:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Ahora leemos la consulta y tratamos de entender qué se propone hacer la SGBD:
- unimos las tablas
- uniquificamos por X.pk
- de los registros restantes seleccionamos uno
¿Entonces qué obtuvimos? «Un registro» de los únicos - y si tomamos este uno de los no únicos, ¿acaso el resultado cambiará de alguna manera?.. «¿Y si no hay diferencia, por qué pagar más?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- aquí se pueden agregar condiciones adecuadas
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Y el mismo tema con GROUP BY + LIMIT 1.
«Solo tengo que preguntar»: GROUP implícito + LIMIT
Cosas como estas se encuentran en varias verificaciones de no vacuidad de tablas o CTE a lo largo de la ejecución de la consulta:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Las funciones agregadas (count/min/max/sum/...) se ejecutan exitosamente en todo el conjunto, incluso sin especificación explícita GROUP BY. Solo que con LIMIT no se llevan muy bien.
El desarrollador puede pensar «bueno, si hay registros, no debo exceder el LIMIT». ¡Pero no debes hacerlo así! Porque para la base de datos es:
- cuenta lo que desean devuelve tantas filas como piden
- Dependiendo de las condiciones objetivo, aquí es adecuado hacer uno de los reemplazos:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)en(count + LIMIT 1) > 0EXISTS(LIMIT 1)encount >= N(SELECT count(*) FROM (... LIMIT N))en«¿Cuánto pesa en gramos»: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
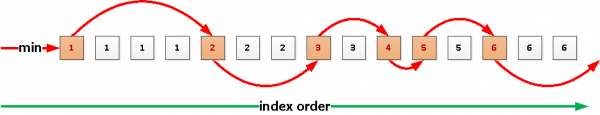
Un desarrollador ingenuo puede pensar sinceramente que la ejecución de la consulta se detendrá,una vez que encontremos los $1 primeros valores distintos que se presenten Alguna vez en el futuro esto podría funcionar así gracias a un nuevo nodo.
Index Skip Scan , cuya implementación se está estudiando ahora, pero por ahora — no.Por ahora primero
se extraerán todos los registros , se unificarán, y solo de ellos se devolverá cuántos se soliciten. Especialmente triste puede ser si nosotros queremos algo como, y hay cientos de miles de registros en la tabla... $1 = 4Para no entristecernos en vano, utilizaremos la consulta recursiva
«DISTINCT para pobres» de PostgreSQL Wiki :
Fuente: habr.com
