

Hoy no habrá casos complicados ni algoritmos sofisticados en SQL. Todo será muy simple, a nivel del Capitán Obvio: hacemos la revisión del registro de eventos con clasificación por tiempo.
Es decir, tenemos una tabla en la base de datos events, y tiene un campo ts — precisamente el tiempo por el cual queremos mostrar estas entradas de manera ordenada:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Está claro que no tendremos solo unas pocas entradas, por lo que necesitaremos de alguna forma navegación paginada.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Es casi una broma — rara vez, pero sucede en la naturaleza. A veces, después de trabajar con ORM, es difícil volver a trabajar "directamente" con SQL.
Pero pasemos a problemas más comunes y menos obvios.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - entradas por página, $1 - inicio de la página
¿De dónde salió el número 26? Es la cantidad aproximada de entradas para llenar una pantalla. Más exactamente, 25 entradas visibles, más 1, que indica que aún hay más en la selección y tiene sentido continuar.
Por supuesto, este valor no necesita ser "incorporado" en el cuerpo de la consulta, sino que puede ser pasado como parámetro. Pero en este caso, el planificador de PostgreSQL no podrá basarse en el conocimiento de que debería haber relativamente pocas entradas, y probablemente elegirá un plan ineficiente.
Y mientras en la interfaz de la aplicación la revisión del registro se implementa como un cambio entre "páginas visuales", nadie nota nada sospechoso durante mucho tiempo. Justo hasta el momento en que, en la lucha por la comodidad del UI/UX, se decide rehacer la interfaz con un "scroll infinito" — es decir, todas las entradas del registro se dibujan como una única lista que el usuario puede desplazarse hacia arriba o hacia abajo.
Y aquí, durante otra prueba, se te sorprende con la duplicación de entradas en el registro. ¿Por qué, si hay un índice normal en la tabla? (ts), que es utilizado por tu consulta?
Precisamente porque no tomaste en cuenta que ts no es una clave única en esta tabla. En realidad, los valores tampoco son únicos., como en cualquier «tiempo» en condiciones reales — por eso, la misma entrada en dos solicitudes adyacentes puede «saltarse» de página a página debido a un orden final diferente en la clasificación del mismo valor de clave.
De hecho, aquí se oculta un segundo problema, que es mucho más difícil de notar — algunas entradas no se mostrarán en absoluto. ¡Porque las entradas «duplicadas» ocuparon el lugar de alguien! Una explicación detallada con imágenes bonitas se puede .
Expandir el índice
El ingenioso desarrollador entiende — hay que hacer que la clave del índice sea única, y la forma más sencilla es ampliarla con un campo inherentemente único, como el PK:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);Y la consulta se transforma:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Un tiempo después, un DBA viene a ti y te «alegra» al decir que tus consultas , y en general, ya es hora de pasar a navegación desde el último valor mostrado. Tu consulta se transforma de nuevo:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- los últimos valores recibidos en el paso anterior
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Suspiras aliviado, hasta que llega…
#3. Чистка индексов
Porque un día tu DBA leyó y entendió que un timestamp «no último» — no es bueno. Y volvió a acercarse a ti — ahora con la idea de que ese índice debería convertirse de nuevo en (ts DESC).
Pero, ¿qué hacer con el problema original de «saltos» de entradas entre páginas? Bueno, es sencillo — ¡hay que seleccionar bloques con una cantidad variable de entradas!
En general, ¿quién nos prohíbe leer no «exactamente 26», sino «al menos 26»? Por ejemplo, para que en el siguiente bloque haya entradas con valores inherentemente diferentes ts — ¡así no habrá problemas de «saltar» entradas entre bloques!
Así es como lograr esto:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
¿Qué está sucediendo aquí, en general?
- Bajamos 25 entradas y obtenemos el valor «límite»
ts. - Si allí ya no hay nada, reemplazamos el valor NULL por
-infinity. - Restamos todo el segmento de valores entre el valor obtenido
tsy el parámetro $1 pasado desde la interfaz (el último valor «dibujado» anterior). - Si el bloque ha devuelto menos de 26 registros, es el último.
O lo mismo en imagen:
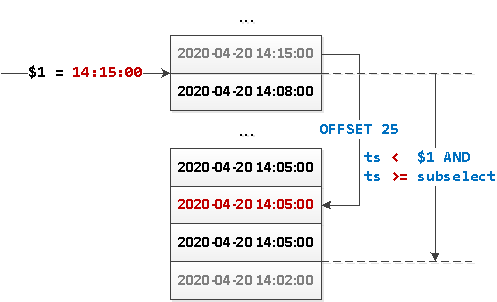
Dado que ahora tenemos la selección no tiene un «inicio» determinado, nada nos impide «expandir» esta consulta en la dirección inversa y realizar una carga dinámica de bloques de datos desde el «punto de referencia» en ambas direcciones: tanto hacia abajo como hacia arriba.
Nota
- Sí, en este caso accedemos al índice dos veces, pero todo «limpiamente por el índice». Por lo tanto, la consulta anidada solo dará una exploración adicional de índice únicamente.
- Es bastante evidente que esta técnica solo se puede usar cuando sus valores
tspueden cruzarse solo de manera aleatoria, y hay pocos de ellos. Sin embargo, si su caso típico es «un millón de registros en 00:00:00.000», entonces no debe hacerlo. Es decir, no debe permitir ese caso. Pero si ya ha sucedido, use la opción con índice extendido.
Fuente: habr.com
