

A veces, el desarrollador necesita transmitir un conjunto de parámetros en una consulta o incluso una selección completa "al ingreso". A veces se encuentran soluciones muy extrañas para este problema.
Vamos "desde lo contrario" y veamos qué no se debe hacer, por qué, y cómo se puede hacer mejor.
Inserción directa de valores en el cuerpo de la consulta
Normalmente se ve algo así:
query = "SELECT * FROM tbl WHERE id = " + value… o así:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Sobre este método se ha dicho, escrito y hay suficiente:
Casi siempre esto es — un camino directo hacia inyecciones SQL y una carga innecesaria sobre la lógica del negocio, que se ve obligada a "pegar" la cadena de su consulta.
Este enfoque puede estar parcialmente justificado solo en caso de utilizar particionamiento en versiones de PostgreSQL 10 y anteriores para obtener un plan más eficiente. En estas versiones, la lista de secciones escaneadas se determina incluso sin tener en cuenta los parámetros transmitidos, solo en base al cuerpo de la consulta.
$n-argumentos
Uso de parámetros es algo bueno, permite usar , reduciendo la carga tanto en la lógica del negocio (la cadena de consulta se forma y se transmite solo una vez), como en el servidor de base de datos (no requiere análisis y planificación repetidos para cada instancia de la consulta).
Cantidad variable de argumentos
Los problemas nos esperan cuando queramos pasar una cantidad de argumentos desconocida de antemano:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Si dejamos la consulta en esta forma, aunque nos protegerá de inyecciones potenciales, aún así conducirá a la necesidad de combinar/analizar la consulta para cada variante en la cantidad de argumentos. Ya es mejor que hacerlo cada vez, pero se puede evitar también.
Basta con pasar un solo parámetro que contenga una representación serializada de un array:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'La única diferencia es la necesidad de convertir explícitamente el argumento al tipo de array correcto. Pero esto no causa problemas, ya que sabemos de antemano a dónde estamos dirigiéndonos.
Transmisión de selección (matriz)
Normalmente se trata de varias opciones para transmitir conjuntos de datos para insertar en la base "en una sola consulta":
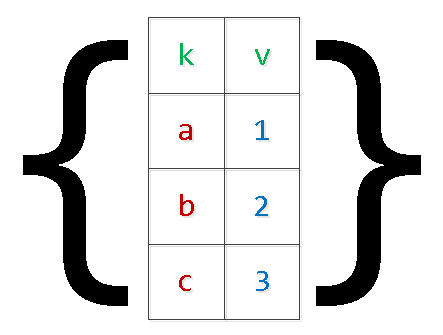
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Además de los problemas mencionados anteriormente con la "reescritura" de la consulta, esto también puede llevarnos a fuera de memoria y a la caída del servidor. La razón es sencilla: bajo los argumentos, PG reserva memoria adicional, y el número de registros en el conjunto está limitado solo por los deseos aplicativos de la lógica de negocio. En casos clínicos extremos, se ha llegado a observar argumentos "numéricos" superiores a $9000 — no hay necesidad de hacerlo así.
Reescribamos la consulta, aplicando ya una "serialización" de dos niveles:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Sí, en el caso de los valores "complejos" dentro del array, es necesario encerrarlos entre comillas.
Es evidente que de esta forma se puede "desplegar" la selección con un número arbitrario de campos.
unnest, unnest, …
Periódicamente aparecen opciones de pasar en lugar de un "array de arrays" varios "arrays de columnas", de los que mencioné anteriormente. :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Con este método, si te equivocas al generar listas de valores para diferentes columnas, es muy fácil obtener resultados sorprendentes, que también dependen de la versión del servidor:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Desde la versión 9.3, PostgreSQL cuenta con funciones completas para trabajar con el tipo json. Por lo tanto, si la definición de los parámetros de entrada se realiza en el navegador, puedes crear el objeto json para la consulta SQL:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Para versiones anteriores, se puede utilizar el mismo método para each(hstore), pero la correcta "compresión" con el escape de objetos complejos en hstore puede causar problemas.
json_populate_recordset
Si sabes de antemano que los datos del "array json de entrada" se utilizarán para llenar alguna tabla, puedes ahorrar mucho en "desreferenciación" de campos y conversión a los tipos necesarios usando la función json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Esta función simplemente "desplegará" el array de objetos proporcionado en la selección, sin depender del formato de la tabla:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TABLA TEMPORAL
Pero si el volumen de datos en el conjunto de selección es muy grande, enviarlo como un solo parámetro serializado es difícil y a veces incluso imposible, ya que requiere de una gran asignación de memoria. Por ejemplo, puede que necesite recopilar un gran paquete de datos sobre eventos de un sistema externo durante mucho tiempo y luego quiera procesarlo todo de una vez en la base de datos.
En este caso, la mejor solución será utilizar :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- repetir muchas, muchas veces
...
-- aquí hacemos algo útil con toda esta tabla en conjunto
Este método es bueno precisamente para transferencias raras de grandes volúmenes de datos.
Desde el punto de vista de la descripción de la estructura de sus datos, una tabla temporal se diferencia de una 'normal' únicamente por una característica en la tabla del sistema pg_class, mientras que en pg_type, pg_depend, pg_attribute, pg_attrdef, … — y en realidad no se diferencia en nada.
Por lo tanto, en sistemas web con un gran número de conexiones de corta duración, para cada una de ellas, esta tabla generará nuevos registros del sistema cada vez, que se eliminan al cerrar la conexión con la base de datos. Como resultado, el uso incontrolado de TEMP TABLE lleva a la 'inflación' de las tablas en pg_catalog y a la ralentización de muchas operaciones que las utilizan.
Por supuesto, se puede combatir esto mediante un paso periódico de VACUUM FULL a través de las tablas del catálogo del sistema.
Variables de sesión
Supongamos que el procesamiento de datos del caso anterior es lo suficientemente complejo para una sola consulta SQL, pero queremos realizarlo con bastante frecuencia. Es decir, queremos utilizar el procesamiento por procedimientos en , pero utilizar la transferencia de datos a través de tablas temporales sería demasiado costoso.
No podremos usar parámetros $n para la transferencia en un bloque anónimo. La solución serán las variables de sesión y la función current_setting.
Hasta la versión 9.2, era necesario configurar previamente custom_variable_classes para las 'propias' variables de sesión. En las versiones actuales, se puede escribir aproximadamente así:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
En otros lenguajes de procedimientos admitidos, se pueden encontrar otras soluciones.
¿Conoce otros métodos? ¡Compártalos en los comentarios!
Fuente: habr.com
