

Miles de gerentes de ventas en oficinas de todo el país registran en decenas de miles de contactos a diario - hechos de comunicación con clientes potenciales o que ya están trabajando con nosotros. Para esto, primero hay que encontrar al cliente, y preferiblemente muy rápido. Esto sucede, la mayoría de las veces, utilizando el nombre.
Por lo tanto, no es sorprendente que, al revisar nuevamente las consultas "pesadas" en una de las bases más cargadas: nuestra propia , descubriera "en la cima" una consulta para la búsqueda "rápida" por nombre para las tarjetas de organizaciones.
Además, una investigación posterior reveló un ejemplo interesante primero de optimización y luego de degradación del rendimiento de la consulta al modificarla secuencialmente por varios equipos, cada uno de los cuales actuaba exclusivamente con las mejores intenciones.
0: ¿qué quería el usuario?
 [КДПВ ]
¿Qué entiende habitualmente un usuario cuando habla de una búsqueda "rápida" por nombre? Casi nunca es una búsqueda "honesta" por subcadena como ... LIKE '%rosa%' - ya que en los resultados no solo aparecen 'Rosalia' y 'Tienda Rosa', sino también 'Grosa' e incluso 'Casa de Abuelo Morosa'.
El usuario, a nivel práctico, entiende que le proveerán una búsqueda por el inicio de la palabra en el título y mostrará los resultados más relevantes que comienzan con lo que se introdujo. Y lo hará prácticamente al instante - al introducir parte de la palabra.
1: limitamos la tarea
Y mucho menos alguien introduciría intencionadamente 'ros magaz', para que cada palabra tuviese que buscarse por prefijo. No, para el usuario es mucho más sencillo reaccionar a la sugerencia rápida de la última palabra que intencionalmente no introducir las anteriores - mire cómo funciona cualquier motor de búsqueda.
En general, almacenar correctamente formular los requisitos para la tarea es más de la mitad de la solución. A veces, un análisis cuidadoso del caso de uso .
¿Qué hace un desarrollador abstracto?
1.0: motor de búsqueda externo
Oh, buscar es complicado, no quiero involucrarme en esto en absoluto - ¡dediquémonos a devops! Que ellos nos implementen un sistema de búsqueda externo relativamente a la base de datos: Sphinx, ElasticSearch,…
Una opción funcional, aunque laboriosa en términos de sincronización y rapidez de cambios. Pero no en nuestro caso, ya que la búsqueda se realiza para cada cliente únicamente dentro de los datos de su cuenta. Y los datos presentan una alta variabilidad; si ahora el gerente ha agregado una tarjeta 'Tienda Rosa', en 5-10 segundos podría recordar que olvidó incluir el correo electrónico y querrá buscarla y corregirla.
Por lo tanto, vamos a buscar «directamente en la base». Afortunadamente, PostgreSQL nos permite hacer esto, y no de una sola manera; exploraremos las diferentes opciones.
1.1: Subcadena "honesta"
Nos centramos en la palabra «subcadena». Y es que existe un excelente ! Aunque luego será necesario ordenar correctamente los resultados.
Intentemos usar una tabla simple para ilustrar:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Cargamos allí 7.8 millones de registros de organizaciones reales e indexamos:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Busquemos las primeras 10 entradas para la búsqueda de subcadenas:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rosa')
ORDER BY
  lower(name) ~ ('^' || 'rosa') DESC -- primero "los que comienzan con"
, lower(name) -- los demás alfabéticamente
LIMIT 10;
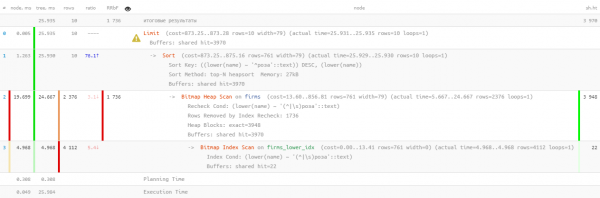
Bueno, eso es... 26ms, 31MB de datos leídos y más de 1.7K registros filtrados — para 10 consultas. Los gastos generales son demasiado altos, ¿no podríamos hacer algo más eficiente?
1.2: ¿búsqueda por texto? ¡esto es FTS!
De hecho, PostgreSQL ofrece un mecanismo de búsqueda de texto completo CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));
SELECT
  *
FROM
  firms
WHERE
  to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*')
ORDER BY
  lower(name) ~ ('^' || 'rosa') DESC
, lower(name)
LIMIT 10;
Aquí nos ayudó un poco la paralelización de la ejecución de la consulta, reduciendo el tiempo a la mitad hasta 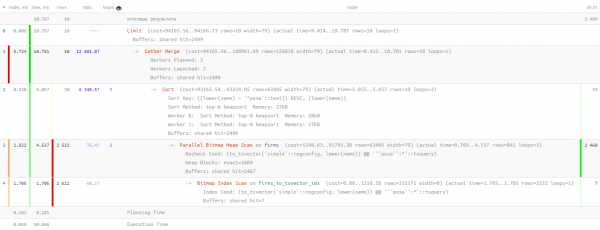
11ms . Y además tuvimos que leer 1.5 veces menos — solo20MB . Y cuanto menos, mejor, ya que a mayor volumen que leemos, más altas son las posibilidades de un cache miss, y cada página adicional leída desde el disco es un potencial "freno" para la consulta.1.3: ¿aún así LIKE?
La consulta anterior es buena, pero si la ejecutamos cientos de miles de veces al día, entonces se acumularán
2TB 2TB dados lidos. No melhor dos casos — da memória, mas se não tivermos sorte, também do disco. Então vamos tentar torná-lo menor.
Lembremos que o usuário quer ver primeiro "que começam com ...". Afinal, isso é puramente usando text_pattern_ops! E só se "não tivermos o suficiente" para 10 registros encontrados, teremos que ler mais usando a busca FTS:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('rosa' || '%')
LIMIT 10; 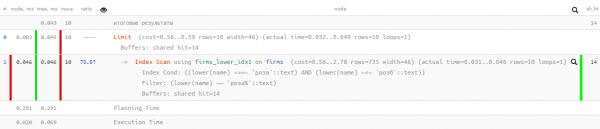
Ótimos números — apenas 0.05ms e pouco mais de 100KB lido! Mas esquecemos a ordenação pelo nome, para que o usuário não se perca nos resultados:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rosa' || '%')
ORDER BY
  lower(name)
LIMIT 10; 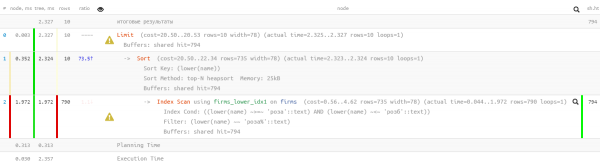
Ops, algo já não está tão bonito — parece que o índice existe, mas a ordenação está passando por cima dele... Claro, já é várias vezes mais eficiente do que a versão anterior, mas...
1.4: "refinar com uma lixa"
Mas existe um índice que permite tanto a busca por intervalo quanto a ordenação normal — b-tree normal!
CREATE INDEX ON firms(lower(name));Mas a consulta para ele terá que ser "montada manualmente":
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'rosa' AND
  lower(name) <= ('rosa' || chr(65535)) -- para UTF8, para um byte - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 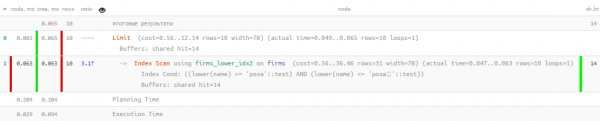
Ótimo — tanto a ordenação funciona, quanto o consumo de recursos permanece "microscópico", milhares de vezes mais eficiente do que o "FTS puro"! Agora só falta juntar em uma única consulta:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'rosa' AND
    lower(name) <= ('rosa' || chr(65535)) -- para UTF8, para codificações de um byte - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*') AND
    lower(name) NOT LIKE ('rosa' || '%') -- "começando com" já encontramos acima
  ORDER BY
    lower(name) ~ ('^' || 'rosa') DESC -- usamos a mesma ordenação para NÃO ir pelo índice btree
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Vou notar que a segunda subconsulta é executada apenas se a primeira retornou menos do que o esperado do último LIMIT número esperado de linhas. Eu já escrevi antes sobre esse tipo de otimização de consultas. .
menos de 10% das consultas chegam a executar o segundo bloco. Ou seja, com essas limitações conhecidas previamente para a tarefa, conseguimos reduzir o consumo total de recursos do servidor em quase mil vezes!1.5*: ficaremos sem o refinamento
Acima
Выше LIKE nos impidió usar una clasificación incorrecta. Pero se puede "encaminar correctamente" usando el operador USING:
Por defecto se entiende
ASC. Además, se puede especificar el nombre de un operador de clasificación específico en la cláusulaUSING. El operador de clasificación debe ser un miembro de la familia de operadores B-tree de "menor que" o "mayor que".ASCusualmente es equivalente aUSING <yDESCusualmente es equivalente aUSING >.
En nuestro caso, "menor que" es ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rosa' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 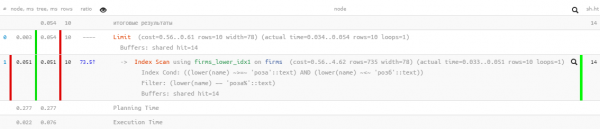
2: cómo "se descomponen" las consultas
Ahora dejamos que nuestra consulta "madure" durante medio año a un año, y con sorpresa descubrimos nuevamente que está "en la cima" con indicadores de acumulación diaria de "memoria" (buffers shared hit) en 5.5TB — es decir, aún más de lo que había originalmente.
No, por supuesto, nuestro negocio creció y la carga aumentó, ¡pero no tanto! Eso significa que algo no está bien — vamos a investigar.
2.1: el nacimiento de la paginación
En algún momento, a otro equipo de desarrolladores se le ocurrió hacer posible "saltar" del rápido búsqueda parcial a un registro con los mismos, pero resultados ampliados. ¿Y qué registro sin navegación por páginas? ¡Vamos a implementarlo!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Ahora se podía mostrar sin problemas para el desarrollador el registro de resultados de búsqueda con carga "tipo-paginación".
Por supuesto, en realidad, para cada siguiente página de datos se lee cada vez más (todo de la vez anterior, que descartaremos, más el necesario "extra") — es decir, esto es indudablemente un antipatrón. Y lo correcto sería iniciar la búsqueda en la siguiente iteración desde la clave almacenada en la interfaz, pero sobre eso, otro día.
2.2: se anhela la exotica
En algún momento, al desarrollador le apeteció diversificar la selección de resultados con datos de otra tabla, para lo cual toda la consulta anterior se envió a CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- alguna consulta a la tabla relacionada
FROM
  q
LIMIT 10 OFFSET ;
Y aun así — no está mal, ya que la consulta anidada se calcula solo para 10 registros devueltos, si no fuera por...
2.3: DISTINCT sin sentido y despiadado
En algún momento de este proceso de evolución, del segundo subquery se perdió NOT LIKE la condición.Está claro que después de esto UNION ALL comenzó a devolver algunos registros dos veces — primero encontramos por el comienzo de la línea y luego otra vez — por el comienzo de la primera palabra de esta línea. En el límite, todas las entradas de la segunda subconsulta podrían coincidir con las entradas de la primera.
¿Qué hace el desarrollador en lugar de buscar la causa?.. ¡No hay pregunta!
- ampliemos el tamaño al doble muestras originales
- aplicaremos DISTINCT, para que solo queden instancias únicas de cada fila
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Es decir, está claro que el resultado, al final, es exactamente el mismo, pero la posibilidad de "fallar" en la segunda subconsulta CTE ha aumentado significativamente, y además de eso, se lee claramente más.
Pero eso no es lo más triste. Dado que el desarrollador pidió seleccionar DISTINCT no por campos específicos, sino por todos los campos a la vez las entradas, también se incluyó automáticamente el campo sub_query — el resultado de la subconsulta. Ahora, para realizar DISTINCT, la base tuvo que ejecutar ya no 10 subconsultas, sino todas + 10!
2.4: ¡la cooperación es lo primero!
Así es como vivían los desarrolladores — sin preocupaciones, porque en el registro no había paciencia suficiente para "ajustar" N a valores significativos ante la crónica lentitud en la obtención de cada "página" siguiente por parte del usuario.
Hasta que no llegaron los desarrolladores de otro departamento y quisieron aprovechar un método tan conveniente para la búsqueda iterativa — es decir, tomamos un fragmento de una muestra, filtramos según condiciones adicionales, mostramos el resultado, luego el siguiente fragmento (lo que en nuestro caso se logra al aumentar N), y así hasta que llenemos la pantalla.
En general, en el caso capturado N alcanzó valores de casi 17K, y en total en un día se ejecutaron por "cadena" no menos de 4K de tales consultas. Las últimas de ellas se escanearon con confianza ya por 1GB de memoria en cada iteración…
Total
Fuente: habr.com
