

Tengan cuidado con las operaciones, buffers perjudiciales...
Veamos algunos enfoques universales para optimizar consultas en PostgreSQL con un ejemplo de una consulta pequeña. Usar estos enfoques o no, es decisión suya, pero es importante conocerlos.
En versiones posteriores de PG, la situación puede cambiar con la 'inteligencia' del planificador, pero para 9.4/9.6 se verá aproximadamente igual que los ejemplos aquí.
Tomemos una consulta bastante realista:
SELECT
  TRUE
FROM
  "Documento" d
INNER JOIN
  "ExtensiónDocumento" doc_ex
    USING("@Documento")
INNER JOIN
  "TipoDocumento" t_doc ON
    t_doc."@TipoDocumento" = d."TipoDocumento"
WHERE
  (d."Persona3" = 19091 or d."Empleado" = 19091) AND
  d."$Borrador" IS NULL AND
  d."Eliminado" IS NOT TRUE AND
  doc_ex."Estado"[1] IS TRUE AND
  t_doc."TipoDocumento" = 'PlanTrabajo'
LIMIT 1;
sobre los nombres de tablas y camposSe pueden tener diferentes opiniones sobre los nombres 'rusos' de campos y tablas, pero es cuestión de gusto. Dado que no tenemos desarrolladores extranjeros, y PostgreSQL nos permite nombrar incluso con jeroglíficos, siempre que estén entre comillas, preferimos nombrar los objetos de forma clara y comprensible para evitar malentendidos.
Veamos el plan resultante:
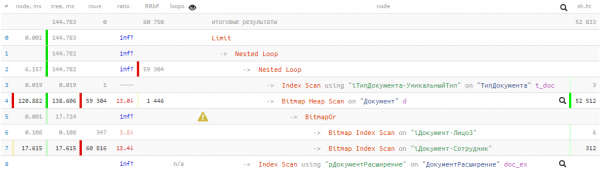
144ms y casi 53K buffers — es decir, ¡más de 400MB de datos! Y tendremos suerte si todos ellos están en caché en el momento de nuestra consulta, de lo contrario, se volverá mucho más largo al leer desde el disco.
¡El algoritmo es lo más importante!
Para optimizar cualquier consulta, primero debes entender qué es lo que realmente debe hacer.
Por ahora, dejemos fuera de este artículo el desarrollo de la propia estructura de la base de datos, y acordemos que podemos 'reescribir' la consulta relativamente 'barato' y/o aplicar algunos índices que necesitamos en la base de datos Entonces, la consulta: — verifica la existencia de algún documento.
— en el estado que necesitamos y de un tipo específico
— donde el autor o el ejecutor sea el empleado que necesitamos
JOIN + LIMIT 1
Con bastante frecuencia, es más fácil para el desarrollador escribir una consulta donde primero se hace la unión de una gran cantidad de tablas, y luego, de todo este conjunto, se queda solo con un único registro. Pero más fácil para el desarrollador no significa más eficiente para la base de datos.
En nuestro caso hubo solo 3 tablas, ¡y qué efecto...!
Primero, deshagámonos de la unión con la tabla 'TipoDocumento', y al mismo tiempo informemos a la base de datos que
el tipo de registro es único para nosotros.
¡El algoritmo es lo más importante! Para optimizar cualquier consulta, primero debes entender qué se supone que debe hacer. (sabemos esto, pero el programador aún no se da cuenta):
CON T COMO (
  SELECCIONAR
    "@TipoDeDocumento"
  DE
    "TipoDeDocumento"
  DONDE
    "TipoDeDocumento" = 'PlanDeTrabajos'
  LÍMITE 1
)
...
DONDE
  d."TipoDeDocumento" = (TABLA T)
...
Sí, si la tabla/CTE consta de un único campo de un único registro, en PG se puede escribir así en lugar de
d."TipoDeDocumento" = (SELECCIONAR "@TipoDeDocumento" DE T LÍMITE 1)Cálculos "perezosos" en consultas de PostgreSQL
BitmapOr vs UNION
En algunos casos, Bitmap Heap Scan nos costará mucho — por ejemplo, en nuestra situación, cuando muchas grabaciones caen bajo la condición requerida. Lo obtuvimos por condiciones OR, que se convirtieron en BitmapOr-operación en el plan.
Regresando al problema original — necesitamos encontrar una grabación que corresponda a cualquiera de las condiciones — es decir, no hay necesidad de buscar las 59K grabaciones por ambas condiciones. Hay una forma de trabajar una condición, y pasar a la segunda solo cuando no se encontró nada por la primera.Nos ayudará esta construcción:
(
  SELECCIONAR
    ...
  LÍMITE 1
)
UNION ALL
(
  SELECCIONAR
    ...
  LÍMITE 1
)
LÍMITE 1
"El LIMIT 1 externo garantiza que la búsqueda se detenga al encontrar el primer registro. Y si se encuentra ya en el primer bloque, la ejecución del segundo no se llevará a cabo (nunca ejecutado en el plan).
"Escondemos bajo CASE" condiciones complejas
En la consulta original hay un punto extremadamente incómodo: la verificación del estado en la tabla relacionada "DocumentoExtensión". Independientemente de la veracidad de las otras condiciones en la expresión (por ejemplo, d."Eliminado" IS NOT TRUE), esta unión se ejecuta siempre y "consume recursos". Más o menos se gastarán — depende del volumen de esta tabla.
Pero se puede modificar la consulta para que la búsqueda del registro relacionado solo ocurra cuando sea realmente necesario:
SELECCIONAR
  ...
DE
  "Documento" d
DONDE
  ... /*condición de índice*/ Y
  CASE
    CUANDO "$Borrador" IS NULL Y "Eliminado" IS NOT TRUE ENTONCES (
      SELECCIONAR
        "Estado"[1] IS TRUE
      DE
        "DocumentoExtensión"
      DONDE
        "@Documento" = d."@Documento"
    )
  FIN
Ya que de la tabla relacionada no necesitamos ninguno de los campos , podemos transformar la unión JOIN en una condición mediante un subconsulta.Dejamos los campos indexables "fuera del CASE", los simples condiciones de la grabación las incluimos en el bloque WHEN — y ahora la "consulta pesada" solo se ejecuta al pasar a THEN.
Mi apellido es "Total"
Recopilamos la consulta resultante con todas las mecánicas mencionadas anteriormente:
Собираем результирующий запрос со всеми описанными выше механиками:
CON T AS (
  SELECT
    "@TipoDeDocumento"
  FROM
    "TipoDeDocumento"
  WHERE
    "TipoDeDocumento" = 'PlanTrabajo'
)
  (
    SELECT
      TRUE
    FROM
      "Documento" d
    WHERE
      ("Persona3", "TipoDeDocumento") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Borrador" IS NULL AND "Eliminado" IS NOT TRUE THEN (
          SELECT
            "Estado"[1] IS TRUE
          FROM
            "DocumentoExtensión"
          WHERE
            "@Documento" = d."@Documento"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Documento" d
    WHERE
      ("TipoDeDocumento", "Empleado") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Borrador" IS NULL AND "Eliminado" IS NOT TRUE THEN (
          SELECT
            "Estado"[1] IS TRUE
          FROM
            "DocumentoExtensión"
          WHERE
            "@Documento" = d."@Documento"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Ajustando [a] los índices
El ojo entrenado notó que las condiciones indexadas en los subbloques UNION son un poco diferentes; esto se debe a que ya tenemos índices adecuados en la tabla. Y si no los tuviéramos, habría que crearlos: Documento(Persona3, TipoDeDocumento) y Documento(TipoDeDocumento, Empleado).
sobre el orden de los campos en las condiciones ROWDesde el punto de vista del planificador, por supuesto, también se puede escribir (A, B) = (constA, constB)como (B, A) = (constB, constA). Pero al escribir en el orden de los campos en el índice, esa consulta simplemente será más fácil de depurar después.
¿Qué hay en el plan?
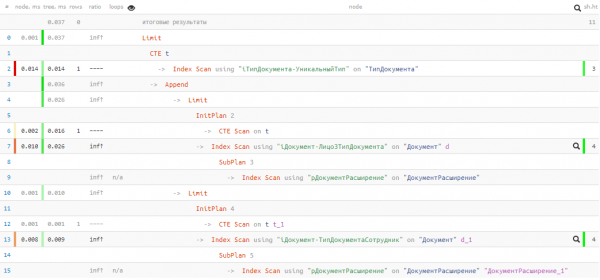
Desafortunadamente, no tuvimos suerte, y en el primer bloque UNION no se encontró nada, por lo que el segundo sí se ejecutó. Pero aun así — solo 0.037ms y 11 buffers!
Hemos acelerado la consulta y reducido la "carga" de datos en memoria en varios miles de veces, utilizando métodos bastante simples — un buen resultado con poco copiar y pegar. 🙂
Fuente: habr.com
