

Les propongo que se familiaricen con la transcripción de la presentación de principios de 2016 de Vladimir Sitnikov "PostgreSQL y JDBC exprimir hasta la última gota"
¡Buenos días! Me llamo Vladimir Sitnikov. He trabajado 10 años en la empresa NetCracker y me ocupo principalmente de rendimiento. Todo lo que está relacionado con Java y SQL es lo que me apasiona.
Y hoy les contaré sobre lo que encontramos en la empresa cuando comenzamos a usar PostgreSQL como servidor de bases de datos. Y principalmente trabajamos con Java. Pero lo que compartiré hoy no solo está relacionado con Java. Como ha demostrado la práctica, esto también surge en otros lenguajes.
Vamos a hablar de:
- la recuperación de datos.
- Sobre la conservación de datos.
- Y también sobre el rendimiento.
- Y sobre los escollos ocultos que hay allí.
Comencemos con una pregunta sencilla. Elegimos una fila de la tabla por la clave primaria.
La base de datos se encuentra en el mismo host. Y todo esto toma 20 milisegundos.
Esos 20 milisegundos son mucho. Si tienes 100 consultas así, pierdes tiempo en un segundo para ejecutar esas consultas, es decir, estás perdiendo tiempo en vano.
No nos gusta hacer eso y miramos qué nos ofrece la base de datos para esto. La base de datos nos ofrece dos opciones de ejecución de consultas.
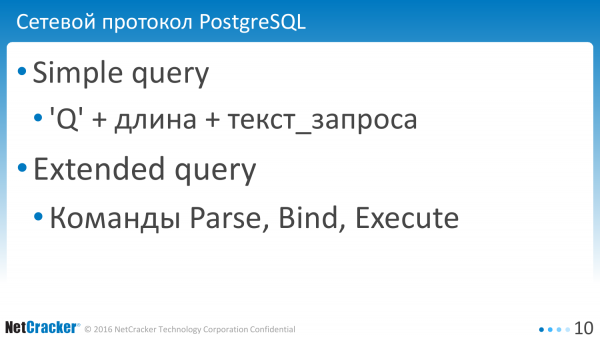
La primera opción es una consulta simple. ¿Qué tiene de bueno? Que la tomamos y la enviamos, y no hacemos nada más.
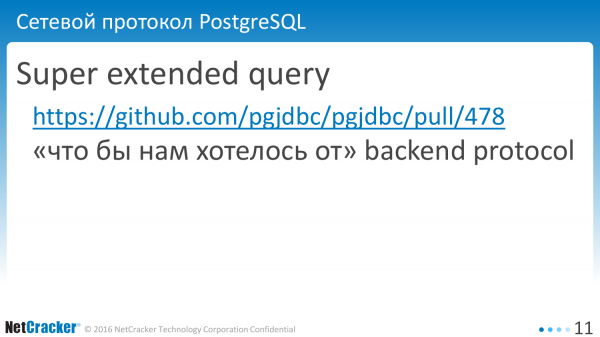
La base de datos también tiene una consulta extendida, que es más inteligente, pero más funcional. Se puede enviar una consulta por separado para análisis, ejecución, vinculación de variables, etc.
La superconsulta extendida es algo que no cubriremos en esta presentación. Quizás deseamos algo de la base de datos y hay una lista de deseos que se ha formado de alguna manera, es decir, esto es lo que queremos, pero no es posible ahora ni en el próximo año. Por eso lo anotamos y vamos a molestar a las personas clave.
Y lo que podemos hacer es simplemente la consulta simple y la consulta extendida.
¿Cuál es la peculiaridad de cada enfoque?
La consulta simple es buena para la ejecución única. La ejecutas una vez y olvidas. Y el problema es que no soporta el formato binario de datos, es decir, no es adecuado para sistemas de alto rendimiento.
La consulta extendida permite ahorrar tiempo en el análisis. Esto es lo que hemos hecho y comenzamos a usar. Nos ha ayudado enormemente. No solo hay economías en el análisis. También hay ahorros en la transmisión de datos. Transmitir datos en formato binario es mucho más eficiente.
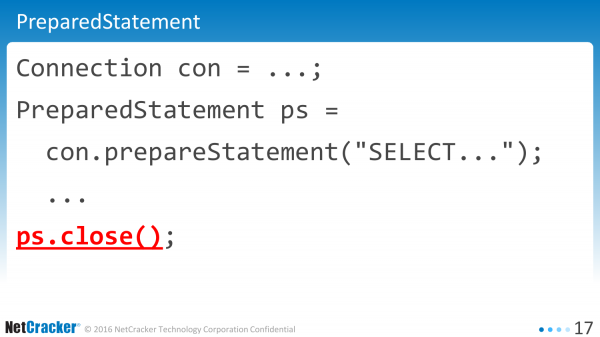
Pasemos a la práctica. Así es como se ve una aplicación típica. Puede ser Java, etc.
Creamos el statement. Ejecutamos el comando. Creamos el close. ¿Dónde está el error aquí? ¿Cuál es el problema? No hay problemas. Así está escrito en todos los libros. Así se debe escribir. Si quieres el máximo rendimiento, escríbelo así.
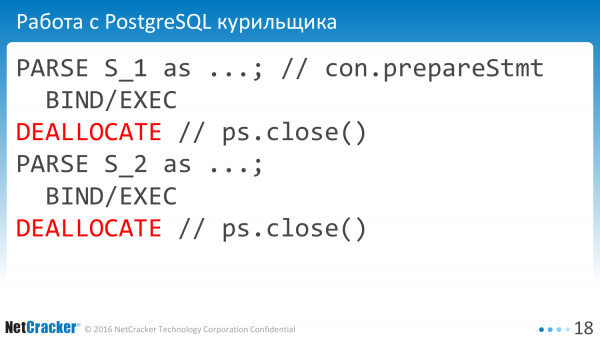
Pero la práctica ha demostrado que esto no funciona. ¿Por qué? Porque tenemos el método 'close'. Y cuando hacemos esto, desde el punto de vista de la base de datos, es como si un fumador estuviera trabajando con la base de datos. Dijimos 'PARSE EXECUTE DEALLOCATE'.
¿Por qué estas creaciones innecesarias y la descarga de statements? No son necesarios para nadie. Pero generalmente en PreparedStatement resulta así, cuando los cerramos, cierran todo en la base de datos. Esto no es lo que queremos.
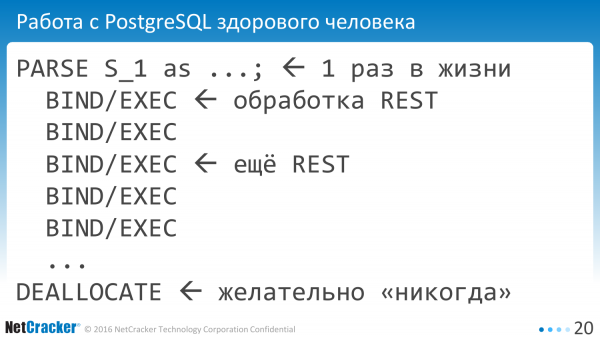
Queremos, como personas sanas, trabajar con la base. Una vez preparamos nuestro statement, luego lo ejecutamos muchas veces. En realidad, muchas veces significa una vez en toda la vida de la aplicación. Y utilizamos el mismo id de statement en diferentes REST. Ese es nuestro objetivo.
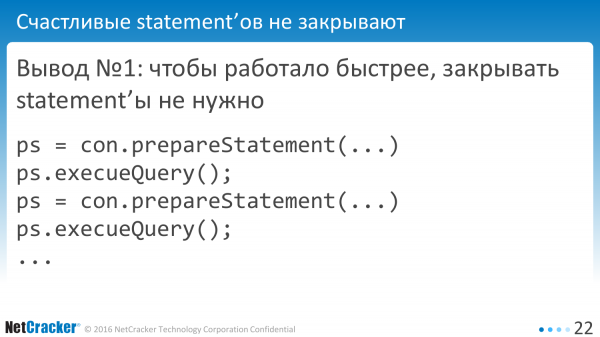
¿Cómo logramos esto?
Muy simple: no hay que cerrar los statements. Escribimos así: 'prepare' 'execute'.
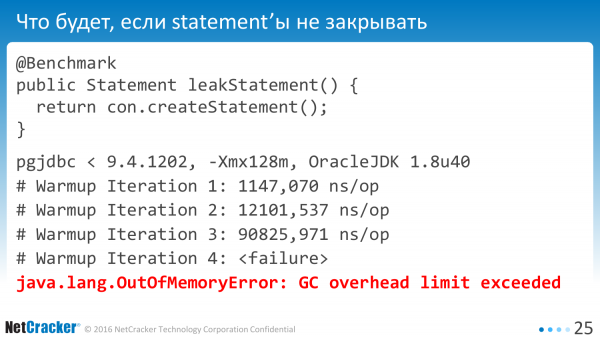
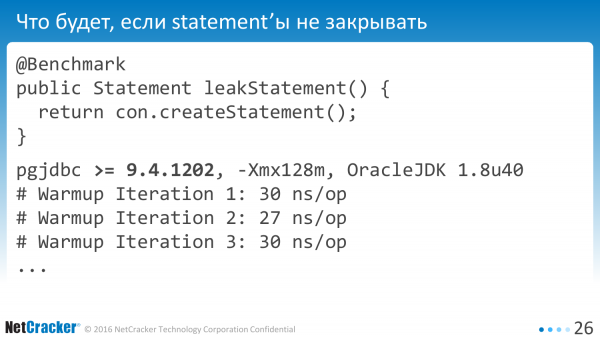
Si ejecutamos esto, está claro que en algún lugar habrá un desbordamiento. Si no es claro, se puede medir. Tomaremos y escribiremos un benchmark con este método simple. Creamos el statement. Lo ejecutamos en alguna versión del driver y nos damos cuenta de que se cae bastante rápido con una pérdida de toda la memoria que teníamos.
Está claro que esos errores son fáciles de corregir. No voy a hablar de ellos. Pero diré que en la nueva versión funciona mucho más rápido. El método es absurdo, pero aun así.
¿Cómo trabajar correctamente? ¿Qué necesitamos hacer para esto?
En realidad, las aplicaciones siempre cierran los statements. Todos los libros dicen que deben cerrarse, de lo contrario, la memoria se filtrará.
Y PostgreSQL no puede almacenar en caché las consultas. Cada sesión necesita crear esta caché para sí misma.
Y tampoco queremos gastar tiempo en el análisis.
Y como siempre, tenemos dos opciones.
La primera opción es que tomemos y digamos que envolvamos todo en PgSQL. Ahí hay un caché. Lo cachea todo. Resultará genial. Hemos mirado esto. Tenemos 100500 consultas. No funciona. No estamos de acuerdo en convertir las consultas a procedimientos manualmente. No, no.
Tenemos una segunda opción: hacer nuestro propio desarrollo. Abrimos el código fuente, comenzamos a desarrollar. Desarrollamos y desarrollamos. Resultó que no era tan complicado hacerlo.
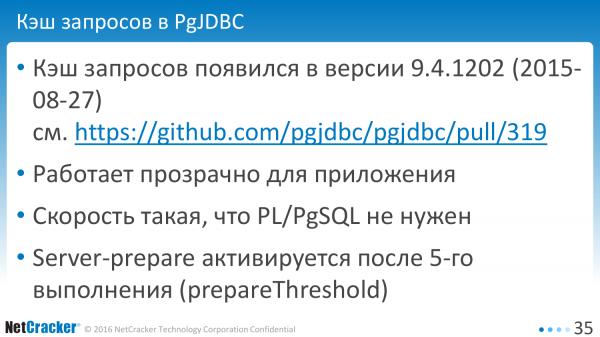
Esto apareció en agosto de 2015. Ahora hay una versión más moderna. Y todo va genial. Funciona tan bien que no hemos cambiado nada en la aplicación. Incluso hemos dejado de pensar en PgSQL, es decir, esto nos ha bastado para reducir prácticamente a cero todos los gastos generales.
El servidor prepara las declaraciones en la quinta ejecución para no gastar memoria en la base de datos para cada consulta temporal.
Se puede preguntar: ¿dónde están los números? ¿Qué obtienen? Y aquí no daré números, porque cada consulta tiene los suyos.
Nuestras consultas eran tales que gastábamos alrededor de 20 milisegundos en el análisis en consultas OLTP. Había 0,5 milisegundos en ejecución, 20 milisegundos en análisis. La consulta era un texto de 10 KiB, 170 líneas de plan. Esta es una consulta OLTP. Solicita 1, 5, 10 filas, a veces más.
Pero no queríamos gastar 20 milisegundos. Lo hemos reducido a 0. Todo genial.
¿Qué puedes sacar de aquí? Si tienes Java, tomas la versión moderna del controlador y te alegras.
Si tienes algún otro lenguaje, piensa: ¿tal vez tú también lo necesitas? Porque desde la perspectiva del lenguaje final, por ejemplo, si es PL 8 o tienes LibPQ, no es obvio que estás gastando tiempo no en la ejecución, sino en el análisis, y eso vale la pena comprobar. ¿Cómo? Todo es gratis.
Excepto que hay errores, algunas peculiaridades. Y sobre eso vamos a hablar ahora. La mayor parte será sobre arqueología industrial, sobre lo que hemos encontrado, en qué nos hemos topado.
Si la consulta se genera dinámicamente. Eso sucede. Alguien concatena cadenas, resultando en una consulta SQL.
¿Por qué es malo? Es malo porque cada vez terminamos con una cadena diferente.
Y esta línea diferente necesita calcular el hashCode nuevamente. Realmente es una tarea de CPU: encontrar un texto de consulta largo, incluso teniendo el hash, no es tan fácil. Así que la conclusión es simple: no generen consultas. Almacenen en una sola variable. Y disfruten.
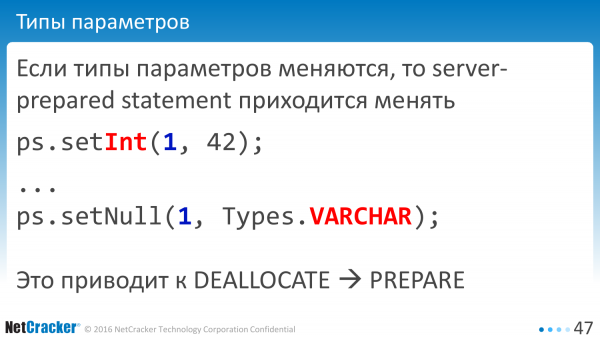
El siguiente problema. Los tipos de datos son importantes. Hay ORMs que dicen que no importa qué NULL, que sea cualquiera. Si es Int, decimos setInt. Y si es NULL, que siempre sea VARCHAR. ¿Y qué importa al final qué NULL haya? La base de datos lo entenderá por sí sola. Y esta imagen no funciona.
En la práctica, a la base de datos realmente le importa. Si la primera vez dijiste que era un número, y la segunda vez dijiste que era VARCHAR, no puedes reutilizar las declaraciones preparadas del servidor. Y en ese caso, tienes que recrear nuestra declaración desde cero.
Si estás ejecutando la misma consulta, asegúrate de que los tipos de datos en la columna no se confundan. Debes cuidar el NULL. Este es un error común que tuvimos después de comenzar a usar PreparedStatements.
Bien, lo activamos. Tal vez tomamos un controlador. Y el rendimiento cayó. Todo se volvió malo.
¿Cómo puede ser eso? ¿Es un bug o una característica? Desafortunadamente, no pudimos entender si era un bug o una característica. Pero hay un escenario bastante simple para reproducir este problema. Nos sorprendió completamente. Y se trata de una consulta de literalmente una tabla. Por supuesto, tuvimos más de tales consultas. Generalmente incluían de dos a tres tablas, pero hay este escenario de reproducción. Toma cualquier versión en tu base de datos y repítelo.
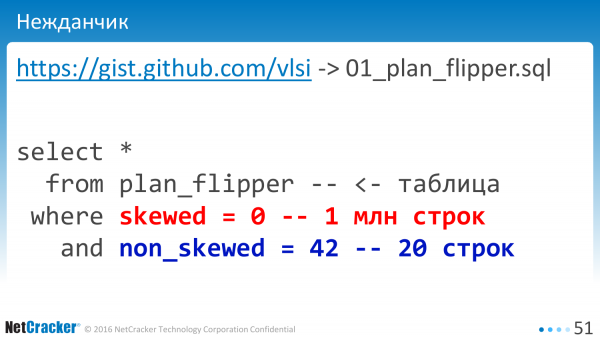
El sentido es que tenemos dos columnas, cada una de las cuales está indexada. En una columna hay un millón de filas con el valor NULL. Y en la otra columna hay solo 20 filas. Cuando ejecutamos sin variables asociadas, todo funciona bien.
Si comenzamos a ejecutar con variables vinculadas, es decir, usamos un signo «?» o «$1» para nuestra consulta, ¿qué obtenemos al final?
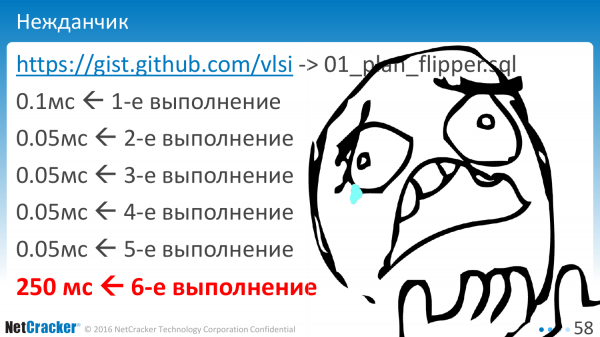
La primera ejecución - como se supone. La segunda - un poco más rápida. Algo se ha almacenado en caché. Tercera, cuarta, quinta. Luego, ¡pum! - y así. Y lo peor es que esto sucede en la sexta ejecución. ¿Quién sabía que había que hacer exactamente seis ejecuciones para entender cuál es realmente el plan de ejecución?
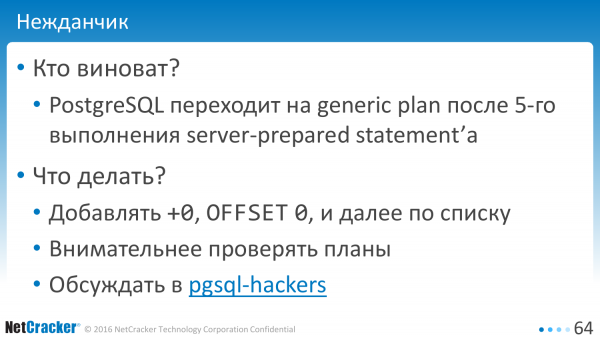
¿Quién es el culpable? ¿Qué ha pasado? La base de datos contiene optimización. Y está más o menos optimizada para un caso genérico. Por lo tanto, a partir de cierta cantidad de veces, cambia a un plan genérico que, lamentablemente, puede resultar ser diferente. Puede ser el mismo, o puede ser diferente. Y hay un valor umbral que conduce a tal comportamiento.
¿Qué se puede hacer al respecto? Aquí, por supuesto, es más complicado hacer suposiciones. Hay una solución sencilla que utilizamos. Es +0, OFFSET 0. Seguramente, conoces este tipo de soluciones. Simplemente tomamos y añadimos «+0» a la consulta y todo sale bien. Lo mostraré más adelante.
Y hay otra opción: observar los planes más detenidamente. El desarrollador no solo debe escribir la consulta, sino también decir «explain analyze» 6 veces. Si son 5, no servirá.
Y hay una tercera opción: enviar una carta a pgsql-hackers. Yo escribí, pero todavía no está claro si es un error o una característica.
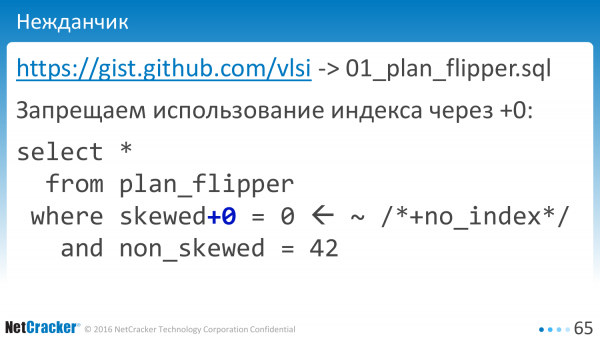
Mientras pensamos si es un error o una característica, arreglemos esto. Tomemos nuestra consulta y añadamos «+0». Todo bien. Dos caracteres y ni siquiera hay que pensar en cómo o qué. Muy sencillo. Simplemente hemos prohibido a la base de datos usar el índice en esa columna. No hay índice en la columna «+0» y eso es todo, la base de datos no utiliza el índice, todo bien.
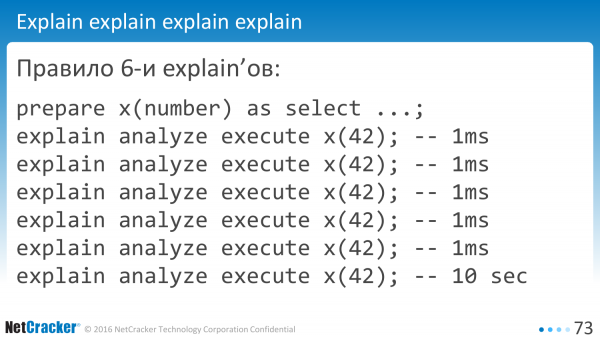
Esta es la regla de los 6 «explain». Actualmente en las versiones actuales hay que hacerlo 6 veces si tienes variables relacionadas. Si no tienes variables relacionadas, lo hacemos de esta manera. Al final, esta consulta es la que falla. No es complicado.
A primera vista, ¿cuánto más se puede? Aquí hay un error, allá hay un error. Realmente hay errores en todas partes.
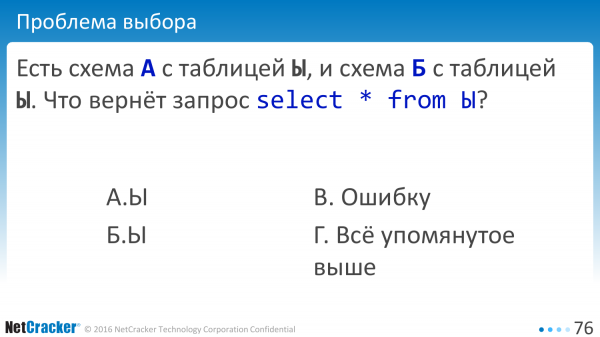
Veamos un ejemplo más. Supongamos que tenemos dos esquemas. Esquema A con la tabla Ы y esquema B con la tabla Ы. Consulta: seleccionar datos de la tabla. ¿Qué tendremos entonces? Tendremos un error. Tendremos todo lo mencionado anteriormente. La regla es: hay un error en todas partes, tendremos todo lo mencionado anteriormente.
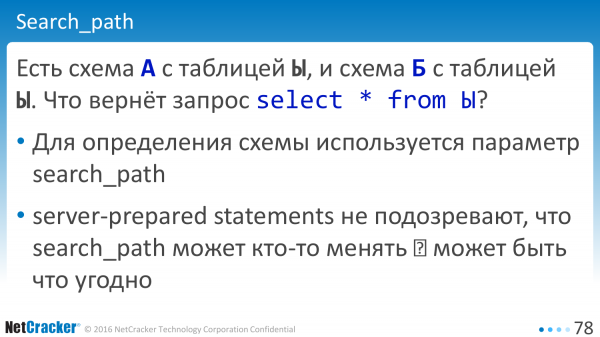
Ahora la pregunta es: «¿Por qué?». Aparentemente, hay documentación que dice que si tenemos un esquema, hay una variable «search_path», que indica dónde buscar la tabla. Aparentemente, la variable está presente.
¿Cuál es el problema? El problema es que las declaraciones preparadas en el servidor no sospechan que alguien pueda cambiar el search_path. Este valor permanece como una constante para la base de datos. Y algunas partes pueden no captar los nuevos valores.
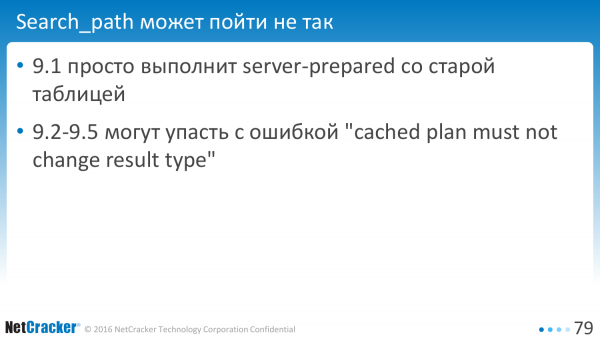
Por supuesto, esto depende de la versión en la que estés probando. Depende de cuán diferentes sean tus tablas. Y la versión 9.1 simplemente ejecutará las consultas antiguas. Las nuevas versiones pueden detectar la trampa y decir que tienes un error.
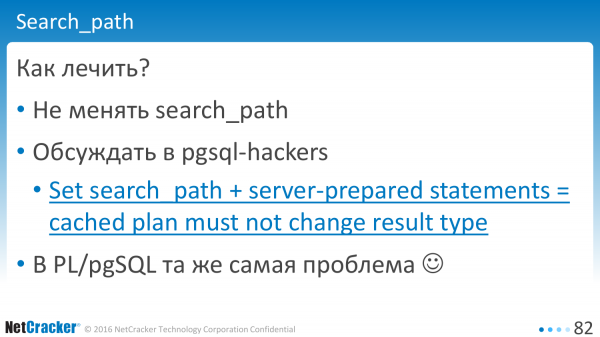
¿Cómo se soluciona esto? Hay una receta sencilla: no lo hagas. No cambies el search_path mientras la aplicación esté en funcionamiento. Si lo cambias, lo mejor es crear una nueva conexión.
Podemos discutir, es decir, abrir, discutir y añadir. Tal vez logremos convencer a los desarrolladores de bases de datos de que, en caso de que alguien cambie un valor, la base de datos debería informar al cliente: ‘Mira, aquí has actualizado un valor. Tal vez necesites restablecer o recrear las declaraciones?’. Actualmente, la base de datos actúa de forma sigilosa y no informa de que internamente las declaraciones han cambiado.
Y vuelvo a enfatizar: esto no es típico de Java. Veremos lo mismo en PL/pgSQL uno a uno. Pero se reproducirá ahí.
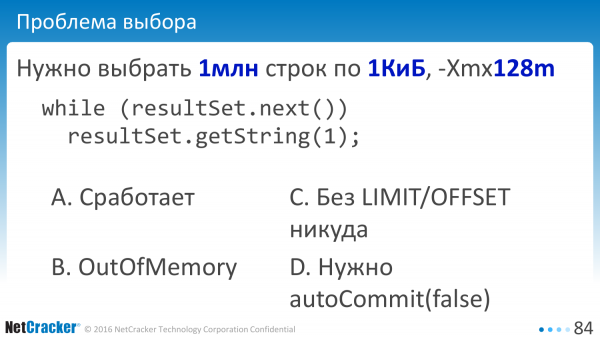
Intentemos seleccionar algunos datos. Seleccionamos, seleccionamos. Tenemos una tabla de un millón de filas. Cada fila tiene un kilobyte. Aproximadamente un gigabyte de datos. Y tenemos una memoria operativa en la máquina Java de 128 megabytes.
Nosotros, como se recomienda en todos los libros, usamos procesamiento por flujo. Es decir, abrimos resultSet y leemos los datos poco a poco. ¿Funcionará esto? ¿No se agotará la memoria? ¿Leerá poco a poco? Vamos a confiar en la base de datos, confiemos en Postgres. No confiamos. ¿Caeremos en OutOfMemory? ¿A quién le ha ocurrido un OutOfMemory? ¿Y quién pudo solucionarlo después? Alguien pudo solucionarlo.
Si tienes un millón de filas, no puedes simplemente seleccionarlas. Es absolutamente necesario usar OFFSET/LIMIT. ¿Quién está a favor de esta opción? ¿Y quién a favor de jugar con autoCommit?
Aquí, como de costumbre, la opción más inesperada resulta ser la correcta. Y si de repente desactivas autoCommit, eso ayudará. ¿Por qué? La ciencia no lo sabe.
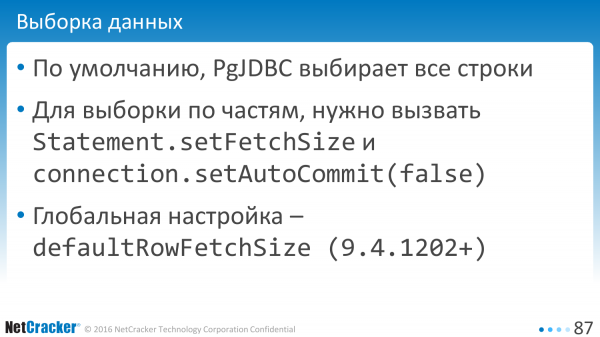
Pero por defecto, todos los clientes que se conectan a la base de datos Postgres seleccionan los datos completos. PgJDBC no es una excepción en este aspecto, selecciona todas las filas.
Hay una variación en el tema FetchSize, es decir, se puede especificar a nivel de una declaración individual que, por favor, seleccione datos de 10, 50. Pero esto no funciona hasta que apagues autoCommit. Apagaste autoCommit: empieza a funcionar.
Sin embargo, recorrer el código y poner setFetchSize en todas partes es incómodo. Por eso hicimos una configuración que indicará un valor predeterminado para toda la conexión.
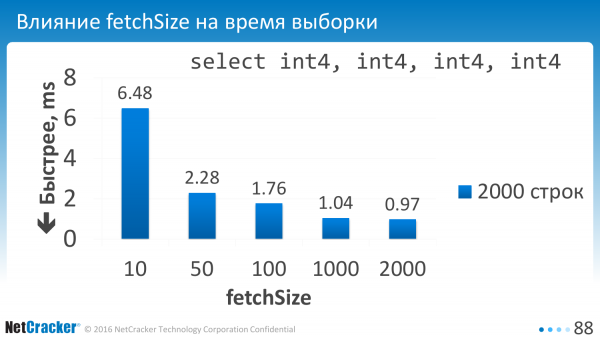
Esto es lo que hemos dicho. Hemos configurado el parámetro. ¿Y qué hemos conseguido? Si seleccionamos un número pequeño, por ejemplo, si seleccionamos 10 filas, tenemos costos adicionales bastante grandes. Por lo tanto, este valor debería ser alrededor de cien.
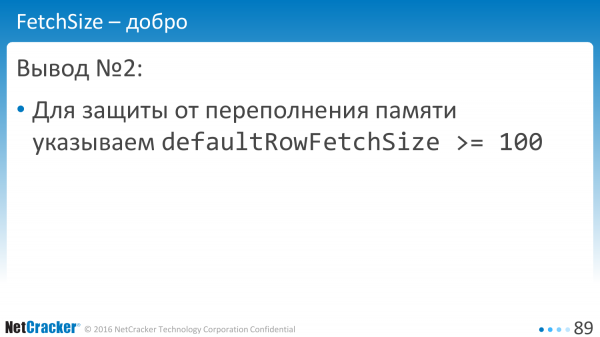
Idealmente, por supuesto, también deberíamos aprender a limitar en bytes, pero la receta es esta: establecemos defaultRowFetchSize por encima de cien y nos alegramos.
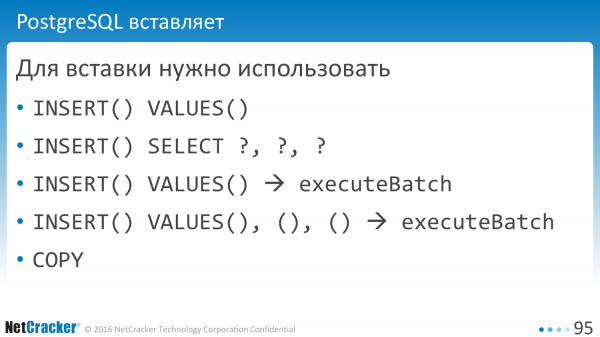
Pasemos a la inserción de datos. Insertar es más sencillo, hay diferentes variantes. Por ejemplo, INSERT, VALUES. Esa es una buena opción. Se puede hablar de "INSERT SELECT". En la práctica, es lo mismo. No hay diferencia en rendimiento.
Los libros dicen que se debe ejecutar un Batch statement, y también dicen que se pueden ejecutar comandos más complejos con varios paréntesis. Y en Postgres hay una función maravillosa: se puede hacer COPY, es decir, hacerlo más rápido.

Si medimos, podemos hacer algunas descubrimientos interesantes nuevamente. ¿Cómo queremos que esto funcione? Queremos no analizar y no ejecutar comandos innecesarios.
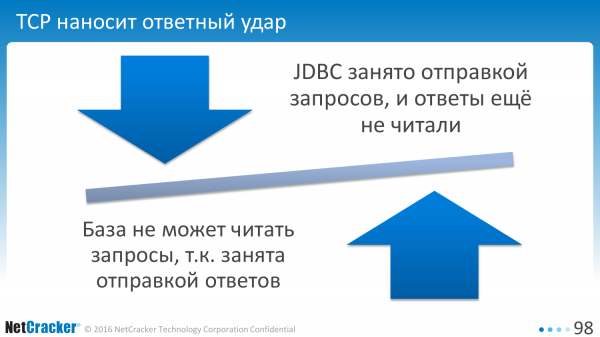
En la práctica, TCP no nos permite hacer eso. Si el cliente está ocupado enviando una solicitud, la base de datos, en sus intentos de enviarnos respuestas, no lee las solicitudes. Como resultado, el cliente espera a que la base de datos lea la solicitud, y la base de datos espera al cliente a que lea la respuesta.
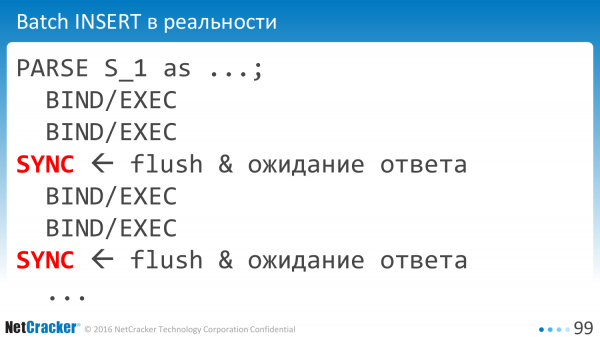
Y por eso el cliente se ve obligado a enviar periódicamente un paquete de sincronización. Interacciones de red innecesarias, pérdida de tiempo adicional.
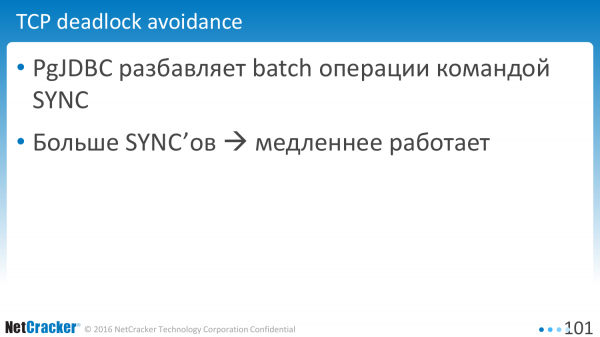 Y cuanto más añadimos, peor se vuelve. El controlador es bastante pesimista y los añade con bastante frecuencia, aproximadamente cada 200 filas, dependiendo del tamaño de las filas, etc.
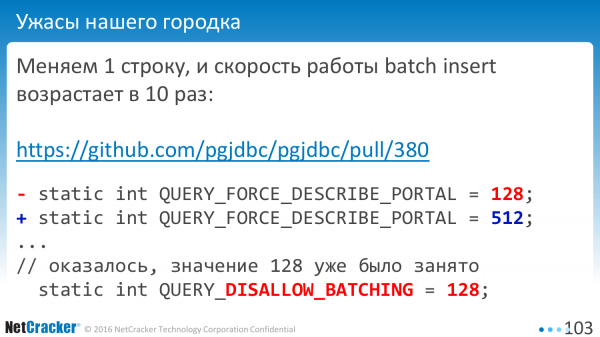
A veces, corregir solo una línea acelera todo diez veces. Eso sucede. ¿Por qué? Como siempre, una constante ya se había utilizado en algún lugar. Y el valor "128" significaba no utilizar batching.
Es bueno que esto no haya llegado a la versión oficial. Lo descubrimos antes de comenzar a lanzar la versión. Todos los valores que menciono están basados en versiones modernas.
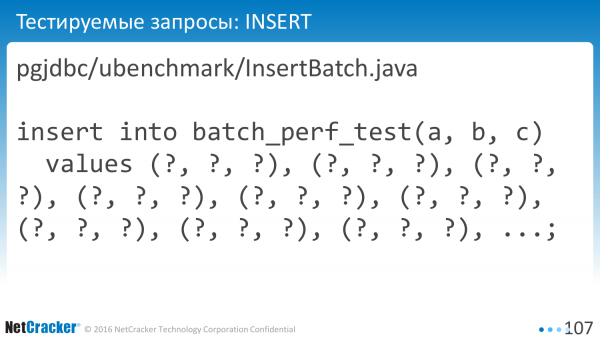
Vamos a medir. Medimos InsertBatch simple. Medimos InsertBatch múltiple, es decir, lo mismo, pero con muchos values. Un movimiento astuto. No todos pueden hacer eso, pero es un movimiento simple, mucho más fácil que COPY.
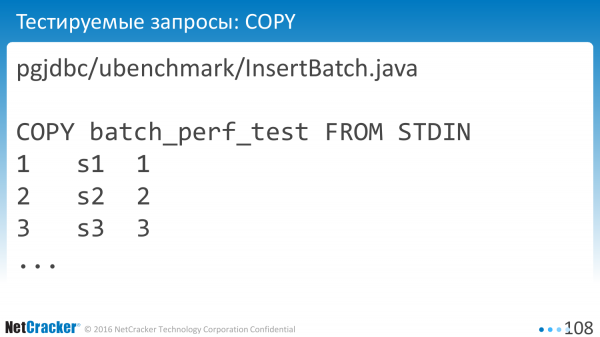
Se puede hacer COPY.
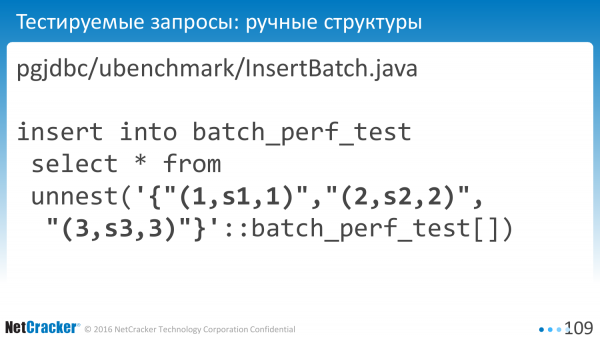
Y se puede hacer esto en estructuras. Declarar el tipo User por defecto, pasar un arreglo e INSERTar directamente en la tabla.
Si abres el enlace: pgjdbc/ubenchmsrk/InsertBatch.java, el código está en GitHub. Puedes ver específicamente qué consultas se generan allí. No es lo más importante.
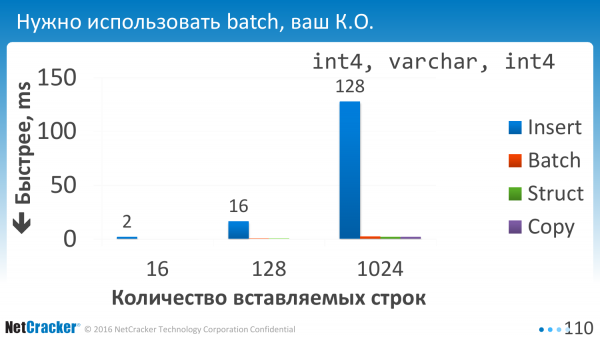
Lo hemos lanzado. Y lo primero que entendimos es que no usar batch es simplemente imposible. Todas las opciones de batching son iguales a cero, es decir, el tiempo de ejecución es prácticamente cero en comparación con la ejecución única.
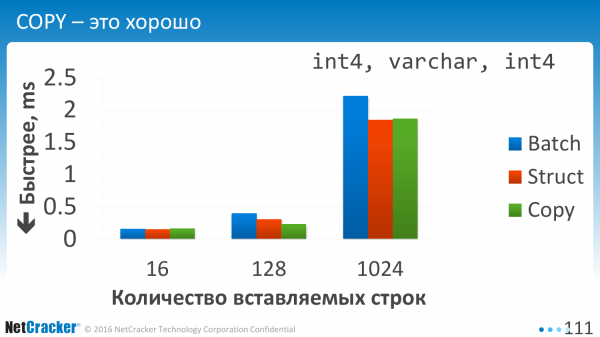
Estamos insertando datos. Es una tabla bastante simple. Tres columnas. ¿Y qué vemos aquí? Vemos que las tres opciones son aproximadamente comparables. Y COPY, por supuesto, es mejor.
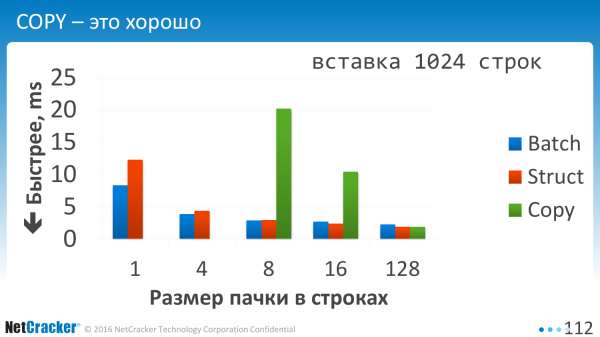
Esto es cuando insertamos en pequeñas porciones. Cuando dijimos que un valor son VALUES, dos valores son VALUES, tres valores son VALUES o que enumeramos 10 separados por comas. Esto es justo ahora horizontal. 1, 2, 4, 128. Se nota que el Batch Insert, que está dibujado en azul, le facilita mucho la vida. Es decir, cuando insertas uno a uno o incluso cuando insertas cuatro, se vuelve dos veces mejor, simplemente porque pusimos un poco más en VALUES. Menos operaciones EXECUTE.
Usar COPY en volúmenes pequeños es extremadamente poco prometedor. Ni siquiera dibujé en los dos primeros. Van hacia el cielo, es decir, esos números verdes para COPY.
COPY debe utilizarse cuando tienes al menos más de cien filas de datos. Los costos de abrir esta conexión son grandes. Y, sinceramente, no he explorado en esta dirección. Optimicé el batch, pero no COPY.
¿Qué hacemos después? Medimos. Entendemos que hay que usar estructuras o un ingenioso batch que combine varios valores.
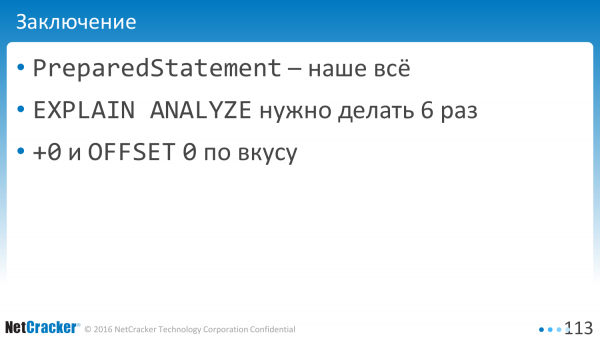
¿Qué se debe resaltar de la exposición de hoy?
- PreparedStatement es lo más importante. Esto aporta mucho a la eficiencia. Trae un gran barril de alquitrán.
- Y hay que hacer EXPLAIN ANALYZE 6 veces.
- Y hay que diluir OFFSET 0, y usar trucos como +0 para corregir el porcentaje restante de nuestras consultas problemáticas.
Fuente: habr.com
