

Muchos de los que ya utilizan — nuestro servicio de visualización de planes PostgreSQL, quizás no estén al tanto de una de sus supercapacidades: transformar un fragmento de registro del servidor difícil de leer…
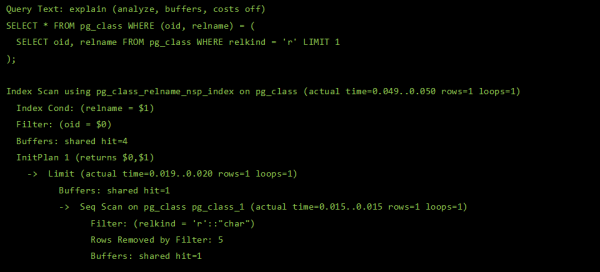
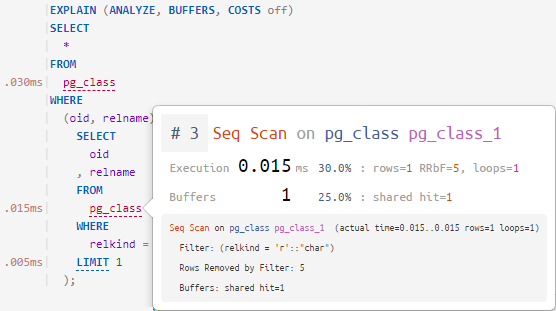
… en una consulta bien formateada con sugerencias contextuales sobre los nodos correspondientes del plan:
En esta desglose de la segunda parte de su les contaré cómo logramos hacerlo.
Con la transcripción de la primera parte, dedicada a problemas típicos de rendimiento de consultas y sus soluciones, se puede consultar en el artículo .
Primero nos ocuparemos del coloreado — y colorearemos no el plan, ya lo hemos coloreado, ya es bonito y comprensible, sino la consulta.
Nos pareció que una «manta» sin formatear extraída del registro de consultas se ve muy poco atractiva y, por ello, incómoda.
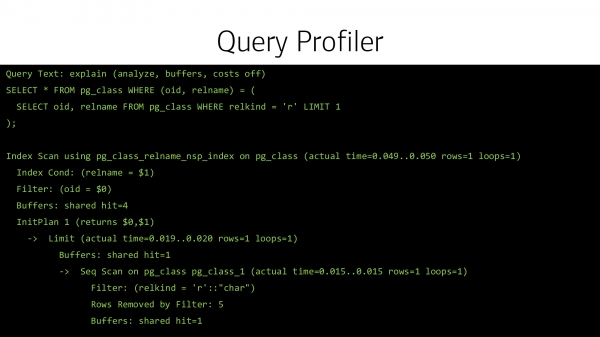
Especialmente cuando los desarrolladores ‘pegan’ el cuerpo de la consulta en una línea de código (sí, es un antipatron, pero a veces sucede). ¡Terrible!
Vamos a representarlo de una manera más bonita.
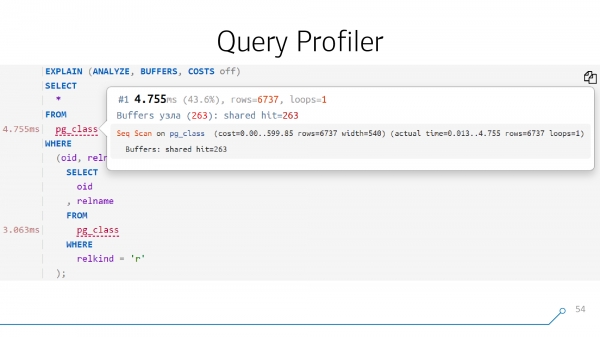
Y si podemos representarlo de forma atractiva, es decir, descomponer y volver a unir el cuerpo de la consulta, entonces podemos ‘adjuntar’ sugerencias a cada objeto de esta consulta — lo que sucedía en el punto correspondiente del plan.
Árbol sintáctico de la consulta
Para hacer esto, primero necesitamos descomponer la consulta.
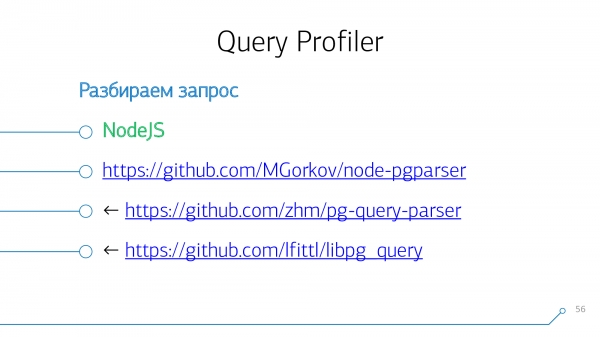
Dado que , hicimos un módulo para ello, pueden . En realidad, esto son enlaces avanzados a las entrañas del propio parser de PostgreSQL. Es decir, simplemente es una gramática compilada y hecha enlaces desde NodeJS. Tomamos como base módulos ajenos; aquí no hay ningún gran secreto.
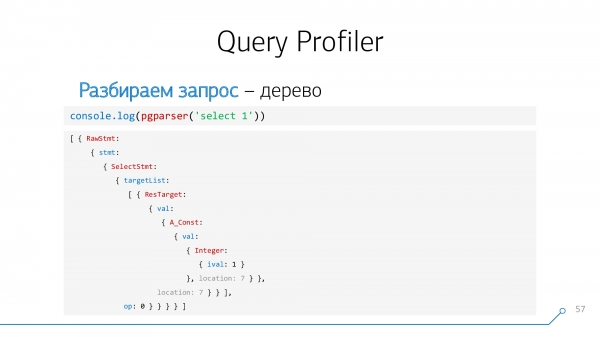
Alimentamos el cuerpo de la consulta a nuestra función — y obtenemos un árbol sintáctico descompuesto en forma de objeto JSON.
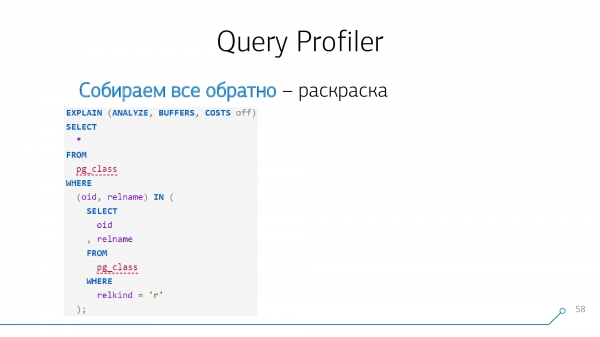
Ahora podemos recorrer este árbol en sentido inverso y volver a construir la consulta con los espacios, colores y formateado que deseamos. No, esto no se configura, pero nos pareció que sería más cómodo así.
Vinculación de nodos de consulta y plan
Ahora veamos cómo podemos combinar el plan que descompusimos en el primer paso y la consulta que descompusimos en el segundo.
Tomemos un ejemplo sencillo: tenemos una consulta que forma un CTE y lee de él dos veces. Genera el siguiente plan.
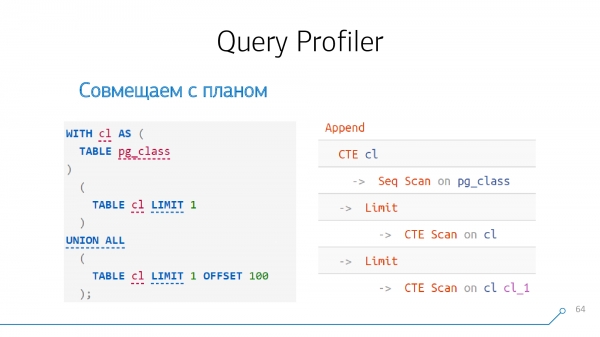
CTE
Si lo miramos atentamente, hasta la versión 12 (o comenzando con ella con la palabra clave MATERIALIZED) la formación .
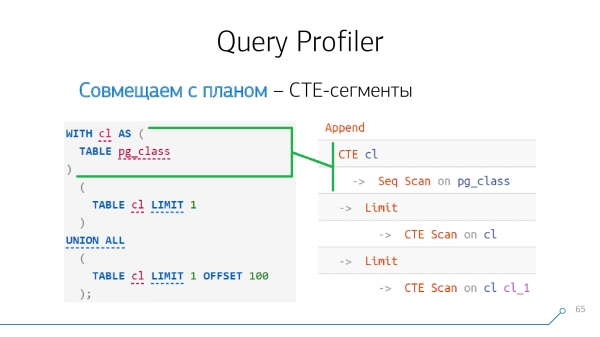
Así que, si vemos en alguna parte de la consulta la generación de un CTE y en alguna parte del plan un nodo CTE, entonces estos nodos están claramente 'chocando', podemos inmediatamente combinarlos.
La tarea 'con estrella': los CTE pueden ser anidados.
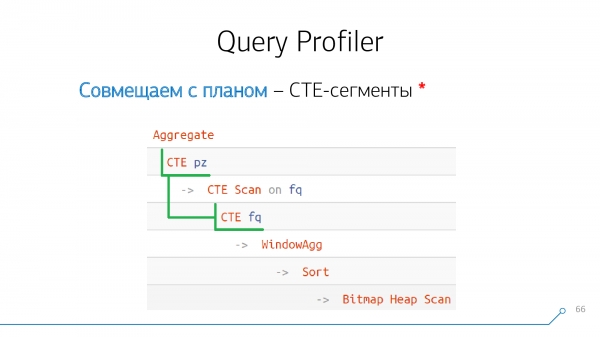
Pueden estar muy mal anidados, e incluso tener el mismo nombre. Por ejemplo, puedes dentro de CTE A hacer CTE X, y al mismo nivel dentro de CTE B hacer otra vez CTE X:
WITH A AS (
  WITH X AS (...)
  SELECT ...
)
, B AS (
  WITH X AS (...)
  SELECT ...
)
...
Al hacer la comparación, debes entender esto. Comprenderlo 'con los ojos' — incluso viendo el plan, incluso viendo el cuerpo de la consulta — es muy difícil. Si tienes una generación de CTE complicada, anidada, y las consultas son grandes — entonces ni siquiera se percibe.
RÁPIDO
Si tenemos en la consulta la palabra clave UNION [ALL] (el operador de unión de dos selecciones), entonces en el plan le corresponde o bien un nodo Añadir, o algún tipo de Unión Recursiva.
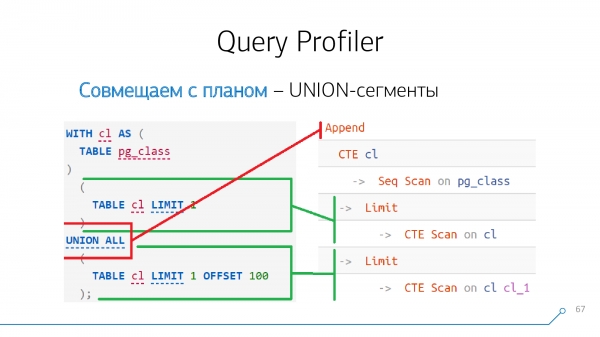
Lo que está 'arriba' de RÁPIDO es el primer descendiente de nuestro nodo, lo que está 'abajo' — el segundo. Si a través de RÁPIDO tenemos 'pegados' varios bloques a la vez, entonces Añadir-el nodo seguirá siendo solo uno, pero tendrá más hijos, no dos, sino muchos — en orden como aparecen:
  (...) -- #1
UNION ALL
  (...) -- #2
UNION ALL
  (...) -- #3
Append
-> ... #1
-> ... #2
-> ... #3
La tarea 'con estrella': dentro de la generación de selección recursiva (WITH RECURSIVE) también puede haber más de uno. RÁPIDOPero siempre es recursivo solo el último bloque después del último. RÁPIDOTodo lo que está arriba — es uno, pero diferente. RÁPIDO:
WITH RECURSIVE T AS(
  (...) -- #1
UNION ALL
  (...) -- #2, aquí termina la generación del estado inicial de la recursión
UNION ALL
  (...) -- #3, solo este bloque es recursivo y puede contener una referencia a T
)
...
También hay que saber 'despegar' tales ejemplos. En este caso, vemos que RÁPIDO-había 3 segmentos en nuestra consulta. Por lo tanto, uno RÁPIDO corresponde a Añadir-nodo, y al otro — Unión Recursiva.
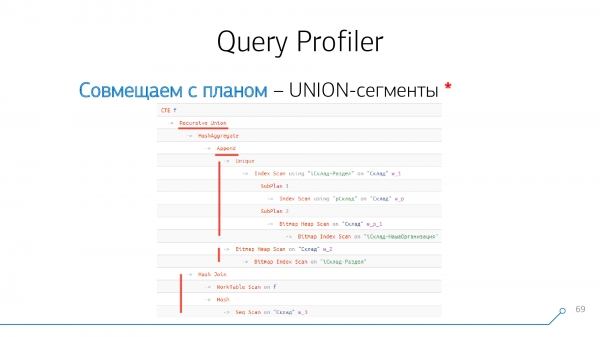
Lectura-escritura de datos.
Todo, lo hemos desglosado, ahora sabemos qué parte de la consulta corresponde a qué parte del plan. Y en estas partes podemos encontrar fácil y cómodamente aquellos objetos que 'se leen'.
Desde el punto de vista de la consulta, no sabemos — si es una tabla o un CTE, pero se designan con el mismo nodo. VariedadRango. En el plan, la parte que se "lee" también es un conjunto bastante limitado de nodos:
Escaneo Secuencial en [tbl]Escaneo de Montículo de Bitmap en [tbl]Índice [Solo] Escaneo [Invertido] usando [idx] en [tbl]Escaneo CTE en [cte]Insertar/mensaje de Update./Eliminar en [tbl]
Conocemos la estructura del plan y la consulta, sabemos cómo se corresponden los bloques, conocemos los nombres de los objetos — hacemos una correspondencia inequívoca.
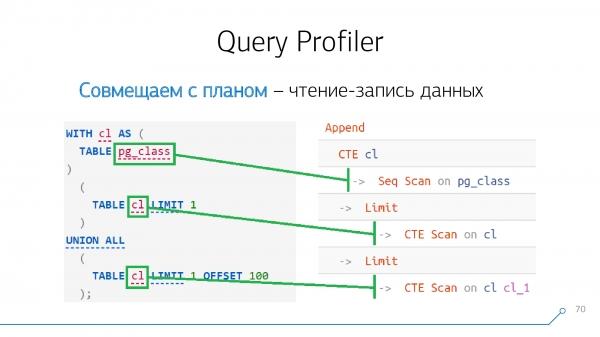
De nuevo, la tarea "con asterisco".. Tomamos la consulta, la ejecutamos, no tenemos aliases — simplemente leemos dos veces desde una CTE.
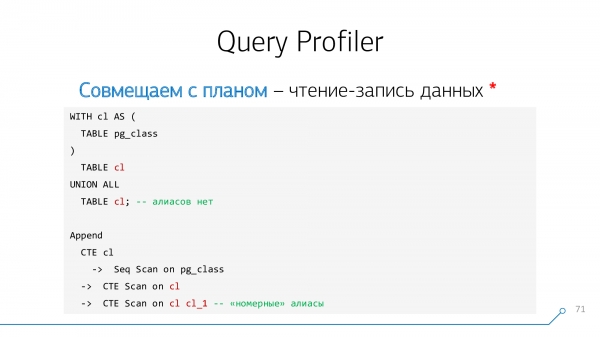
Miramos en el plan — ¿qué pasa? ¿Por qué aparece un alias? No lo solicitamos. ¿De dónde salió este "numerado"?
PostgreSQL lo agrega automáticamente. Solo hay que entender que exactamente ese alias no tiene sentido para nuestros fines de comparación con el plan, simplemente está añadido aquí. No vamos a prestarle atención.
Segundo la tarea "con asterisco".: si estamos leyendo de una tabla particionada, obtendremos un nodo Añadir o Fusionar Agregar, que consistirá en una gran cantidad de "hijos", y cada uno de ellos será algún tipo de Scande la tabla-sección: Escaneo Secuencial, Escaneo de Montículo de Bitmap o Index Scan. Pero, en cualquier caso, estos "hijos" no serán consultas complejas — así es como se pueden distinguir estos nodos de Añadir al realizar RÁPIDO.
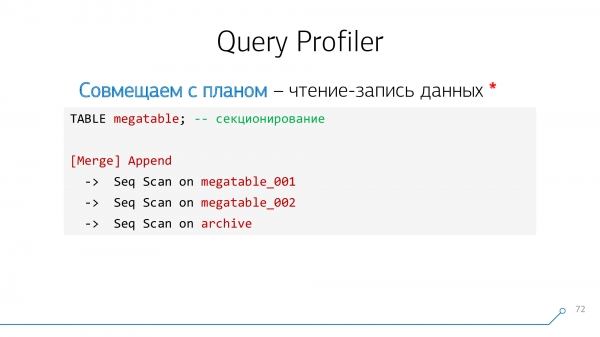
También entendemos estos nodos, los agrupamos y decimos: "todo lo que has leído de megatable — está aquí y descendiendo en el árbol".
Nodos "simples" de obtención de datos
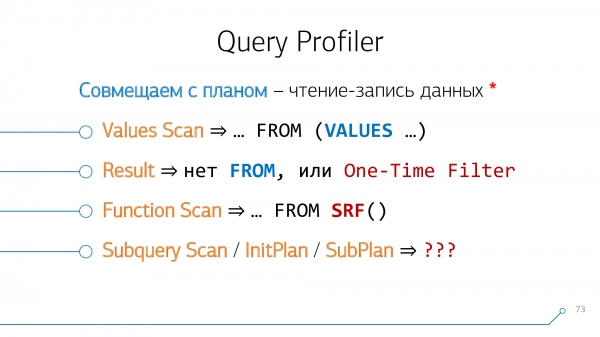
Escaneo de Valores en el plan corresponde SECUENCIA en la consulta.
Resultado — es una consulta sin FROM parece SELECT 1. O cuando tienes una expresión evidentemente falsa en el WHERE-bloque (entonces aparece el atributo One-Time Filter):
EXPLAIN ANALYZE
SELECT * FROM pg_class WHERE FALSE; -- o 0 = 1
Resultado (costo=0.00..0.00 filas=0 ancho=230) (tiempo real=0.000..0.000 filas=0 loops=1)
One-Time Filter: falso
Escaneo de Función "se mapean" a las SRF homónimas.
Pero con las subconsultas es más complicado — desafortunadamente, no siempre se convierten en InitPlan/SubPlan. A veces se convierten en ... Join o ... Anti Join, especialmente cuando escribes algo como WHERE NOT EXISTS .... Y allí combinar no siempre es posible — en el texto del plan, no hay operadores correspondientes a los nodos del plan.
De nuevo, la tarea "con asterisco".: varios SECUENCIA en la consulta. En este caso, en el plan también obtendrás varios nodos Escaneo de Valores.
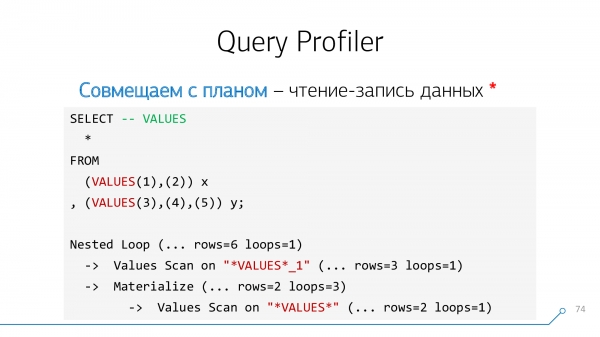
Distinguirlos unos de otros ayudará un sufijo "numerado" — que se agrega precisamente en el orden en que se encuentran los correspondientes SECUENCIA-bloques a lo largo de la consulta de arriba hacia abajo.
Procesamiento de datos
Parece que hemos analizado todo en nuestra consulta — solo queda Límite.
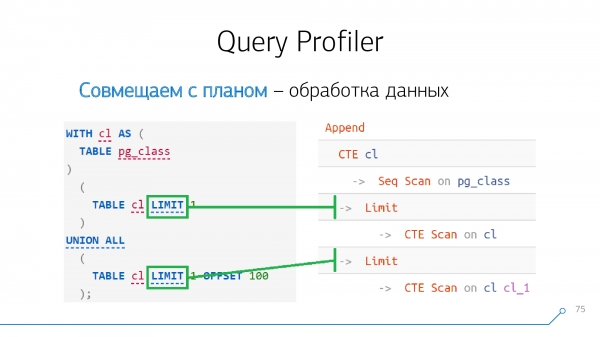
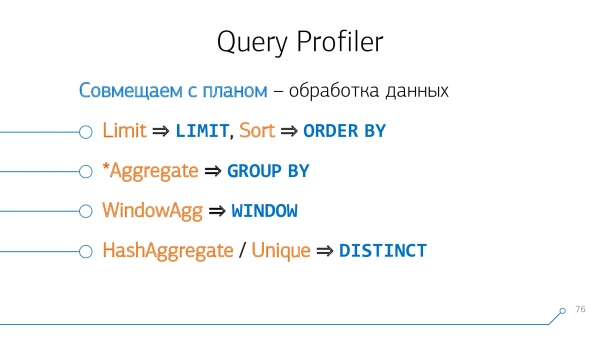
Pero aquí todo es sencillo — nodos como Límite, Ordenar, Agregar, WindowAgg, Unique "se mapean" uno a uno a los operadores correspondientes en la consulta, si los hay. Aquí no hay "asteriscos" ni complicaciones.
JOIN
Las dificultades surgen cuando queremos combinar JOIN entre sí. No siempre es posible, pero se puede.
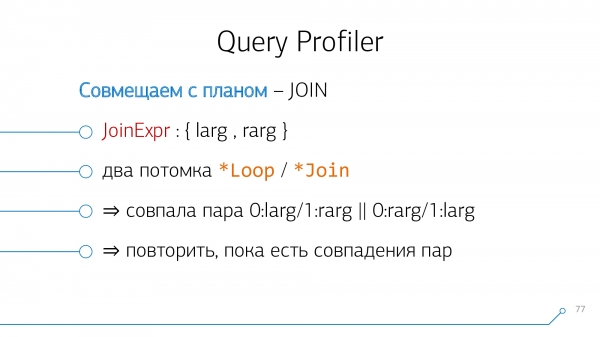
Desde el punto de vista del analizador de consultas, tenemos un nodo JoinExpr, que tiene exactamente dos hijos: el izquierdo y el derecho. Esto es, respectivamente, lo que está "sobre" su JOIN y lo que está "debajo" de él en la consulta.
Y desde el punto de vista del plan, es dos hijos de algún * Bucle/* Unir-nodo. Bucle Anidado, Unión Hash Anti,... algo así.
Utilicemos una lógica sencilla: si tenemos las tablas A y B, que se "unen" entre sí en el plan, entonces en la consulta podrían estar dispuestas ya sea A-JOIN-B, o B-JOIN-A. Intentaremos combinarlas así, luego de esta manera, y así hasta que tales pares se agoten.
Tomemos nuestro árbol sintáctico, tomemos nuestro plan, miremos ambos... ¡no se parecen!
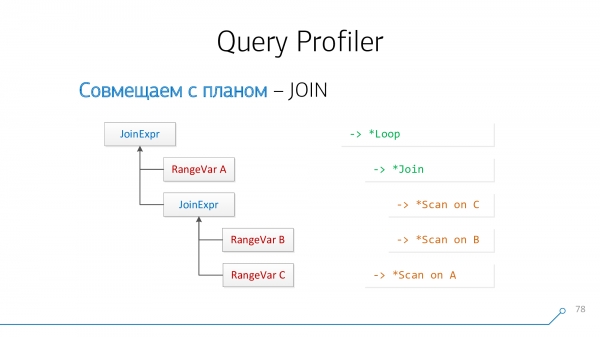
Redibujemos en forma de grafos — ¡oh, ya se ve algo similar a algo!
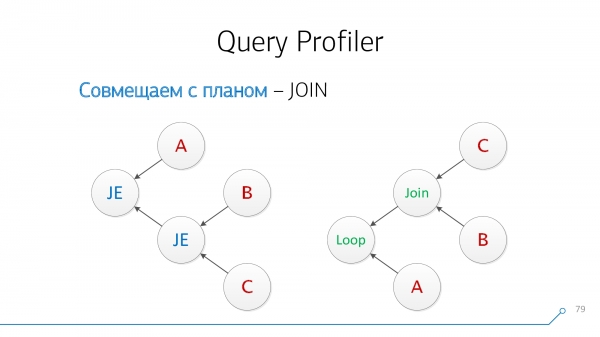
Presta atención a que tenemos nodos que tienen simultáneamente hijos B y C — no nos importa en qué orden. Combinémoslos y giremos la imagen del nodo.
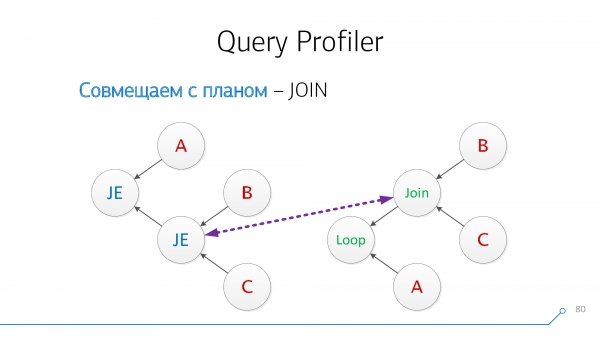
Miremos otra vez. Ahora tenemos nodos con hijos A y pareados (B + C) — los combinamos también.
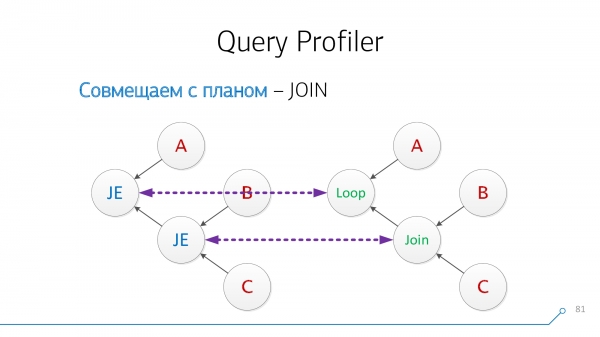
¡Excelente! Así que hemos combinado estos dos JOIN de la consulta con los nodos del plan exitosamente.
Lamentablemente, esta tarea no siempre se resuelve.
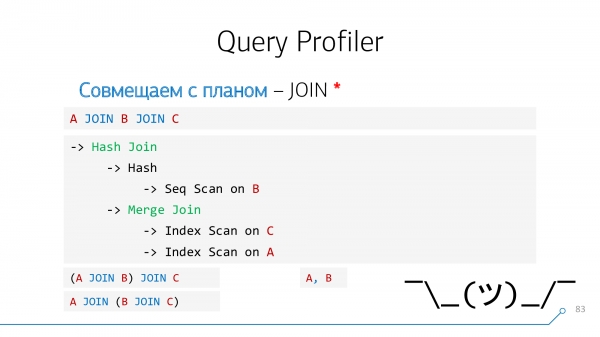
Por ejemplo, si en la consulta A JOIN B JOIN C, en el plan inicialmente se unieron los nodos "extremos" A y C. Y en la consulta no hay tal operador, no tenemos nada que resaltar, nada a lo que vincular la sugerencia. Lo mismo sucede con la "coma", cuando escribes A, B.
Pero, en la mayoría de los casos, casi todos los nodos pueden "desenredarse" y obtener un perfil así a la izquierda por tiempo — literalmente, como en Google Chrome, cuando analizas código en JavaScript. Ves cuánto tiempo tomó cada línea y cada operador "ejecutarse".
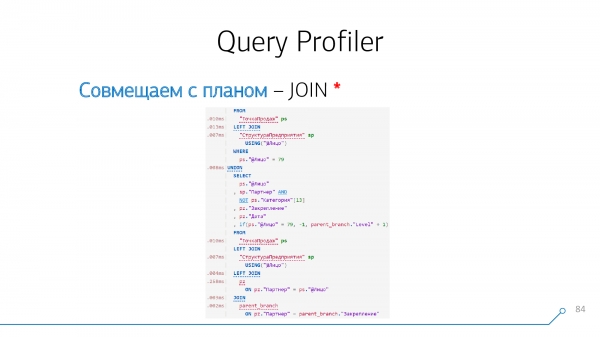
Y para que les sea más cómodo utilizar todo esto, hemos implementado un almacenamiento , donde pueden guardar y luego encontrar sus planes junto con las consultas asociadas o compartir un enlace con alguien.
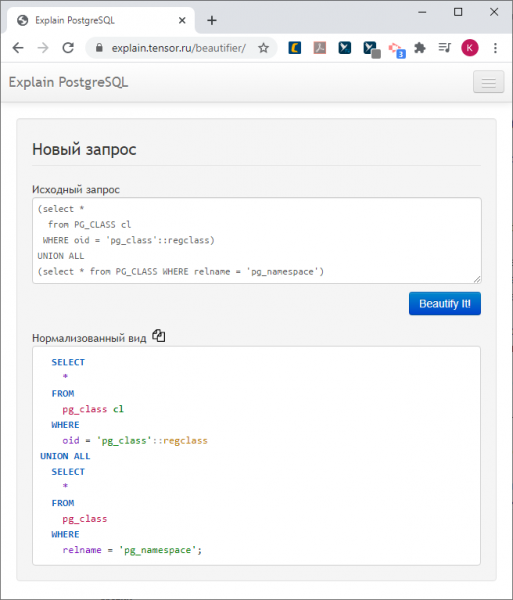
Si solo necesitas convertir una consulta ilegible a un formato adecuado, utiliza nuestro .
Fuente: habr.com
