

La traducción del artículo ha sido preparada especialmente para los estudiantes del curso .
En las últimas semanas, hemos añadido a un formato de flujo binario, complementando el formato de archivos de acceso aleatorio/IPC existente. Tenemos implementaciones en Java y C++ y enlaces en Python. En este artículo, explicaré cómo funciona el formato y mostraré cómo se puede alcanzar una muy alta capacidad de transferencia de datos para DataFrame pandas.
Transmisión de datos en columnas
Una pregunta común que recibo de los usuarios de Arrow es sobre el alto costo de mover grandes conjuntos de datos tabulares del formato basado en filas o registros a un formato de columnas. Para conjuntos de datos de varios gigabytes, transponer en memoria o en disco puede ser una tarea abrumadora.
Para la transmisión de datos, ya sean los datos originales de tipo fila o columna, una opción es enviar pequeños paquetes de filas, cada uno de los cuales contiene una disposición por columnas.
En Apache Arrow, una colección de arreglos de columnas en memoria, que representa un bloque de una tabla, se llama paquete de registros (record batch). Para representar una única estructura de datos de una tabla lógica, se pueden combinar varios paquetes de registros.
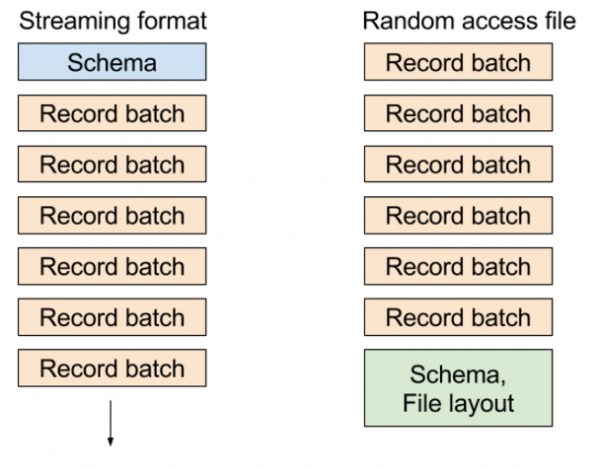
En el formato de archivo existente de acceso aleatorio, escribimos metadatos que contienen el esquema de la tabla y la ubicación de los bloques al final del archivo, lo que te permite seleccionar cualquier paquete de registros o cualquier columna del conjunto de datos a un costo muy bajo. En el formato de flujo, enviamos una serie de mensajes: el esquema y luego uno o varios paquetes de registros.
Los diferentes formatos se ven aproximadamente así, como se muestra en esta imagen:
Transmisión de datos en PyArrow: aplicación
Para mostrarte cómo funciona, crearé un ejemplo de un conjunto de datos que representa un bloque de transmisión:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Ahora, supongamos que queremos escribir 1 GB de datos, compuestos de bloques de 1 MB cada uno, un total de 1024 bloques. Para empezar, crearemos el primer marco de datos de 1 MB con 16 columnas:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Luego los convierto a pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Ahora crearé un flujo de salida que escribirá en la memoria y crearé StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Luego escribiremos 1024 chunks, que en total constituirán 1GB de conjunto de datos:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Dado que estamos escribiendo en RAM, podemos obtener todo el flujo en un solo búfer:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Dado que estos datos están en memoria, la lectura de los paquetes de registros de Arrow se realiza como una operación zero-copy. Abro StreamReader, leo los datos en pyarrow.Table, y luego los convierto en DataFrame de pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Todo esto, por supuesto, está bien, pero puede tener preguntas. ¿Qué tan rápido ocurre esto? ¿Cómo afecta el tamaño del chunk al rendimiento de la obtención del DataFrame de pandas?
Rendimiento de la transmisión de datos
A medida que disminuye el tamaño del chunk de transmisión, el costo de reconstruir un marco de columnas continuo de DataFrame en pandas aumenta debido a ineficiencias en los esquemas de acceso a la caché. También hay algunos costos adicionales al trabajar con estructuras de datos de C++ y sus búferes de memoria.
Para 1 MB, como se mencionó anteriormente, en mi laptop (Quad-core Xeon E3-1505M) se obtiene:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Por lo tanto, la capacidad de transferencia efectiva es de 7.75 GB/s para recuperar un DataFrame de 1GB de 1024 chunks de 1MB. ¿Qué sucede si usamos chunks de mayor o menor tamaño? Estos son los resultados que obtendríamos:
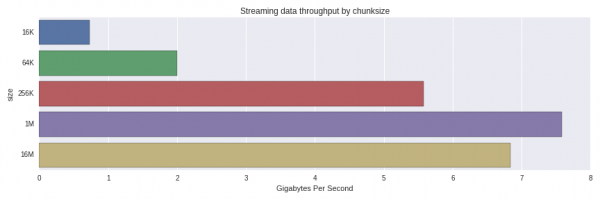
El rendimiento disminuye considerablemente de chunks de 256K a 64K. Me sorprendió que los chunks de 1MB se procesaran más rápido que los de 16MB. Vale la pena investigar más a fondo y entender si esto es una distribución normal o si hay otros factores en juego.
En la implementación actual del formato, los datos no se comprimen en absoluto, por lo que el tamaño en memoria y "en los cables" es aproximadamente el mismo. En el futuro, la compresión puede convertirse en una opción adicional.
Summary
La transmisión de datos en columnas puede ser una forma efectiva de enviar grandes conjuntos de datos a herramientas de análisis en columnas, como pandas, utilizando pequeños fragmentos. Los servicios de datos que utilizan almacenamiento orientado a filas pueden transmitir y transponer pequeños fragmentos de datos que son más convenientes para la caché L2 y L3 de su procesador.
Código completo
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Fuente: habr.com
